
发布解读,非本站实测。 本文依据公开资料整理,未完成本文模型的付费接口测试。厂商基准只适用于其公布的版本、数据集与条件;未提供可复核来源、原始值及换算方法的衍生评分已撤下。 OpenAI 这次发布 GPT-5.6,做了一个反常的决定:几乎不公布传统学术榜单成绩。没有 MMLU、没有 GPQA Diamond、没有 AIME——这些过去每次旗舰发布都要刷一遍的"标准动作",这次被有意跳过了。
取而代之的是一组实战基准:BrowseComp(网页浏览检索)、OSWorld 2.0(真实操作系统操作)、Terminal-Bench 2.1(终端任务)、AA Coding Agent Index(编码智能体指数)。OpenAI 的潜台词很清楚:大模型已经卷到了"能不能独立干活"的阶段,刷学术分已经不能说明问题。
GPT-5.6 也引入了一套新的命名体系——按天体分档:Sol(旗舰)/ Terra(中坚)/ Luna(极速)。其中 SOL Pro 是最高推理强度的档位,专门跑最难、最长的 Agent 工作流。这篇解读它的核心升级。
说明
本文的能力描述来自 OpenAI 官方发布页与公开第三方评测,非本站实测。涉及的能力结论均标注来源,价格数据为 apizt 控制台实时值。建议你用注册赠送的额度,拿自己的真实任务验证。
一、GPT-5.6 SOL Pro 在卷什么?官方公布的三件事
根据 OpenAI 官方发布,GPT-5.6 的升级重点可以归纳成三个方向,全部围绕"让模型能独立完成真实工作"。
1. 天体档位体系:Sol / Terra / Luna
GPT-5.6 抛弃了过去的单一旗舰打法,改用天体命名分三档:Sol 是能力上限最高的旗舰档,Terra 是性价比中坚(企业副驾定位),Luna 是最快最便宜的极速档。其中 SOL Pro 对应最高推理强度(reasoning.mode = pro),专门服务高难度、长耗时的 Agent 工作流。
2. Agent 与 Coding 实战基准全面领先
官方公布的实战基准成绩:
| 基准 | GPT-5.6 SOL | 说明 |
|---|---|---|
| BrowseComp | 92.2%(Ultra) | 网页检索新 SOTA,超 GPT-5.5 Pro |
| OSWorld 2.0 | 62.6% | 真实操作系统操作,算力仅 Opus 4.8 的 15% |
| Terminal-Bench 2.1 | 88.8%(单 agent)/ 91.9%(Ultra) | 终端任务领先 |
| AA Coding Agent Index | 80 | 编码智能体指数第一 |
| AA Intelligence Index | 59(max reasoning) | 仅落后 Fable 5(59.9)1 分 |
3. 105 万 token 上下文 + 缓存优化
SOL 档支持 105 万 token 上下文窗口(最大输入约 92 万),配合缓存命中价仅 $0.50/M,长任务和重复 prompt 场景的成本大幅下降。
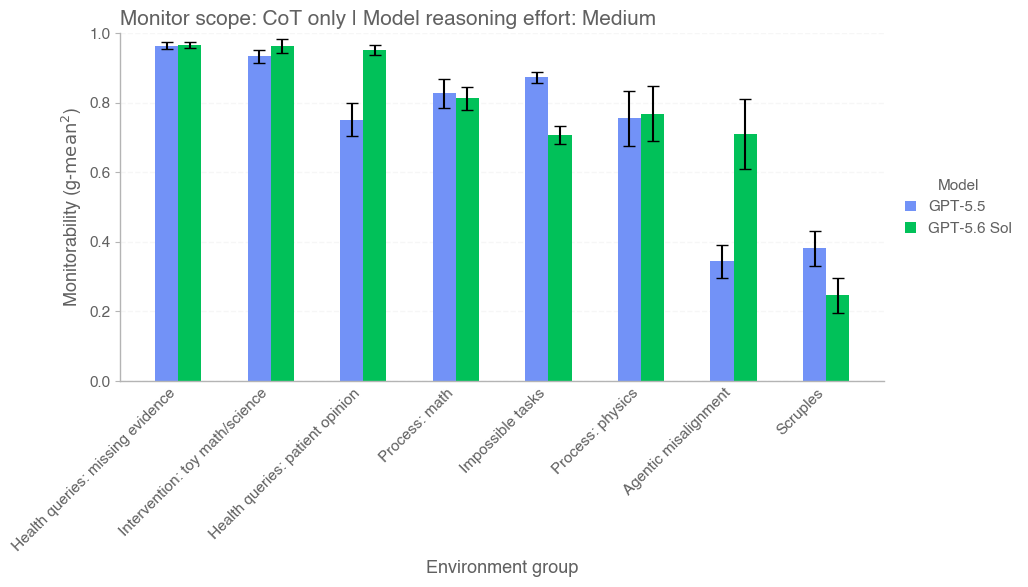
值得注意的是,GPT-5.6 在 AA Intelligence Index(59) 上仅比 Claude Fable 5(59.9)低 1 分,但在 AA Coding Agent Index(80) 上领先——说明它不是"纯推理王",而是"能干活之王"。选型时这个区别很关键。
二、GPT-5.6 SOL vs 上一代 GPT 5.5:公开实测怎么看?
光看跑分不够直观。下面用公开第三方评测的方向性结论,把 SOL Pro 和上一代 5.5、以及同档旗舰在具体维度上做个对比。以下结论来自公开第三方评测,非本站实测。
表 1:相对上一代 GPT 5.5 的提升
| 对比维度 | GPT-5.6 SOL Pro | GPT 5.5 | 提升方向 |
|---|---|---|---|
| Agent / 长程任务 | 大幅领先 | 强 | 代际提升 |
| Coding(SWE/Terminal) | 第一梯队 | 强 | 显著增强 |
| 网页检索(BrowseComp) | 92.2%(SOTA) | 90.1% | 新 SOTA |
| 纯推理(AA Index) | 59 | 强 | 接近持平 |
| 输入价格($/M) | 5 | 5 | 同档 |
| 输出价格($/M) | 30 | 30 | 同档 |
来源:公开第三方评测,2026-07
这对开发者意味着什么:GPT-5.6 相比 5.5 的提升集中在 Agent 和 Coding 实战,而不是传统学术推理。如果你的场景是"让 AI 独立跑完一个多步任务"(数据抓取、自动化运维、深度研究),SOL Pro 是目前最强的选择之一。
表 2:与同档旗舰 Claude Fable 5 / Opus 4.8 的取舍
| 对比维度 | GPT-5.6 SOL Pro | Claude Fable 5 | Claude Opus 4.8 | 结论 |
|---|---|---|---|---|
| 纯推理(AA Index) | 59 | 59.9 | 强 | Fable 5 略胜 |
| Coding Agent Index | 80 | 强 | 强 | SOL Pro 领先 |
| OSWorld(系统操作) | 62.6% | 强 | 强 | SOL Pro 领先 |
| 输入价格($/M) | 5 | 5 | 5 | 同档 |
| 输出价格($/M) | 30 | 25 | 25 | Claude 略便宜 |
来源:OpenAI / Anthropic 官方发布与公开评测,2026-07
这对开发者意味着什么:旗舰之间的差距不是"谁碾压谁",而是"各自的主场不同"。SOL Pro 在 Agent/Coding 实战上领先,Fable 5 在纯推理上略胜,Opus 4.8 在可靠性与工程交付上有口碑。按你的任务类型选,比死磕榜单更实用。
三、它值多少钱?实时价格
价格组件显示美元基准价,token 价格按每百万 token 标注;实际分组倍率、缓存、阶梯与按次单位请核对完整价格页,人民币充值折算以充值页和账单为准。
为了直观对比 SOL Pro 在旗舰阵营里的位置,这里把它和 GPT 5.5、Claude Opus 4.8、Claude Fable 5 横向放一起:
旗舰模型价格对比(GPT-5.6 SOL Pro / GPT 5.5 / Claude Opus 4.8 / Claude Fable 5)
美元基准价 · token 价按每百万标注;其他计费方式见价格页
| 模型 | 厂商 | 类型 | 输入 | 输出 |
|---|---|---|---|---|
| gpt-5.6 | — | — | —/百万token | —/百万token |
| gpt-5.5 | — | — | —/百万token | —/百万token |
| claude-opus-4-8 | — | — | —/百万token | —/百万token |
| claude-fable-5 | — | — | —/百万token | —/百万token |
这笔账要算清
旗舰档单价明显更高。不要用它跑日常闲聊和简单任务——那是 Terra/Luna 档或 mini 的主场。SOL Pro 的正确用法是:高价值、低容错的 Agent 工作流(多步任务、深度研究、复杂工程交付)。
四、国内怎么调用?
apizt 已接入 GPT-5.6 SOL Pro(模型名 gpt-5.6),高速直连无需翻墙,4 步接入几分钟跑通第一次调用:
4 步跑通 · GPT-5.6 SOL Pro
兼容 OpenAI SDK 与常用工具,高速直连
注册账号
Google 或 GitHub 账号直接登录
复制 API Key
控制台创建令牌即可使用
配置 Base URL
兼容 OpenAI SDK 与常用工具
验证首次调用
核对实际回答与控制台日志
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ["tokenba_API_KEY"],
  base_url="https://api.apizt.com/v1"
)

response = client.chat.completions.create(
  model="gpt-5.6",
  messages=[{"role": "user", "content": "你好"}]
)

print(response.choices[0].message.content)该示例未执行此模型调用。请核对真实回答、状态码和控制台记录。
核对这个型号的请求与结果
本站绘制的内容说明图:这是本篇展示的短文本连通性示例;未执行该型号调用,不能代替完整任务、工具功能或效果测试。
五、该不该用它?
基于官方数据和公开评测,给你一个判断框架:
| 你的场景 | 推荐 | 理由 |
|---|---|---|
| Agent / 长程多步任务 | GPT-5.6 SOL Pro | BrowseComp 92.2% SOTA,长程执行强 |
| 真实系统操作(OSWorld 类) | GPT-5.6 SOL Pro | 62.6%,算力仅 Opus 的 15% |
| 深度研究 / 自动化运维 | GPT-5.6 SOL Pro | AA Coding Agent Index 80 第一 |
| 极致纯推理(数学/逻辑) | Claude Fable 5 | AA Index 59.9 略胜 |
| 关键工程交付(零幻觉) | Claude Opus 4.8 | 可靠性有口碑 |
| 日常对话 / 简单任务 | Terra/Luna 或 mini 档 | 旗舰过剩,浪费成本 |
一句话总结:GPT-5.6 SOL Pro 是 OpenAI 对"大模型下一战场"的明确回答——从刷学术分转向独立干活。当你的任务复杂到需要模型自己拆解、调度、执行多步时,它就是目前最强的选择之一。但如果只是单轮推理或日常问答,更便宜的档位完全够用。
注册 apizt 后送的免费额度,足够你拿自己的真实 Agent 任务验证——用自己的数据做决定,比看任何评测都准。
信息来源:本文能力描述来自 OpenAI GPT-5.6 官方发布、GPT-5.6 系统卡、开发者定价文档及公开第三方评测,非本站实测。价格数据为发布当日(2026-07-22)apizt 控制台快照,最新价格请以控制台价格页为准。
操作与使用问题
GPT-5.6 SOL Pro 的档位名称与 model ID 如何核对?
以请求服务的目录和原文来源分别记录产品名与准确 ID,不自行删后缀或将档位混用。客户端参数和账单也按实际调用型号核对。
GPT-5.6 长上下文和缓存资料能直接估算 Agent 总价吗?
需要实际缓存命中、输入长度、工具回合与重试记录。发布说明仅是规则背景,完整费用以目标通道计价和控制台实扣为准。
把选好的模型,接入你的应用
从 Claude、GPT、Gemini 等模型中选择所需能力。获取 API Key,按工具配置接口地址,再用一个小请求确认结果和费用。
创建 API Key
在控制台创建令牌,选择需要使用的模型权限。
填写接入配置
按工具要求填写 API Key、接口地址与模型 ID。
发起第一次调用
确认收到有效结果,再到控制台查看用量与费用。
继续阅读
GPT-6 Astra 评测解读:推理基准、Computer Use 与证据
GPT-6 Astra 评测需要把推理基准和 Computer Use 分成各自的能力范围。本文整理既有公开资料;使用搜索或电脑工具前应确认客户端与通道,实际操作保留执行与恢复记录。
Wan 3.0 Video 评测解读:长镜头、音画与按秒费用
Wan 3.0 Video 评测应把长镜头、音画同步和参考素材的目标写成验收表。本文整理原有视频公开资料;榜单位置与当前通道稳定性不同,真实成片需下载播放并按时长核对费用。
DeepSeek V4 Pro 0813 评测解读:版本快照、长上下文与接口
DeepSeek V4 Pro 0813 评测按 0813 快照资料阅读稀疏注意力、长上下文和编码任务。快照名称与网关 ID 的关系必须单独核对,不能把公开原生 Responses 能力当作当前网关已透传。