
发布解读,非本站实测。 本文依据公开资料整理,未完成本文模型的付费接口测试。厂商基准只适用于其公布的版本、数据集与条件;未提供可复核来源、原始值及换算方法的衍生评分已撤下。 阿里通义的 Max 系列过去一直有个遗憾:性能强,但不开源。Qwen3.8-Max 把这个遗憾一起解决了——2.4 万亿总参数(95B 激活)的 MoE 旗舰、100 万 token 上下文,并且官方宣布将首次开源 Max 级权重。
跑分端的叙事更直接:Terminal Bench 2.1 拿 86.6,同时超越 Claude Opus 4.8(84.6)和 Fable 5(84.6);PaperBench 93.0、OSWorld-Verified 86.1 均为官方对比表第一。国产旗舰第一次在"长程 Agent + 真实系统操作"这类硬指标上集体压过海外旗舰。
说明
本文的能力描述来自阿里通义官方发布与公开基准,非本站实测。涉及的能力结论均标注来源,价格数据为 apizt 控制台实时值。建议你用注册赠送的额度,拿自己的真实任务验证。
一、Qwen3.8-Max 在卷什么?官方公布的三件事
根据 通义千问官方博客(2026-08-03),升级重点可以归纳成三个方向。
1. 2.4T 参数 + 95B 激活:国产最大开源旗舰
2.4 万亿总参数、95B 激活的 MoE 架构,官方同时宣布将开源 Max 级权重(Apache 风格许可)——这是通义历史上第一次把"闭源旗舰"开源。
2. 100 万上下文 + 常开推理
原生 100 万 token 上下文,推理常开(默认 xhigh 档),thinking budget 最高 163,840 token。对超长代码仓库、长文档研究这类任务,"1M 上下文 + 常开推理"是硬需求组合。
3. 真实任务基准集体登顶
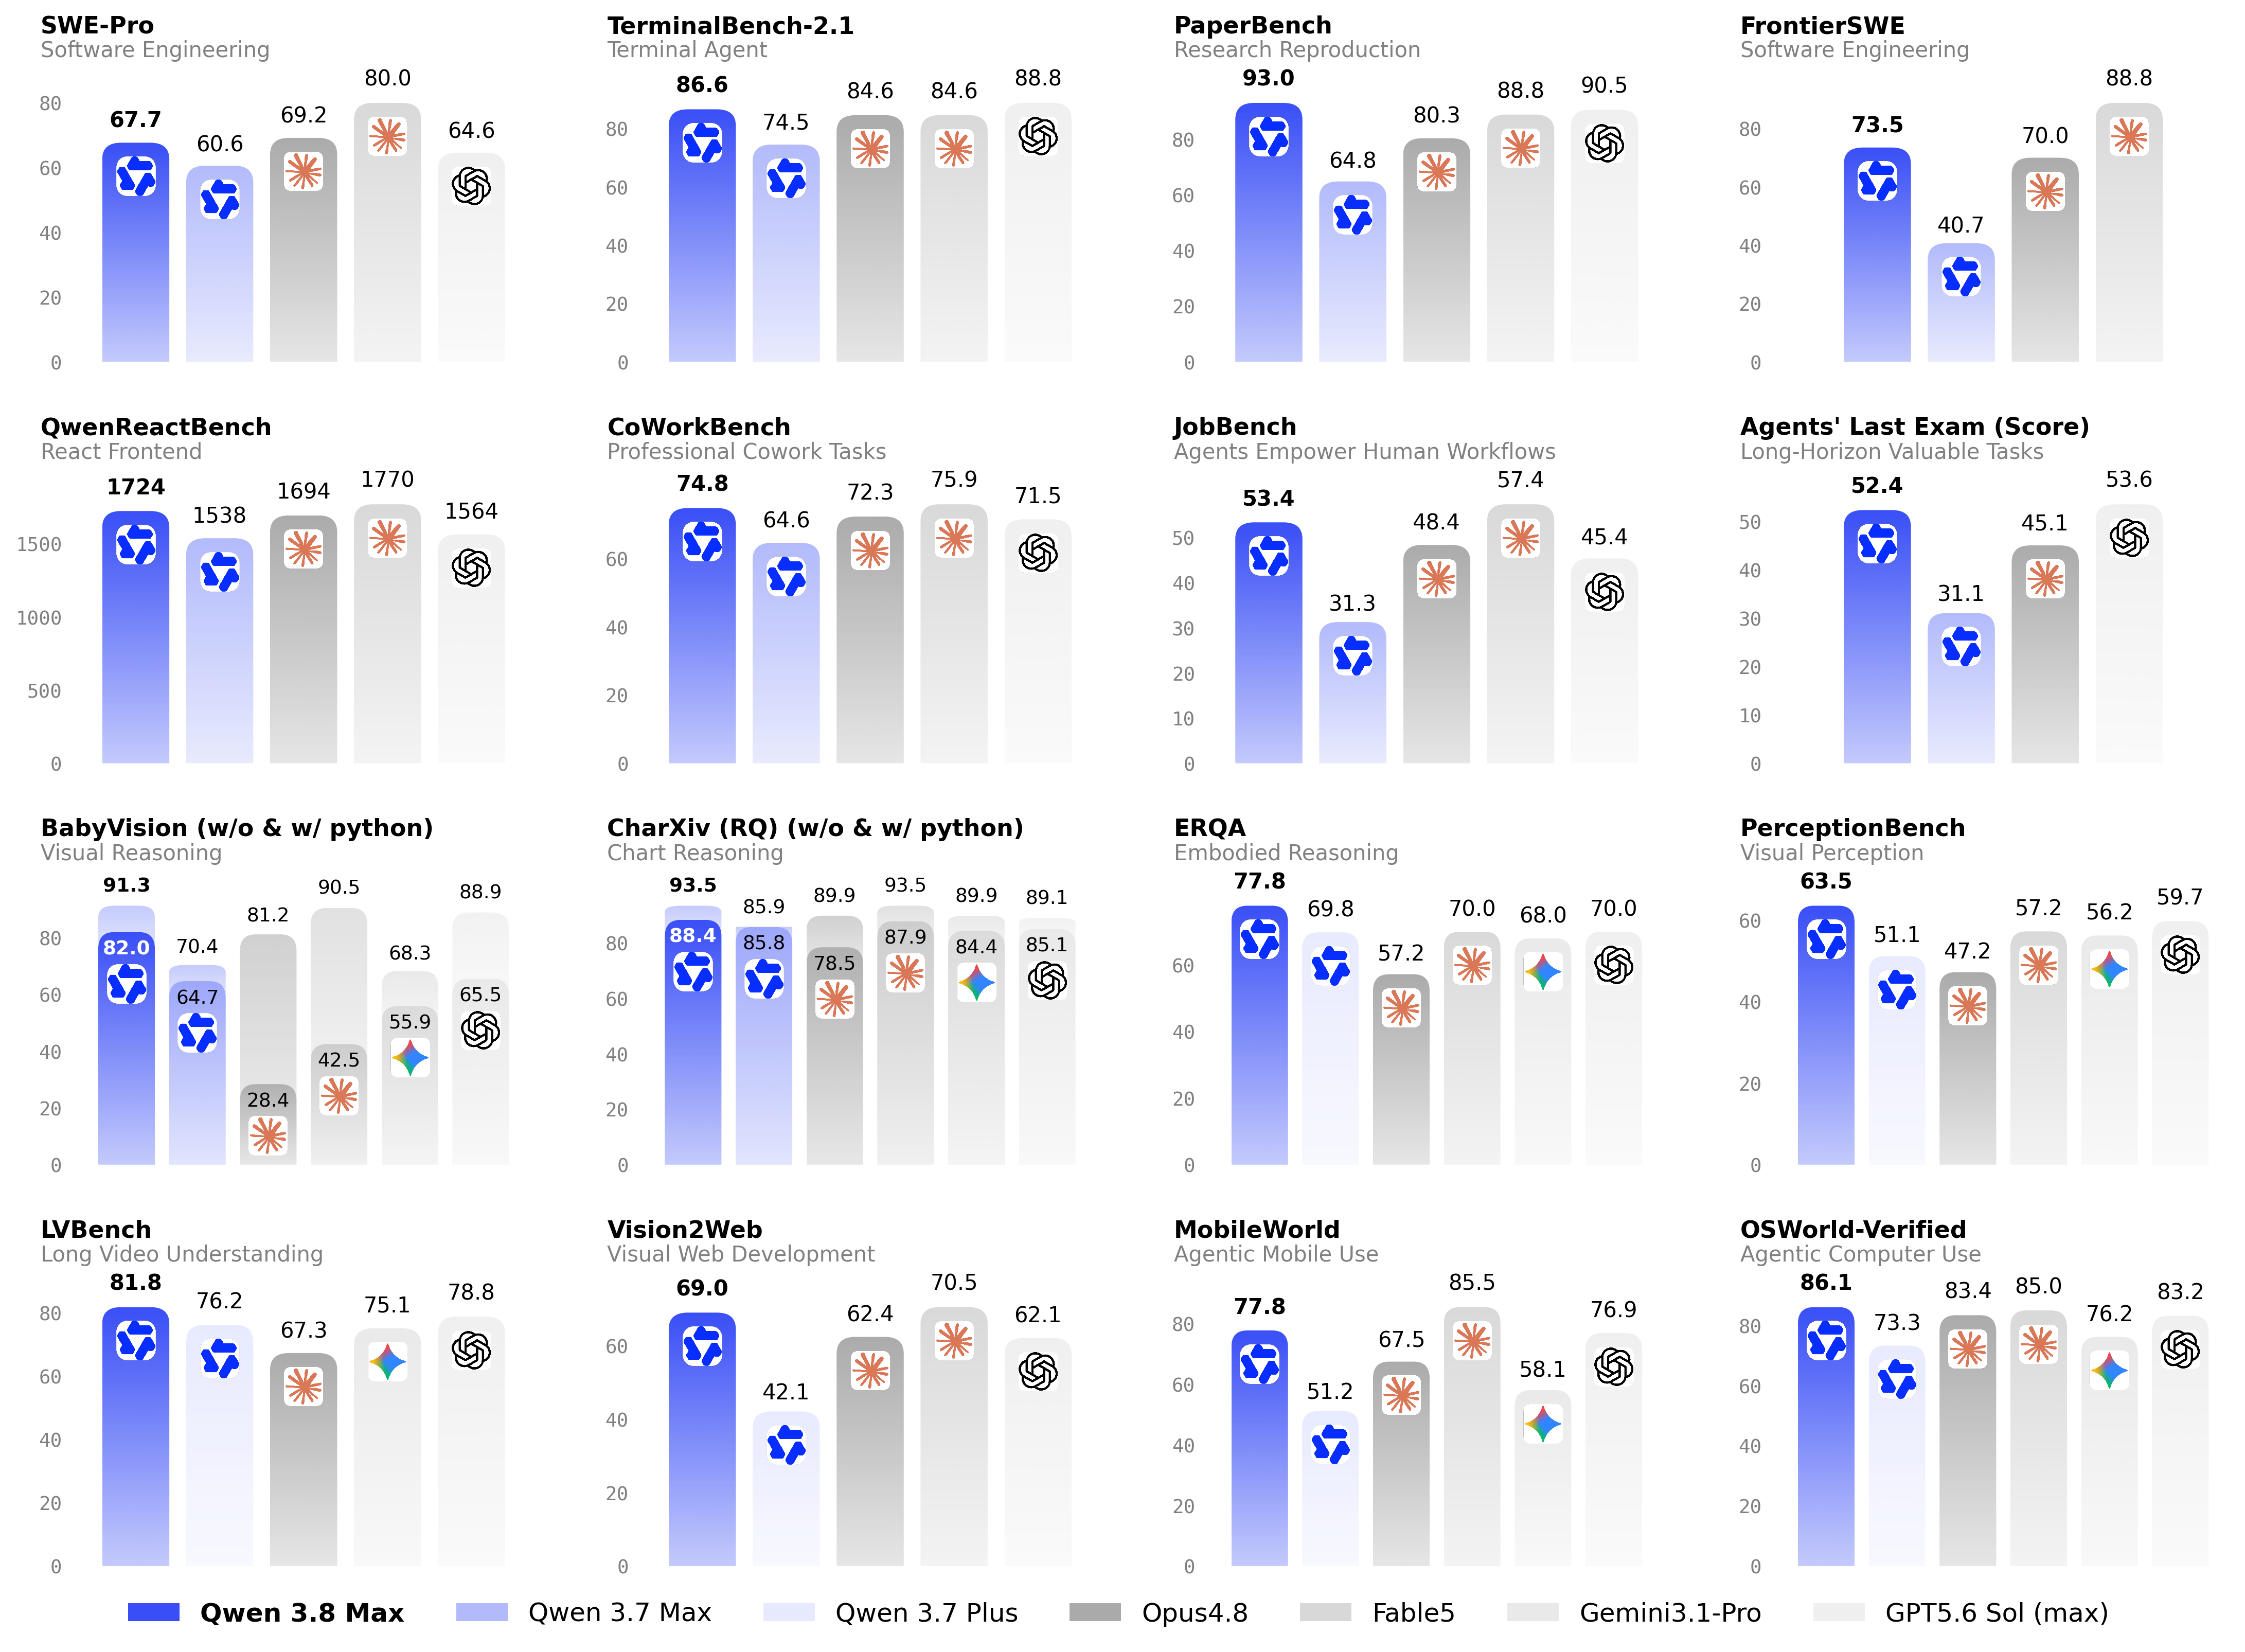
官方公布的关键基准成绩:
| 基准 | Qwen3.8-Max | 对比 |
|---|---|---|
| Terminal Bench 2.1 | 86.6 | Opus 4.8 = 84.6,Fable 5 = 84.6 |
| PaperBench | 93.0 | Fable 5 = 88.8,GPT-5.6 Sol = 90.5 |
| OSWorld-Verified | 86.1 | 对比表第一 |
| IFBench | 82.8 | 对比表第一 |
| WideSearch | 81.9 | 对比表第一 |
| SWE-bench Pro | 67.7 | Claude Code harness 第一 |
| GPQA | 92.6 | 第一梯队 |
| HLE | 43.6 | 第一梯队 |
二、Qwen3.8-Max vs 旗舰阵营:公开实测怎么看?
以下结论来自公开第三方评测与官方数据,非本站实测。
表 1:相对上一代 Qwen 3.7 Max 的提升
| 对比维度 | Qwen3.8-Max | Qwen 3.7 Max |
|---|---|---|
| 参数规模 | 2.4T(95B 激活) | 更小 |
| 上下文 | 100 万 | 更小 |
| Terminal Bench 2.1 | 86.6 | 未上榜 |
| 开源 | Max 级首次开源 | 未开源 |
| 输入/输出价($/M) | 2 / 6 | 接近 |
来源:通义官方发布,2026-08
表 2:与海外/国产旗舰的取舍
| 对比维度 | Qwen3.8-Max | Claude Opus 5 | Kimi K3 |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 更低 | 88.3(v2.0 口径) |
| OSWorld | 86.1(第一) | 强 | — |
| 输入/输出价($/M) | 2 / 6 | 5 / 25 | 3 / 15 |
| 开源 | 是(即将) | 否 | 2.8T 开源 |
| 上下文 | 100 万 | 100 万 | 100 万 |
来源:各厂商官方发布,2026-08
这对开发者意味着什么:Qwen3.8-Max 用 Opus 5 约 1/4 的价格拿到了多项真实任务第一。加上即将开源,"可自部署 + 旗舰性能 + 国产价格"三件事同时到位。
三、它值多少钱?实时价格
旗舰模型价格对比(Qwen3.8-Max / Qwen 3.7 Max / Claude Opus 5 / Kimi K3)
美元基准价 · token 价按每百万标注;其他计费方式见价格页
| 模型 | 厂商 | 类型 | 输入 | 输出 |
|---|---|---|---|---|
| qwen3.8-max | — | — | —/百万token | —/百万token |
| qwen3.7-max | — | — | —/百万token | —/百万token |
| claude-opus-5 | — | — | —/百万token | —/百万token |
| kimi-k3 | — | — | —/百万token | —/百万token |
这笔账要算清
- 真实任务首选 3.8-Max:Terminal Bench / OSWorld / PaperBench 三项第一,价格仅 Opus 5 的约 1/4。
- 等开源再私有化:权重开源后可自部署,数据敏感场景的终局方案。
- 注意长上下文阶梯价:部分区域超 32K/128K 输入有阶梯加价,超长任务先算 token 账。
四、国内怎么调用?
4 步跑通 · Qwen3.8-Max
兼容 OpenAI SDK 与常用工具,高速直连
注册账号
Google 或 GitHub 账号直接登录
复制 API Key
控制台创建令牌即可使用
配置 Base URL
兼容 OpenAI SDK 与常用工具
验证首次调用
核对实际回答与控制台日志
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ["tokenba_API_KEY"],
  base_url="https://api.apizt.com/v1"
)

response = client.chat.completions.create(
  model="qwen3.8-max",
  messages=[{"role": "user", "content": "你好"}]
)

print(response.choices[0].message.content)该示例未执行此模型调用。请核对真实回答、状态码和控制台记录。
核对这个型号的请求与结果
五、该不该用它?
| 你的场景 | 推荐 | 理由 |
|---|---|---|
| 长程 Agent / 终端任务 | Qwen3.8-Max | Terminal Bench 86.6 超双旗舰 |
| 真实系统操作 | Qwen3.8-Max | OSWorld 86.1 第一 |
| 超长文档 / 大仓库 | Qwen3.8-Max | 1M 上下文 + 常开推理 |
| 极限抽象推理 | Claude Opus 5 | ARC-AGI 3 断层领先 |
| 要自部署 + 开源 | Qwen3.8-Max / Kimi K3 | 两者都开源,按价格选 |
| 日常轻任务 | 更便宜的 Flash 档 | 旗舰过剩 |
一句话总结:Qwen3.8-Max 是国产旗舰第一次在"真实任务"维度集体登顶,并顺手补上了开源这块最后的拼图。价格只有海外旗舰的零头,能力却在多个硬指标上反超——如果你的工作流是长程 Agent 和真实系统操作,它值得立刻切换验证。
信息来源:本文能力描述来自 通义千问官方博客、阿里云百炼定价及公开第三方评测,非本站实测。价格数据为发布当日(2026-08-09)apizt 控制台快照,最新价格请以控制台价格页为准。
操作与使用问题
Qwen3.8 Max 的模型规模能保证任务结果正确吗?
不能。对于代码执行固定测试,对于资料分析核对引用和缺信息处理。规模和公开榜单说明特定条件下的资料,不代表你的输入必然通过。
Qwen3.8 Max 普通名称和日期快照可以随意合并吗?
保留准确 ID 和调用时间,分别核对路由、参数与账单。原文发布资料与当前服务快照不能仅凭名称相似认定相同。
查看相关型号
在型号详情中核对最低价格、参数、接口示例与使用限制,再选择配置方式。
把选好的模型,接入你的应用
从 Claude、GPT、Gemini 等模型中选择所需能力。获取 API Key,按工具配置接口地址,再用一个小请求确认结果和费用。
创建 API Key
在控制台创建令牌,选择需要使用的模型权限。
填写接入配置
按工具要求填写 API Key、接口地址与模型 ID。
发起第一次调用
确认收到有效结果,再到控制台查看用量与费用。
继续阅读
Grok 4.7 评测解读:长程编码、同价资料与 Token 用量
Grok 4.7 评测要同时阅读公开编码成绩和长任务用量。本文保留发布资料;同价说明不保证同一任务账单相同,应在相同工具环境记录最终交付、延迟和全部 Token。
GPT-6 Sol 评测解读:编码、缓存与完整任务账单
GPT-6 Sol 评测要先看有效代码结果,再阅读公开定价和缓存说明。本文的版本资料不表示所有通道都享有相同缓存规则;完整成本包括工具回合、失败重试与输出预算。
GPT Image 2.5 评测解读:Flare、Sunburst 与多轮编辑
GPT Image 2.5 评测必须区分 Flare 与 Sunburst 的准确型号,并把速度和细节分别验收。本文解读公开图像资料;多轮编辑每步保存原图、输出、参数与费用,防止越改越偏。