正在打开页面…
正在加载内容,请稍候。
正在打开页面…
正在加载内容,请稍候。
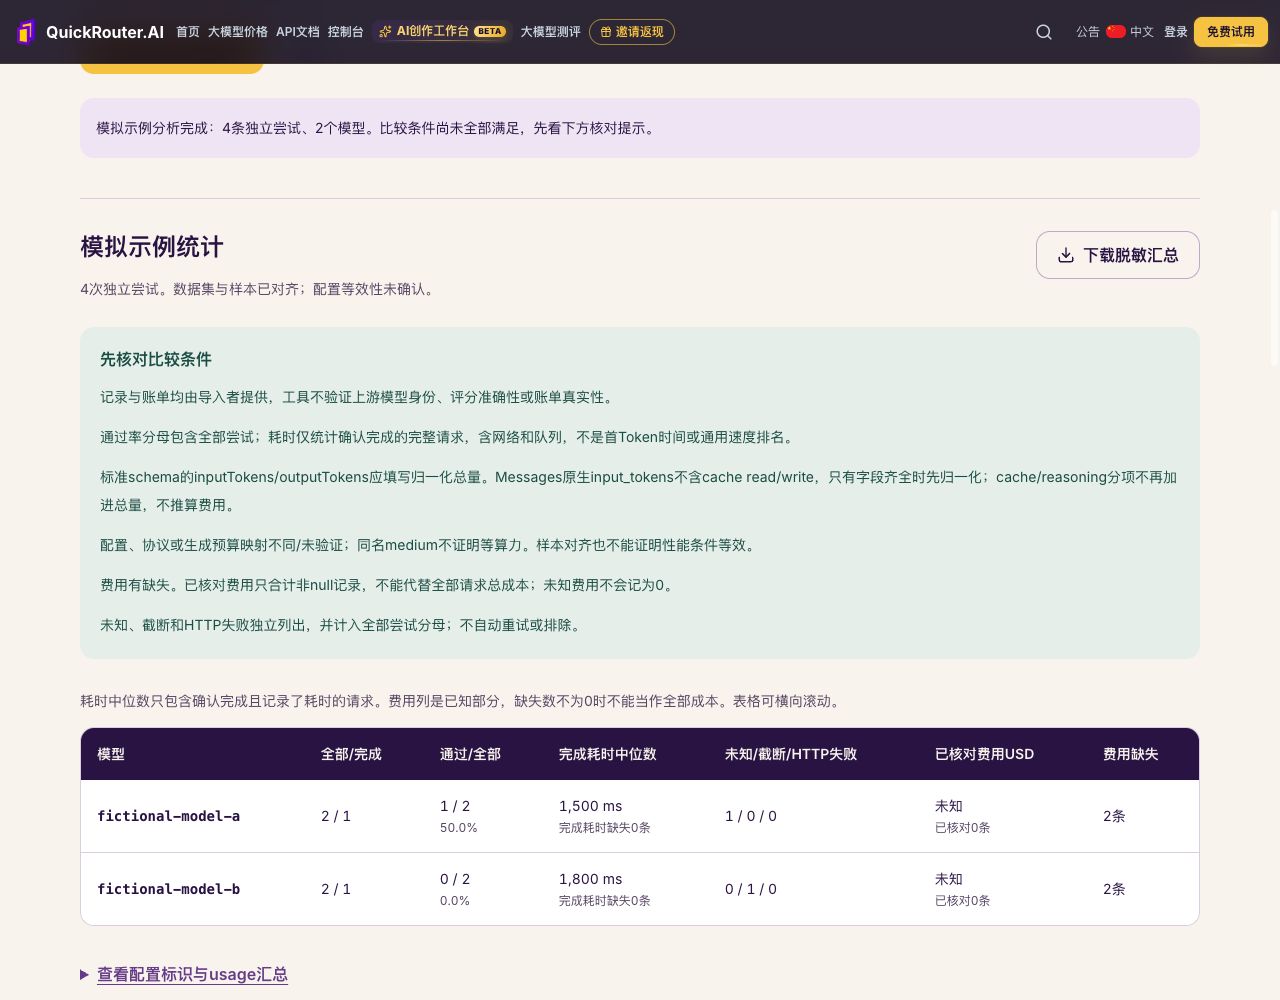
大模型评测结果分析器在浏览器内校验独立尝试记录,检查样本和配置能否比较。统计全部尝试通过率、完整请求耗时中位数与已核对费用,保留失败、未知和缺失账单,再下载脱敏汇总。
你的输入只在当前浏览器内处理,不放入 URL,不上传、不保存,也不自动调用 API。刷新页面后清空你的输入。
最多1MiB / 10,000条。至少两个不同模型;每次尝试有独立trialId。已核对金额填billedUsd,未知填null,不要填估价。
导出仅保留支持的状态、数值与配置/模型标识,不包含输入原文或未知字段。先移除尚未提交的占位记录;未知提交状态应保留为unknown。
已填入虚构模拟示例,尚未分析、没有真实调用或费用。请点击分析,或替换为脱敏记录。
至少需要两个不同模型,并为每条独立尝试填写trialId、model、datasetId、sampleId、configId及对应配置。数据集、样本集合或重复尝试数不齐时,统计可用于核对各自记录,不能直接得出横向结论。
全部尝试通过率=明确通过数÷全部记录数。完成请求耗时只统计status为completed且有elapsedMs的记录,包含网络和队列,不是首Token延迟。重复trialId拒绝整份导入;真实重试使用新ID,不能覆盖原尝试。
billedUsd只能填已逐条核对的实际金额,未知填null。费用不齐不能当作总成本。标准schema的inputTokens/outputTokens是归一化总量:Messages原生input_tokens不含cache read/write,字段齐全时先加进总input,无法归一化则填null。cache/reasoning分项不再重复加进总量,也不据此估价。
支持20261009同档主力原始summary.json的明确格式,映射trial_id、任务/样本、协议、选定请求参数和既有usage数值。其他JSON或报告需转换为标准schema,不会把任意答案当作测试记录。
不会。样本对齐、预算映射和实际任务评分都要核对;相同medium也不能证明等算力。结果用于这份测试的记录检查,不生成冠军或通用能力排名。
不需要。只粘贴脱敏元数据、数值、状态与配置标识;不包含请求素材、答案、Key、响应ID或错误原文。工具不上传、不存储,汇总仅保留允许的元数据字段。
选择支持所需接口的准确型号,用 apizt API Key 完成首个任务,再核对响应与控制台记录。