
展开本页目录
开始前准备什么
- 独立练习目录及Python 3.14;系统与Node依赖以README为准。
- 离线重放无需Key;新请求使用自己的apizt Key,先核对模型权限和当前价格。
- 原创合成材料,不需要登录第三方平台账号。
- 先看文件
- 按步骤操作
- 对照真实结果
- 离线或模型复跑
默认离线重放;包含完整失败尝试与本地检查,不含Key。
1. 核对本例材料与目标文件
参见本批TOPIC-RESEARCH.md同编号新增边界,原生小样与负例均独立交付。
先下载合成材料在独立目录练习。原始文件、模型输入与验收答案分别保留;本地核对答案不发送给模型。
input.json(节选)
{
  "tickets": [
    {
      "id": "T01",
      "text": "退款还没到账"
    },
    {
      "id": "T02",
      "text": "想退回未开封商品"
    },
    {
      "id": "T03",
      "text": "退款金额需要核对"
    },
    {
      "id": "T04",
      "text": "取消订单后退款"
    },
    {
      "id": "T05",
      "text": "快递到哪了"
    },
    {
      "id": "T06",
      "text": "物流显示异常"
    },
    {
      "id": "T07",
      "text": "包裹迟到了"
    },
    {
      "id": "T08",
      "text": "需要改快递地址"
    },
    {
      "id": "T09",
      "text": "请开电子发票"
    },
    {
      "id": "T10",
      "text": "发票抬头写错"
    },
    {
      "id": "T11",
      "text": "发票什么时候发"
    },
    {
      "id": "T12",
      "text": "重开发票"
    }
  ]
}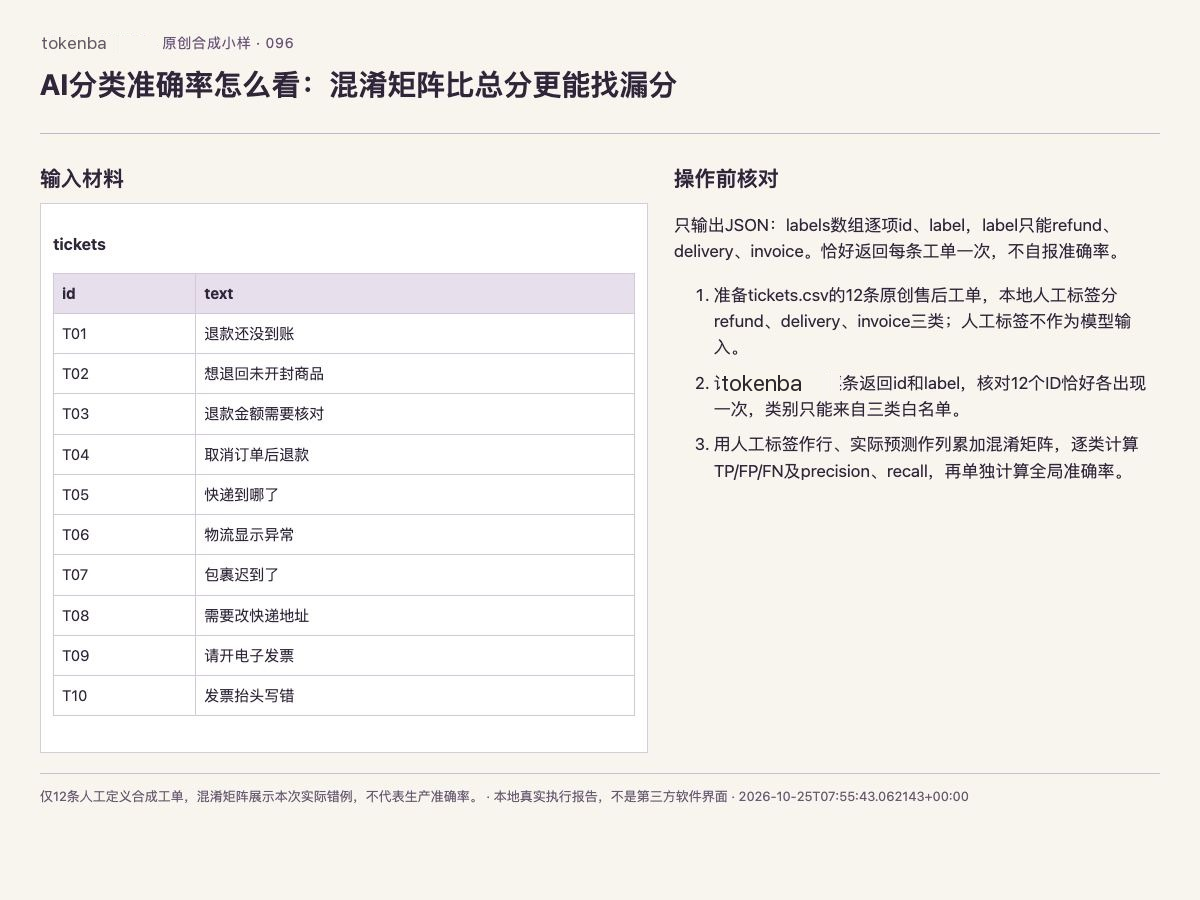
实际输入、原始文件和本例操作约束的浏览器截图
2. 按顺序完成这项具体操作
本次实际使用Python 3.14,依赖版本固定在资料包。需要LibreOffice或Node的案例请先按README安装对应运行时。python run.py读取真实旧响应完成本地处理;只有显式--live才发新请求。
- 1. 准备tickets.csv的12条原创售后工单,本地人工标签分refund、delivery、invoice三类;人工标签不作为模型输入。
- 2. 让apizt逐条返回id和label,核对12个ID恰好各出现一次,类别只能来自三类白名单。
- 3. 用人工标签作行、实际预测作列累加混淆矩阵,逐类计算TP/FP/FN及precision、recall,再单独计算全局准确率。
- 4. 生成confusion-matrix.png、class-metrics.csv和ticket-predictions.csv,保留每一条实际错误,不挑掉不利样本。
- 5. 核对矩阵总数等于有效分类数;本任务通过表示计算和产物验收通过,不表示模型答题100%,也不代表生产分布表现。
独立练习目录 · 默认仅离线复核
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
python run.py
3. 对照真正发送的请求
只输出JSON:labels数组逐项id、label,label只能refund、delivery、invoice。恰好返回每条工单一次,不自报准确率。
网页实验台只执行这一步模型字段检查。原生文件写入、坐标/公式/格式回读及负例验收由下载包负责。
request-1.json(图片Base64省略,原文件在下载包)
{
  "model": "gemini-2.5-flash-lite",
  "messages": [
    {
      "role": "system",
      "content": "严格只输出单个JSON对象,不要Markdown代码围栏,不要解释。只输出JSON:labels数组逐项id、label,label只能refund、delivery、invoice。恰好返回每条工单一次,不自报准确率。"
    },
    {
      "role": "user",
      "content": "任务约束(只输出JSON对象,不用代码围栏):\n只输出JSON:labels数组逐项id、label,label只能refund、delivery、invoice。恰好返回每条工单一次,不自报准确率。\n待处理合成材料:\n{\"tickets\": [{\"id\": \"T01\", \"text\": \"退款还没到账\"}, {\"id\": \"T02\", \"text\": \"想退回未开封商品\"}, {\"id\": \"T03\", \"text\": \"退款金额需要核对\"}, {\"id\": \"T04\", \"text\": \"取消订单后退款\"}, {\"id\": \"T05\", \"text\": \"快递到哪了\"}, {\"id\": \"T06\", \"text\": \"物流显示异常\"}, {\"id\": \"T07\", \"text\": \"包裹迟到了\"}, {\"id\": \"T08\", \"text\": \"需要改快递地址\"}, {\"id\": \"T09\", \"text\": \"请开电子发票\"}, {\"id\": \"T10\", \"text\": \"发票抬头写错\"}, {\"id\": \"T11\", \"text\": \"发票什么时候发\"}, {\"id\": \"T12\", \"text\": \"重开发票\"}]}"
    }
  ],
  "temperature": 0,
  "max_tokens": 1536,
  "provider": {
    "sort": "success_rate"
  },
  "response_format": {
    "type": "json_object"
  }
}4. 查看原生处理代码与实际文件
下面节选来自本次实际执行的workflow.py分支,需要结合完整脚本运行。模型输出不能代替文件解析器或业务验算。
具体产物:class-metrics.csv、ticket-predictions.csv、confusion-matrix.png。
workflow.py · 本例分支节选
labels = {r.get('id'): r.get('label') for r in output.get('labels', [])}
expected = {r['id']: 'refund' if n < 4 else 'delivery' if n < 8 else 'invoice' for n, r in enumerate(original['tickets'])}
classes = ['refund', 'delivery', 'invoice']
check('12工单各分类一次且类别受控', set(labels) == set(expected) and len(output.get('labels', [])) == 12 and all((v in classes for v in labels.values())))
matrix = [[0] * 3 for _ in classes]
predictions = []
for key, gold in expected.items():
    guess = labels.get(key)
    predictions.append({'id': key, 'gold': gold, 'predicted': guess, 'correct': gold == guess})
    if guess in classes:
        matrix[classes.index(gold)][classes.index(guess)] += 1
metrics = []
for j, cls in enumerate(classes):
    tp = matrix[j][j]
    fp = sum((matrix[k][j] for k in range(3) if k != j))
    fn = sum((matrix[j][k] for k in range(3) if k != j))
    metrics.append({'class': cls, 'tp': tp, 'fp': fp, 'fn': fn, 'precision': tp / (tp + fp) if tp + fp else None, 'recall': tp / (tp + fn) if tp + fn else None})
check('混淆矩阵总数等于有效分类数', sum(map(sum, matrix)) == sum((v in classes for v in labels.values())))
check('宏平均与全局准确率分别计算', len(metrics) == 3)
write_csv(artifact('class-metrics.csv'), metrics)
write_csv(artifact('ticket-predictions.csv'), predictions)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
fig, ax = plt.subplots(figsize=(7, 5))
ax.imshow(matrix, cmap='Purples')
ax.set_xticks(range(3), classes)
ax.set_yticks(range(3), classes)
ax.set_xlabel('Predicted')
ax.set_ylabel('Human fixture label')
for y in range(3):
    for x in range(3):
        ax.text(x, y, str(matrix[y][x]), ha='center', va='center', color='white' if matrix[y][x] >= 3 else '#291343')
fig.tight_layout()
fig.savefig(artifact('confusion-matrix.png'), dpi=170)
plt.close(fig)
result = {'matrix': matrix, 'classes': classes, 'metrics': metrics, 'accuracy': sum((r['correct'] for r in predictions)) / len(expected), 'errors': [r for r in predictions if not r['correct']], 'evaluationScope': '12 synthetic examples, not general benchmark'}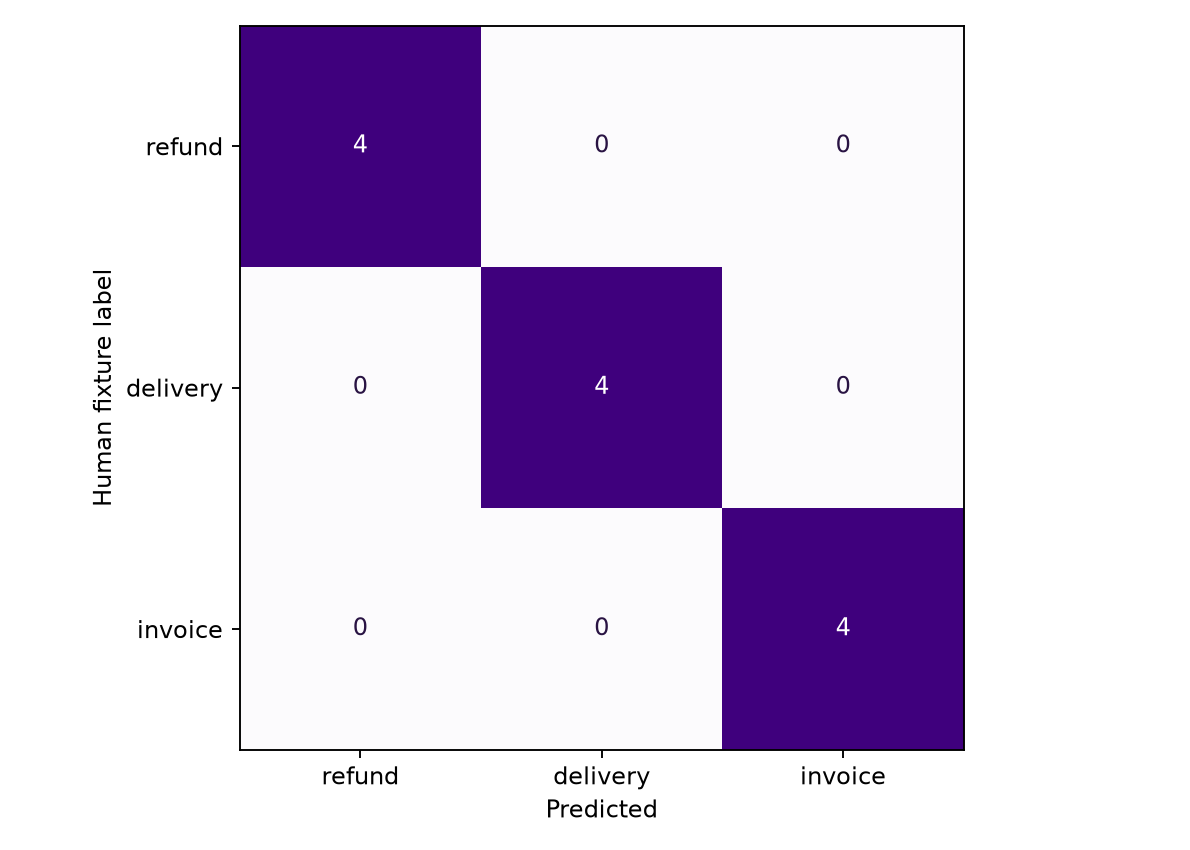
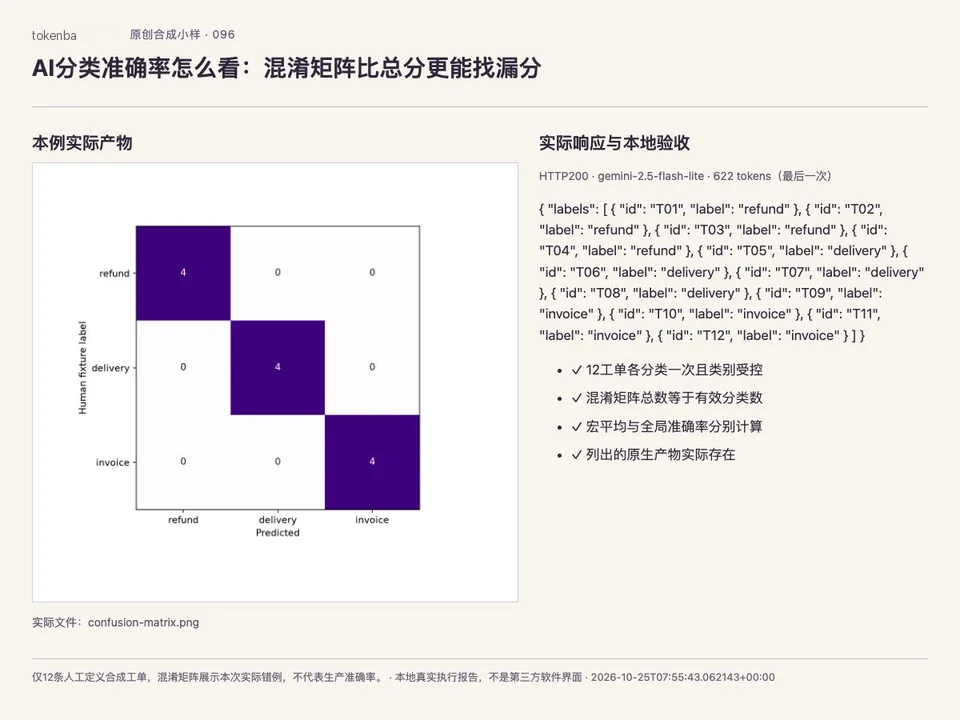
原生文件实际渲染或解码输入:confusion-matrix.png;不是第三方平台截图。
5. 对照真实结果和检查表
实测2026-10-25T07:55:43.062143+00:00,HTTP200;请求gemini-2.5-flash-lite,返回gemini-2.5-flash-lite。本次5/5项检查通过,指本例执行及验收机制通过,不代表所有模型字段零误差。
最后一次返回用量622tokens;1份尝试记录的已知用量合计622。失败记录保留,用量缺失不按0计,本文不推算实际金额。
| 实际检查 | 结果 |
|---|---|
| 真实apizt API响应HTTP200 | 通过 |
| 12工单各分类一次且类别受控 | 通过 |
| 混淆矩阵总数等于有效分类数 | 通过 |
| 宏平均与全局准确率分别计算 | 通过 |
| 列出的原生产物实际存在 | 通过 |
- 实际检查
- 真实apizt API响应HTTP200
- 结果
- 通过
- 实际检查
- 12工单各分类一次且类别受控
- 结果
- 通过
- 实际检查
- 混淆矩阵总数等于有效分类数
- 结果
- 通过
- 实际检查
- 宏平均与全局准确率分别计算
- 结果
- 通过
- 实际检查
- 列出的原生产物实际存在
- 结果
- 通过
result.json · 原生处理后实际结果
{
  "matrix": [
    [
      4,
      0,
      0
    ],
    [
      0,
      4,
      0
    ],
    [
      0,
      0,
      4
    ]
  ],
  "classes": [
    "refund",
    "delivery",
    "invoice"
  ],
  "metrics": [
    {
      "class": "refund",
      "tp": 4,
      "fp": 0,
      "fn": 0,
      "precision": 1.0,
      "recall": 1.0
    },
    {
      "class": "delivery",
      "tp": 4,
      "fp": 0,
      "fn": 0,
      "precision": 1.0,
      "recall": 1.0
    },
    {
      "class": "invoice",
      "tp": 4,
      "fp": 0,
      "fn": 0,
      "precision": 1.0,
      "recall": 1.0
    }
  ],
  "accuracy": 1.0,
  "errors": [],
  "evaluationScope": "12 synthetic examples, not general benchmark"
}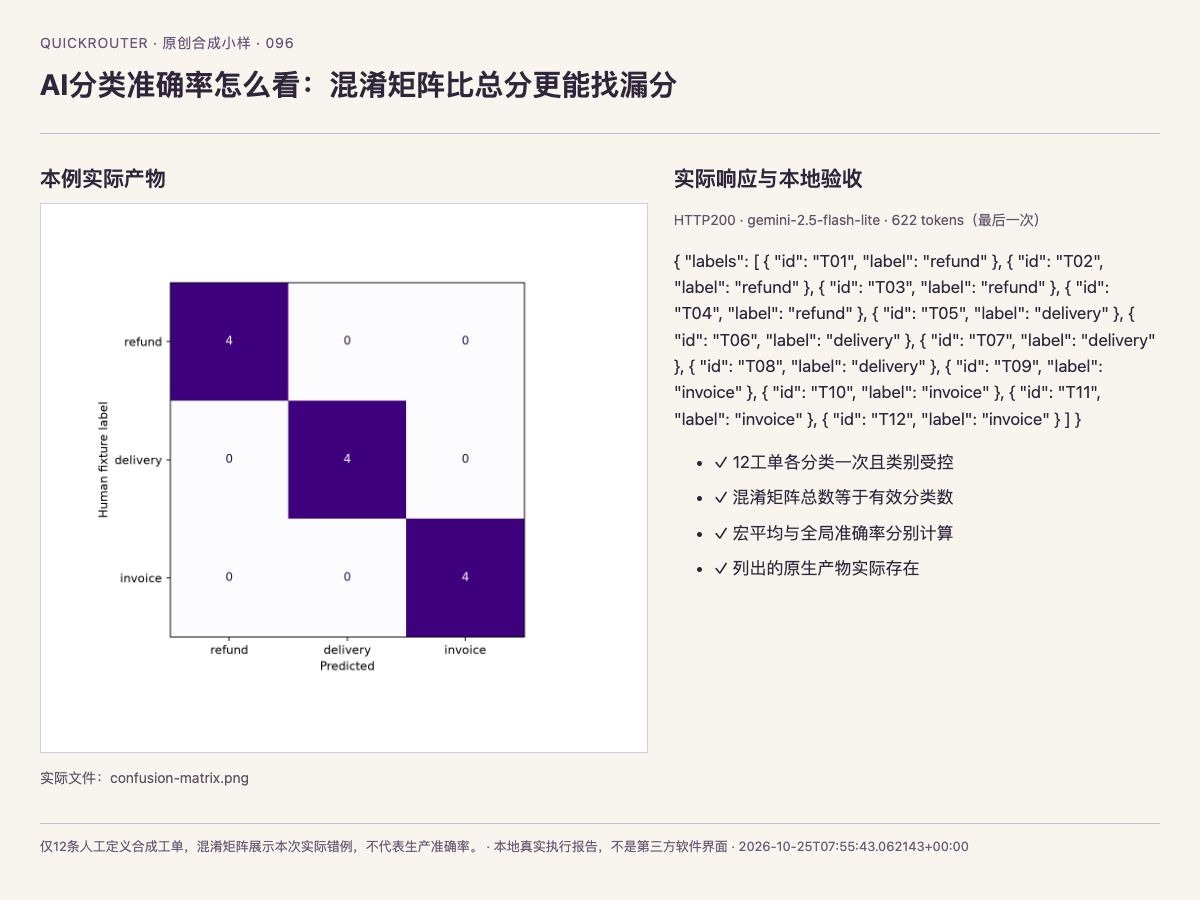
本例实际产物与原始响应的浏览器截图;本地检查和模型答案分开记录
6. 替换输入前,先确认这些边界
仅12条人工定义合成工单,混淆矩阵展示本次实际错例,不代表生产准确率。
修改材料后应重新制定事实断言和反例。识别错误率、混淆矩阵或拒答类教程允许保留模型实际错误;检查通过指计算和处理正确。没有调用视频模型。
怎样确认已经完成
- 真实apizt API响应HTTP200
- 12工单各分类一次且类别受控
- 混淆矩阵总数等于有效分类数
- 宏平均与全局准确率分别计算
- 列出的原生产物实际存在
常见问题
AI 分类 混淆矩阵怎么开始?
准备tickets.csv的12条原创售后工单,本地人工标签分refund、delivery、invoice三类;人工标签不作为模型输入。按本页顺序继续,先用下载包离线重放,再替换自己的材料。
网页试跑和下载包有什么区别?
网页只复跑模型字段,不生成全部原生文件;资料包包含实际原生处理和本地验收。
这次通过结果适用于其他材料吗?
仅12条人工定义合成工单,混淆矩阵展示本次实际错例,不代表生产准确率。