
展开本页目录
开始前准备什么
- 独立练习目录及Python 3.14;系统与Node依赖以README为准。
- 离线重放无需Key;新请求使用自己的apizt Key,先核对模型权限和当前价格。
- 原创合成材料,不需要登录第三方平台账号。
- 先看文件
- 按步骤操作
- 对照真实结果
- 离线或模型复跑
默认离线重放;包含完整失败尝试与本地检查,不含Key。
1. 核对本例材料与目标文件
已有Excel公式、透视、甘特任务;本篇独立交付打印布局副本与实际分页,不再写补货算法。需人工重叠复核。
先下载合成材料在独立目录练习。原始文件、模型输入与验收答案分别保留;本地核对答案不发送给模型。
input.json(节选)
{
  "columns": [
    "产品",
    "数量",
    "金额",
    "内部备注"
  ],
  "rows": [
    [
      "灯A",
      2,
      "100.00",
      "内部合成备注-不对外"
    ],
    [
      "灯B",
      1,
      "60.00",
      "内部合成报价记录"
    ]
  ]
}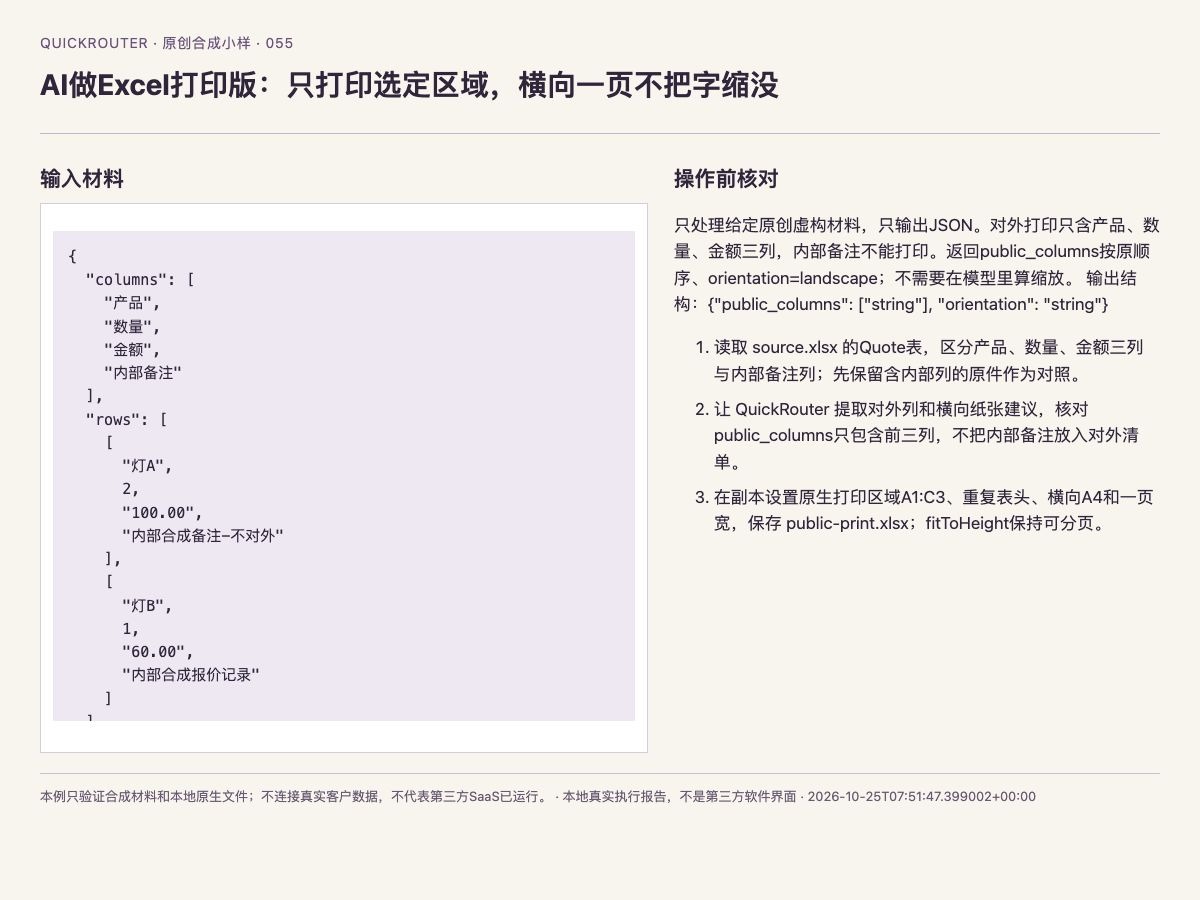
实际输入、原始文件和本例操作约束的浏览器截图
2. 按顺序完成这项具体操作
本次实际使用Python 3.14,依赖版本固定在资料包。需要LibreOffice或Node的案例请先按README安装对应运行时。python run.py读取真实旧响应完成本地处理;只有显式--live才发新请求。
- 1. 读取 source.xlsx 的Quote表,区分产品、数量、金额三列与内部备注列;先保留含内部列的原件作为对照。
- 2. 让 apizt 提取对外列和横向纸张建议,核对public_columns只包含前三列,不把内部备注放入对外清单。
- 3. 在副本设置原生打印区域A1:C3、重复表头、横向A4和一页宽,保存 public-print.xlsx;fitToHeight保持可分页。
- 4. 重新读取XLSX确认打印属性,再用LibreOffice实际导出 public-print.pdf;检查本例PDF确为一页并能读取100.00与60.00。
- 5. 在PDF中检索内部备注及两段私有示例文字,确认未出现;此例的一页结果来自实际渲染,数据增加后须重新检查页数和字体。
独立练习目录 · 默认仅离线复核
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -r requirements.txt
python run.py
3. 对照真正发送的请求
只处理给定原创虚构材料,只输出JSON。对外打印只含产品、数量、金额三列,内部备注不能打印。返回public_columns按原顺序、orientation=landscape;不需要在模型里算缩放。 输出结构:{"public_columns": ["string"], "orientation": "string"}
网页实验台只执行这一步模型字段检查。原生文件写入、坐标/公式/格式回读及负例验收由下载包负责。
request-1.json(图片Base64省略,原文件在下载包)
{
  "model": "gemini-2.5-flash-lite",
  "messages": [
    {
      "role": "system",
      "content": "严格只输出单个JSON对象,不要Markdown代码围栏,不要解释。只处理给定原创虚构材料,只输出JSON。对外打印只含产品、数量、金额三列,内部备注不能打印。返回public_columns按原顺序、orientation=landscape;不需要在模型里算缩放。 输出结构:{\"public_columns\": [\"string\"], \"orientation\": \"string\"}"
    },
    {
      "role": "user",
      "content": "任务约束(只输出JSON对象,不用代码围栏):\n只处理给定原创虚构材料,只输出JSON。对外打印只含产品、数量、金额三列,内部备注不能打印。返回public_columns按原顺序、orientation=landscape;不需要在模型里算缩放。 输出结构:{\"public_columns\": [\"string\"], \"orientation\": \"string\"}\n待处理合成材料:\n{\"columns\": [\"产品\", \"数量\", \"金额\", \"内部备注\"], \"rows\": [[\"灯A\", 2, \"100.00\", \"内部合成备注-不对外\"], [\"灯B\", 1, \"60.00\", \"内部合成报价记录\"]]}"
    }
  ],
  "temperature": 0,
  "max_tokens": 1024,
  "provider": {
    "sort": "success_rate"
  },
  "response_format": {
    "type": "json_object"
  }
}4. 查看原生处理代码与实际文件
下面节选来自本次实际执行的workflow.py分支,需要结合完整脚本运行。模型输出不能代替文件解析器或业务验算。
具体产物:public-print.xlsx、public-print.pdf、result.json、checks.json、preview.html。
workflow.py · 本例分支节选
from openpyxl import load_workbook
from pypdf import PdfReader
source = folder.parent / 'source.xlsx' if (folder.parent / 'source.xlsx').exists() else folder / 'source.xlsx'
wb = load_workbook(source)
ws = wb['Quote']
count = len(output['public_columns'])
check('模型没有选内部备注', output['public_columns'] == ['产品', '数量', '金额'])
ws.print_area = f'A1:C{ws.max_row}'
ws.print_title_rows = '1:1'
ws.page_setup.orientation = 'landscape'
ws.page_setup.paperSize = ws.PAPERSIZE_A4
ws.sheet_properties.pageSetUpPr.fitToPage = True
ws.page_setup.fitToWidth = 1
ws.page_setup.fitToHeight = 0
ws.page_setup.scale = None
wb.save(folder / 'public-print.xlsx')
artifacts.append('public-print.xlsx')
r = load_workbook(folder / 'public-print.xlsx')
check('原生print_area不含D列', 'C3' in str(r.active.print_area).replace('$', '') and 'D' not in str(r.active.print_area).split('!')[-1])
check('原生横向一页宽属性回读', r.active.page_setup.orientation == 'landscape' and r.active.page_setup.fitToWidth == 1)
office = os.environ.get('BATCH100O_SOFFICE', '/Applications/LibreOffice.app/Contents/MacOS/soffice')
with tempfile.TemporaryDirectory(prefix='batch100o-lo-') as temporary_profile:
    profile = Path(temporary_profile)
    command = [office, '-env:UserInstallation=' + profile.resolve().as_uri(), '--headless', '--convert-to', 'pdf', '--outdir', str(folder.resolve()), str((folder / 'public-print.xlsx').resolve())]
    proc = subprocess.run(command, text=True, capture_output=True, timeout=90)
pdf = folder / 'public-print.pdf'
check('LibreOffice实际导出PDF', proc.returncode == 0 and pdf.exists())
if pdf.exists():
    artifacts.append('public-print.pdf')
    reader = PdfReader(pdf)
    text = '\n'.join((page.extract_text() or '' for page in reader.pages))
    check('实际PDF是一页', len(reader.pages) == 1)
    check('内部备注没有进入PDF', all((v not in text for v in ['内部备注', '内部合成备注', '内部合成报价'])))
    check('PDF包含对外数量金额', '100.00' in text and '60.00' in text)
    result = {'print_area': str(r.active.print_area), 'pdf_pages': len(reader.pages), 'pdf_text': text, 'engine': 'LibreOffice headless实际导出'}
else:
    result = {'native_config_saved': True, 'render_failed': proc.stderr or proc.stdout}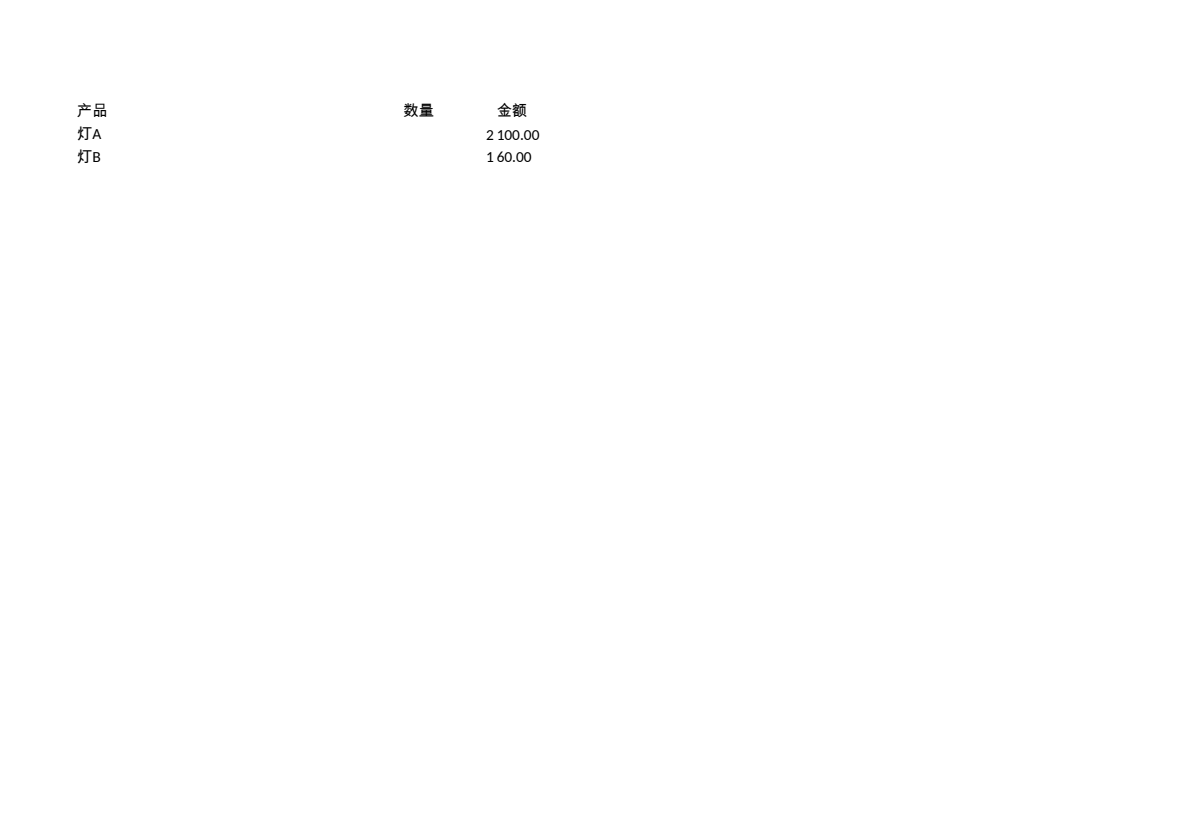
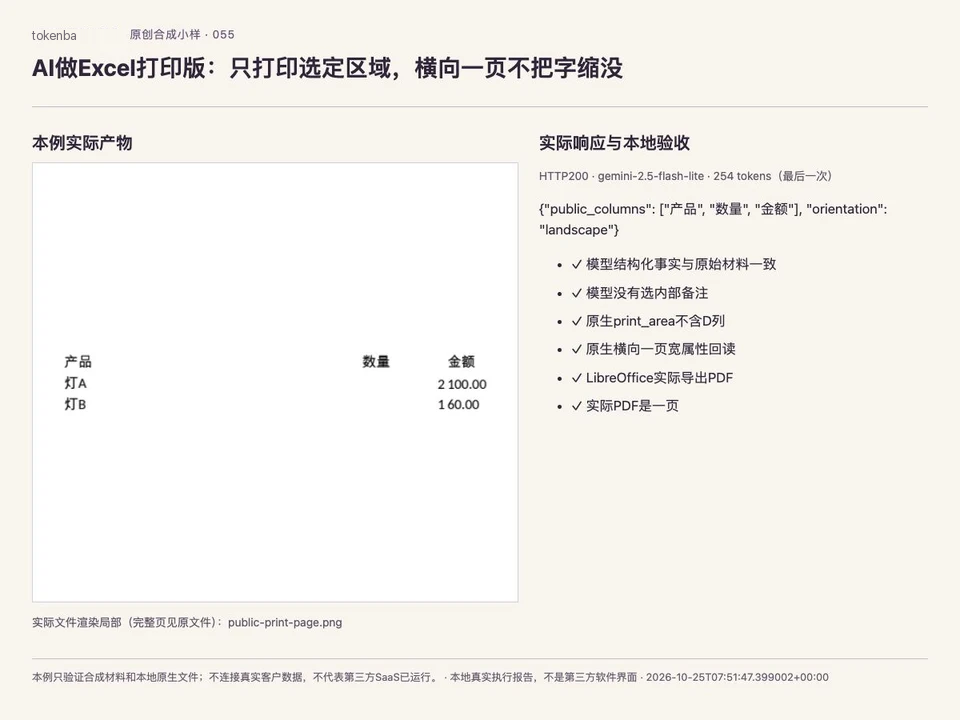
原生文件实际渲染或解码输入:public-print-page.png;不是第三方平台截图。
5. 对照真实结果和检查表
实测2026-10-25T07:51:47.399002+00:00,HTTP200;请求gemini-2.5-flash-lite,返回gemini-2.5-flash-lite。本次9/9项检查通过,指本例执行及验收机制通过,不代表所有模型字段零误差。
最后一次返回用量254tokens;1份尝试记录的已知用量合计254。失败记录保留,用量缺失不按0计,本文不推算实际金额。
| 实际检查 | 结果 |
|---|---|
| 真实apizt API响应HTTP200 | 通过 |
| 模型结构化事实与原始材料一致 | 通过 |
| 模型没有选内部备注 | 通过 |
| 原生print_area不含D列 | 通过 |
| 原生横向一页宽属性回读 | 通过 |
| LibreOffice实际导出PDF | 通过 |
| 实际PDF是一页 | 通过 |
| 内部备注没有进入PDF | 通过 |
| PDF包含对外数量金额 | 通过 |
- 实际检查
- 真实apizt API响应HTTP200
- 结果
- 通过
- 实际检查
- 模型结构化事实与原始材料一致
- 结果
- 通过
- 实际检查
- 模型没有选内部备注
- 结果
- 通过
- 实际检查
- 原生print_area不含D列
- 结果
- 通过
- 实际检查
- 原生横向一页宽属性回读
- 结果
- 通过
- 实际检查
- LibreOffice实际导出PDF
- 结果
- 通过
- 实际检查
- 实际PDF是一页
- 结果
- 通过
- 实际检查
- 内部备注没有进入PDF
- 结果
- 通过
- 实际检查
- PDF包含对外数量金额
- 结果
- 通过
result.json · 原生处理后实际结果
{
  "print_area": "'Quote'!$A$1:$C$3",
  "pdf_pages": 1,
  "pdf_text": "产品 数量 金额\n2 100.00\n1 60.00\n灯A\n灯B",
  "engine": "LibreOffice headless实际导出"
}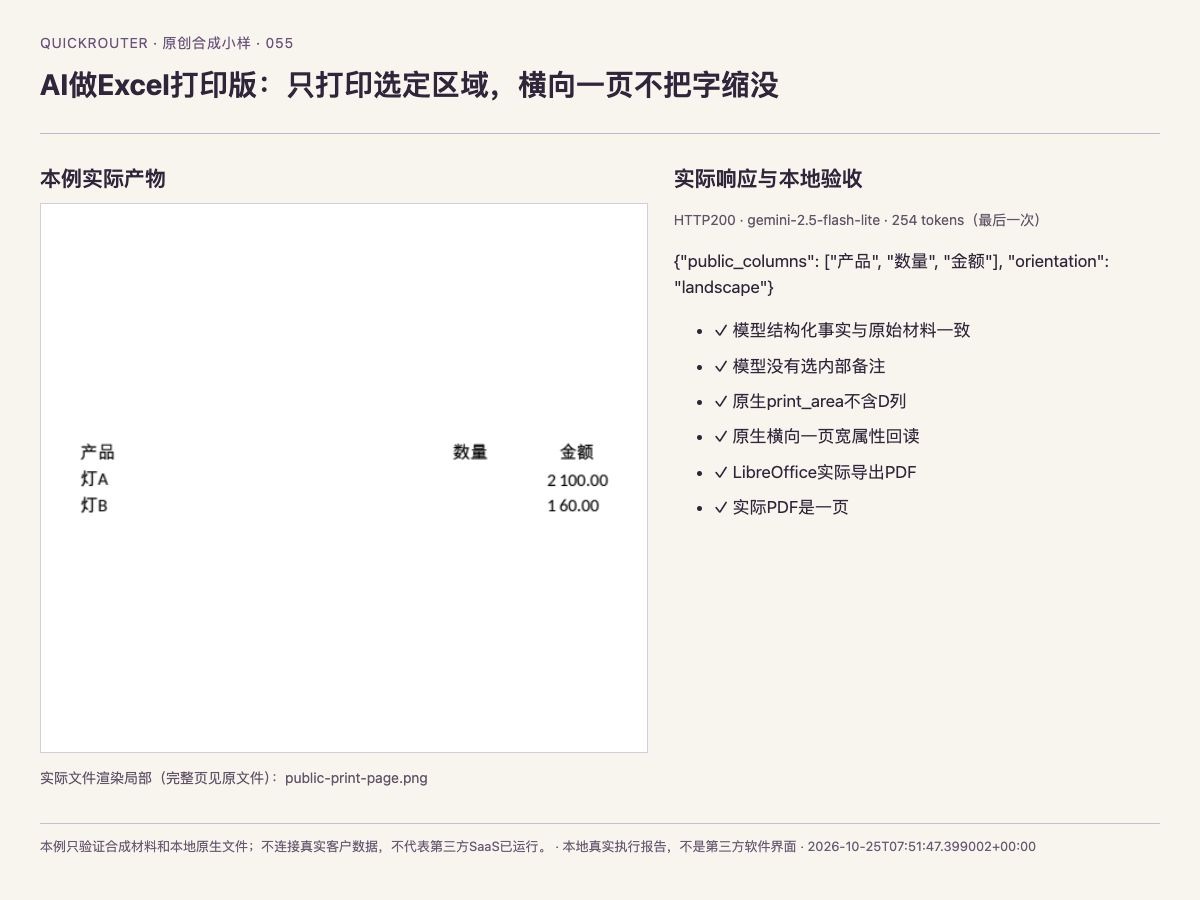
本例实际产物与原始响应的浏览器截图;本地检查和模型答案分开记录
6. 替换输入前,先确认这些边界
本例只验证合成材料和本地原生文件;不连接真实客户数据,不代表第三方SaaS已运行。
修改材料后应重新制定事实断言和反例。识别错误率、混淆矩阵或拒答类教程允许保留模型实际错误;检查通过指计算和处理正确。没有调用视频模型。
怎样确认已经完成
- 真实apizt API响应HTTP200
- 模型结构化事实与原始材料一致
- 模型没有选内部备注
- 原生print_area不含D列
- 原生横向一页宽属性回读
- LibreOffice实际导出PDF
- 实际PDF是一页
- 内部备注没有进入PDF
- PDF包含对外数量金额
常见问题
AI Excel 打印区域 缩放怎么开始?
读取 source.xlsx 的Quote表,区分产品、数量、金额三列与内部备注列;先保留含内部列的原件作为对照。按本页顺序继续,先用下载包离线重放,再替换自己的材料。
网页试跑和下载包有什么区别?
网页只复跑模型字段,不生成全部原生文件;资料包包含实际原生处理和本地验收。
这次通过结果适用于其他材料吗?
本例只验证合成材料和本地原生文件;不连接真实客户数据,不代表第三方SaaS已运行。