
展开本页目录
开始前准备什么
- 将练习包解压到独立目录,不覆盖已有项目或真实业务资料。
- 先运行本包校验并查看实测范围,再按官方文档使用自己的软件、账号与准确版本。
- 需要真实模型的步骤只使用自己的 Key,截图与下载包不包含凭据。
- 打开自有报表页面
- 准备独立下载目录
- 按开源库配置模型
- 运行筛选与下载任务
- 验证真实下载内容
- 拒绝 HTML 伪成功
- 区分 Agent 状态与产物证据
原创输入、运行脚本、字段校验、负例和执行范围;不含可用密钥。
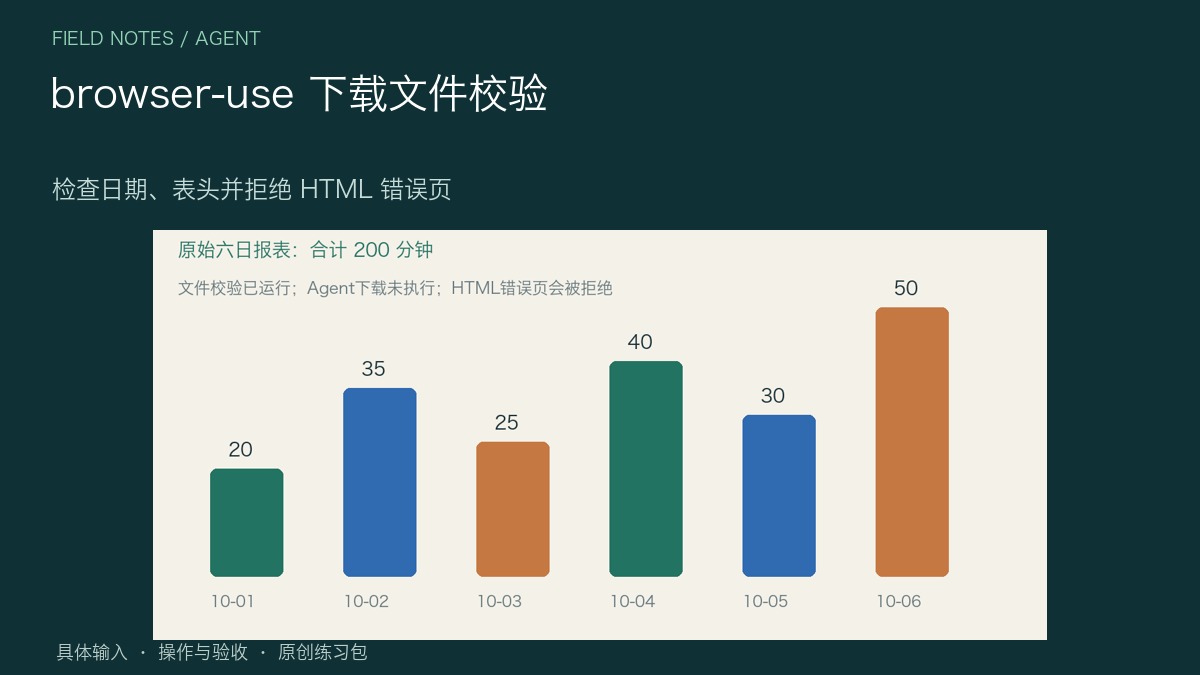
已真实解析原创六行报表并通过 HTML 错误页拒绝测试;未运行 browser-use Agent 或模型下载。
对应正文的具体资料,保持输入可追溯。
验证字段与负例;不能代替未执行的软件或模型。
明确区分材料验证、框架执行和模型调用。
1. 打开自有报表页面
启动 server.py,在本地 3393 端口查看原创六天报表。默认日期范围 10 月 01 日至 06 日,下载按钮另存 CSV,错误路径只返回 HTML 负例。
bash
python3 server.py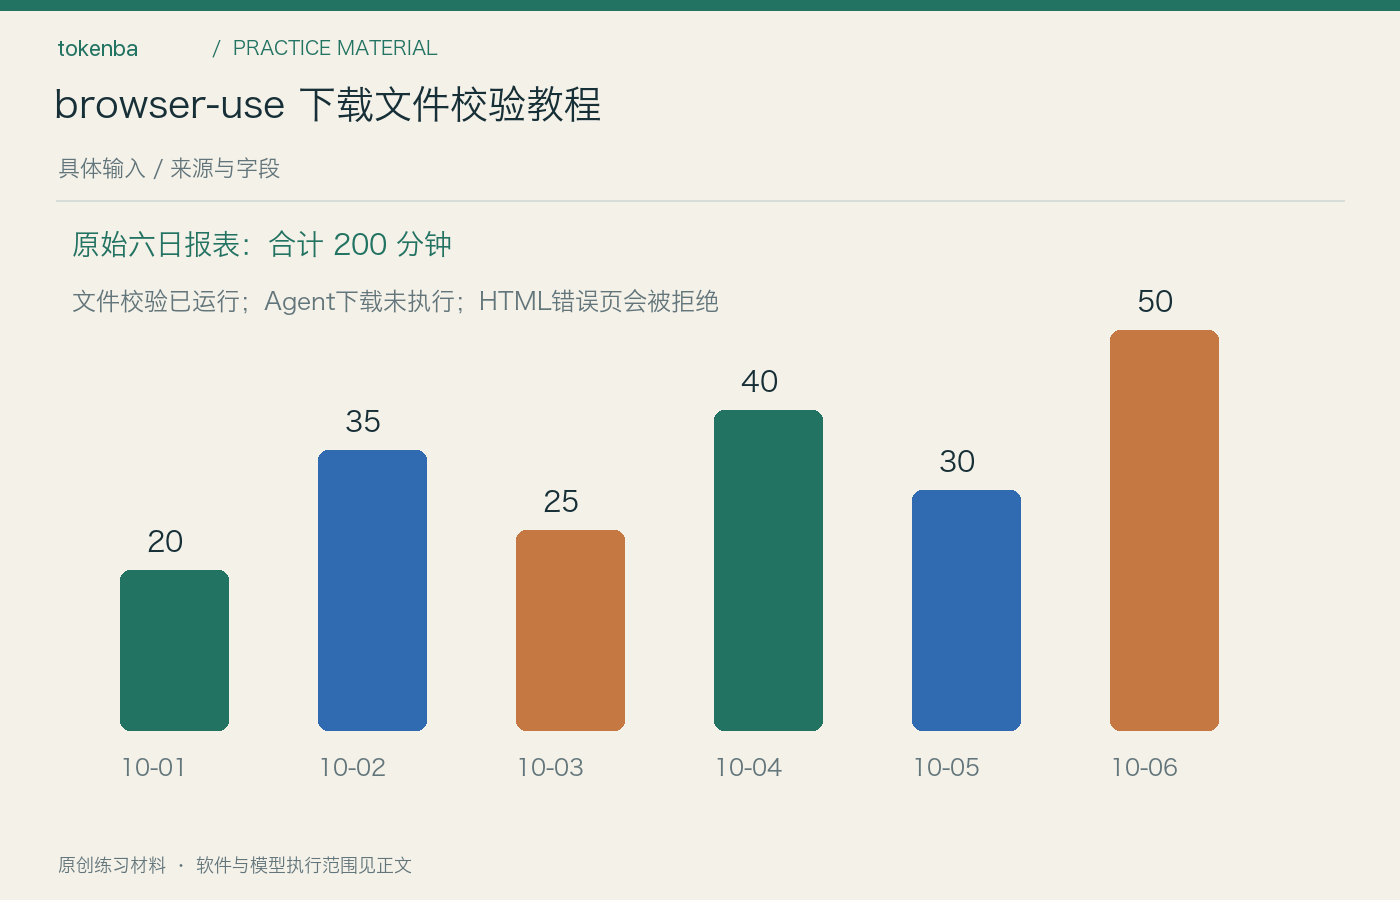
2. 准备独立下载目录
agent.py 将 accept_downloads 和 downloads_path 指向本包 output 目录。不要下载到桌面或覆盖已有 report.csv;执行前确认目录里没有旧结果干扰。
3. 按开源库配置模型
使用 browser_use.ChatOpenAI,base_url 填兼容 API /v1 根地址,模型 ID 和 Key 来自你自己的账户。Cloud browser 下载对象和本地文件路径不是同一接口。
4. 运行筛选与下载任务
任务要求将日期范围设置为 2026-10-01 至 2026-10-06,点击 Download 后停止。Agent 必须实际执行才能有自动化证据;本轮未运行该模型步骤。
bash
python3 agent.py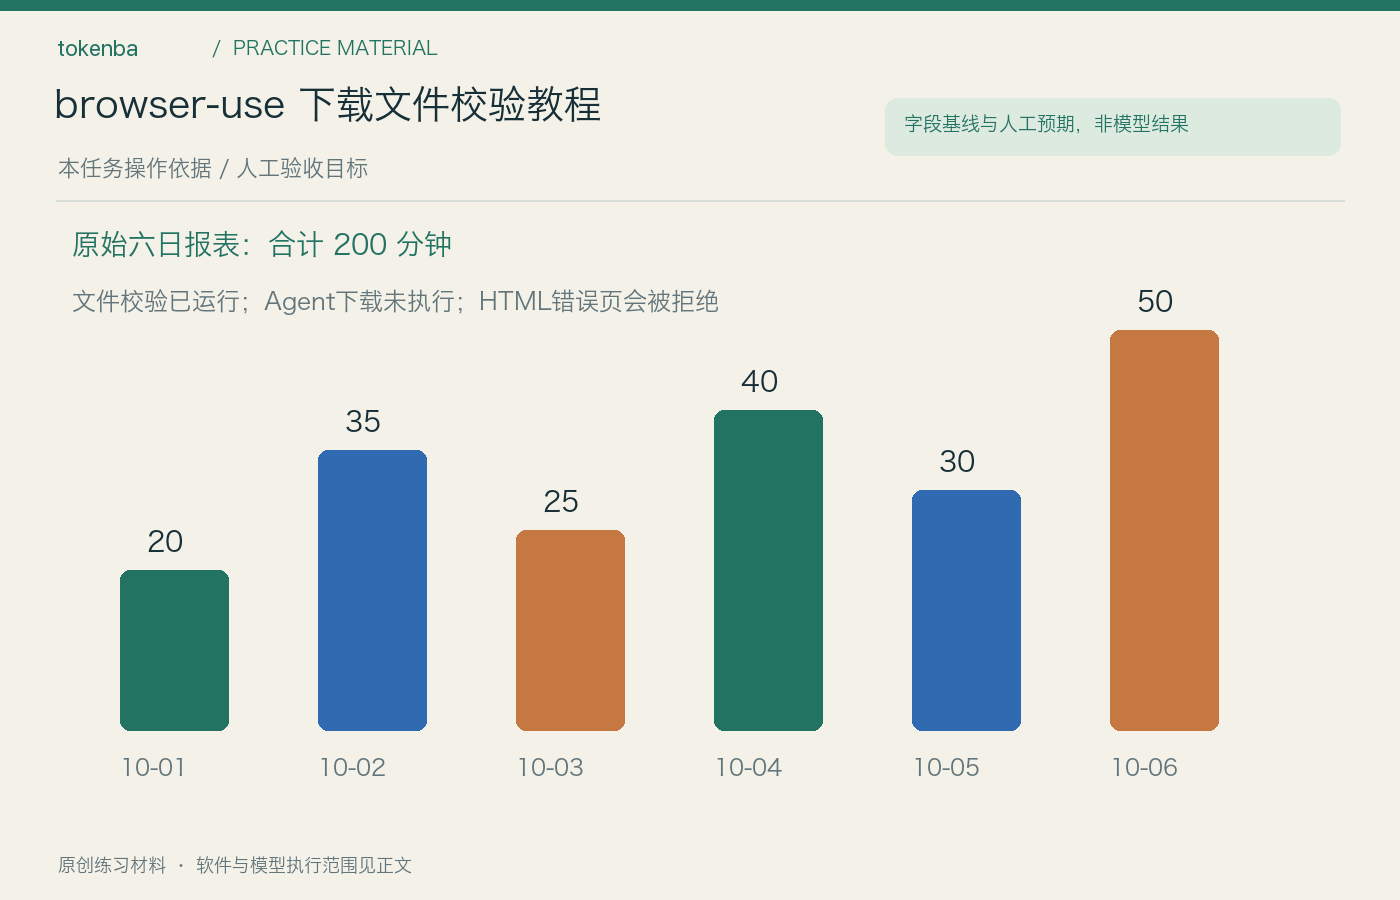
5. 验证真实下载内容
对 output/report.csv 运行 verify.py --actual,检查非空、UTF-8、准确表头、6 行、最早/最晚日期与 200 分钟合计。扩展名 .csv 不能证明内容是 CSV。
bash
python3 verify.py --actual output/report.csv6. 拒绝 HTML 伪成功
negative.html 是 HTTP 200 的错误页面教材。verify.py --actual negative.html 必须非零退出;不能把下载了 HTML 当作报表成功。
7. 区分 Agent 状态与产物证据
history.is_done() 只说明发出终止动作,is_successful() 是模型自报。最终依据本地实际文件,保存运行 history、文件 hash 和独立校验。
bash
python3 verify.py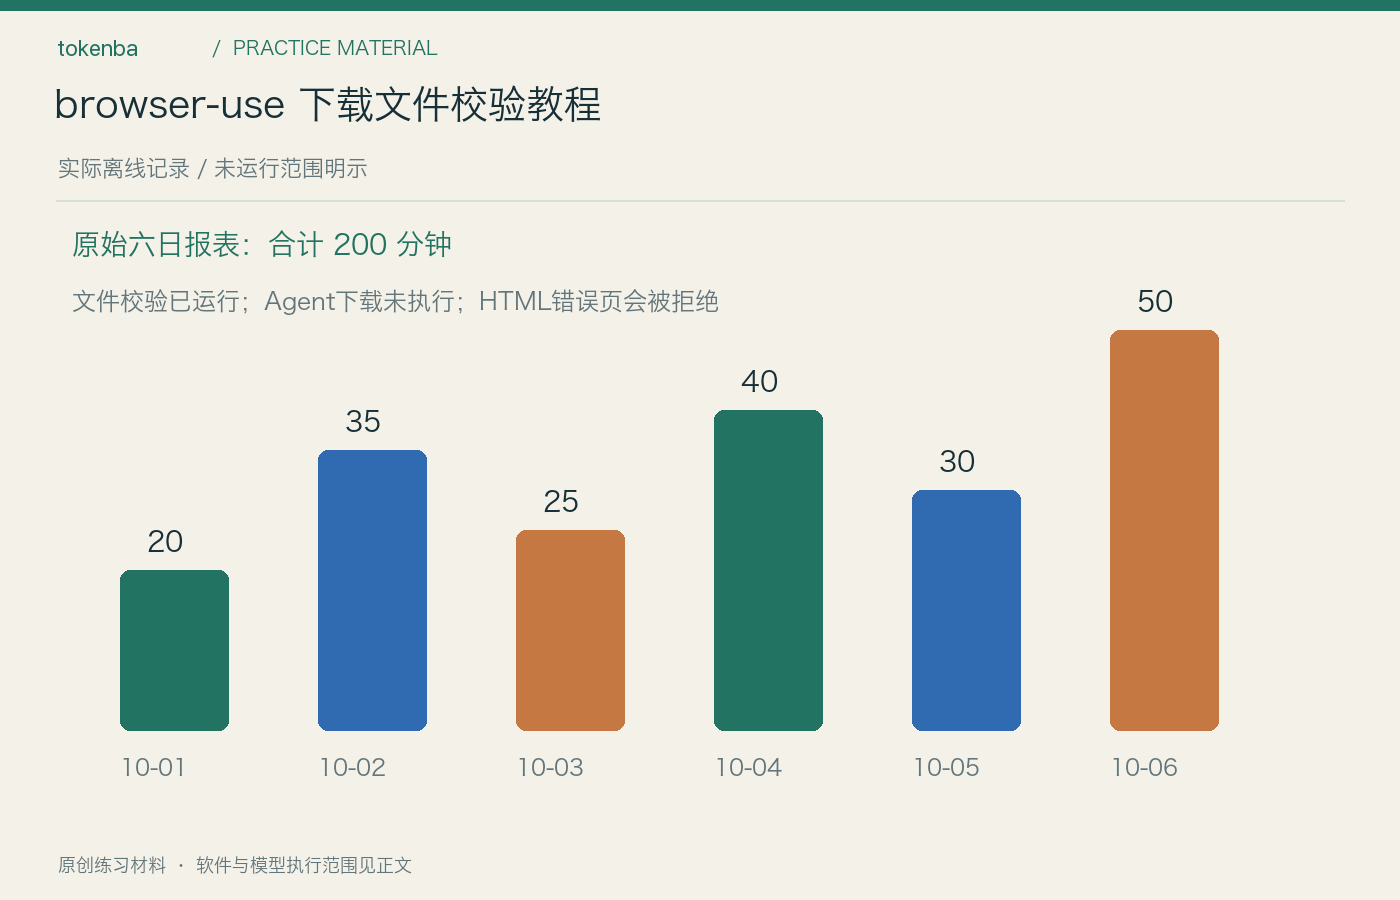
怎样确认已经完成
- negative.html 是 HTTP 200 的错误页面教材。verify.py --actual negative.html 必须非零退出;不能把下载了 HTML 当作报表成功。
- history.is_done() 只说明发出终止动作,is_successful() 是模型自报。最终依据本地实际文件,保存运行 history、文件 hash 和独立校验。
- 已真实解析原创六行报表并通过 HTML 错误页拒绝测试;未运行 browser-use Agent 或模型下载。
常见问题
is_successful 为 True 就能交付报表吗?
不能。它是 Agent 自报,还要独立查看文件是否存在、类型、字段、日期和行数是否正确。
为什么一个 .csv 文件会被拒绝?
服务器可能返回 HTML 登录页或错误页;验证内容而非文件名。本包会拒绝含 HTML 的响应。