
展开本页目录
开始前准备什么
- 下载练习包并解压到独立目录,保留原件。
- 使用自己有权限的目标工具;AI建议与Word/Excel/PPT等原生命令分别执行、分别验收。
- 作者参考的执行范围见本页结果和README;未运行的目标账号、云端权限或界面操作不计为已完成。
- 保留原名称与唯一ID
- 先做精确规范化匹配
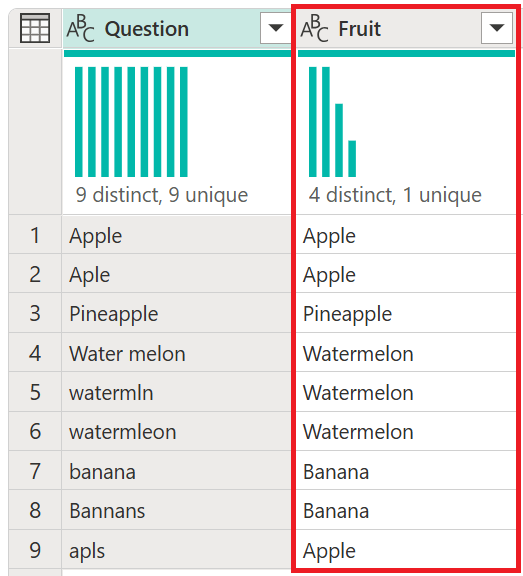
- 在Merge选择fuzzy并保留多个候选与相似度
- 设定待确认区间
- 人工批准映射后写成转换表
- 新增一个同名分支
- 导出最终映射、未匹配与歧义清单
1. 保留原名称与唯一ID
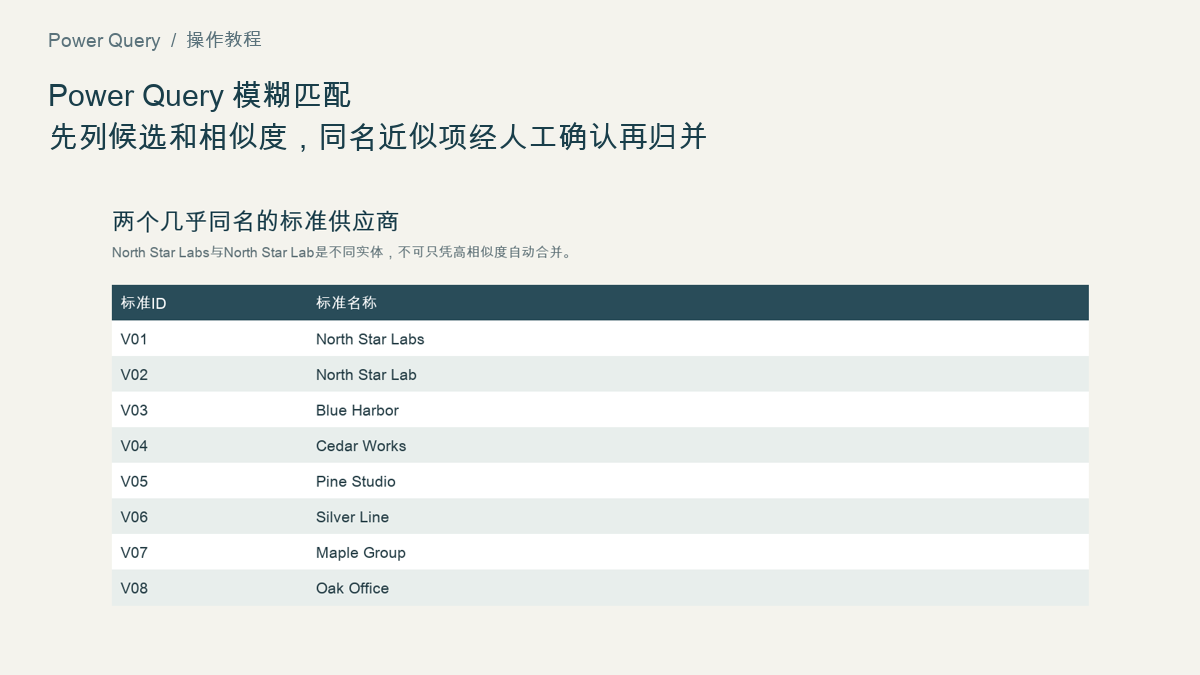
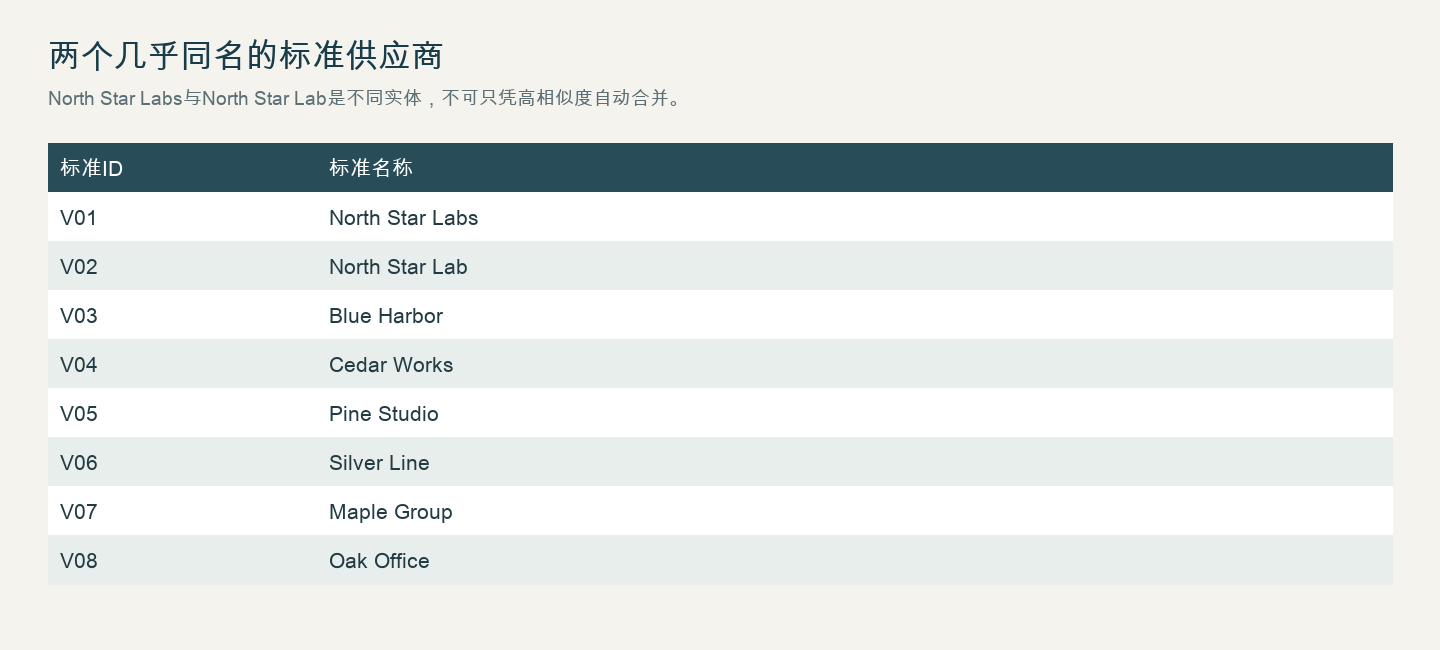
保留原名称与唯一ID,标准表先检查名称是否唯一。
本页练习输入:15条虚构供应方别名和8个标准名称,含同名不同分支、标点差异和无法匹配项。
2. 先做精确规范化匹配
先做精确规范化匹配,剩余项才进入模糊匹配。
先把aliases.csv与canonical.csv分别导入为Aliases和Canonical查询,列名按原文件保留;再在空白查询高级编辑器粘贴fuzzy-candidates.m。作者本地相似分数只作复核参考。
3. 在Merge选择fuzzy并保留多个候选与相似度
text
text
任务:Power Query 模糊匹配:先列候选和相似度,同名近似项经人工确认再归并
输入:15条虚构供应方别名和8个标准名称,含同名不同分支、标点差异和无法匹配项。
请保留原件,并只对副本工作。按以下顺序执行:
1. 保留原名称与唯一ID,标准表先检查名称是否唯一。
2. 先做精确规范化匹配,剩余项才进入模糊匹配。
3. 在Merge选择fuzzy并保留多个候选与相似度。
4. 设定待确认区间,两个近似候选不自动选第一条。
5. 人工批准映射后写成转换表,保留批准人/理由字段。
6. 新增一个同名分支,确认旧规则不能悄悄覆盖映射。
7. 导出最终映射、未匹配与歧义清单,原始名称不丢。
交付:两张输入表;阈值/转换字典;候选复核表与批准映射。
遇到缺失信息或不可执行的原生功能,明确列出,不用编造结果填补。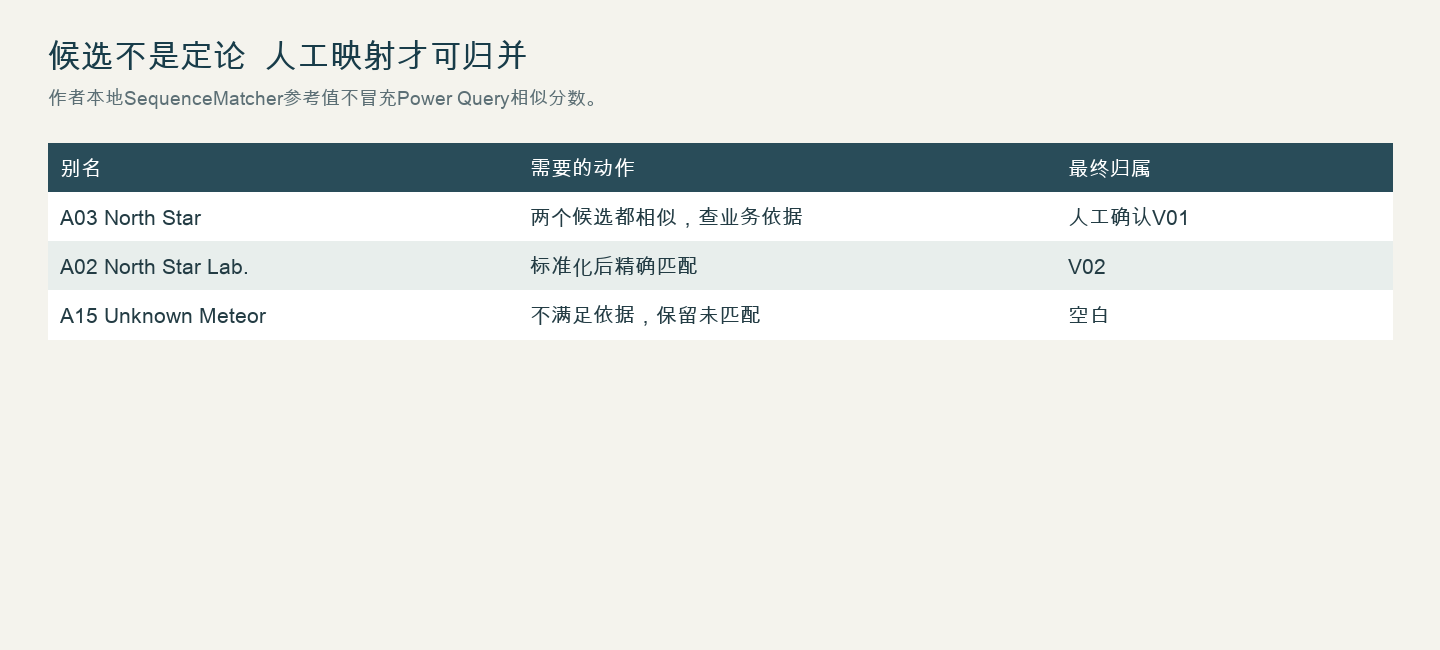
4. 设定待确认区间
设定待确认区间,两个近似候选不自动选第一条。
5. 人工批准映射后写成转换表
人工批准映射后写成转换表,保留批准人/理由字段。
本地参考与核对结果:15条别名先做标准化精确匹配,再列候选;North Star有歧义须人工确认,Unknown Meteor保留未匹配。
6. 新增一个同名分支
新增一个同名分支,确认旧规则不能悄悄覆盖映射。
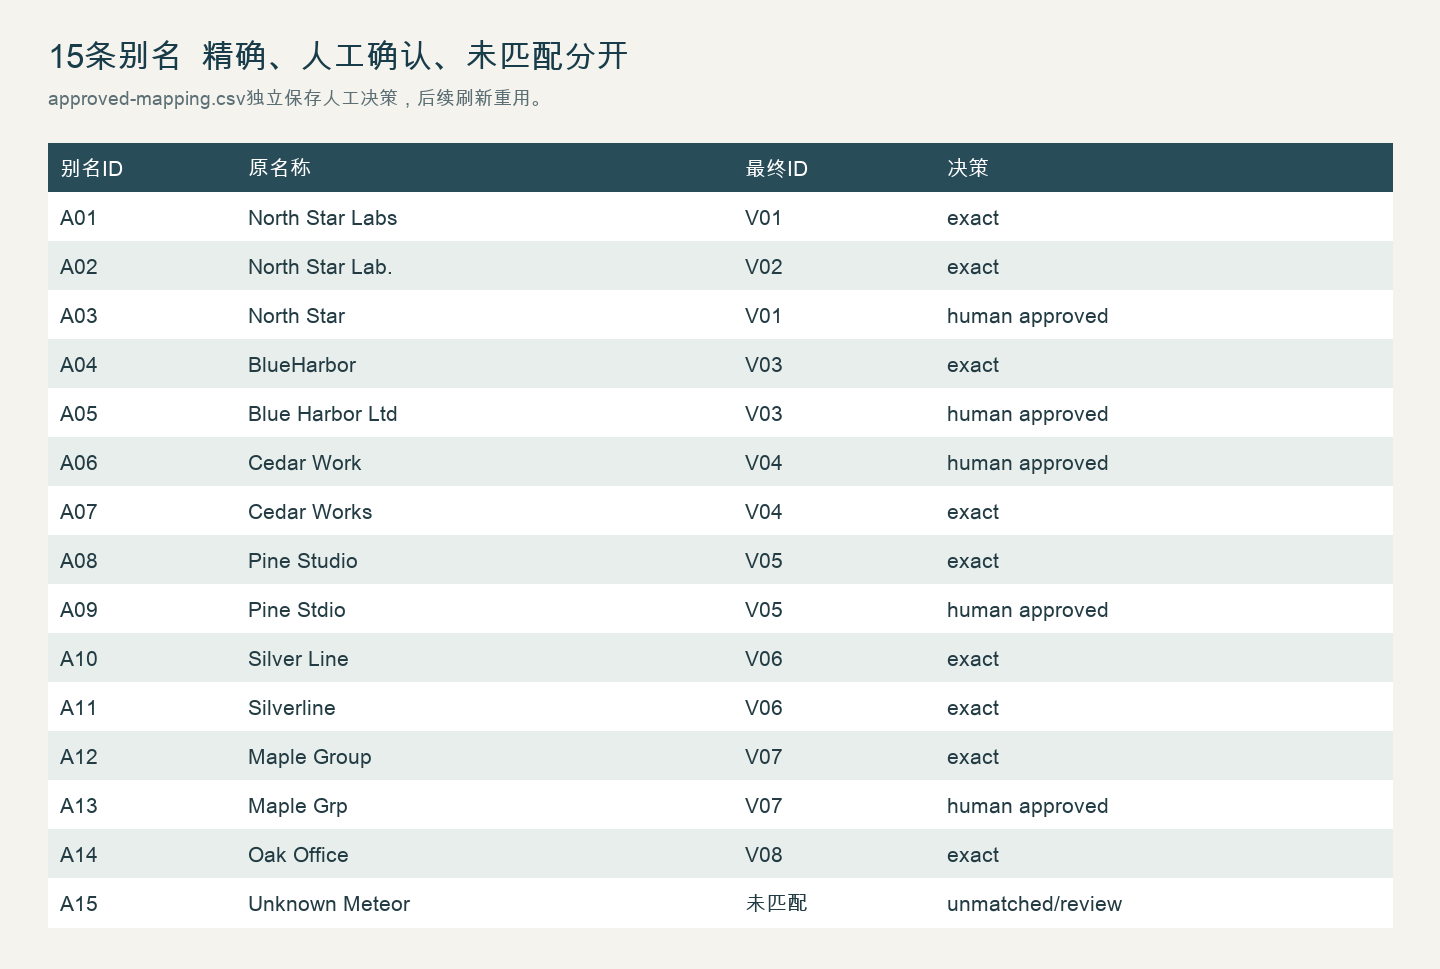
7. 导出最终映射、未匹配与歧义清单
导出最终映射、未匹配与歧义清单,原始名称不丢。
下载ZIP保留原始输入与作者参考两种身份;先按本页步骤完成自己的结果,再运行verify.py核对。具体依赖和已执行范围见README。
bash
bash
python3 verify.py怎样确认已经完成
- 歧义项有多个候选且不自动归并。
- 人工映射可追溯。
- 未知项保持未匹配。
常见问题
公司名差一个字,AI模糊匹配会不会把两家公司合并?
会有这种风险。North Star Labs与North Star Lab是两个不同标准记录;标准化后仍有歧义时,保留两个候选并查真实依据,不能直接选最高分当同一公司。
模糊匹配分数很高,为什么还要保留待确认清单?
相似度只反映文字接近,不证明实体相同。保存原名、候选ID、分数、人工批准映射和未匹配清单;作者本地SequenceMatcher分数也不冒充Power Query分数。