
展开本页目录
开始前准备什么
- 下载本题完整练习包,区分待实现 starter 与作者完成 reference。
- 按README准备本题原生依赖;所有输入均为原创或明确标注的本地fixture。
- 本地练习不需要付费模型Key;真实模型调用未执行,MiniLM题另有明确实际推理说明。
- 启动本地文章
- 观察原始页面
- 配置正文过滤
- 保留代码表格
- 排除导航广告
- 比较输出文本
- 保存可复用配置
原创输入、待完成starter、作者reference及实际运行产物,依README本地准备依赖。
环境要求、具体操作、产物核对与未运行范围。
1. 启动本地文章
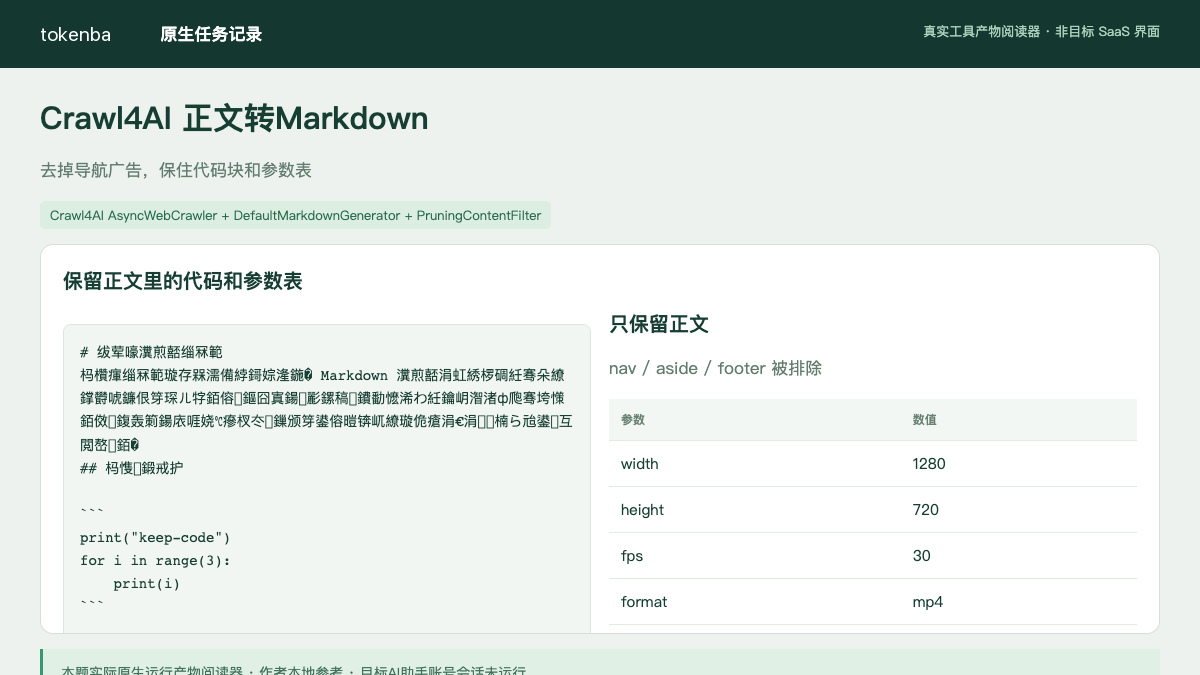
先打开原创 article.html,确认它包含导航、广告侧栏、正文代码块、四行参数表和页脚。输入来自练习包本地服务,不抓取外部新闻或需要登录的页面。
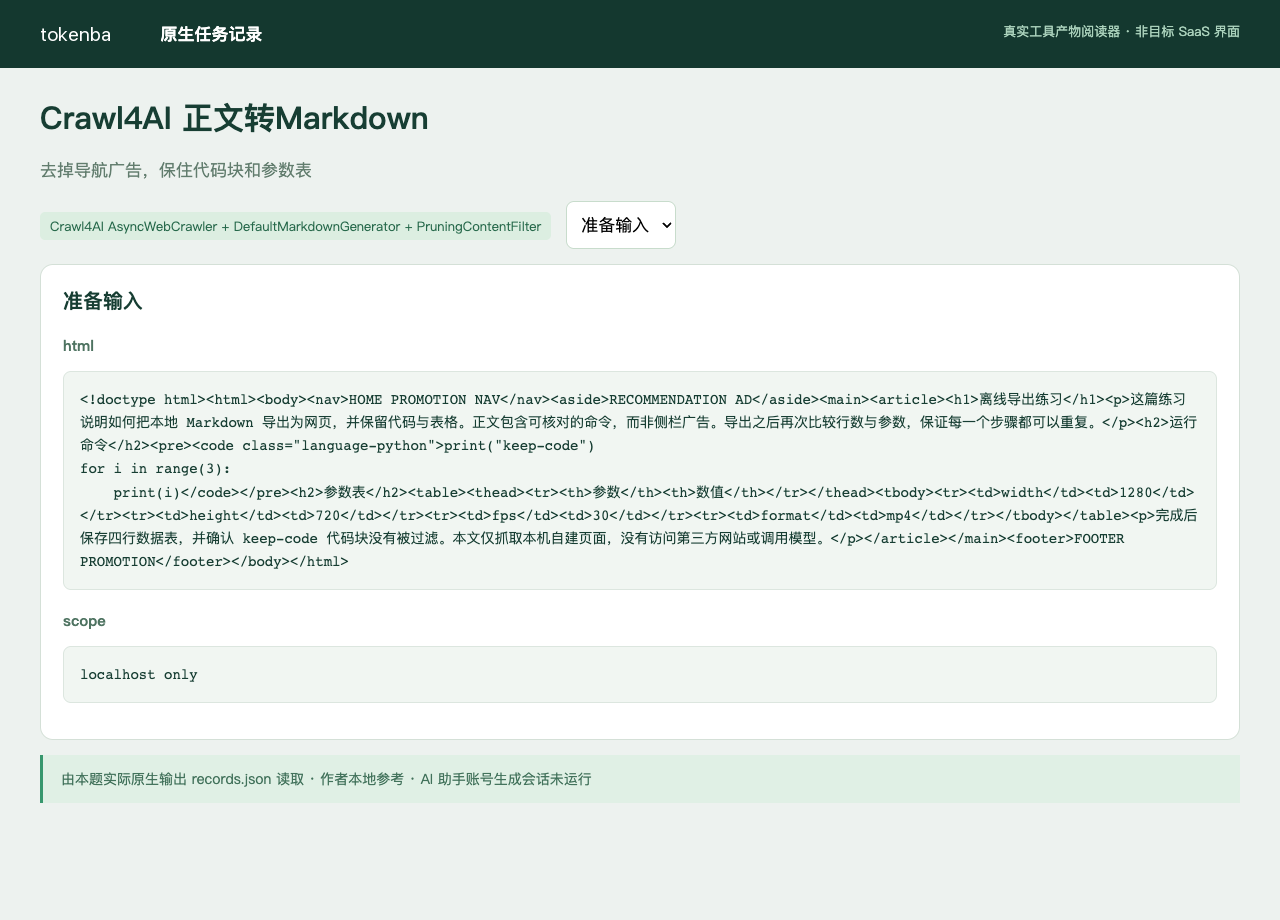
2. 观察原始页面
使用 Crawl4AI 的 AsyncWebCrawler 访问本机页面。浏览器实际加载后生成原始 Markdown,保留原始 HTML,方便判断过滤是否误删正文。
本地启动与复现
cd reference
CHROME_BIN="/path/to/chromium" python3 verify.py
3. 配置正文过滤
在 CrawlerRunConfig 指定 excluded_tags 为 nav、aside、footer,并使用 DefaultMarkdownGenerator 搭配 PruningContentFilter。先从低阈值开始,避免中文短正文被一起删除。
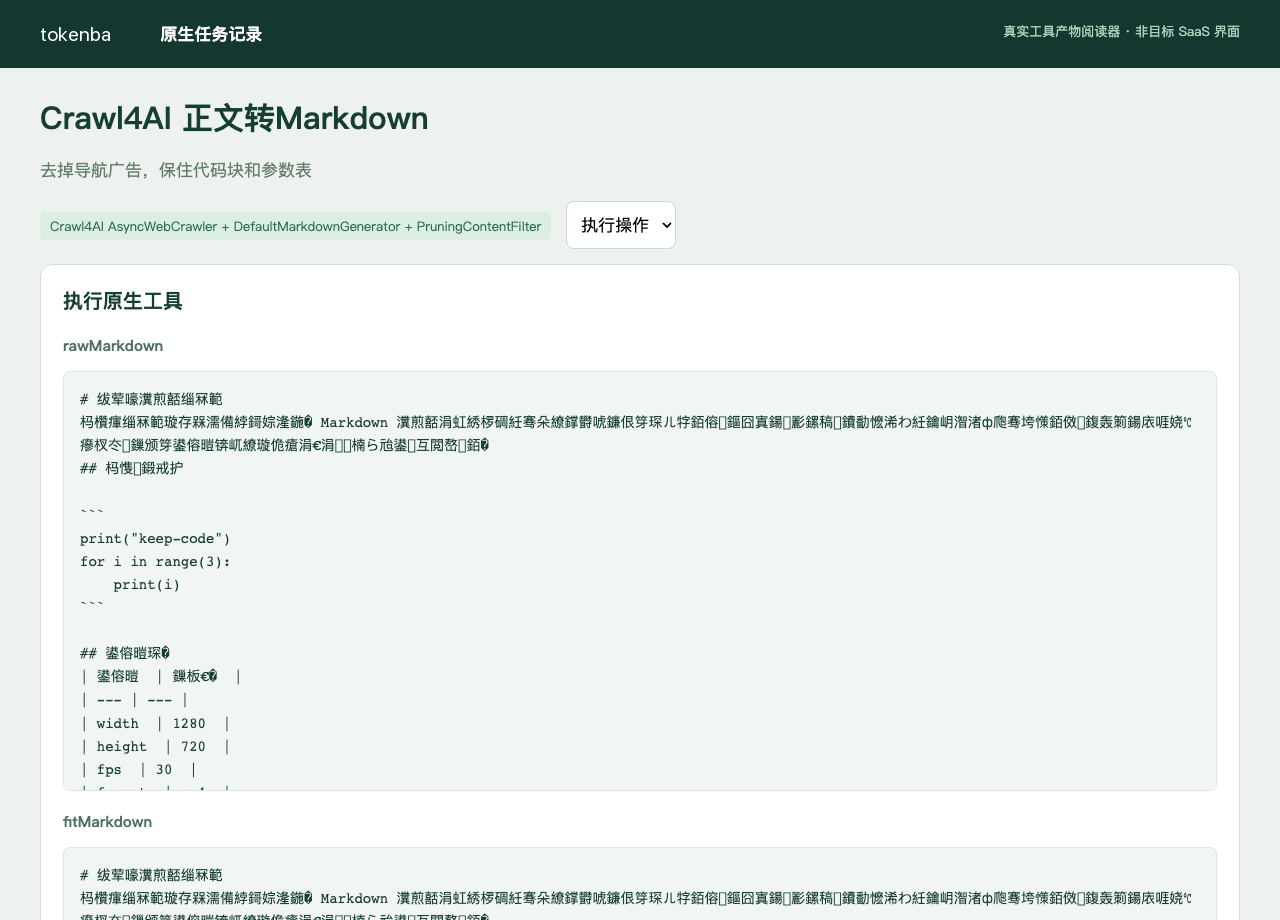
4. 保留代码表格
查看 fit_markdown,确认 keep-code 代码仍在围栏中,width、height、fps、format 四行参数仍存在。过滤质量需要按文章内容核对,不能只比较文本长度变短。
5. 排除导航广告
故意将导航、页脚写成明显的 PROMOTION 与 NAV 标记,检查最终文本不存在这些标记。仅删除广告但连正文也为空的结果不能通过。
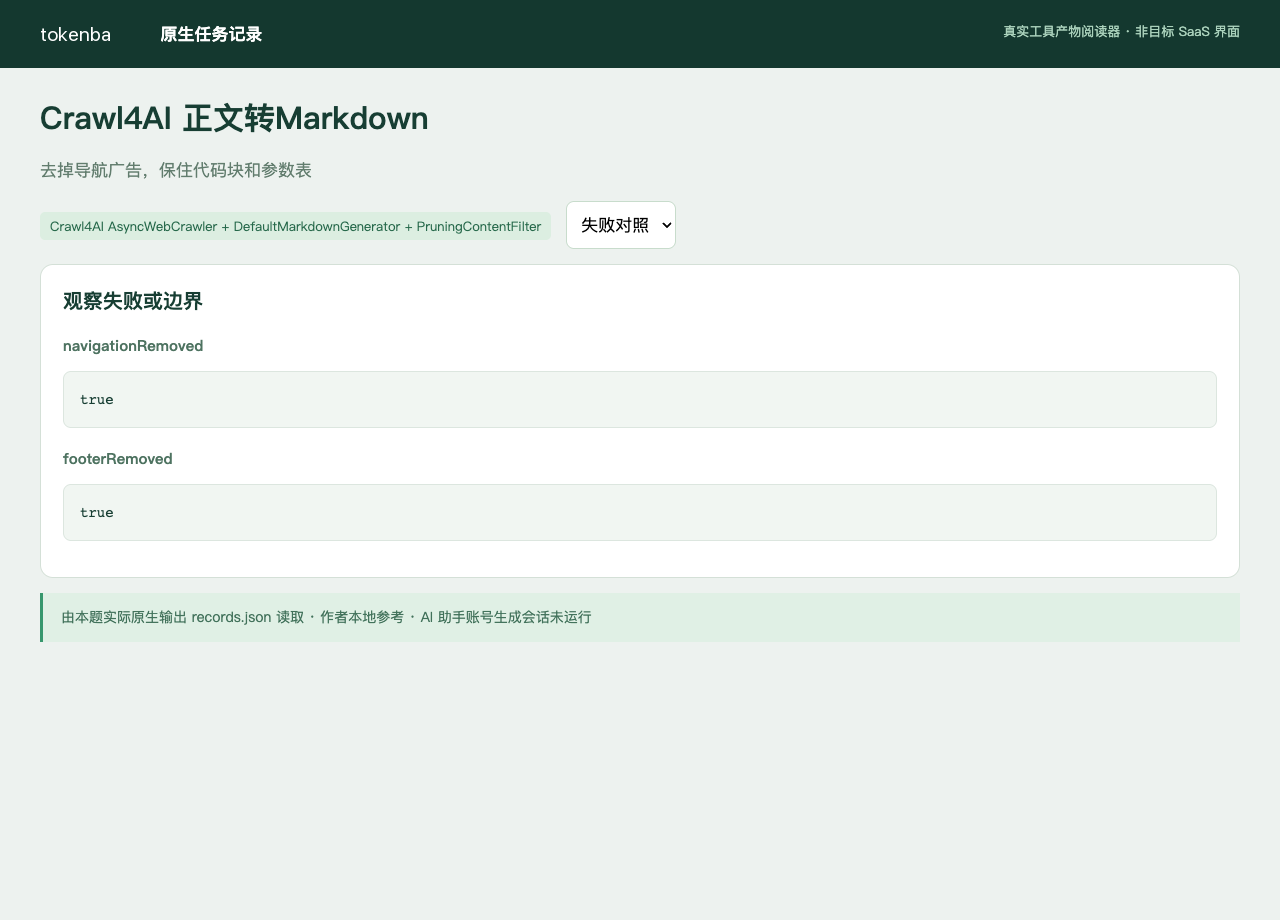
6. 比较输出文本
同时保存 raw.md 与 fit.md,逐段核对正文和命令。这个网页的表格与代码是正例,导航是反例;更复杂站点应另建输入集调整过滤。
7. 保存可复用配置
运行 verify.py 会启动隔离本机 HTTP 服务并调用真实浏览器与 Crawl4AI。README 说明如何指定已安装 Chromium,未运行 LLM 提取器,也不把渲染前静态字符串当成浏览器抓取。
怎样确认已经完成
- fit_markdown不含导航、侧栏与页脚标记。
- keep-code围栏与width/height/fps/format四行参数仍完整。
- raw.md与fit.md可对照,成功来自实际浏览器抓取而非只看长度。
常见问题
网页转Markdown怎么只留正文,不混进导航广告?
先限定nav/aside/footer等非正文标签,再让Markdown生成器搭配内容过滤,保留原始HTML和输出做对照。
去掉网页杂乱内容后,代码和表格怎么保住?
用包含代码与四行表格的原创输入逐项核对。本题fit Markdown仍含keep-code与四个参数行,不能只用文本变短判断成功。
哪些部分实际运行,哪些需要独立验证?
Crawl4AI真实浏览器抓取localhost,fit Markdown保留代码与四行表格,移除导航广告;未调用LLM提取器。 目标AI助手账号生成、云平台部署和生产环境不在本次执行范围。