
展开本页目录
开始前准备什么
- DaVinci Resolve Studio桌面许可,所需转录模型;本轮不安装大型套件。
- 官方20指南为2025年4月;记录实际20/21构建,不据此宣称新热版。
- 先打开独立ZIP的README与asset-identity.json;本题使用目标工具原生功能,不要求apizt Key。
- 创作短剧本TXT、六段对应素材和行ID,给两条take设置同义句与否定词差异作为审校点。
- 导入Media Pool,核对台词语言、完整音轨和时长后运行Audio Transcription。
- 检查每条转录;否定词识别错误先记下,不把转录准确度当成自动保证。
- 选素材运行Create New Timeline Using IntelliScript并载入纯文本剧本,保存运行前版本。
- 逐行对照首轨的台词与剧本,查看禁用备选轨,检查缺句、重复和同义改写。
- 人工启用更合适的take并微调接点;如对白不匹配但画面好,也明确说明取舍来自人工。
- 导出首剪/审校后短片并保存工程,附行ID→源clip→取用区间映射和失败例。
实际可打开输入、作者原生参考、七步README、提示参数与验收表。
区分本地已制作、官方示例与目标软件尚未执行部分。
填写真实输出与失败区域,模板不预填成功。
1. 创作短剧本TXT、六段对应素材和行ID
创作短剧本TXT、六段对应素材和行ID,给两条take设置同义句与否定词差异作为审校点。 蓝盒、红杯和黄卡不是演员或软件界面。script.txt只放目标四句,line-take-ground-truth.csv另列素材、原文与错误备选。
2. 导入Media Pool
导入Media Pool,核对台词语言、完整音轨和时长后运行Audio Transcription。 先实际播放每条音轨;本题英语开源formant合成语音适合检查流程,不代表复杂中文口语/嘈杂现场的准确率。
3. 检查每条转录
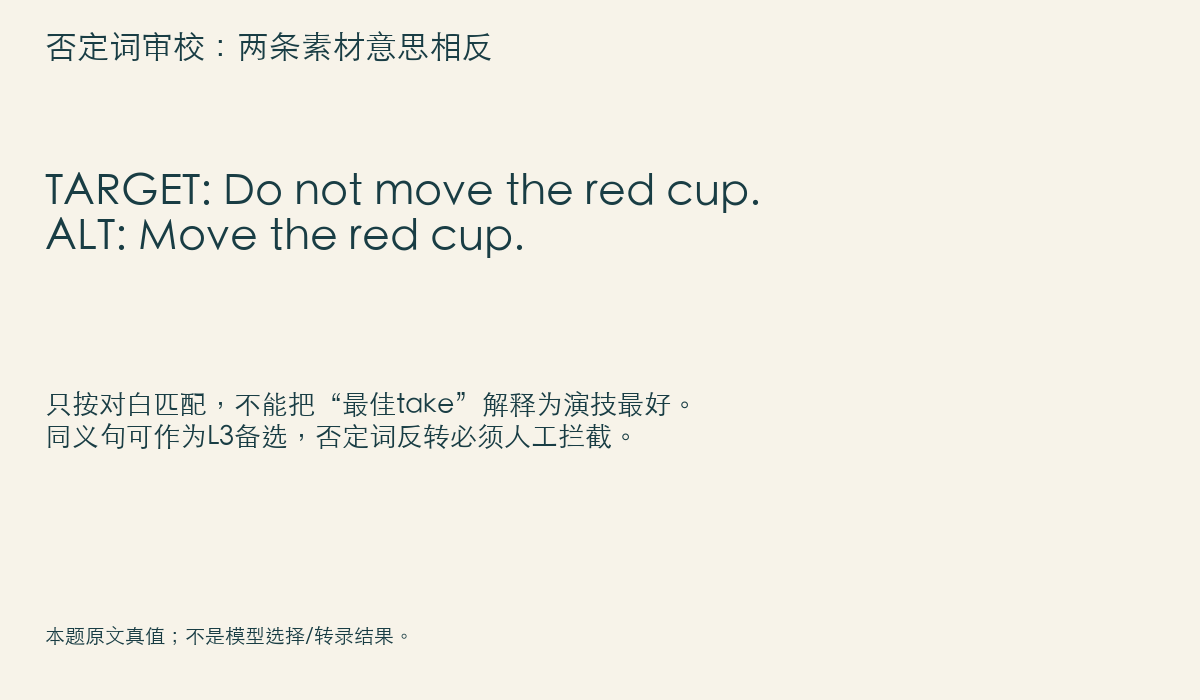
检查每条转录;否定词识别错误先记下,不把转录准确度当成自动保证。 转录后先查Do not是否完整,错误备选是Move the red cup。不要把识别缺否定词当作语义等价。
4. 选素材运行Create New Timeline Using IntelliScript并载入纯文本剧本
选素材运行Create New Timeline Using IntelliScript并载入纯文本剧本,保存运行前版本。 IntelliScript按已转录素材匹配TXT剧本。原始时间线另存,生成后找首轨与默认禁用的备选轨。
5. 逐行对照首轨的台词与剧本
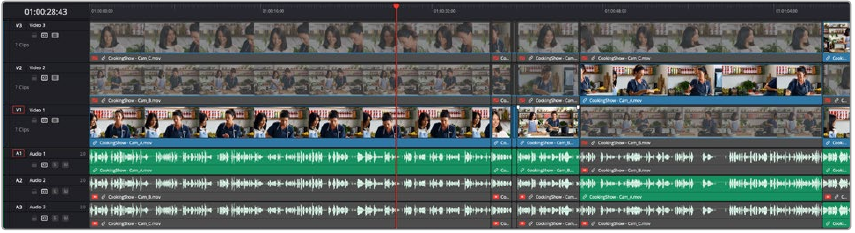
逐行对照首轨的台词与剧本,查看禁用备选轨,检查缺句、重复和同义改写。 官方best take只按对白匹配,不评价演技、画面或good-take元数据。包内同义句适合观察可匹配范围。
6. 人工启用更合适的take并微调接点
人工启用更合适的take并微调接点;如对白不匹配但画面好,也明确说明取舍来自人工。 人工替换备选必须保留源clip与入出点。完整台词比自动选了多少段更重要,前后接点要回听。
7. 导出首剪/审校后短片并保存工程
导出首剪/审校后短片并保存工程,附行ID→源clip→取用区间映射和失败例。 如果没有Resolve账号,可以用包内真实素材和真值理解审校;本站没有生成DRP或AI首剪,不能把原生素材合并成片冒称IntelliScript。
怎样确认已经完成
- 每句有源素材和时间范围,否定词不被漏审。
- 备选轨真实保留,人工替换可追溯。
- 没有宣称模型评价演技、自动审片或自动发布。
常见问题
手里多条台词怎么让达芬奇按剧本先剪一版?
先转录已有素材,再将TXT剧本交给IntelliScript排时间线。它不生成镜头,而是按对白从现有take中取用;本题给六条实际输入。
IntelliScript选的最好一条等于演员演得最好吗?
不等于。官方明确best只依据对白匹配,不能理解为模型评价演技。你仍需看画面、接点和否定词,并人工审核。
练习包里哪些是目标工具的运行结果?
HyperFrames原生物件演示视频与开源formant合成语音的六条真实take;非真人表演,未运行IntelliScript。 包内asset-identity.json逐文件说明;官方功能图单列出处,不打包完整课程,也不把本地参考伪称该工具输出。