
展开本页目录
开始前准备什么
- 下载本题完整练习包,区分待实现 starter 与作者完成 reference。
- 按README准备本题原生依赖;所有输入均为原创或明确标注的本地fixture。
- 本地练习不需要付费模型Key;真实模型调用未执行,MiniLM题另有明确实际推理说明。
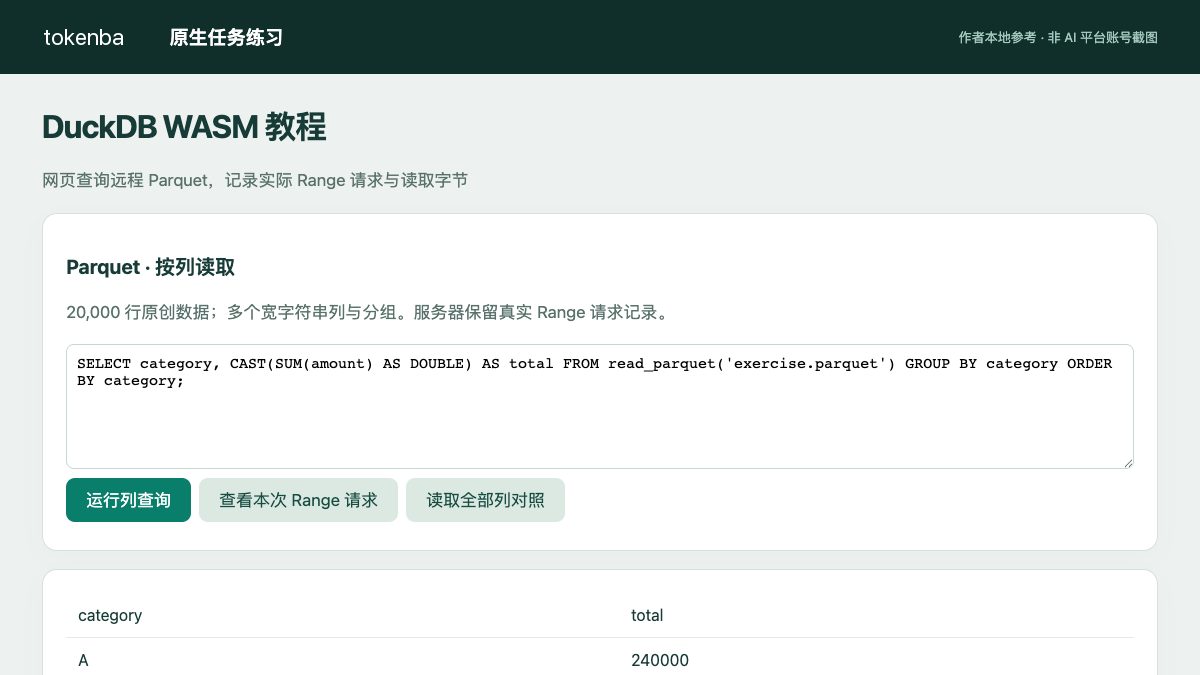
- 准备Parquet分组
- 启动Range服务
- 注册HTTP懒文件
- 执行列聚合
- 读取全部列对照
- 核对网络字节
- 保存查询与输入
原创输入、待完成starter、作者reference及实际运行产物,依README本地准备依赖。
环境要求、具体操作、产物核对与未运行范围。
1. 准备Parquet分组
输入含20000行、category与amount两列及三个宽字符串列,按行组写入真实Parquet。先核对独立oracle中的各类别合计和文件总字节。
2. 启动Range服务
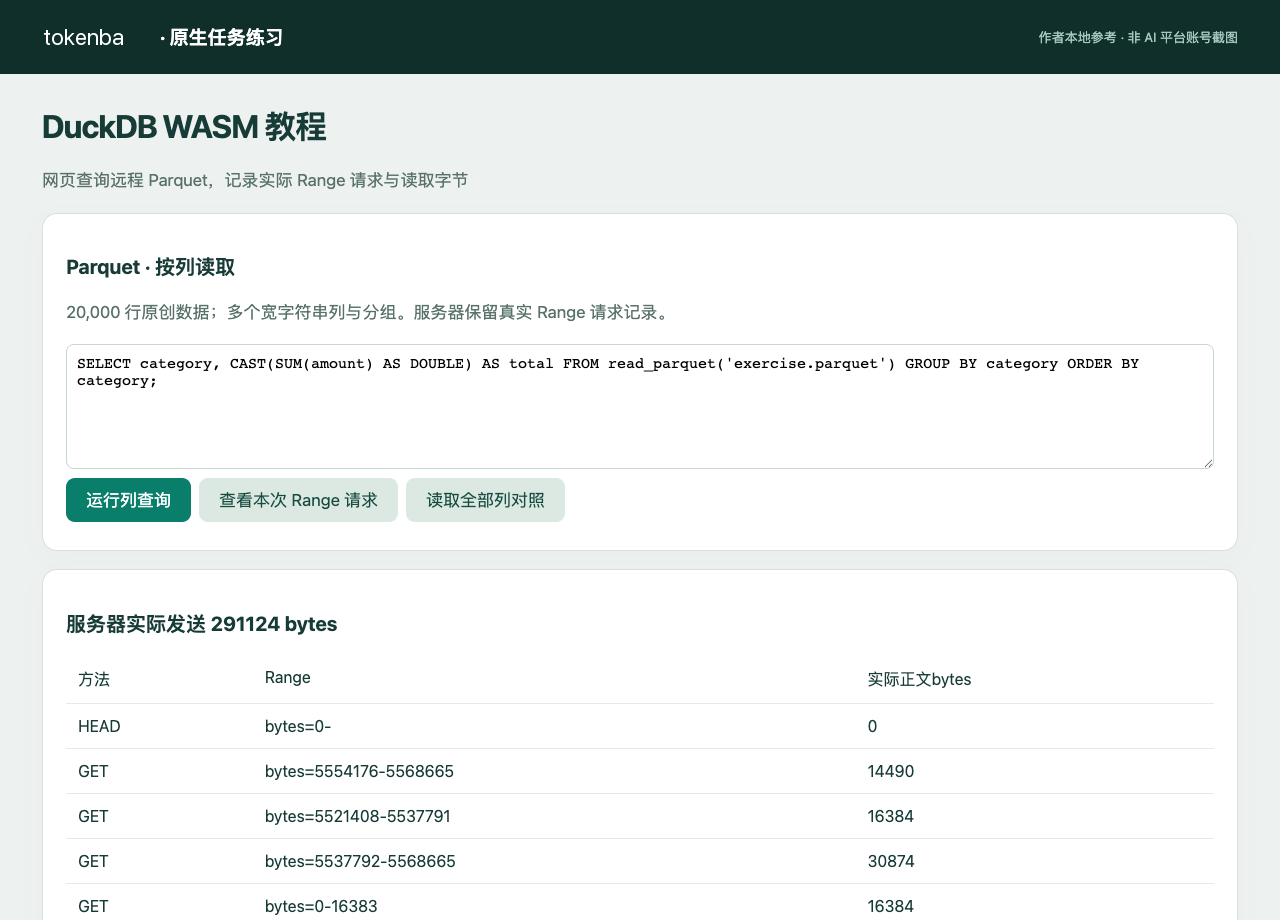
本地HTTP服务必须支持HEAD、Accept-Ranges、206与Content-Range,并记录真实发送字节。仅在浏览器Network里看到文件名不能证明发生了范围读取。
本地启动与复现
cd reference
npm install
npm run build
python3 range_server.py --port 8787
3. 注册HTTP懒文件
DuckDB WASM使用registerFileURL的HTTP协议注册文件,关闭整份HTTP回退并启用可靠HEAD。不要先fetch整文件成ArrayBuffer,再声称按列节省了传输。
4. 执行列聚合
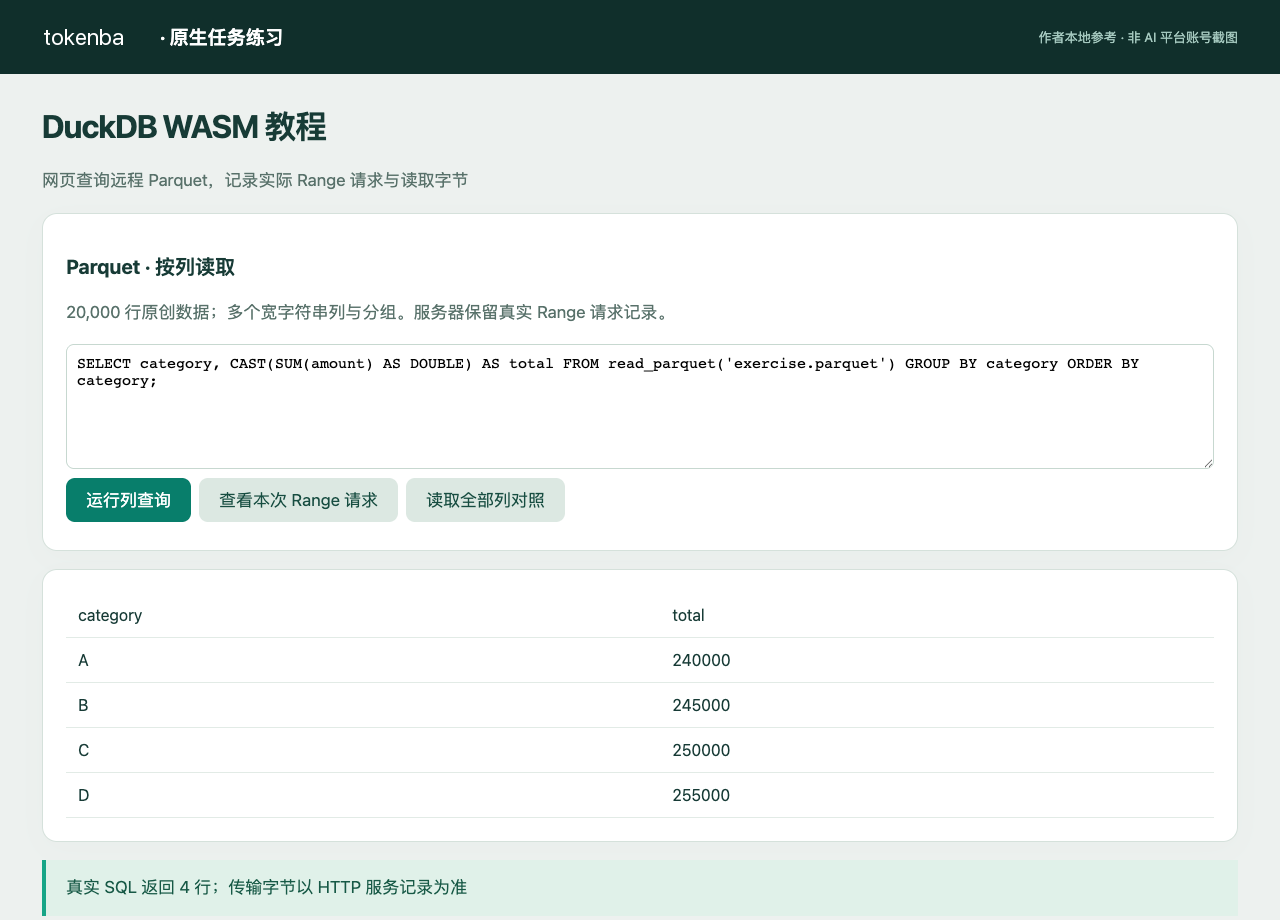
在冷上下文按category聚合amount,SUM显式转为DOUBLE便于显示。实际查询结果与独立生成输入时的类别合计一致。
5. 读取全部列对照
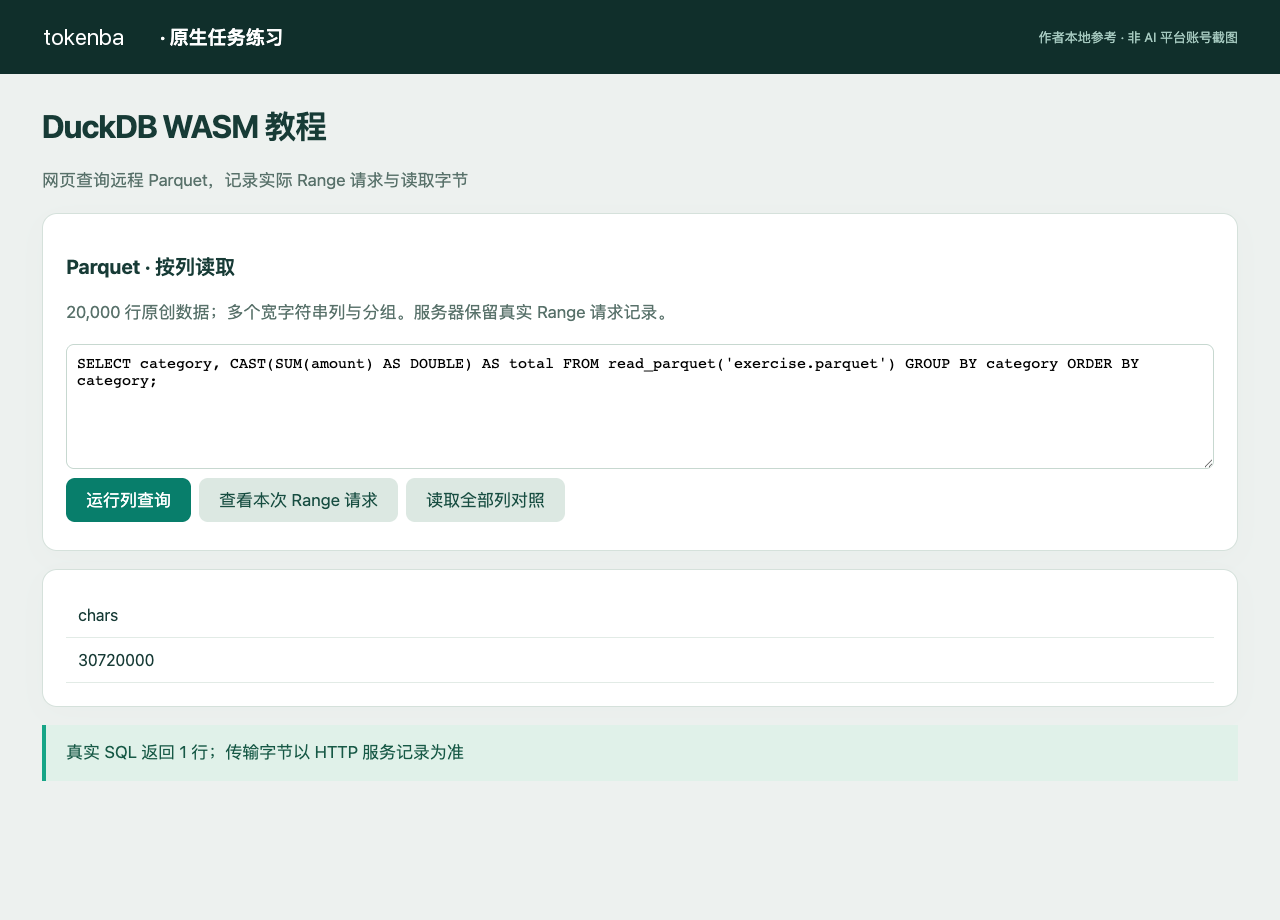
另建冷上下文读取三个宽字符串列作为对照,避免复用先前缓存。使用同一份Parquet,只改变SQL需要的数据列。
6. 核对网络字节
比较服务器实际Range请求和发送字节,列聚合读取少于全列对照。这里报告测得的字节而非估算百分比,文件布局不同时收益也会变化。
7. 保存查询与输入
下载Parquet、oracle、查询源码与范围服务。WASM依赖在本地build准备;本文不代表所有Parquet都能少读,也不把Python DuckDB结果冒充浏览器执行。
怎样确认已经完成
- 实际返回206和Content-Range,服务器记录真实发送字节。
- category聚合与独立oracle一致。
- 两个冷上下文对照列聚合与全列读取,缓存不混用。
常见问题
浏览器能不能直接查Parquet,不先把整份文件读进来?
可以,前提是服务支持HTTP Range,WASM注册HTTP懒文件,而不是先fetch整份。本题实际出现206范围读取。
说只读需要的列,怎么从网络请求证明确实少读了?
使用冷上下文、同一文件比较两种SQL,记录服务器真正发送字节。本题列聚合少于全列对照,收益取决于Parquet布局。
哪些部分实际运行,哪些需要独立验证?
DuckDB WASM实际HTTP Range读取Parquet,类别合计匹配独立oracle,冷上下文列聚合传输少于全列对照。 目标AI助手账号生成、云平台部署和生产环境不在本次执行范围。