
展开本页目录
开始前准备什么
- 使用IBM官方Granite base与对应adapter;只制作输入和校验可以离线免费进行,真正推理需可承担模型内存的本地/自有环境。
- Granite Switch当前仓库要求Python3.11+、PyTorch2.11+;vLLM路径还有CUDA/Transformers兼容要求,不承诺Mac可直接跑同一CUDA栈。
- 官方代码与所列adapter采用Apache2.0;按具体base card核对许可与版本,目标推理未执行,不编造评分和速度。
- 准备带答案基准的问题
- 固定被评回答
- 选择匹配adapter
- 获取实际certainty
- 对照正确性标签
- 检查分组可靠性
- 交付校准边界
1. 准备带答案基准的问题
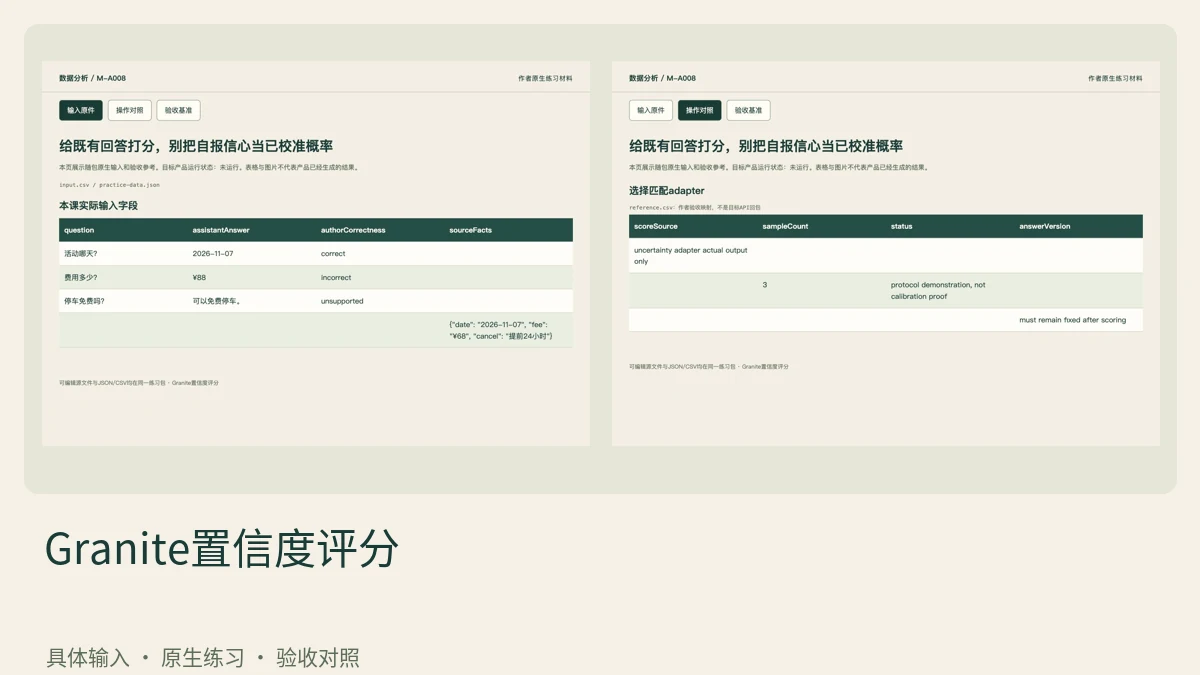
只用作者提供的活动规则:11月7日、¥68、提前24小时取消。
问题超出材料时基准标unknown,不臆测真实政策。
2. 固定被评回答
保存完整conversation并以assistant回答结尾。
评分后不修改回答文本,否则原分数不再对应当前答案。
3. 选择匹配adapter
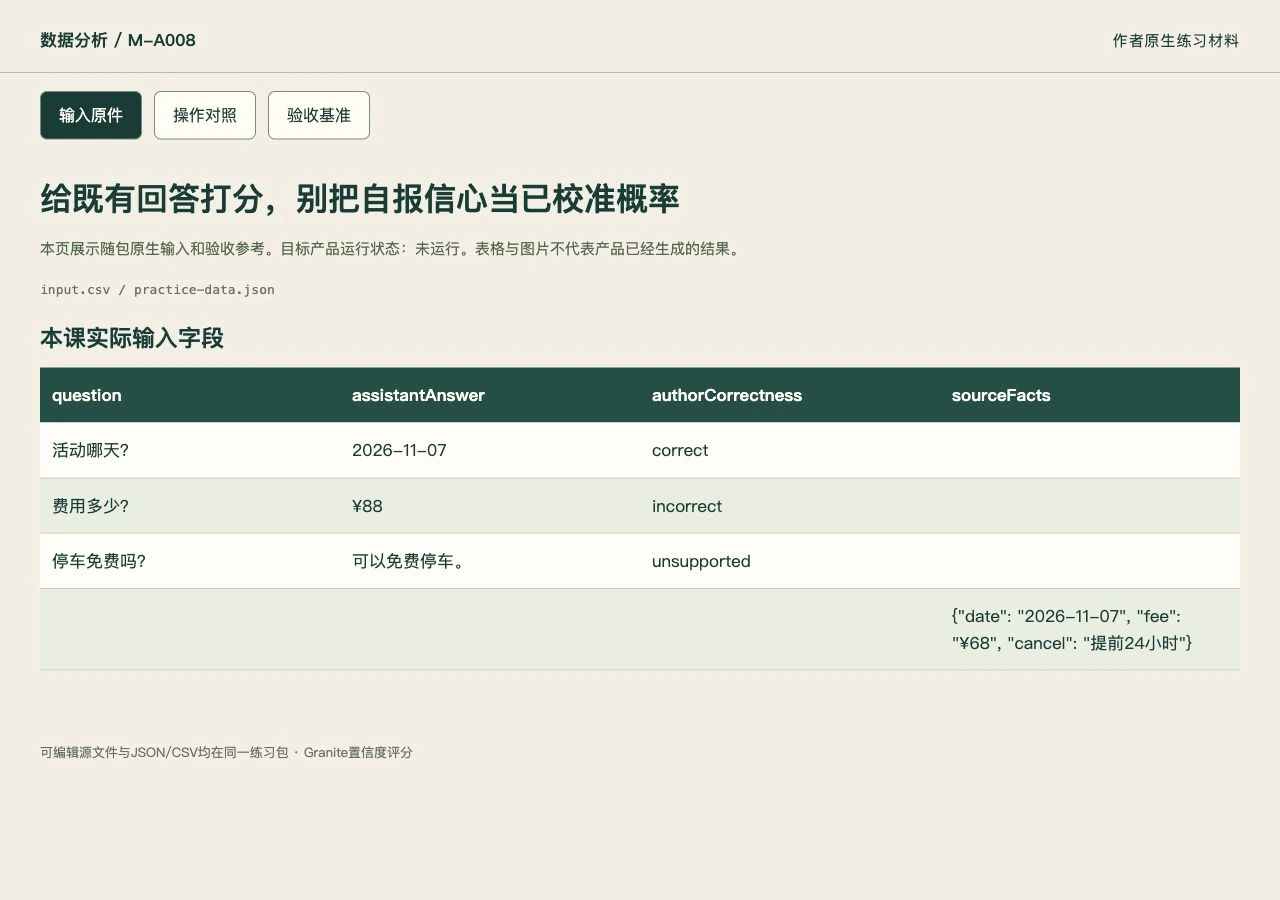
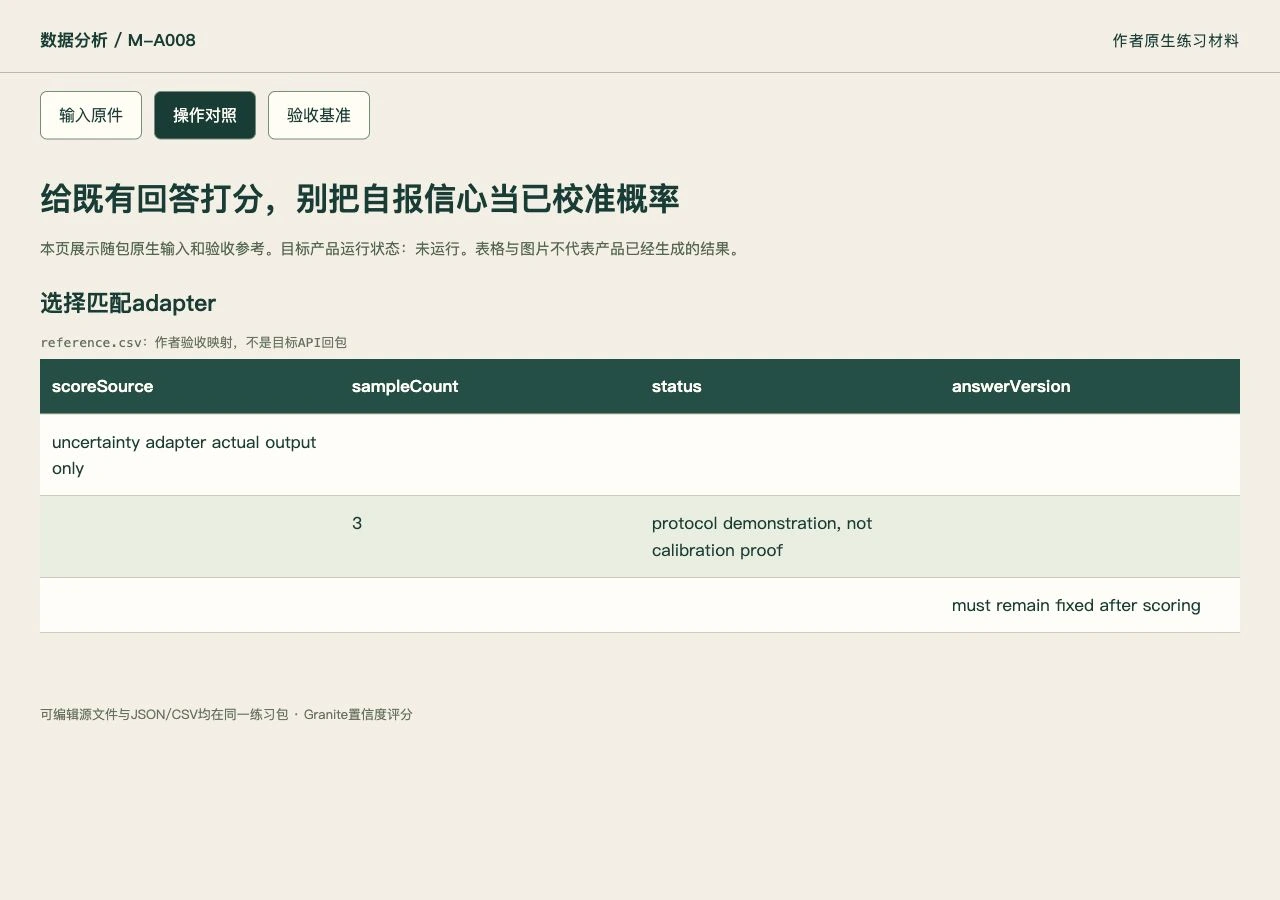
按uncertainty README选择底模和子目录,记录校准适用说明。
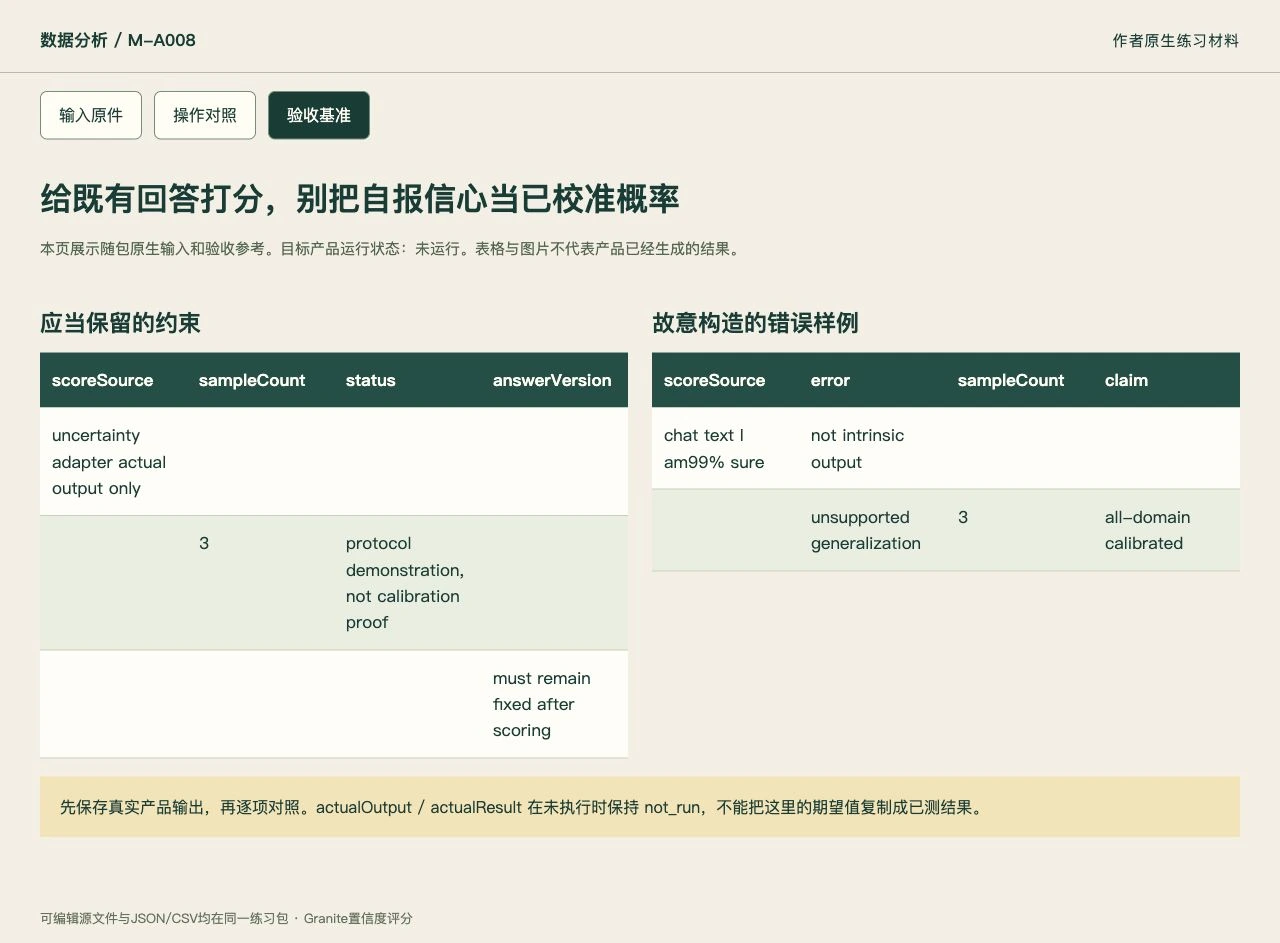
普通模型自报百分比不能冒充专门adapter输出。
4. 获取实际certainty
通过官方推荐Mellea intrinsic取得分数并保留原类型。
未运行时留null,不能写看起来合理的高低值。
5. 对照正确性标签
把事实正确、事实错误、不可从材料判断分开。
unknown不直接当正确,也不为了画好看曲线删掉。
6. 检查分组可靠性
在足够样本上按分数分桶看实际正确比例。
本课三题只示范流程,不足以证明本地场景已校准。
7. 交付校准边界
保存答案版本、基准来源和真实评分。
不能把官方在其测试分布的校准描述扩成所有领域保证。
下载本课材料并开始操作
练习包包含本课的具体输入、可编辑数据、正反样例与七步说明。index.html 可离线查看原件和验收参考,actual-results.csv 用于记录你实际操作后的结果。
怎样确认已经完成
- 被评回答版本固定。
- adapter评分与聊天自报分开。
- 三题演示不声称完成统计校准。
常见问题
模型说自己99%确定能信吗?
那可能只是生成文字。本课使用专门uncertainty adapter,并把实际分数与人工基准对照;即使有校准设计,也要看当前数据分布。
三个例子分数都合理,就算校准好了吗?
不够。三例用于核对输入协议和标签,统计校准需要足够留出样本,并报告分桶数量与实际正确率。