
展开本页目录
开始前准备什么
- 下载到独立练习目录,先运行材料校验,再连接自己的翻译服务。
- 准备 Python 与对应工具的隔离环境;PDF 检查使用 Poppler,翻译版本分别记录。
- 原文均为原创练习材料;密钥只填在本机,不写入下载文件或截图。
- 先打开原创网页
- 选择官方支持的服务入口
- 复制实际服务地址
- 选择实际可用模型并测试
- 翻译这四段原文
- 逐段填验收表
- 保存脱敏配置
原创 PDF/CSV/EPUB/HTML、逐步说明、校验脚本与真实离线记录;不含模型译文。
对应本页操作、工具边界与验收范围。
本页截图使用的原始文档。
读取真实材料与文件结构;不请求模型、不读取凭证。
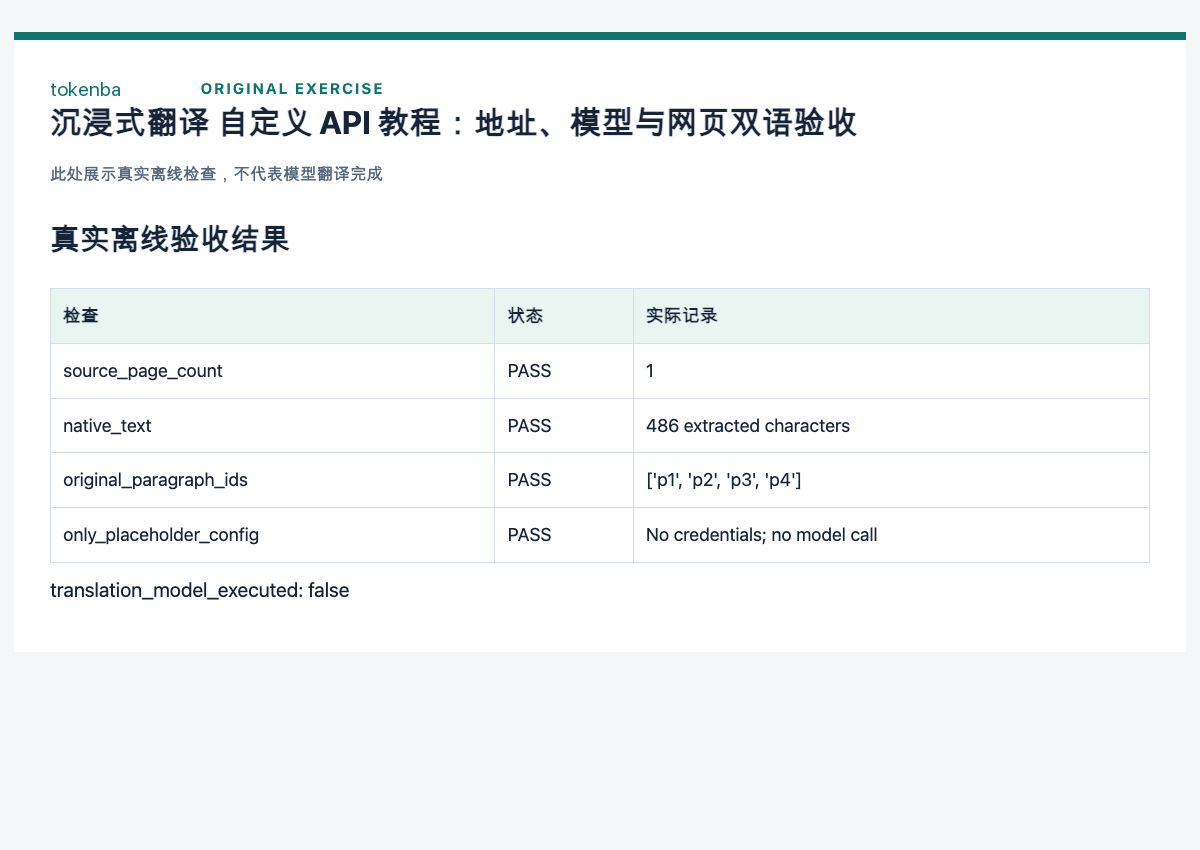
当前材料与脚本的实际运行结果。
本页专用练习材料;运行范围见 README。
本页专用练习材料;运行范围见 README。
本页专用练习材料;运行范围见 README。
1. 先打开原创网页
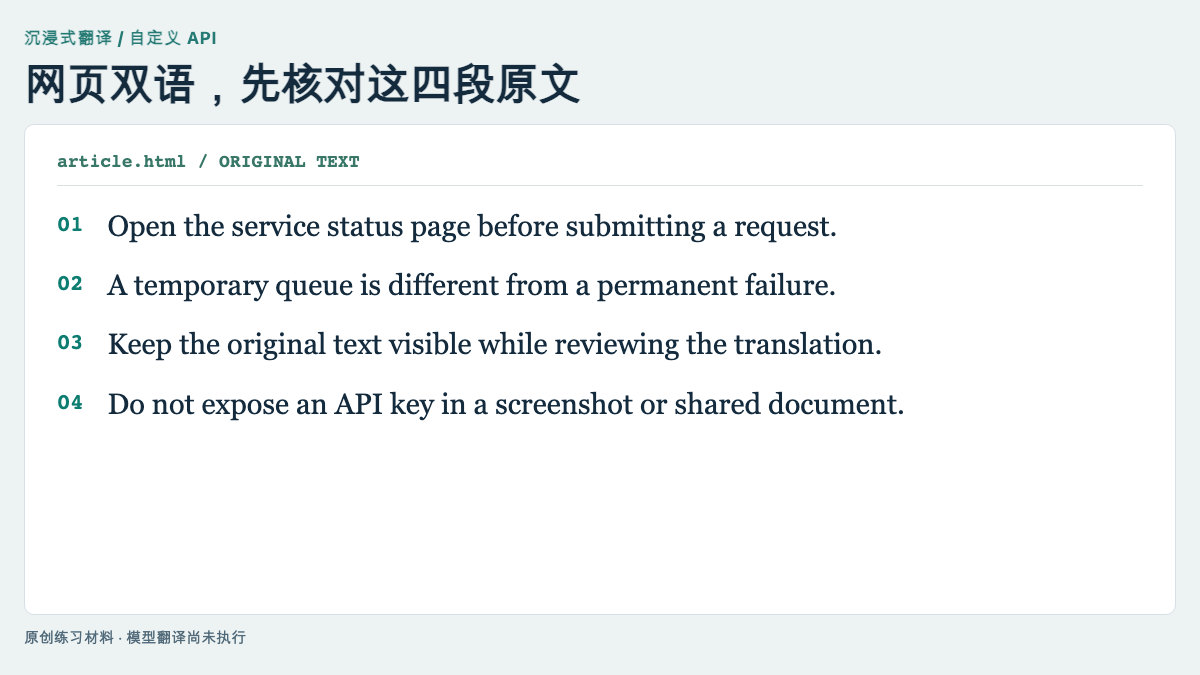
包内 article.html 含四个独立段落与明确段落 ID。用本地 HTTP 服务打开,避免浏览器对 file:// 的扩展权限差异;本页截图就是未翻译的真实输入。
bash
python3 -m http.server 8048 --bind 127.0.0.1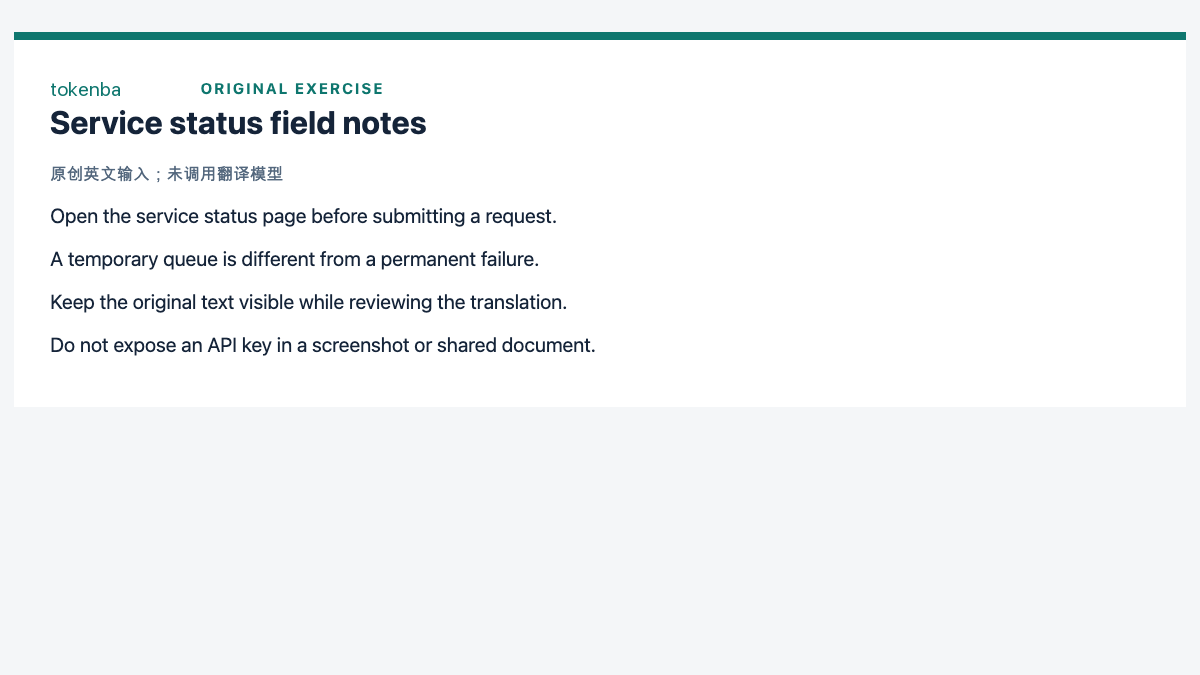
2. 选择官方支持的服务入口
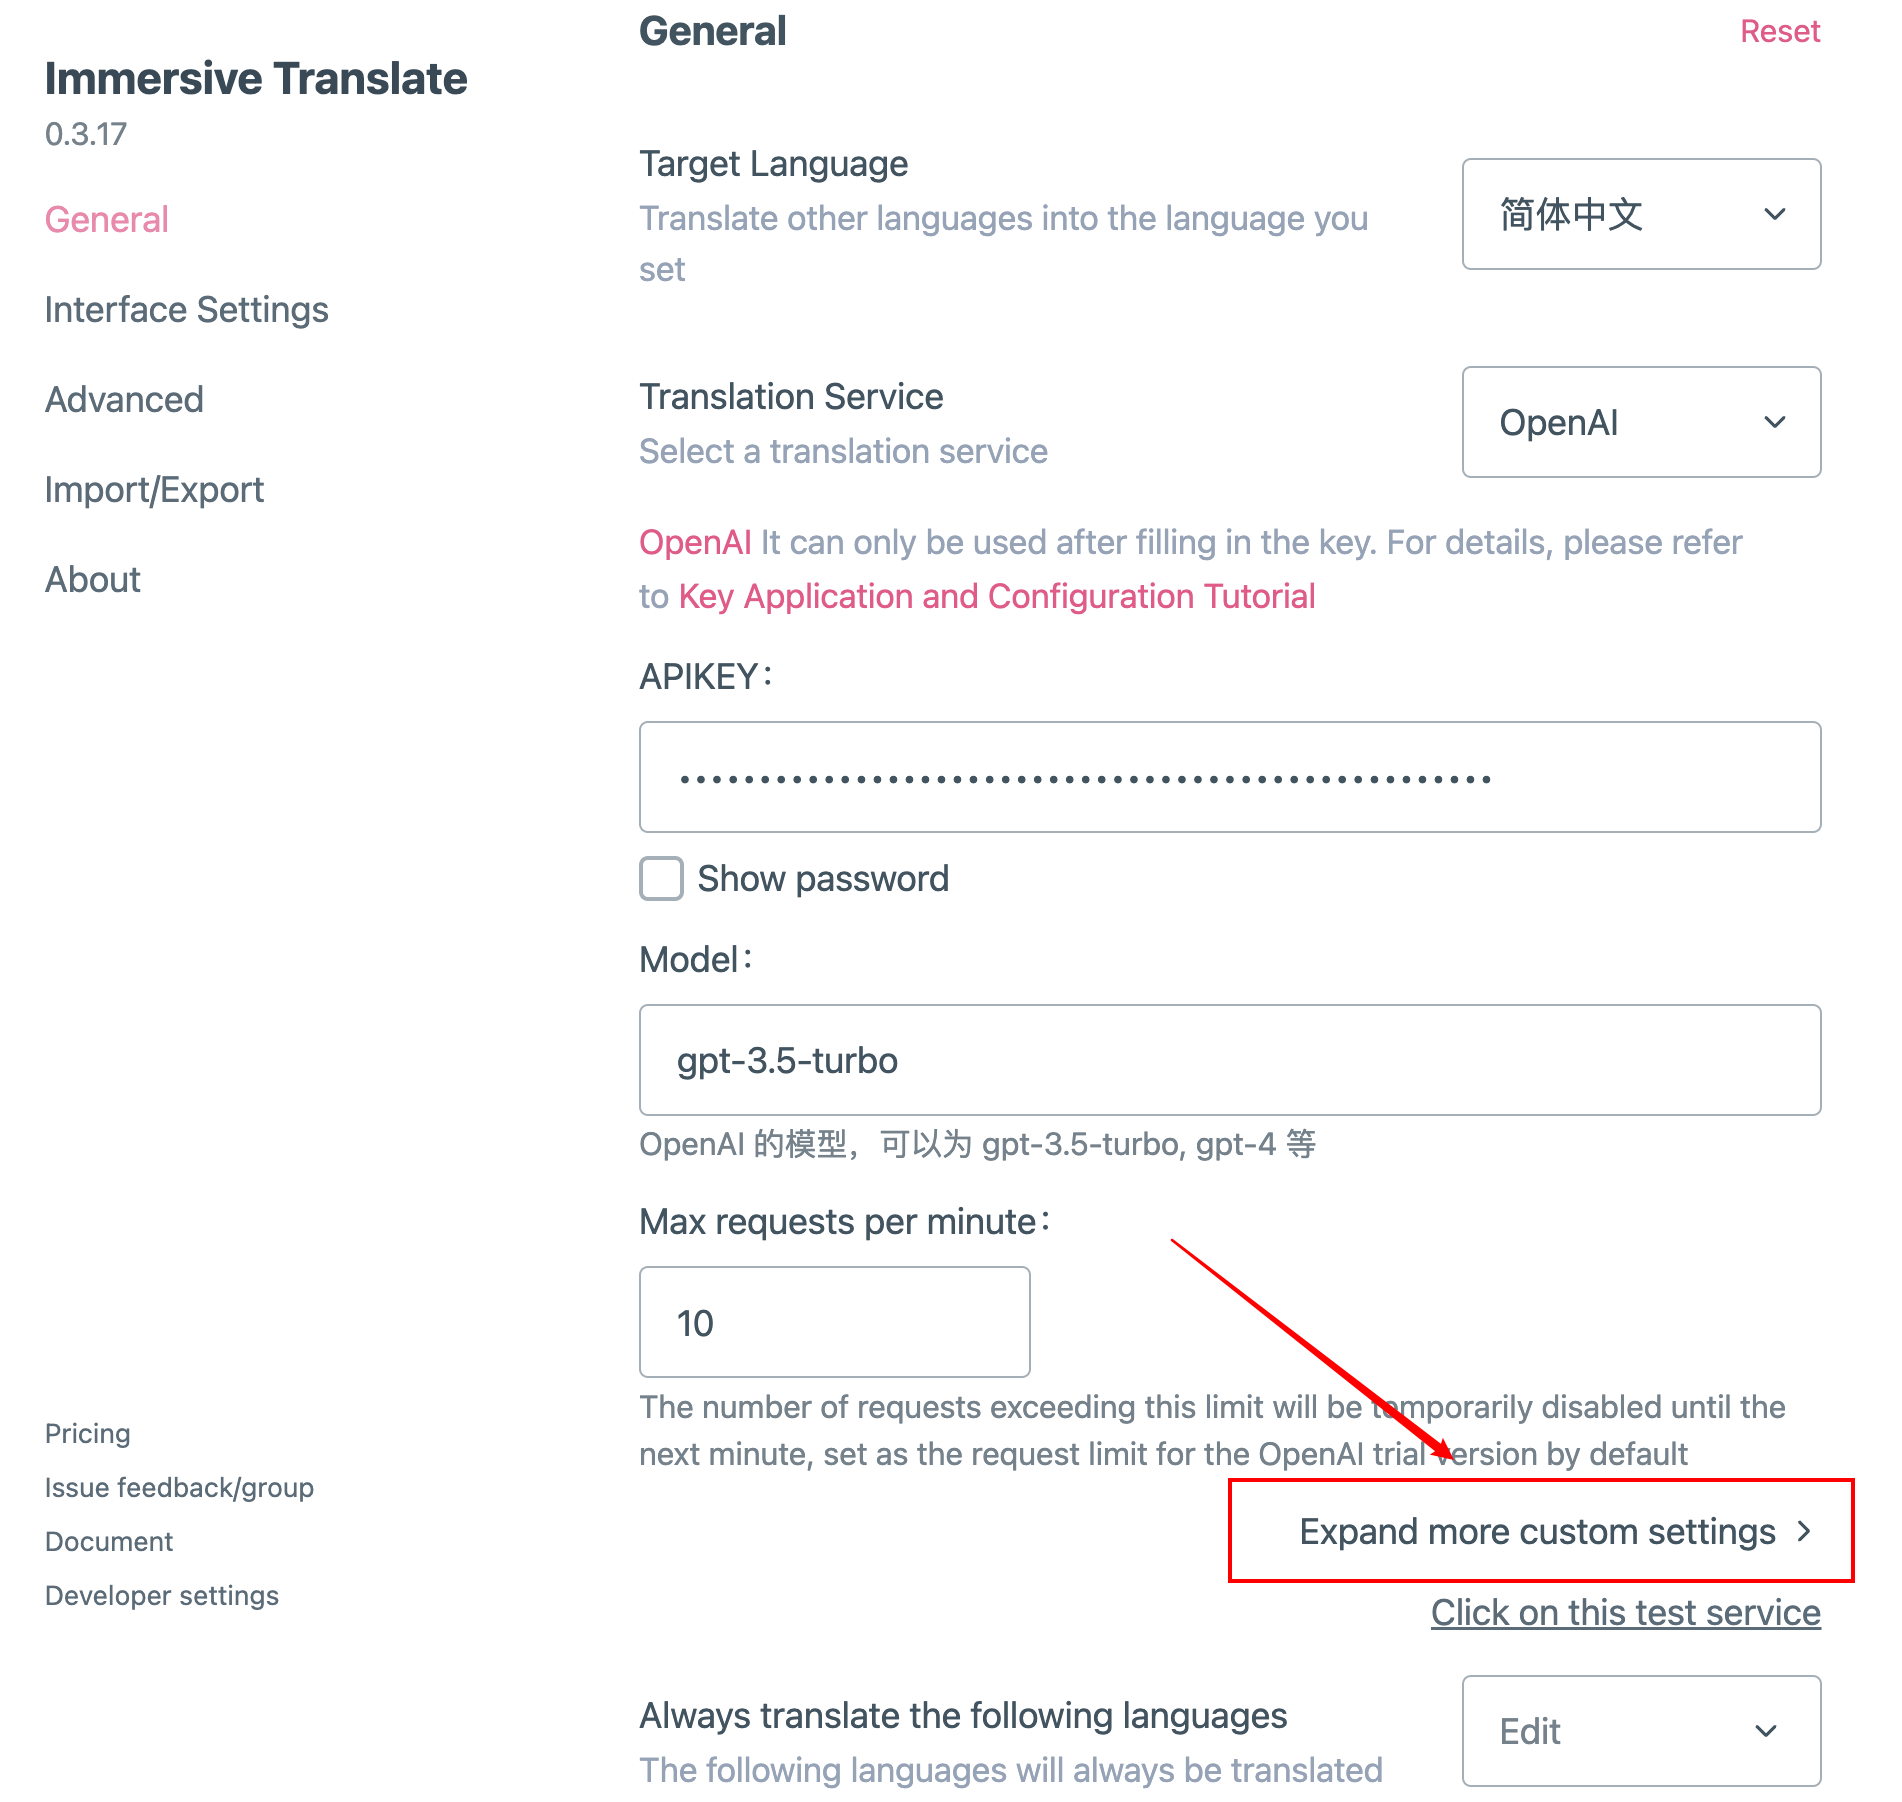
在沉浸式翻译设置中选择 OpenAI 或对应自定义兼容服务,展开更多设置。官方图是历史设置参考,字段与套餐以当前插件为准;不沿用该文档中的旧模型价格。
3. 复制实际服务地址
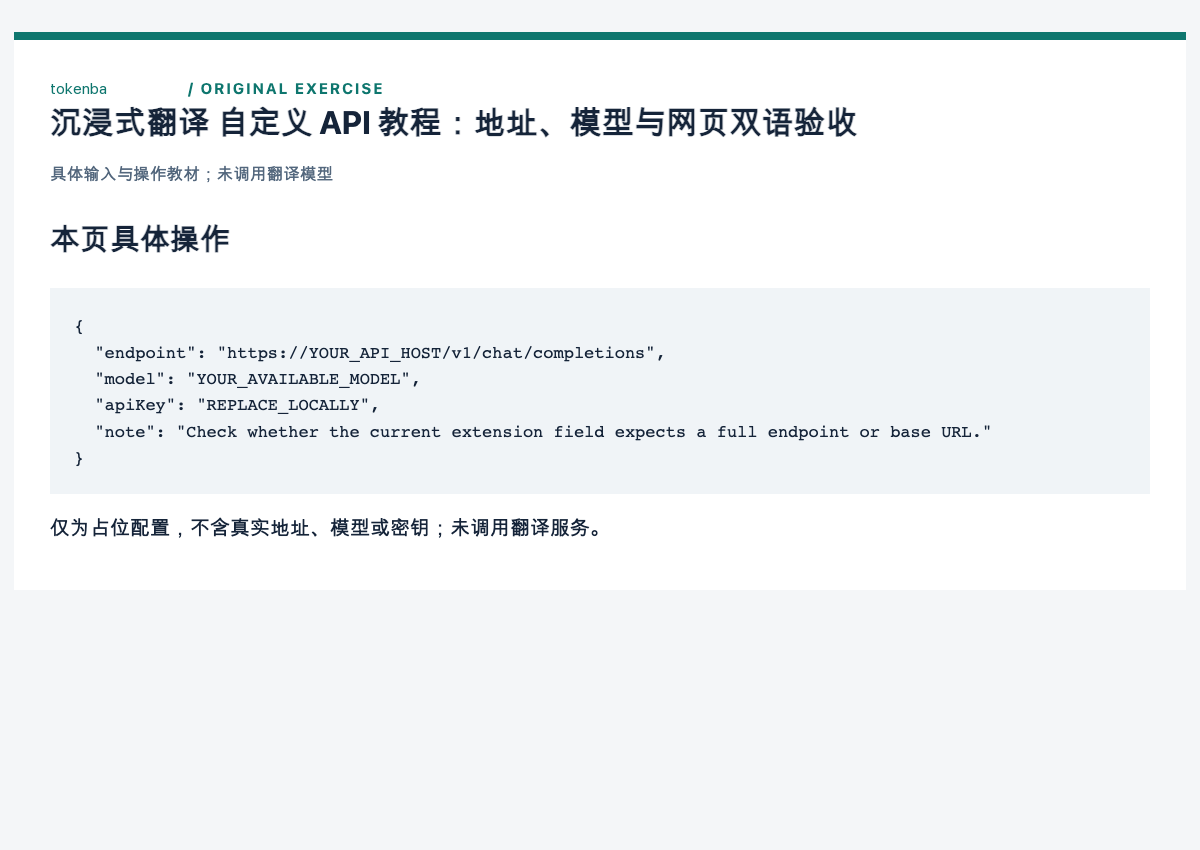
从自己的服务后台复制 API 地址。注意字段要求完整请求 URL 还是 Base URL:若要求完整端点才填写 /v1/chat/completions,不要盲目补两次 /v1。settings.example.json 只有占位符。
4. 选择实际可用模型并测试
填本机 API Key 和后台列出的模型 ID,先点连接/服务测试。401、404 与 429 分别排查凭证、地址/模型、额度/频率;测试成功仍不等于四段网页已完整翻译。
5. 翻译这四段原文
打开 http://127.0.0.1:8048/article.html,触发网页翻译。保留原文显示,逐段检查译文是否紧随正确段落;菜单和快捷键以实际版本为准。
6. 逐段填验收表
在 paragraph-check.csv 写入每段实际译文,复查 temporary queue 与 permanent failure 没有混淆。HTML 验证脚本只检查原文段落 ID 与格式,不调用模型。
bash
python3 verify.py7. 保存脱敏配置
只分享服务域名、端点形态、模型与测试状态,删掉密钥与账号信息。使用 apizt 等兼容服务时仅在官方支持的自定义地址字段配置;插件账号功能仍受其自身规则约束。
怎样确认已经完成
- 原文四个段落的 ID 与顺序均保持,译文逐段对应。
- 端点与模型来自实际后台,字段没有重复 /v1 或错误 /chat/completions。
- 未把离线 HTML 检查或官方历史截图当真实模型调用记录。
常见问题
为什么 API 测试成功,网页还是没翻译?
连接测试只验证部分服务调用;还要检查网页匹配规则、扩展权限、是否已触发翻译和实际段落请求错误。
把 Base URL 后面都加 chat/completions 可以吗?
不可以。字段有的要求完整端点,有的自动拼接;按当前插件说明填写,出现 404 时先核对最终路径。