
展开本页目录
开始前准备什么
- Python环境与本地CPU;Indra使用ONNX,不需要PyTorch或GPU,首次运行需下载约76MB默认模型,math模型另计。
- 代码Apache2.0;权重modified OpenRAIL-M,有企业规模与竞争用途限制,不能宣传无限制免费商用。
- 本课原生材料可离线免费检查;目标识别未执行,实际page.source/conf/坐标只能运行后填写。
- 制作易混淆清单
- 保存逐行结果
- 建立复核队列
- 回看变音符区域
- 抽查高分行
- 记录校对来源
- 交付复核报告
1. 制作易混淆清单
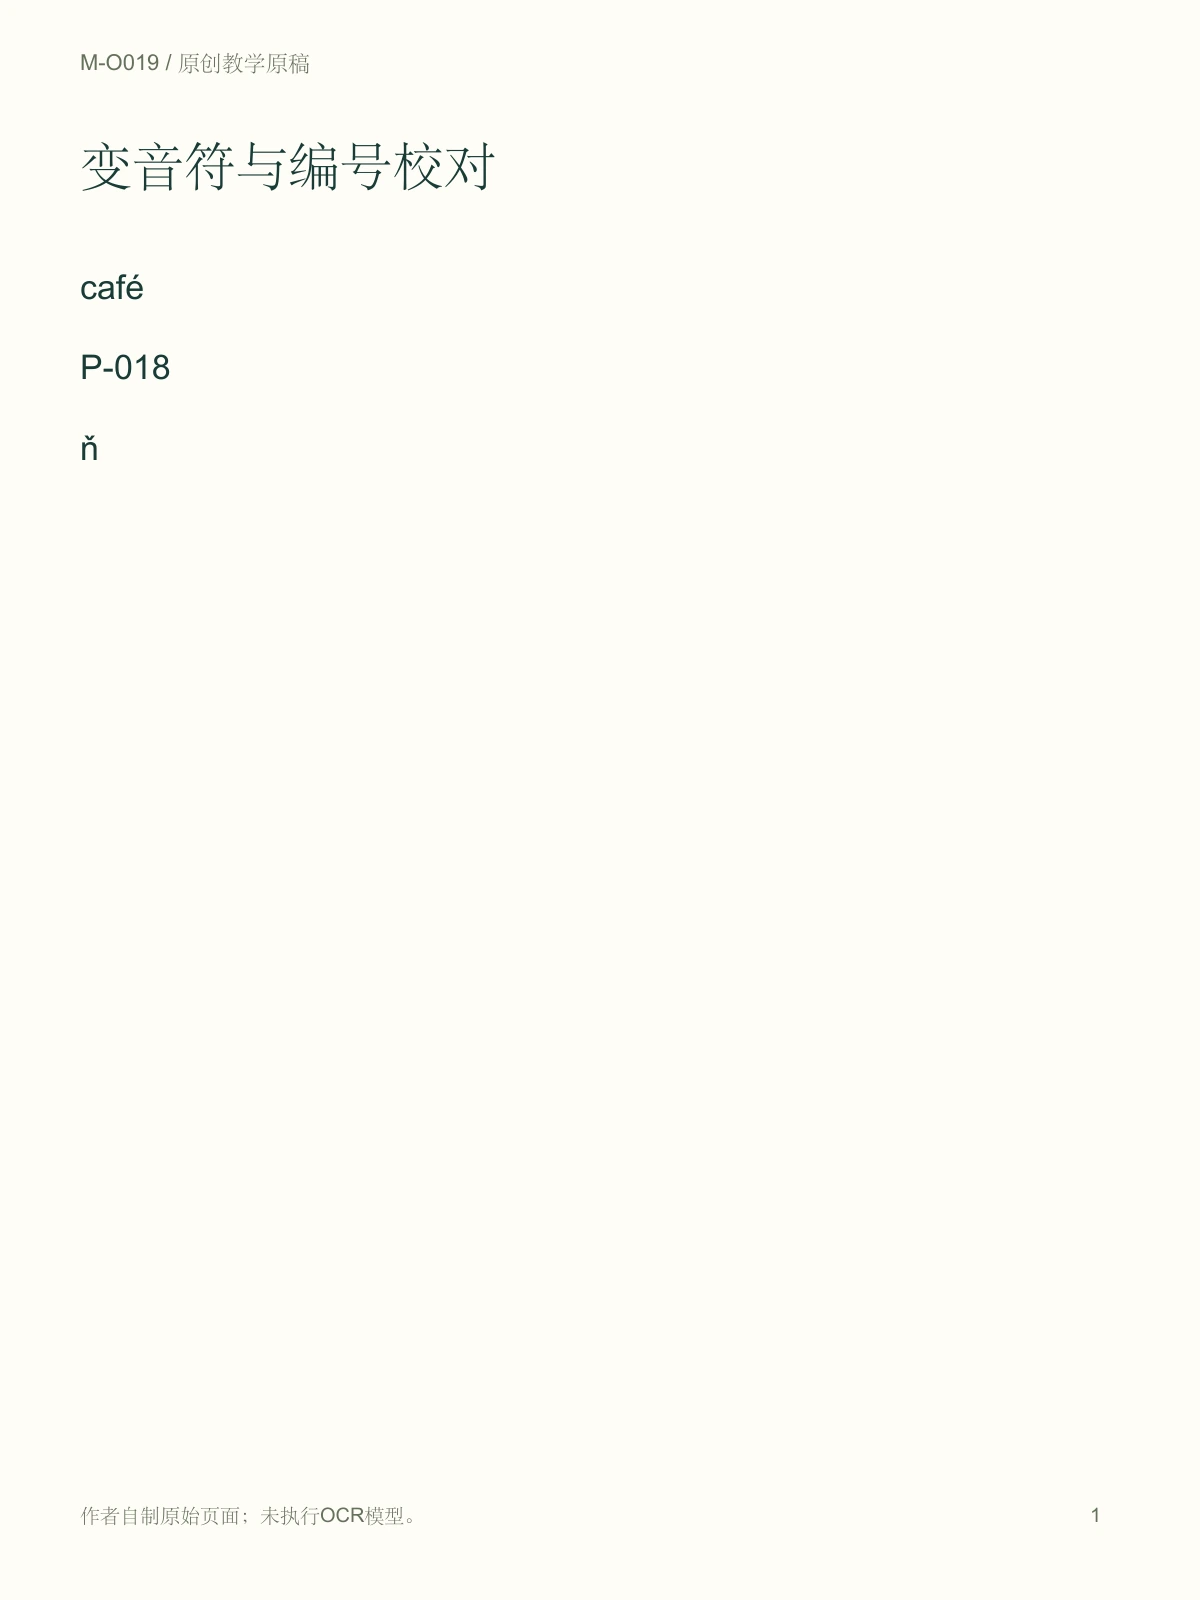
原稿放café、编号P-018与带变音符的ň,并保留高清字形。
这些是教学字符串,不使用真实证件。
2. 保存逐行结果
读取真实page.lines的text、box与conf。
置信度只能从实际结果取得,作者测试分数必须标synthetic。
3. 建立复核队列
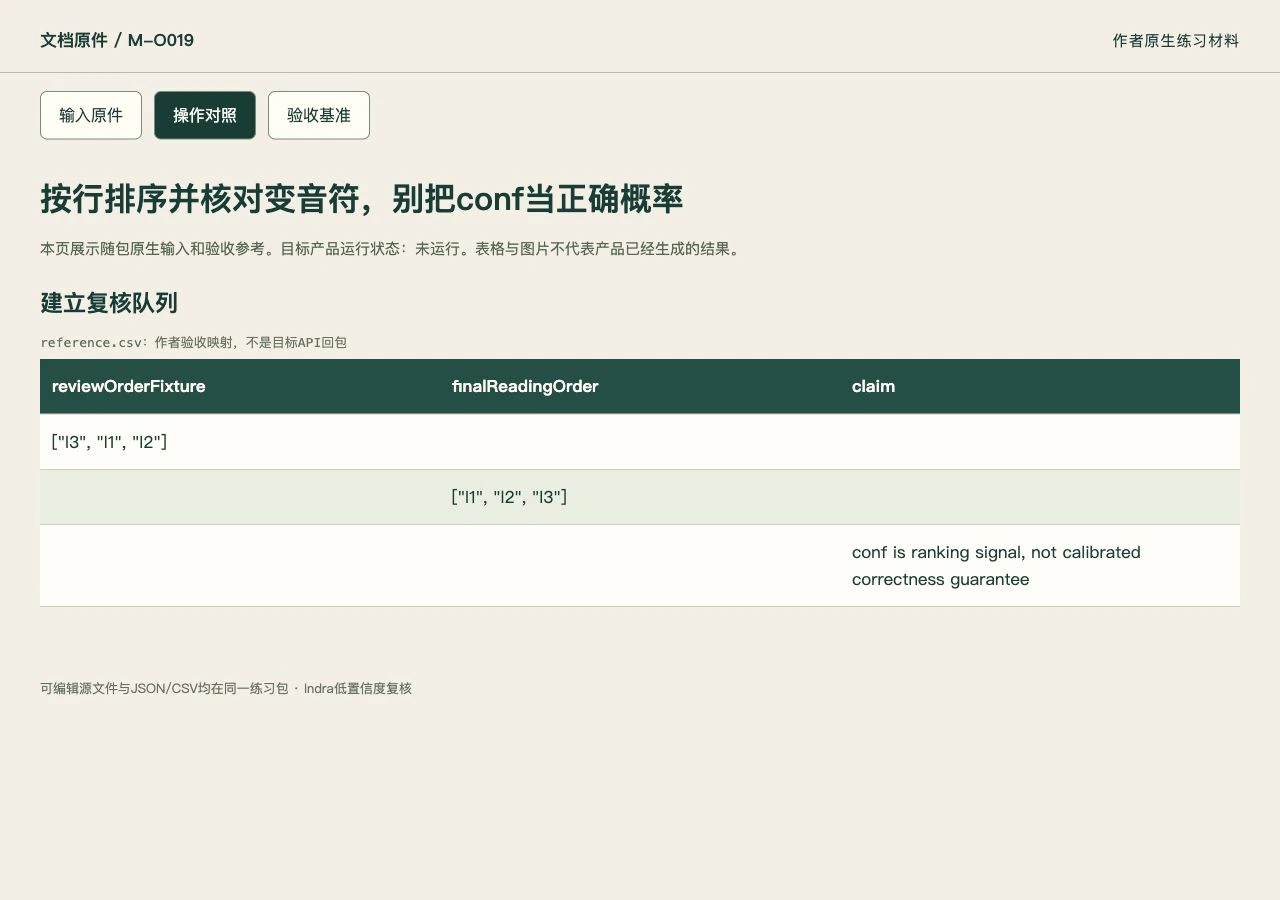
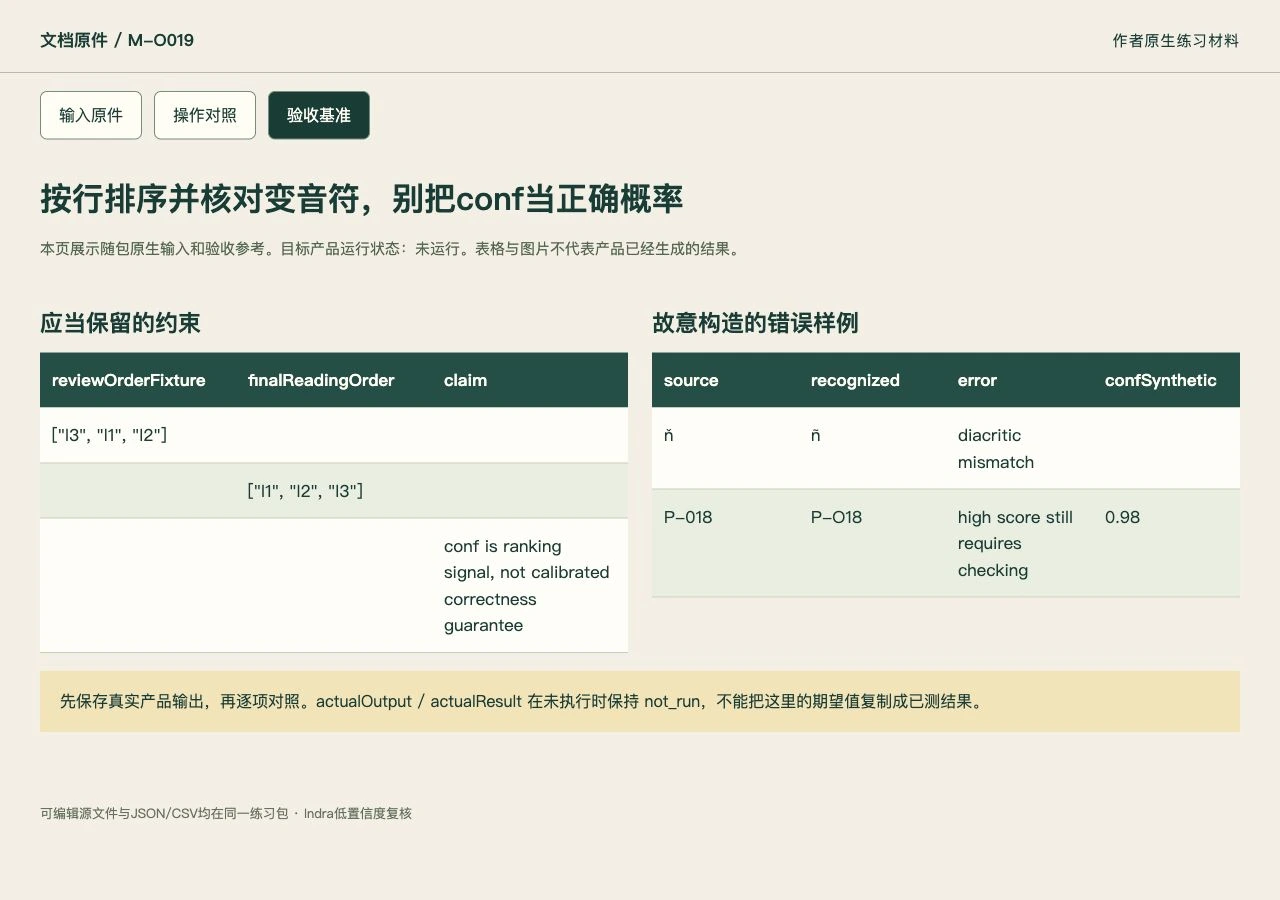
按conf从低到高排序,保留原readingOrder。
排序只改变复核顺序,不改变最终文档阅读顺序。
官方界面与功能位置
以下为官方文档配图,具体版本与账号入口以当前产品为准。本课练习输入与验收对照见相邻步骤。
4. 回看变音符区域
把原框放大,逐字核对ň、ñ等近似符号。
官方说明某些Latin变音符容易混淆,不能仅凭词形看起来合理通过。
5. 抽查高分行
至少抽查一条高分编号,核对0/O、1/l。
高分也可能错,不把阈值以上当已人工校验。
6. 记录校对来源
修订值与原OCR值分列,记录人工确认人/时间。
对无法辨认的原稿保留未定,不用词典强猜。
7. 交付复核报告
同时保存原阅读序与复核序,标明conf不是已校准准确率。
未运行模型时只演示作者队列,不声称当前模型分数分布。
下载本课材料并开始操作
练习包包含本课的具体输入、可编辑数据、正反样例与七步说明。index.html 可离线查看原件和验收参考,actual-results.csv 用于记录你实际操作后的结果。
怎样确认已经完成
- 复核排序不破坏readingOrder。
- 变音符有原图放大证据。
- 高分行仍有抽查且不宣称概率保证。
常见问题
conf是0.95,就代表95%一定认对吗?
不能直接这样解释。官方提供行置信度,但本课没有做概率校准;它适合帮助排序复查,不替代原图核对。
把低分行改完就能交了吗?
还要抽查高分行,尤其编号和变音符。高分错字并非不可能,最终交付应说明抽查范围和未确认项。