
展开本页目录
开始前准备什么
- 准备本篇使用的 Langflow 自定义组件教程 环境;当前入口与版本参照文末官方来源。
- 将本页下载包解压到独立练习目录,先读原始输入与 README。
- 只运行对应步骤所需依赖;离线检查与目标产品运行分别记录。
- 用含异常行的 CSV 定义目标
- 打开自定义组件 Python 编辑器
- 声明输入、输出和返回方法
- 调用标准库解析并保留状态
- 先单独运行组件查看三行
- 再接提示词组件生成解释
1. 用含异常行的 CSV 定义目标
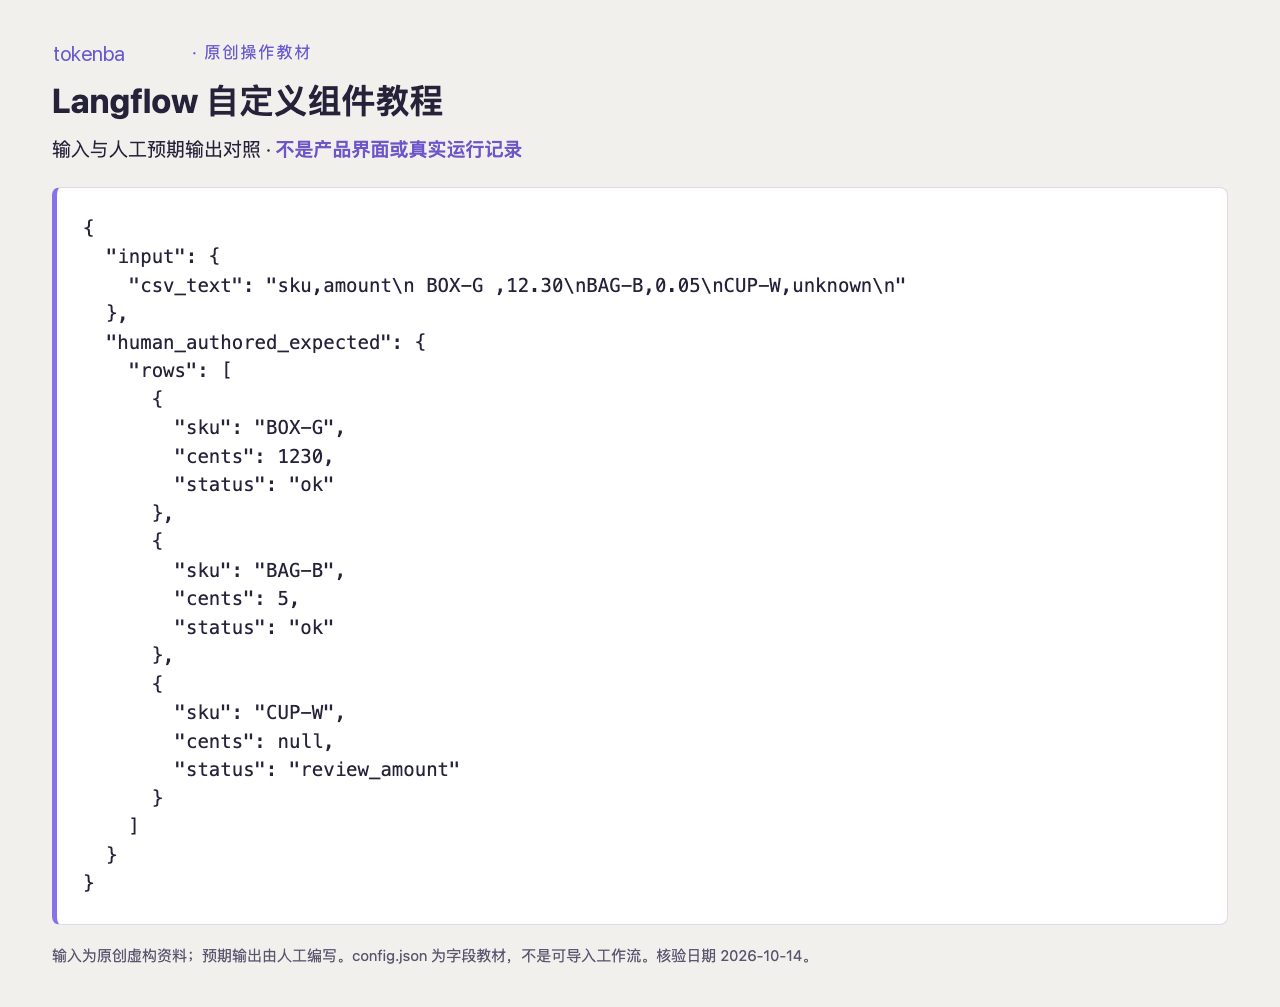
样例共 3 行:第一行 SKU 有空格,第二行金额 0.05,第三行 unknown。输出要保留每行,金额异常写 review_amount,而不是从列表静默删除。
2. 打开自定义组件 Python 编辑器
建立独立实验 flow,加入自定义组件并打开代码编辑器。官方当前示例采用 lfx 命名空间;先核对自己的 Langflow 版本及组件 API,教材不安装包或修改服务器。
3. 声明输入、输出和返回方法
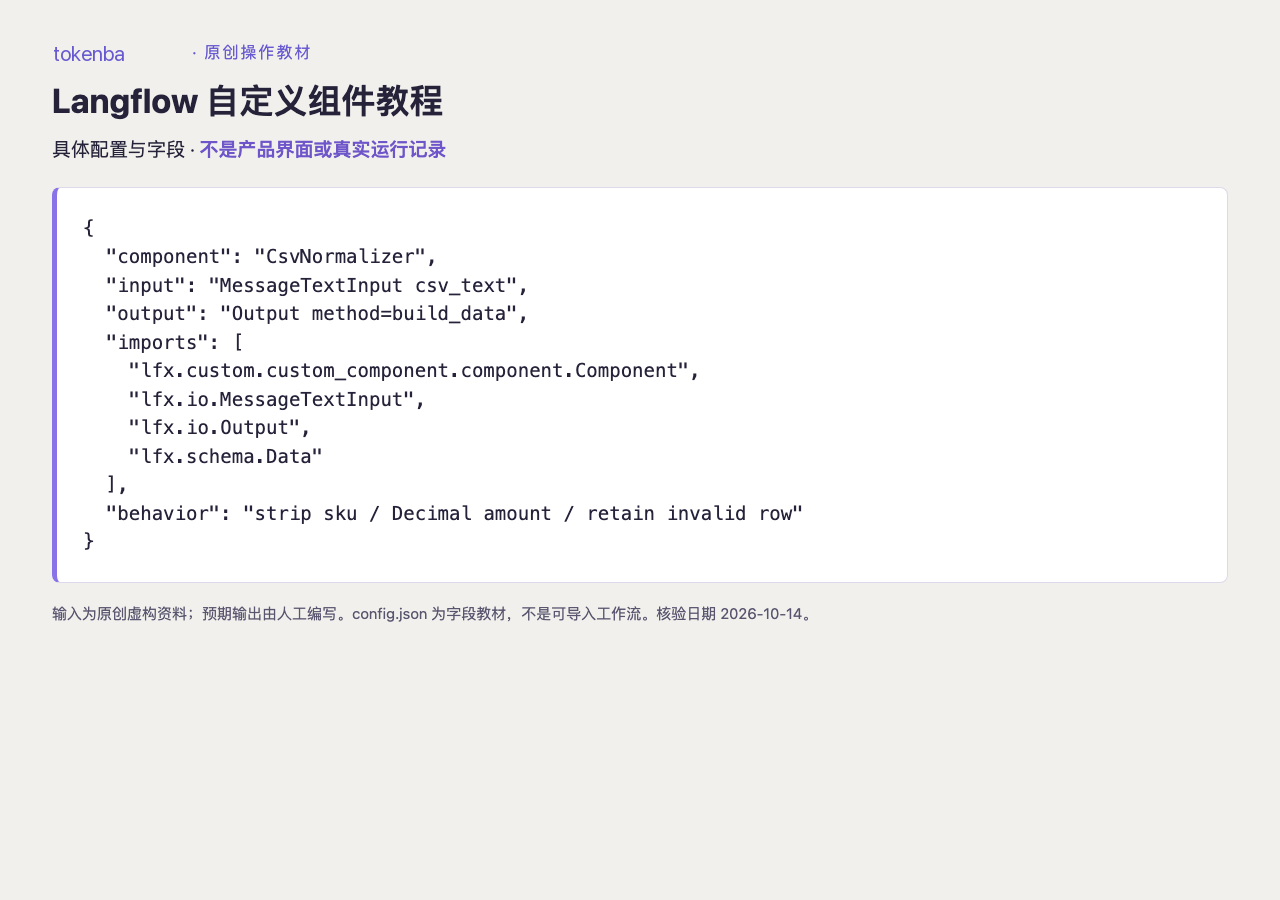
在下载区取得 component.py,在组件编辑器查看并载入完整类定义;页面下方 JSON 只说明字段,不是可执行组件或可导入工作流。MessageTextInput 的 name 为 csv_text,Output 的 method 必须与 build_data 同名,方法返回 Data(data={"rows": rows})。先按本页三个输入独立运行组件,再接模型。
config.json · 字段教材,不可作为工作流导入
{
  "component": "CsvNormalizer",
  "input": "MessageTextInput csv_text",
  "output": "Output method=build_data",
  "imports": [
    "lfx.custom.custom_component.component.Component",
    "lfx.io.MessageTextInput",
    "lfx.io.Output",
    "lfx.schema.Data"
  ],
  "behavior": "strip sku / Decimal amount / retain invalid row"
}
4. 调用标准库解析并保留状态
csv.DictReader 按列解析,SKU 去空格,Decimal 将两位金额转为 cents。检测负数、缺字段或格式不合规时写明状态,不让模型参与确定性清洗。
5. 先单独运行组件查看三行
粘贴 input.csv 后运行该组件,核对三行 ID、整数金额与异常状态。下载 check-fixture.py 可离线验证解析逻辑;完整组件未在 Langflow 实例运行。
6. 再接提示词组件生成解释
结构化结果进入提示词时,把 review 行与 ok 行分别列出,只要求模型解释异常和生成内部说明。数据清洗结果先验收,不能把模型重新计算金额作为通过依据。
7. 下载教材并运行离线核对
先下载完整教材包并解压,在材料目录运行 python3 check-fixture.py。脚本只读取原创输入、人工预期与配置,对照本页固定验收条件;通过说明材料内部关系一致,实际产品、模型与业务写入另需按前六步验证。
bash
unzip lesson.zip -d langflow-csv-normalizer-component
cd langflow-csv-normalizer-component
python3 check-fixture.py
怎样确认已经完成
- 三行均保留,SKU 空格正确去除。
- Decimal 转换为 1230、5,不用浮点近似。
- unknown 返回 null 和 review_amount,不伪造金额。
常见问题
为什么不让 LLM 直接解析金额?
确定性 CSV 与金额格式先用标准库处理,模型只解释已校验结果,便于重复验收且避免无效值被补成数字。
组件文件能保证在所有版本运行吗?
不能。当前官方 API 使用 lfx,本页提供代码与离线纯函数检查,实际组件还要在自己的版本确认输入、输出与类型。