
展开本页目录
开始前准备什么
- 下载本页 ZIP,保留原始输入和来源;示例材料不是模型输出。
- 按官方说明准备匹配软件/模型、设备或账号权限,权重与账号额度不包含在下载包。
- 本地检查需 Python 3 与 FFmpeg/ffprobe;真实结果需要实际生成并回听/看图。
- 先准备准确台词和可解码视频
- 区分 1.5 和 1.6 的推理门槛
- 按官方推理入口准备配置
- 固定一组基线参数
- 执行并保留真实输出
- 对照口型,而不是只看封面
1. 先准备准确台词和可解码视频
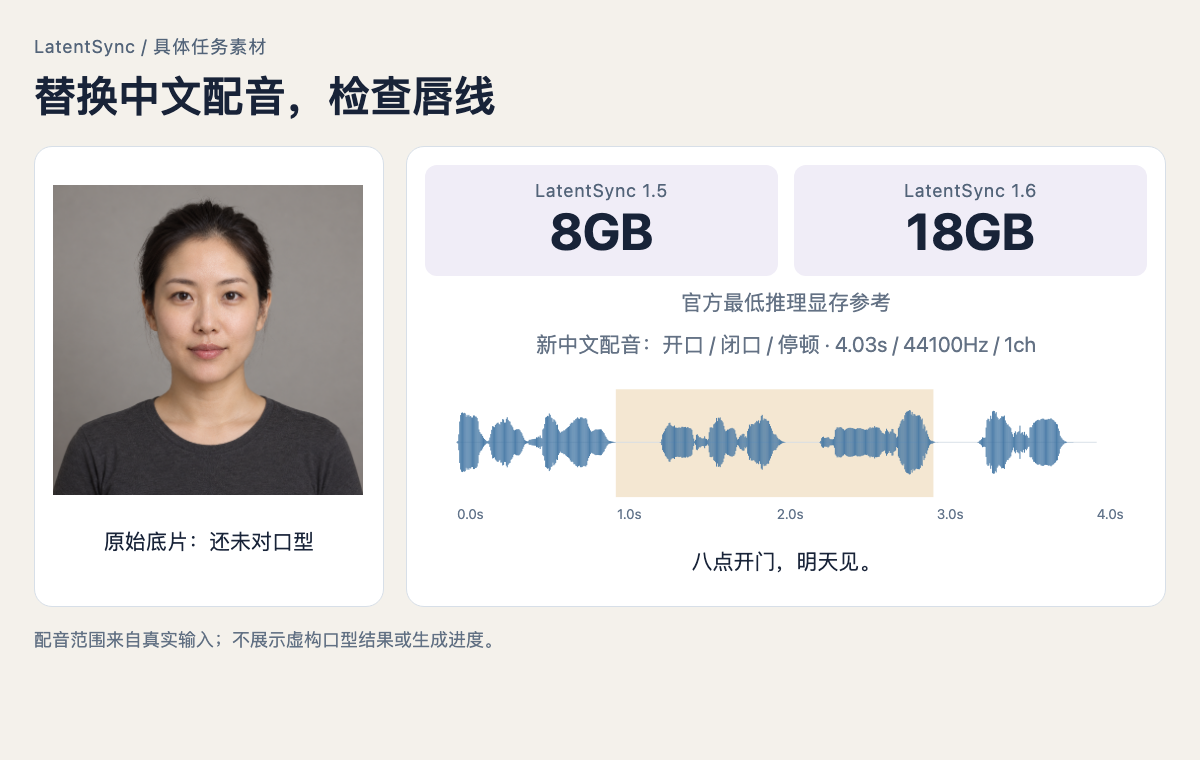
本包底片由原创虚构头像静态展示合成,中文配音是系统朗读,二者是真实输入,不是 LatentSync 成片。自己的正式任务可换成授权带侧转/停顿的原片;保留原片,避免质量损失累积。
2. 区分 1.5 和 1.6 的推理门槛
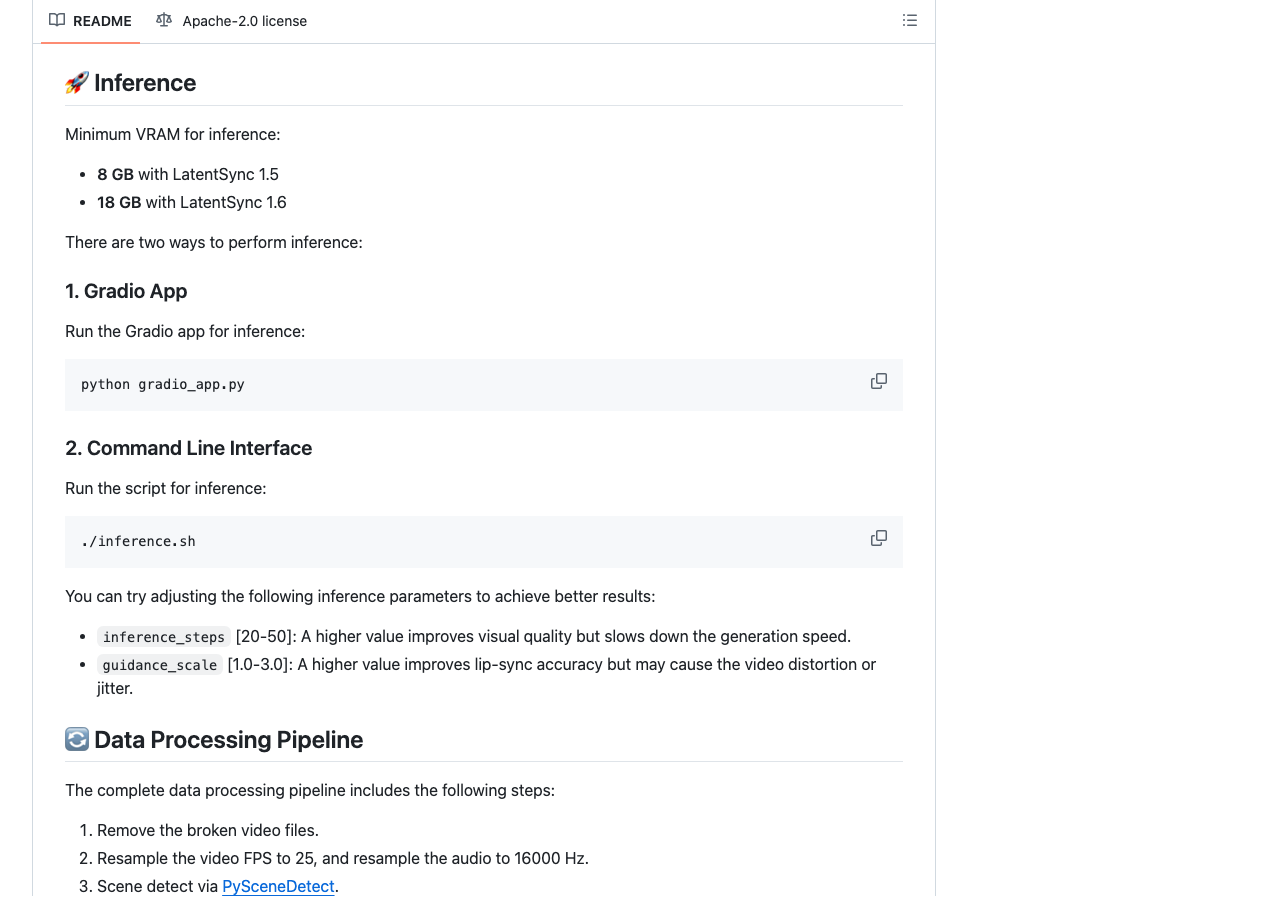
官方写 1.5 推理最低 8GB、1.6 最低 18GB 显存,1.6 对应 512×512 训练分辨率。本次机器没有准备此推理环境,不把训练门槛、Mac 统一内存或教程文件检查当作已跑通。
3. 按官方推理入口准备配置
官方 gradio_app.py 提供界面,inference.sh 给命令行。仓库只提供口型推理,不等于配音合成;本例先提供 narration.wav。下方是实际官方 README 的推理说明截图,不是假冒模型界面。
4. 固定一组基线参数
在独立目录准备权重后用 stage2_512.yaml、20 steps、guidance_scale=1.5 做初次运行。将视频/音频改绝对路径,先不要同时改变采样步数、引导和输入压缩,保存命令与版本。
5. 执行并保留真实输出
下方命令从官方 inference.sh 提取,video_out_path 指向新文件 dubbed.mp4。出现显存不足或人脸未检出时保存错误,不用系统朗读视频或其它模型结果顶替。
运行步骤
# 在已准备 LatentSync 1.6 权重的仓库运行
python -m scripts.inference --unet_config_path configs/unet/stage2_512.yaml --inference_ckpt_path checkpoints/latentsync_unet.pt --inference_steps 20 --guidance_scale 1.5 --enable_deepcache --video_path /绝对路径/portrait-input.mp4 --audio_path /绝对路径/narration.wav --video_out_path dubbed.mp4
6. 对照口型,而不是只看封面
根据 transcript.txt 标出“八”的张嘴、“门/明”的闭唇和静音处,回看牙齿、脸颊边缘与抖动。相同时间的输入帧只作定位;实际结果需由用户推理后带入 check.py 并逐句回听。
7. 实读输入与坏文件,再检查你自己的输出
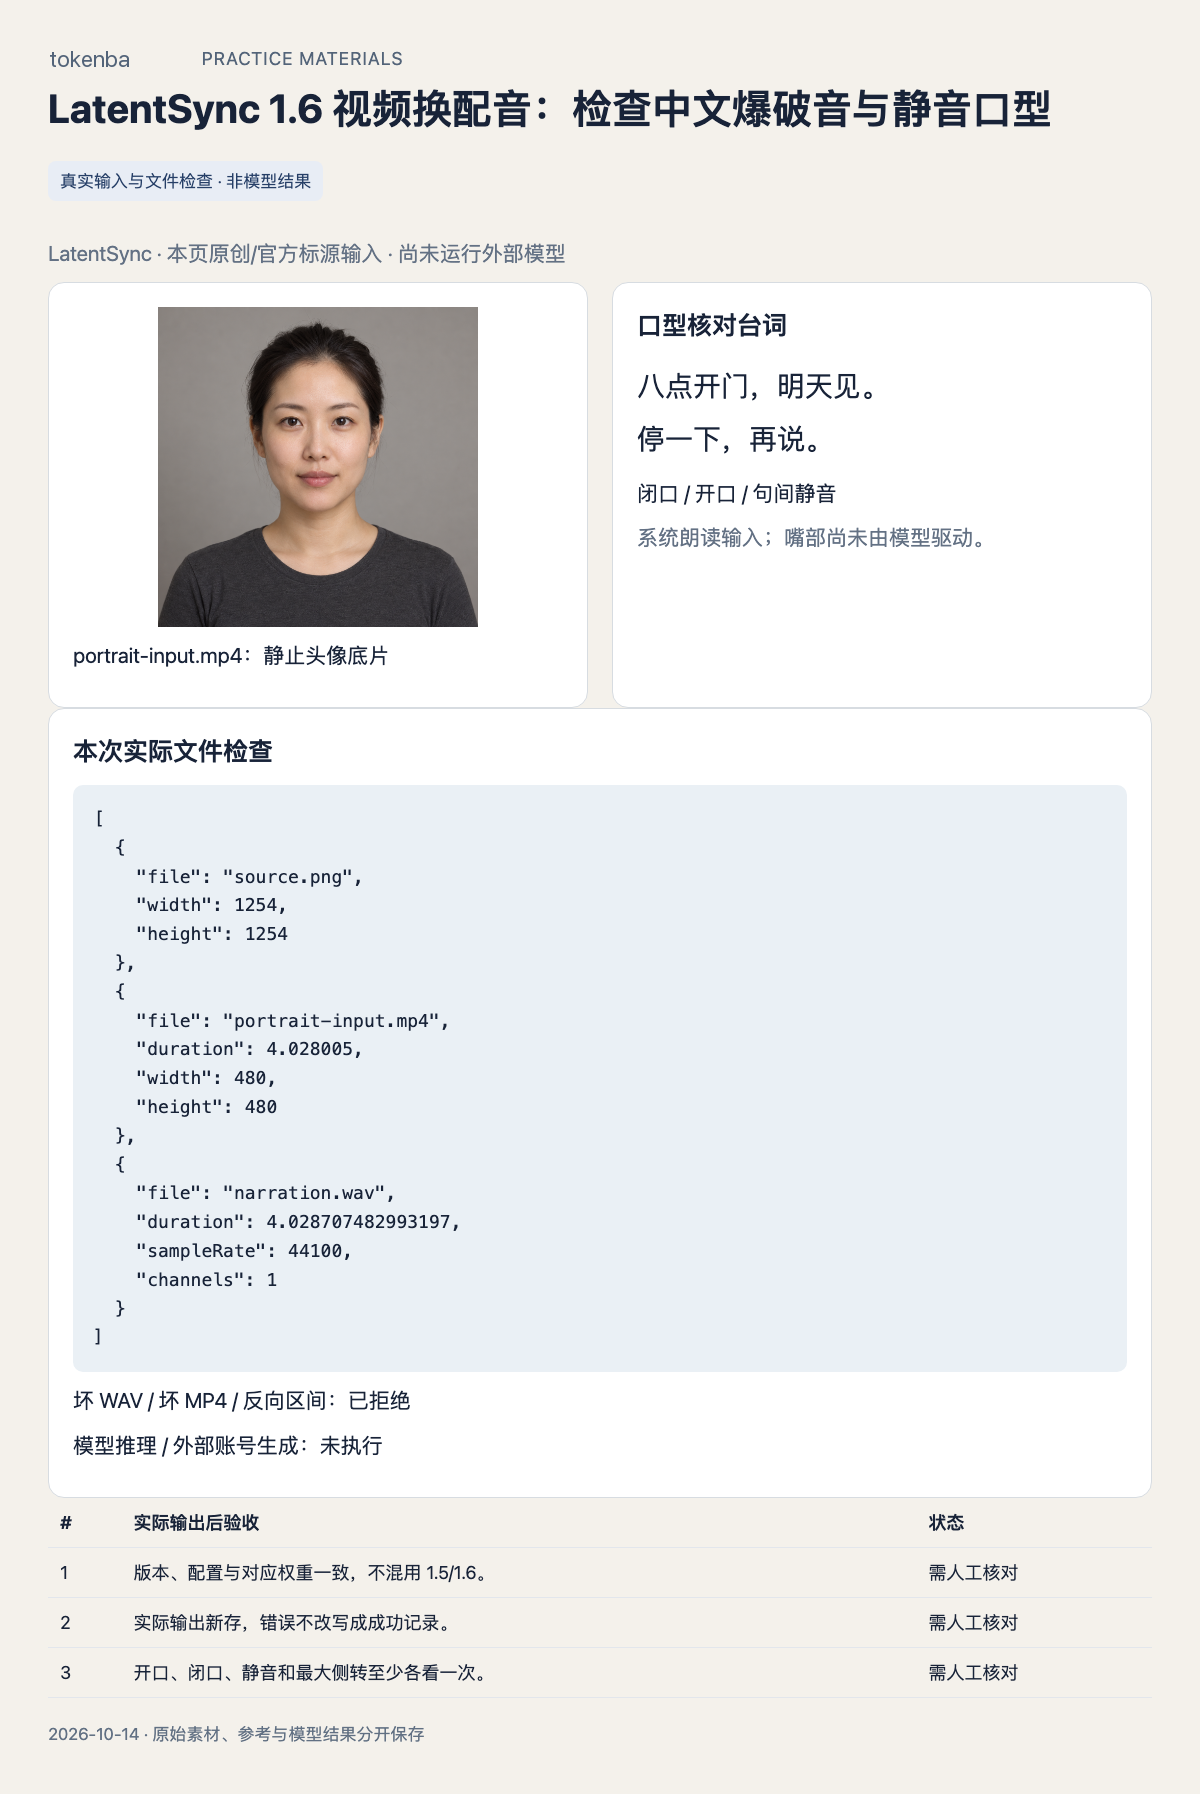
在解压目录运行 python check.py --self-test。脚本读取本页 provenance.json 的输入 hash,检查真实音视频/PNG 和目标区间;坏 WAV、坏 MP4 与反向时间范围应被拒绝。它不会下载模型、请求账号或自动判定口型、音乐质量。输入检查结果见 input-check.json。实际运行后用 --result 指向新文件,并逐项回听/看图。
check.py
python check.py --self-test
python check.py --result 你实际导出的文件.mp48. 交付原始输入、真实输出和待确认项
保留 README、原始输入、parameters.json、provenance.json 和你实际生成的文件;将模型/软件/账号版本、设备和错误写入独立运行记录。review.csv 的 pending 由真实回听/看图后更新,未运行项目不改成 done。配图中的原始参考与官方示例不代表本站已生成同样成果。
怎样确认已经完成
- 版本、配置与对应权重一致,不混用 1.5/1.6。
- 实际输出新存,错误不改写成成功记录。
- 开口、闭口、静音和最大侧转至少各看一次。
常见问题
18GB 指的是训练还是推理?
这里引用官方 1.6 的最低推理显存。训练配置的更高数字是另一件事,读者应按当前仓库与实际设备核对。
本教程已经在 Mac 上完成推理了吗?
没有。本站验证输入音视频与检查脚本,没有执行 LatentSync 模型;不据此宣称 Apple Silicon 原生支持或生成速度。