
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 把三种错误分开留样
- 检查期望路由表
- 配置LiteLLM两类fallback
- 用可控测试提供方触发错误
- 核对上下文与采样兼容
- 检查重试与鉴权失败边界
- 交付每次尝试的原因链
1. 把三种错误分开留样
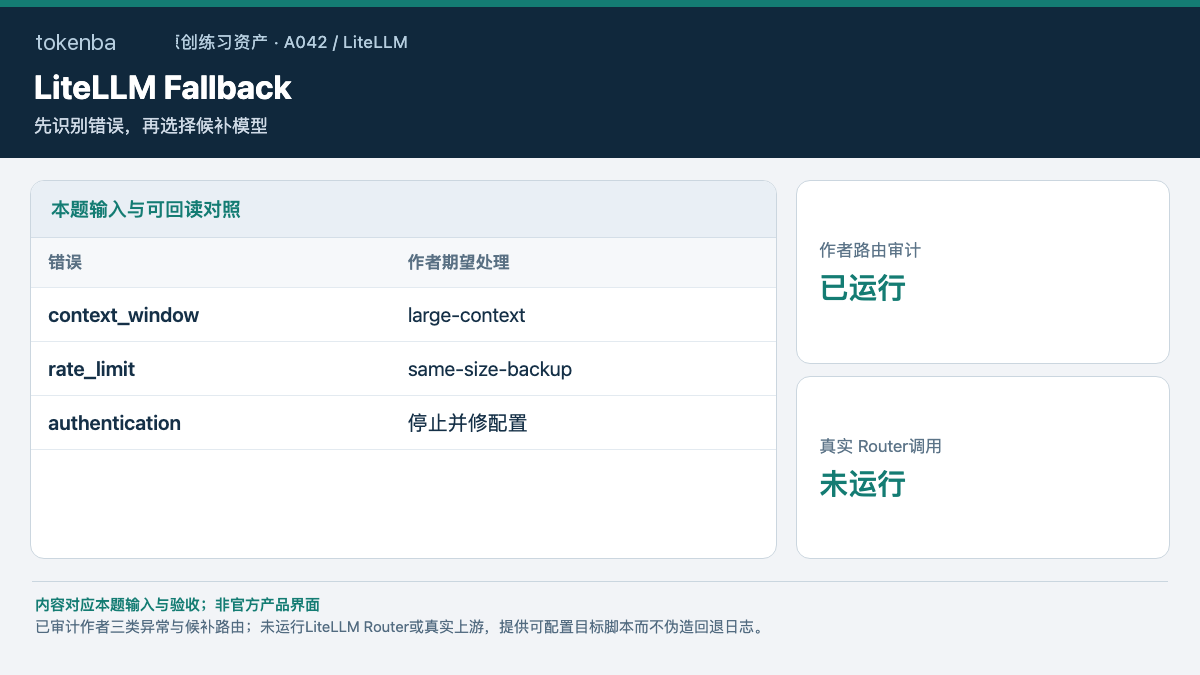
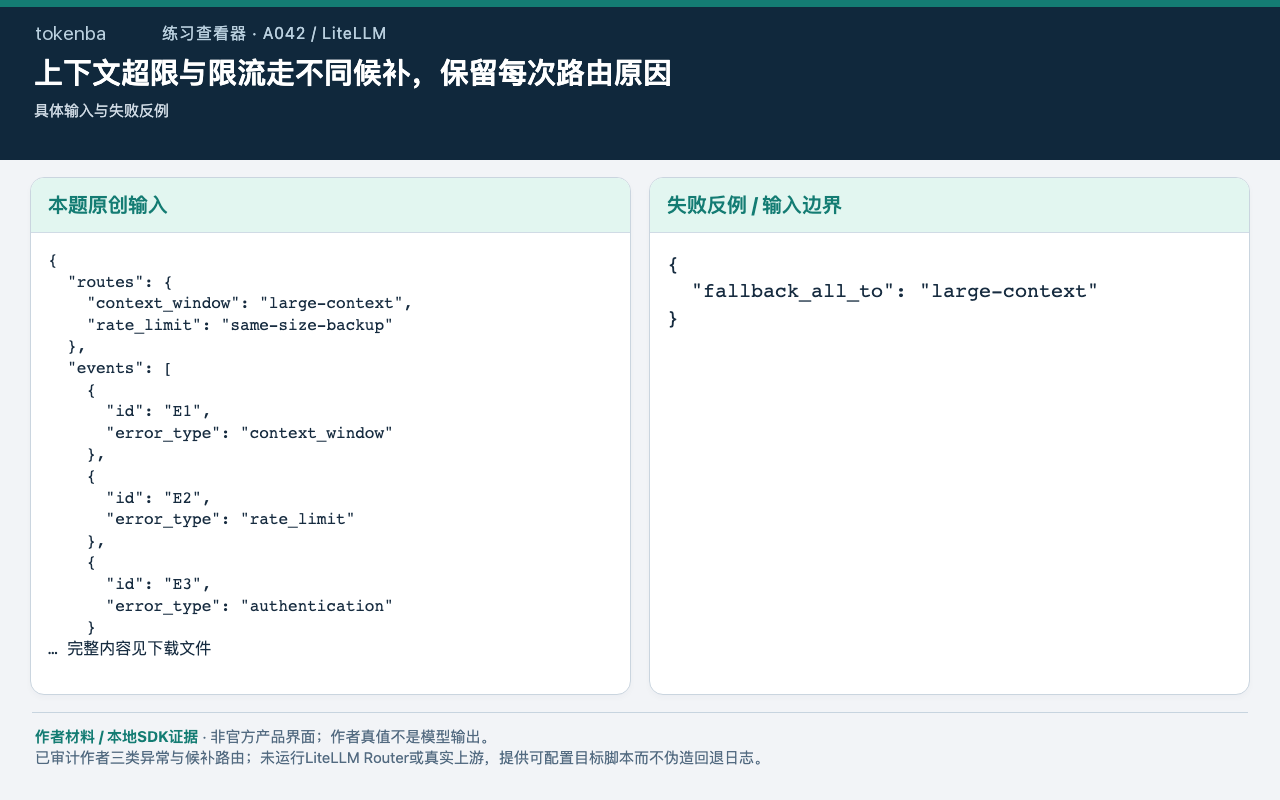
E1上下文超限,E2限流,E3鉴权失败。错误类别来自真实异常类型或body,不能只看任意4xx就随便切模型。
2. 检查期望路由表
作者规则让超限走大上下文、限流走同级备用、鉴权停止修配置。audit.py不发送网络请求,只审计路由合同。
本题独立目录执行
bash
python reference/audit.py3. 配置LiteLLM两类fallback
按当前Router文档分别设置常规fallbacks与context_window_fallbacks,核对模型别名。不要把伪字段放入config后忽略未生效警告。
本题SDK或目标环境入口
bash
python reference/run_sdk.py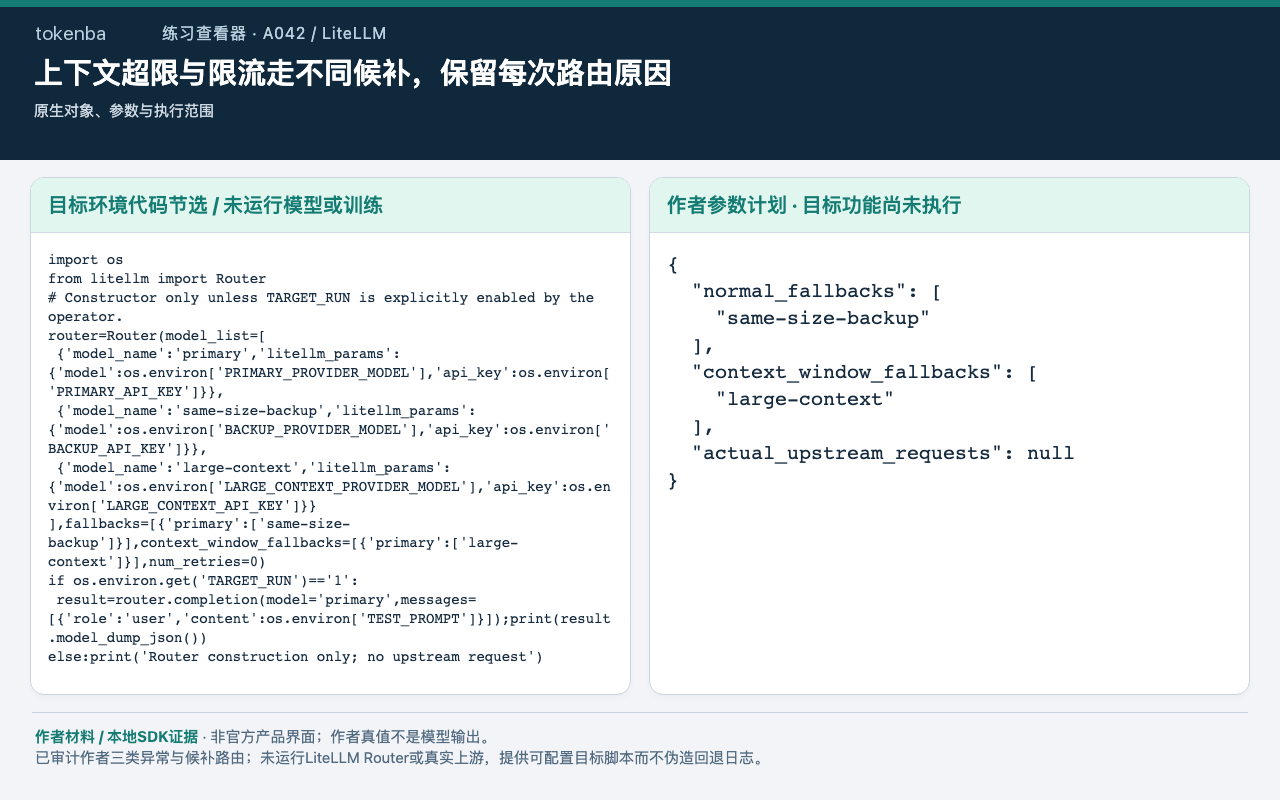
4. 用可控测试提供方触发错误
在隔离环境保存真实异常、路由尝试顺序和成功响应。禁止用自写JSON“已切换”冒充Router真实调用日志。
5. 核对上下文与采样兼容
备用模型必须能处理输入长度和业务要求;不能只因某个备用可用,就删除超长上下文或偷偷改变任务。
6. 检查重试与鉴权失败边界
限流重试按文档预算,鉴权错误要保留并修复;不要反复重试错误密钥或把回退成功掩盖配置问题。
7. 交付每次尝试的原因链
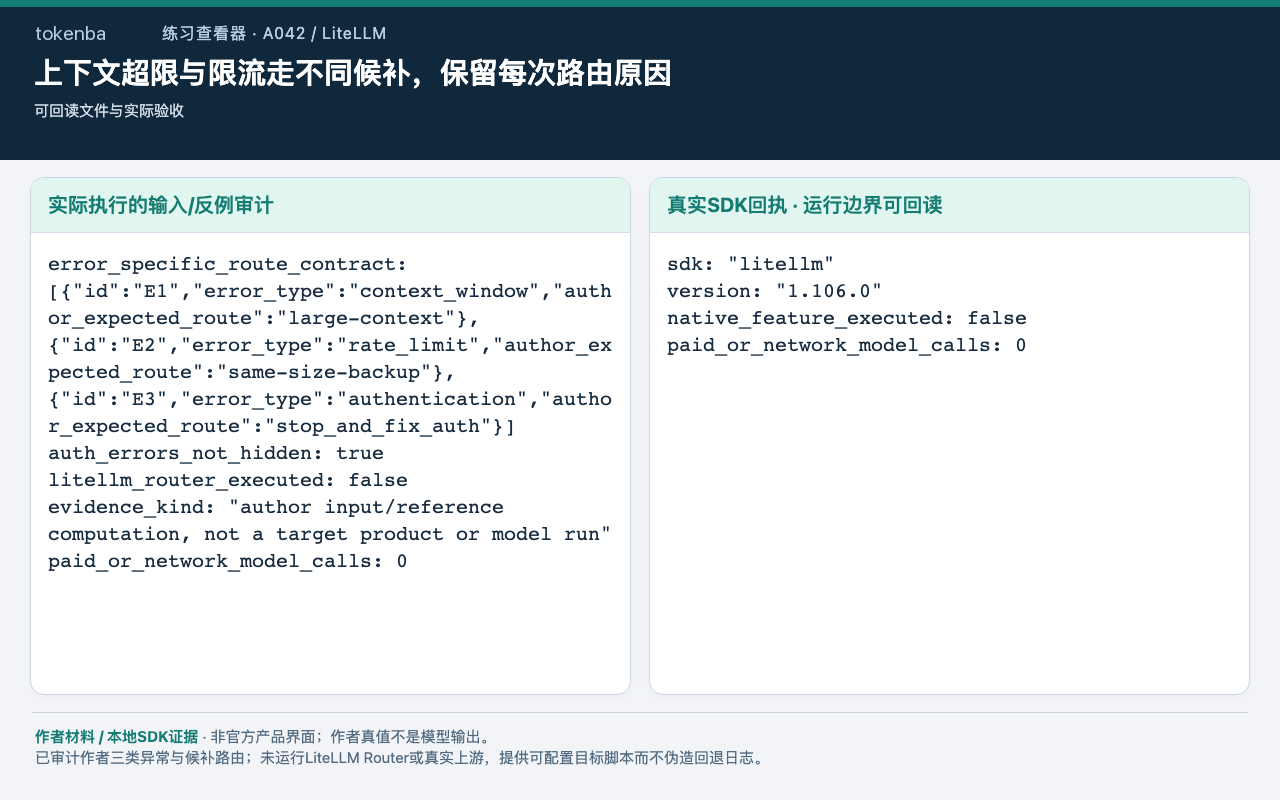
附请求ID、异常分类、模型序列与脱敏配置。当前包仅运行作者分类规则,没有实际Router或外部模型调用。
怎样确认已经完成
- stub与真实provider调用分开
- 不隐藏所有失败
- 不能将fallback当无限重试
- 已审计作者三类异常与候补路由;未运行LiteLLM Router或真实上游,提供可配置目标脚本而不伪造回退日志。
常见问题
LiteLLM上下文超限和限流能用不同候补模型吗?
可以按文档分别配置常规fallbacks与context_window_fallbacks,将限流候补和大上下文候补分开;先核对真实安装版。
Fallback实际换到了哪个模型,怎么保留路由原因?
保存每次异常类别、尝试模型、请求ID和最终返回。包内只有作者路由审计及未运行目标Router脚本,没有虚构真实回退轨迹。
这篇教程哪些步骤已经真正执行?
已审计作者三类异常与候补路由;未运行LiteLLM Router或真实上游,提供可配置目标脚本而不伪造回退日志。