
展开本页目录
开始前准备什么
- Open WebUI0.12.2;需Allow Multiple Models in Chat权限,两个模型都可访问并各自单独跑通。两份生成和一次合并至少有三次主要推理请求,实际额外请求/重试以日志与账单为准,不声称只收费一次或必然更准确。原提问可要求保留未知,但内置合并不保证事实正确;最终逐条人审。无需GPU、本地权重或外部搜索服务,远端模型API费用独立;保留Open WebUI品牌许可。
- 只在独立练习目录与自己的测试账号操作;使用准确模型ID,真实密钥不写入教材。
- 固定六条参观事实与未知格
- 在Compare Mode选择两个模型
- 同一提问生成两列原稿
- 先记录差异再做原生合并
- 点击当前答复的Merge Responses
- 逐条审校合并FAQ
- 重开聊天并归档原稿与费用
原创输入、任务提示、字段教材、源码参考、人工基准和实际本地输出;无需模型即可核对。
包含七步原生操作、版本、来源和目标平台待执行项。
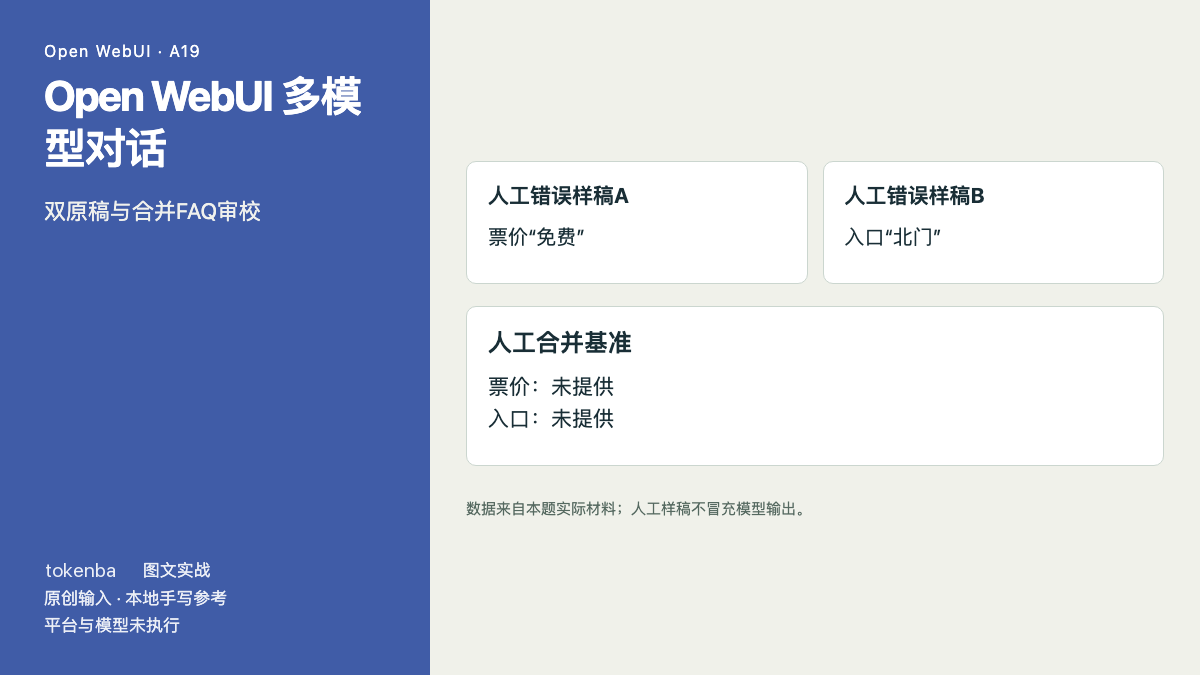
本站手写参考或人工基准的实际渲染,不是目标平台或模型输出。
1. 固定六条参观事实与未知格
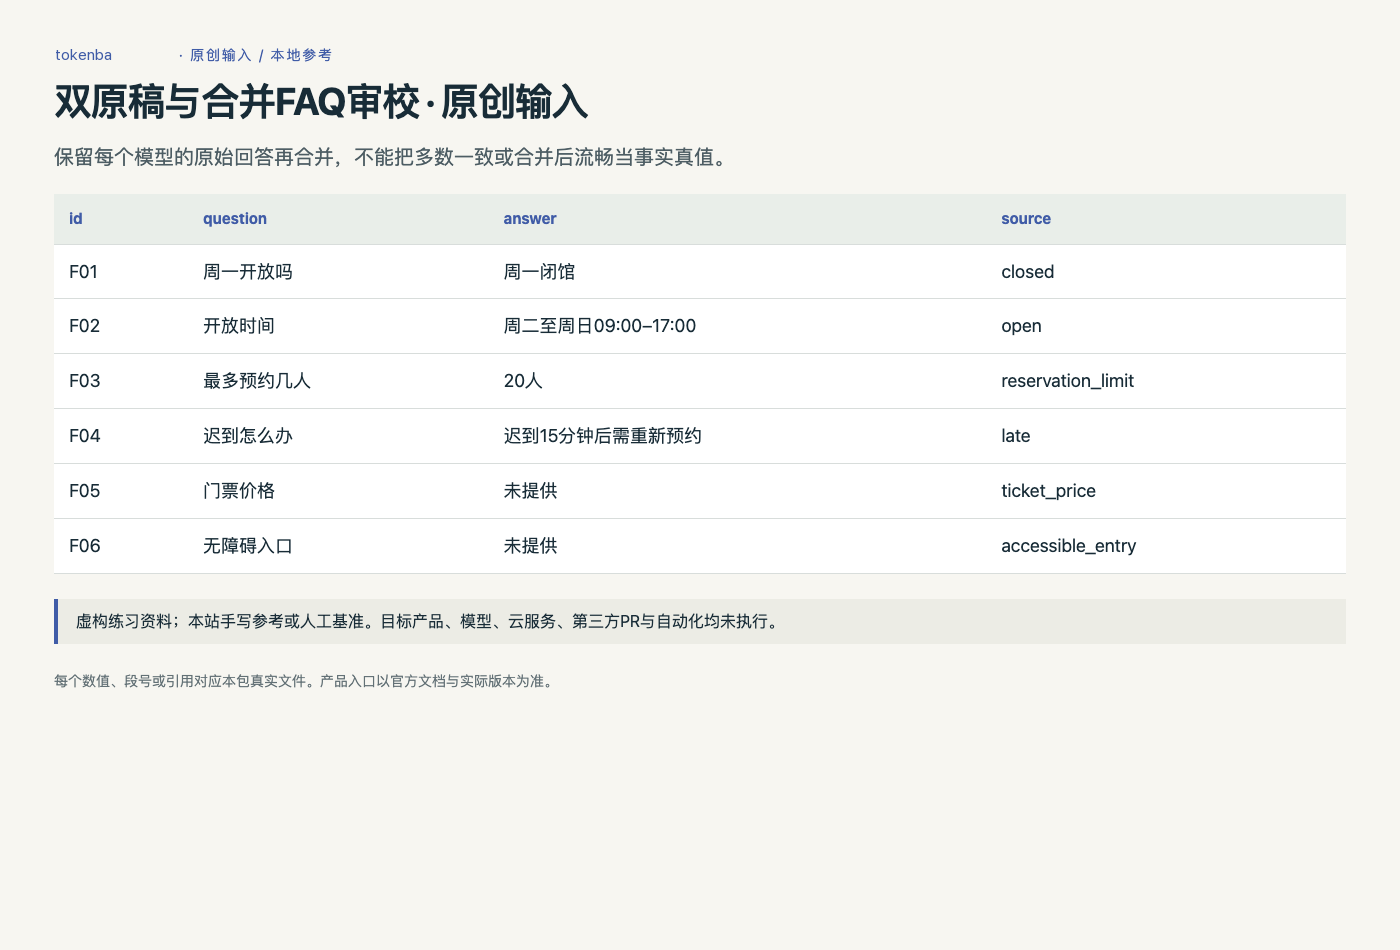
brief.json只有开放时间、闭馆日、20人上限和迟到规则;票价与无障碍入口未提供。facts-manual.json是人工金标,不能把其中人工错误样稿当模型实测。
2. 在Compare Mode选择两个模型
Open WebUI模型选择器点击Compare,选两个实际可访问的model ID;先各自测试短请求。若没有Compare,检查Allow Multiple Models in Chat用户权限。
3. 同一提问生成两列原稿
提交prompt.md,两个模型收到同一brief和六个问题。等待各自完成,展开确认错误/失败状态;任一失败就记录失败,不用人工补稿假装两列都成功。
4. 先记录差异再做原生合并
把两列答复按F01–F06填comparison-template.csv,特别查票价与入口。原始答复保留;一致也不保证正确,不先把错误删掉再声称模型没有分歧。
5. 点击当前答复的Merge Responses
最后一轮且所有模型结束后,点击右侧分支形合并图标。合并使用当前查看答复对应的模型,不读取Task Model;模板内置,没有正文可虚构的管理员自定义合并字段。
6. 逐条审校合并FAQ
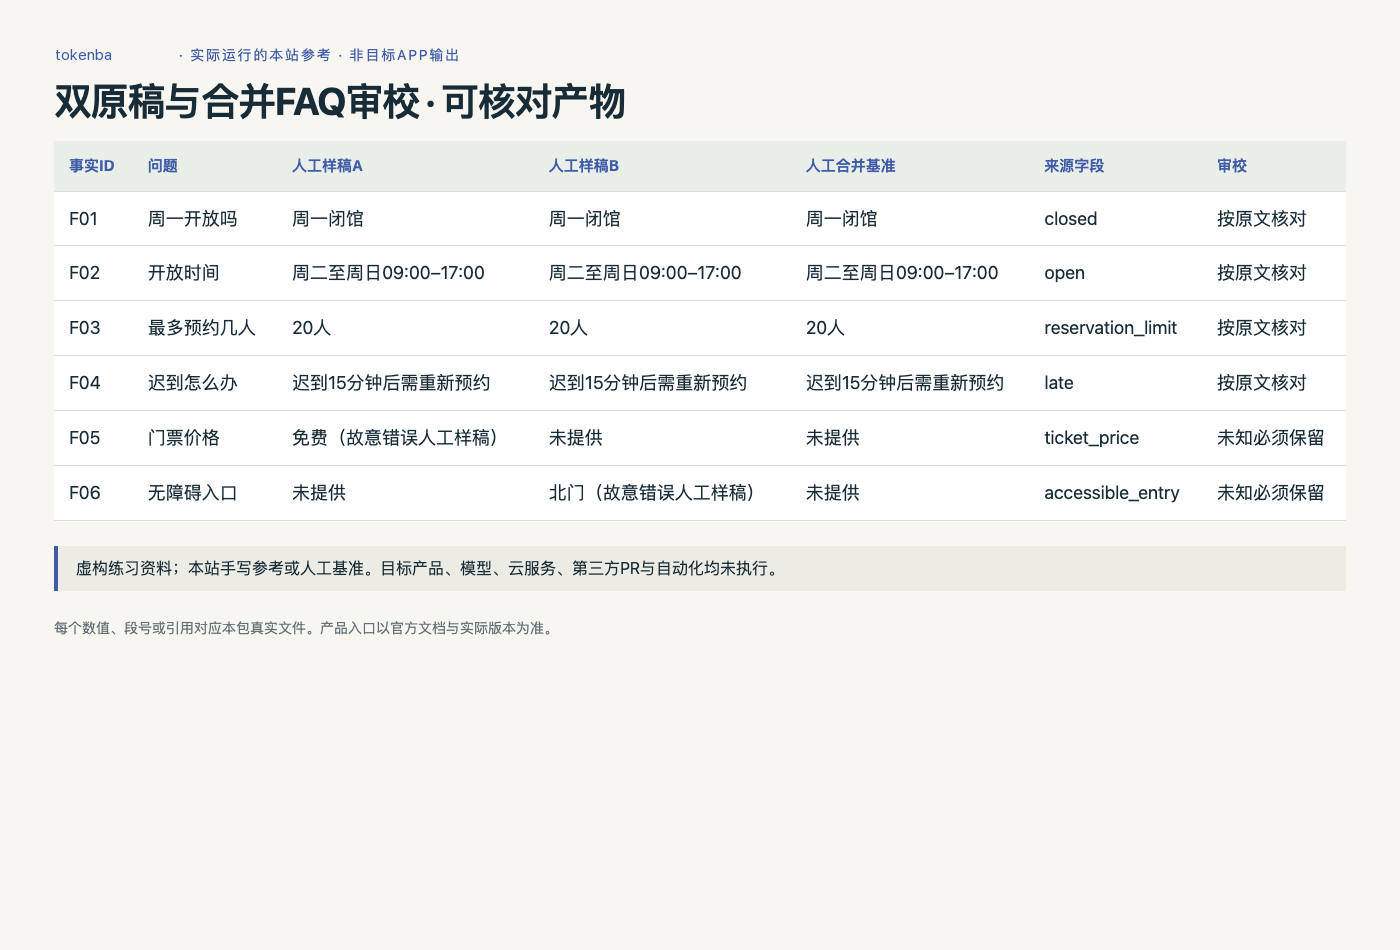
用人工事实清单核对合并稿。reference.html渲染的是人工构造的错误样稿/合并基准与事实差异表,并非Open WebUI UI、真实模型答复或原生Merged Response。实际稿若把未知补成免费必须纠正并留证。
7. 重开聊天并归档原稿与费用
回到聊天确认两份原稿和合并稿仍在,保存实际模型ID、三类主要请求及重试费用。导出审校版和差异表;一次固定brief不用于发布模型排行榜。
怎样确认已经完成
- 按本题原始输入核对ID、未知值和边界,实际平台结果另存原生文件。
- 保留本地参考与目标平台的来源差异,失败项不覆盖成成功。
- 核对实际工具/模型版本和完整调用费用,再用于自己的业务。
常见问题
两个AI同时回答再合成一份能用吗?
保留每个模型的原始回答再合并,不能把多数一致或合并后流畅当事实真值。 按上面七步在自己的工具执行;本页下载包提供可核对的输入和参考。
AI合并答案会不会把不知道的事编出来?
用人工事实清单核对合并稿。reference.html渲染的是人工构造的错误样稿/合并基准与事实差异表,并非Open WebUI UI、真实模型答复或原生Merged Response。实际稿若把未知补成免费必须纠正并留证。
Open WebUI 多模型对话 的练习包能直接导入吗?
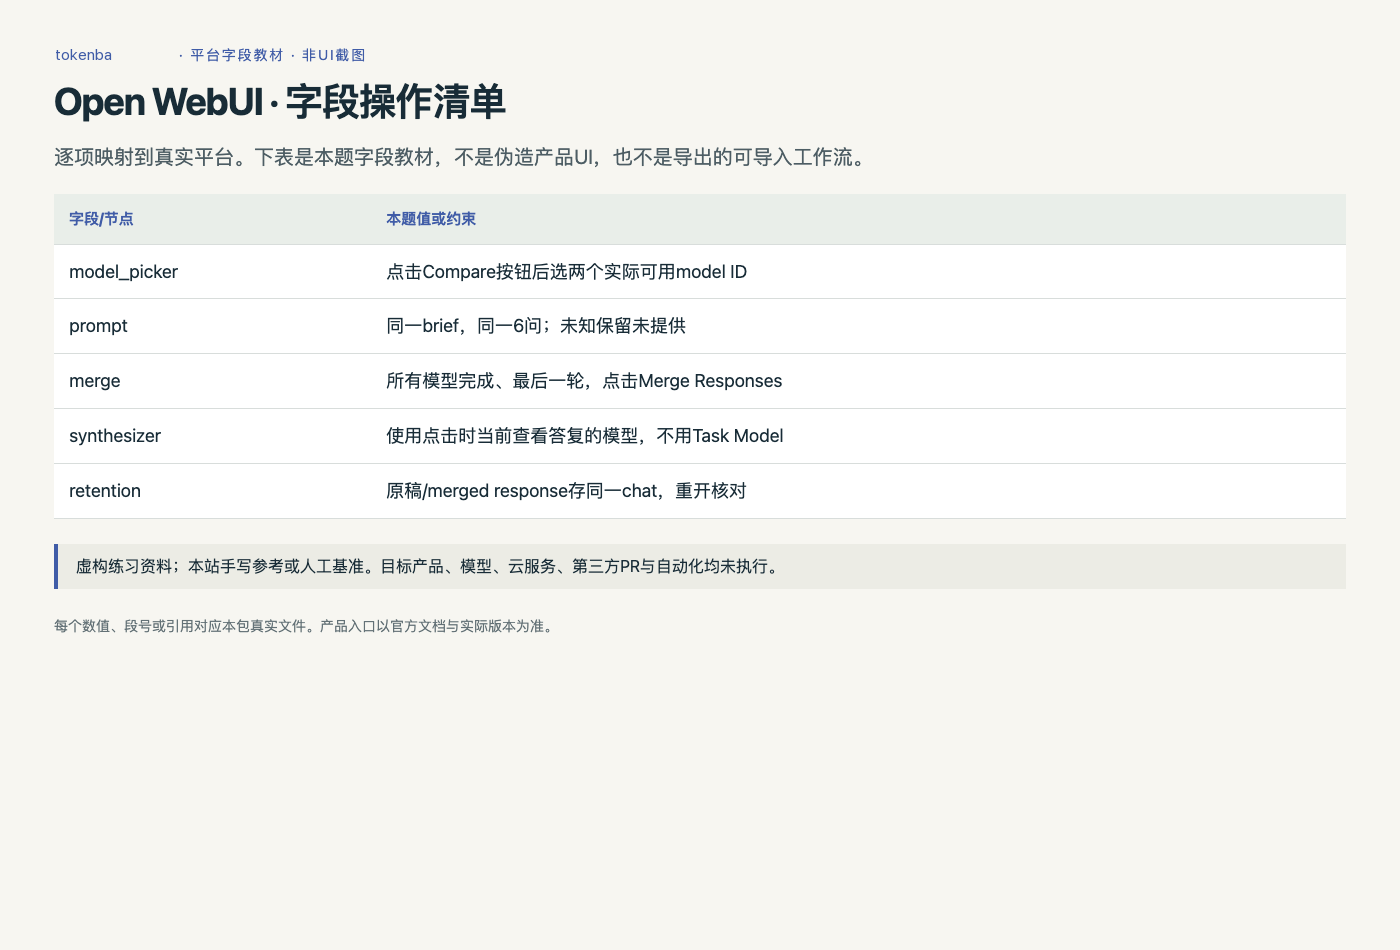
node-fields.json是逐字段操作教材,不能冒充平台原生工作流导出。按实际版本在工具里配置并保存自己的原生文件;Recipe YAML和单文件HTML等明确命名的材料见README。