
展开本页目录
开始前准备什么
- 下载到独立练习目录,先运行材料校验,再连接自己的翻译服务。
- 准备 Python 与对应工具的隔离环境;PDF 检查使用 Poppler,翻译版本分别记录。
- 原文均为原创练习材料;密钥只填在本机,不写入下载文件或截图。
- 确认原文确为六页
- 固定 Next CLI
- 给两个任务写独立目录
- 执行所需页面
- 需要时限制每个分段大小
- 复现台账缺页负例
- 合并前核对每一页
原创 PDF/CSV/EPUB/HTML、逐步说明、校验脚本与真实离线记录;不含模型译文。
对应本页操作、工具边界与验收范围。
本页截图使用的原始文档。
读取真实材料与文件结构;不请求模型、不读取凭证。
当前材料与脚本的实际运行结果。
本页专用练习材料;运行范围见 README。
本页专用练习材料;运行范围见 README。
本页专用练习材料;运行范围见 README。
1. 确认原文确为六页
打开 source.pdf 的缩略图页列表,核对 QR-PAGE-01 至 QR-PAGE-06。运行脚本会读取实际页数并检查台账;不是用文件名猜页数。
bash
pdfinfo source.pdf
python3 verify.py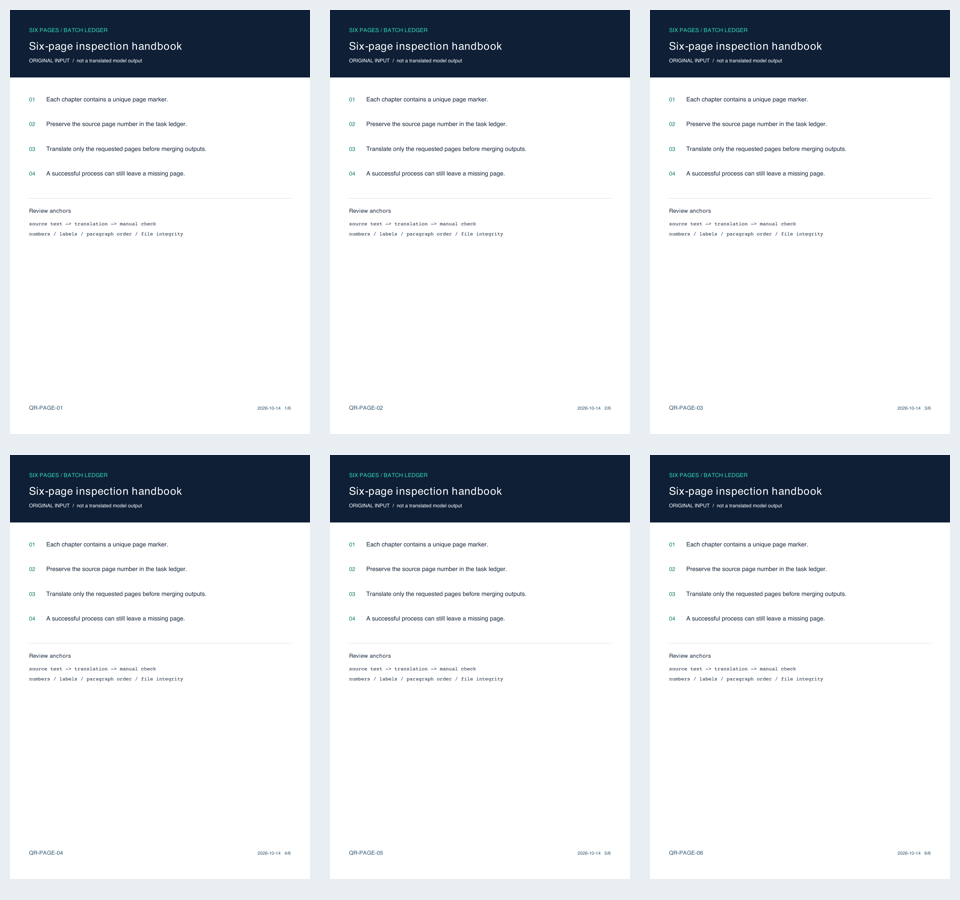
2. 固定 Next CLI
本页使用 PDFMathTranslate-next 的 pdf2zh_next,而非主仓库 pdf2zh。查实际版本和 --pages 参数;需要翻译服务时按 Next 的服务文档配置。
bash
pdf2zh_next --version
pdf2zh_next --help
3. 给两个任务写独立目录
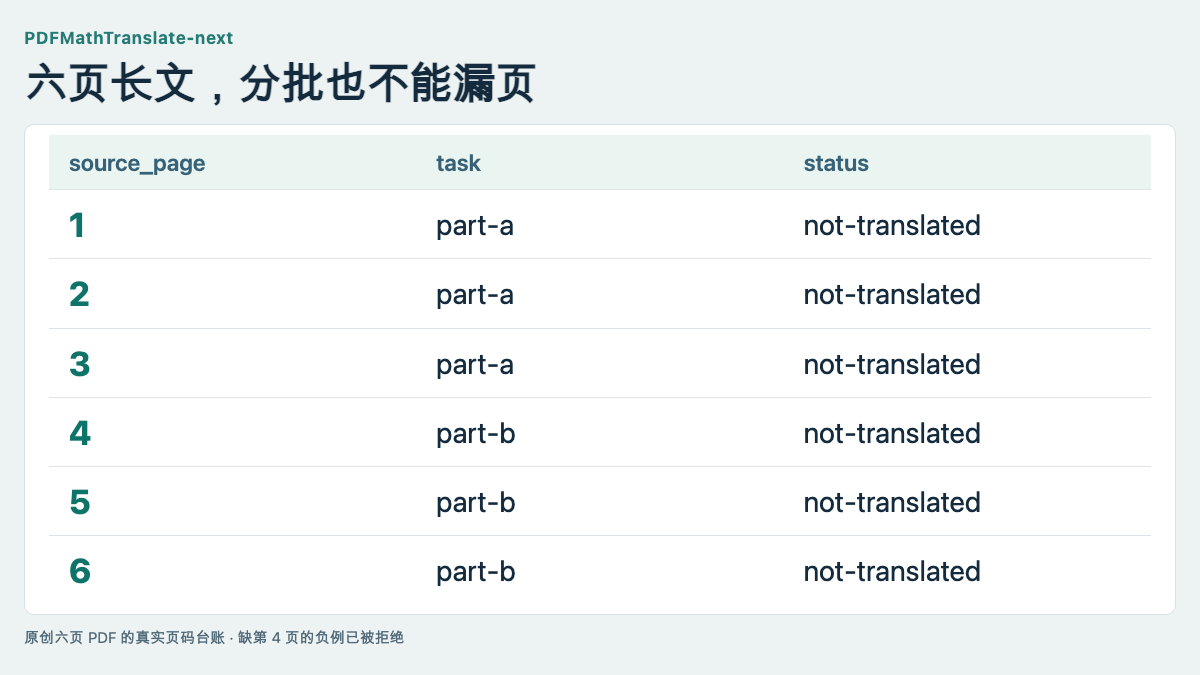
任务 A 翻译原文 1–3 页,任务 B 翻译 4–6 页。不要把任务 B 的本地第 1 页记成原始第 1 页;ledger.csv 已给出原页号和目录。
bash
mkdir -p output/part-a output/part-b4. 执行所需页面
按 Next 官方语法用 --pages 与 --output。下面两次会实际调用翻译后端,教材未执行;先确认自己的额度与版本。
bash
pdf2zh_next source.pdf --pages 1-3 --output output/part-a
pdf2zh_next source.pdf --pages 4-6 --output output/part-b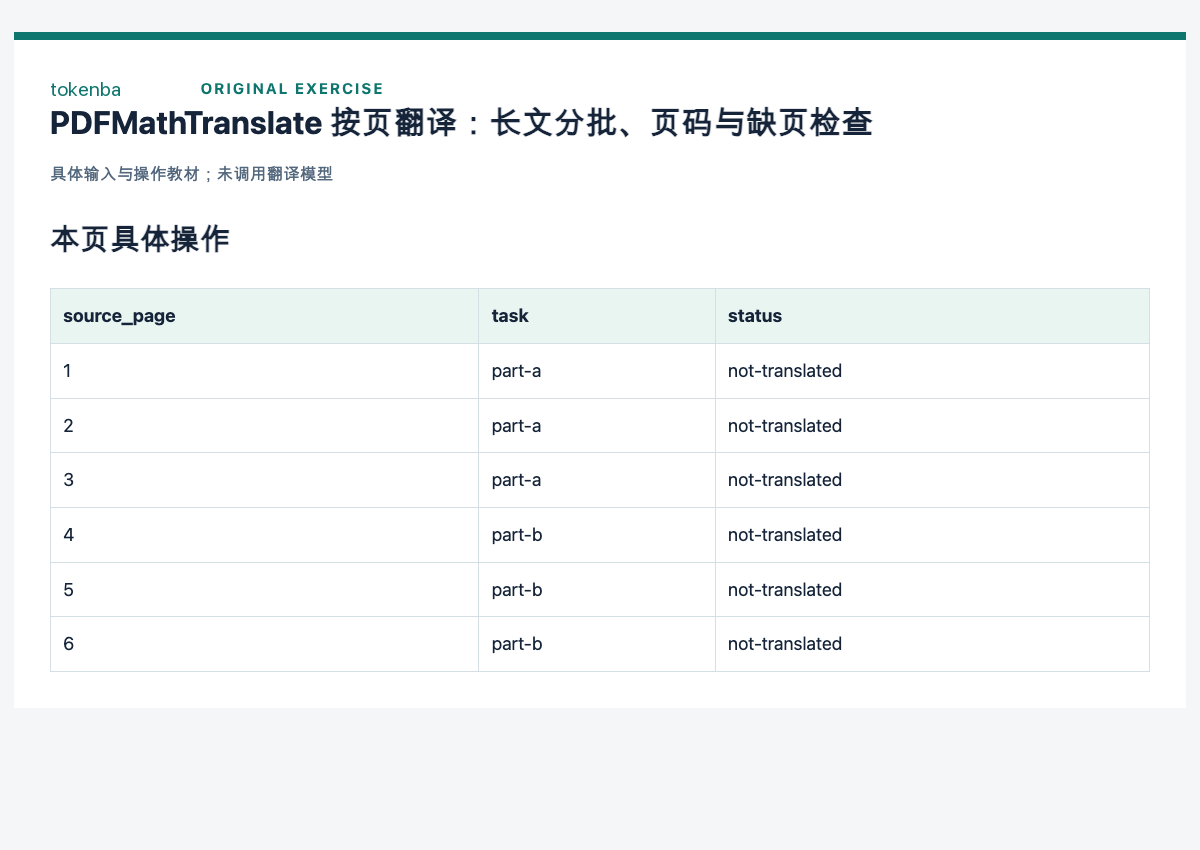
5. 需要时限制每个分段大小
Next 的 --max-pages-per-part 限制分段页数,不能代替源页范围台账。双语模式的输出页数可能比源页数多,验收要映射原始页号。
bash
pdf2zh_next source.pdf --pages 1-6 --max-pages-per-part 3 --output output/split6. 复现台账缺页负例
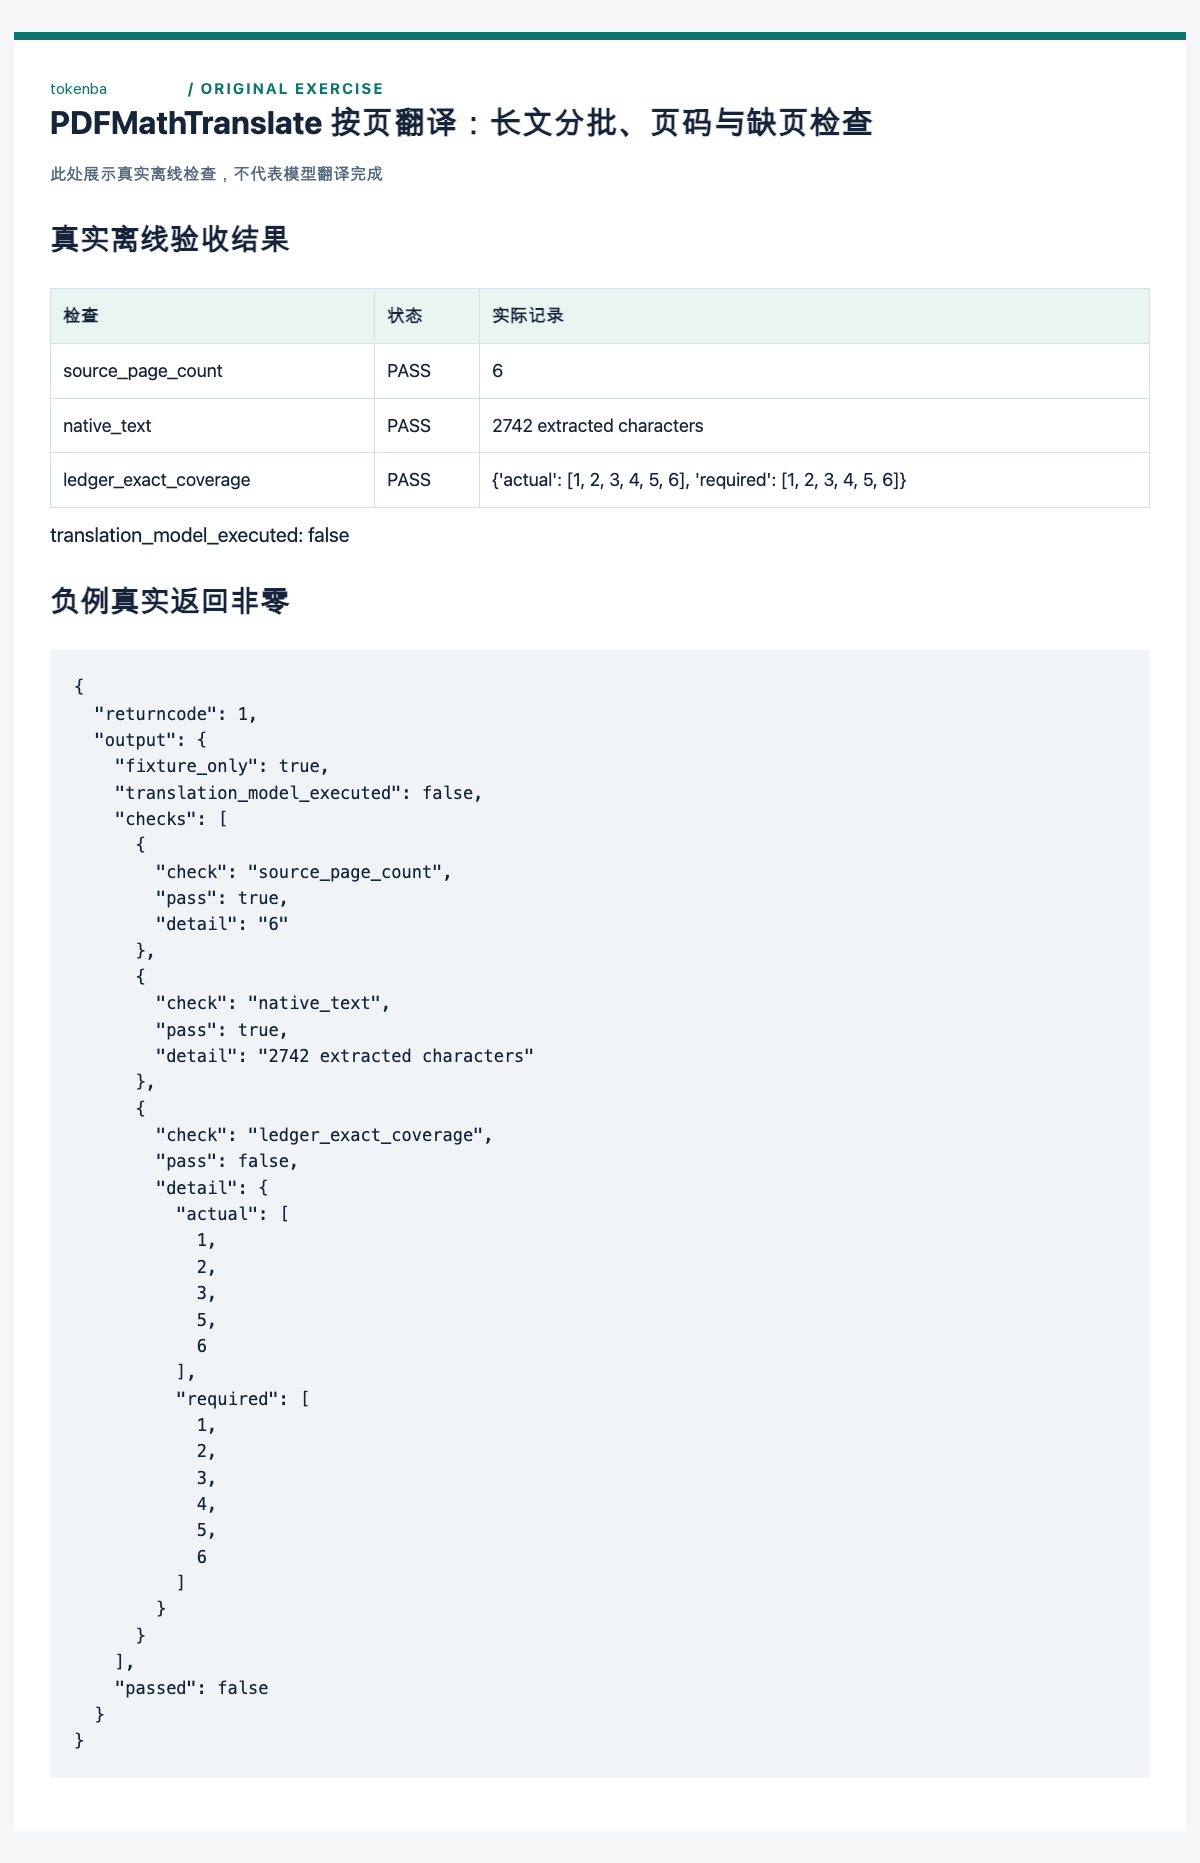
完整 ledger.csv 包含六页;ledger-missing.csv 故意漏掉第 4 页。脚本应拒绝后者并返回非零,本包实际记录了这次失败。它证明台账检查能报错,不代表模型已翻译。
bash
python3 verify.py --ledger ledger-missing.csv7. 合并前核对每一页
每份实际产物登记原始页范围、文件哈希与复核人。确认无重复、无缺页,再选择自己的 PDF 合并工具;保留原文和独立产物,不用简单“页数相等”替代内容检查。
怎样确认已经完成
- 源文档真实六页,台账原页号为 1–6 且各出现一次。
- 缺第 4 页的负例返回非零,完整台账通过。
- 模型输出按原页码核对;双语布局不能仅按输出页数判定。
常见问题
分段 3 页等于只翻前三页吗?
不等于。--pages 选择源页范围,--max-pages-per-part 控制每段大小,两者承担不同任务。
为什么输出 12 页不是重复了?
某些双语布局包含原文与译文两组页。需要检查源页映射与布局,而非直接把页数翻倍当错误。