
展开本页目录
开始前准备什么
- 解压lesson.zip到独立目录,先阅读README与运行范围。
- 使用与页面一致的工具版本;模型或账户能力以自己实际权限为准。
- 保留原始输入;教材中的人工参考与模型实际结果分开保存。
- 检查每组样本
- 启动锁定PyGWalker
- 建立两个分面
- 核对过滤条件
- 检查均值与样本数
- 保存实际图表
- 复现分面配置
含README、原创输入、提示词、校验脚本与明确标注的参考材料。
device-usage.csv,原创练习数据或任务书。
具体步骤、命令与未执行范围。
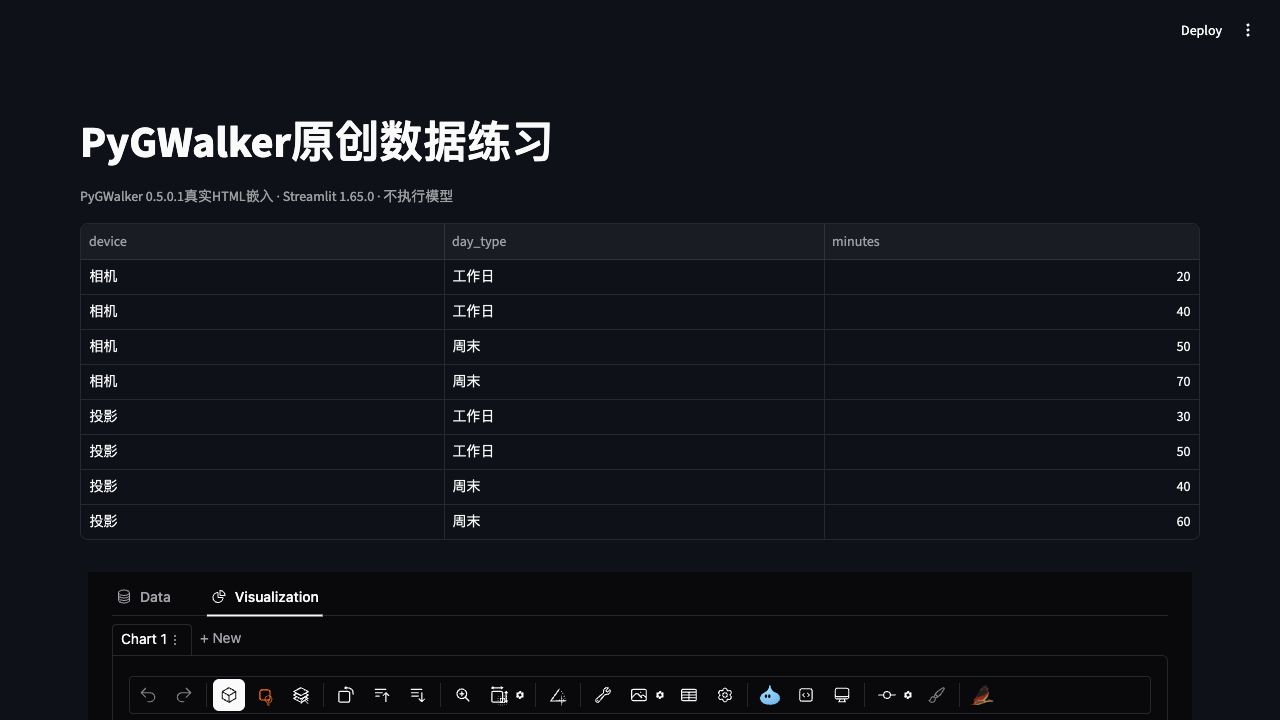
PyGWalker0.5.0.1公开to_html生成;只展示本页原创数据,不是模型输出。
1. 检查每组样本
读取device-usage.csv,设备类别2种、日类型2种,每组2条。minutes是单次使用时长;样本很小,只作教学比较。
bash
python3 analyze.py
python3 verify.py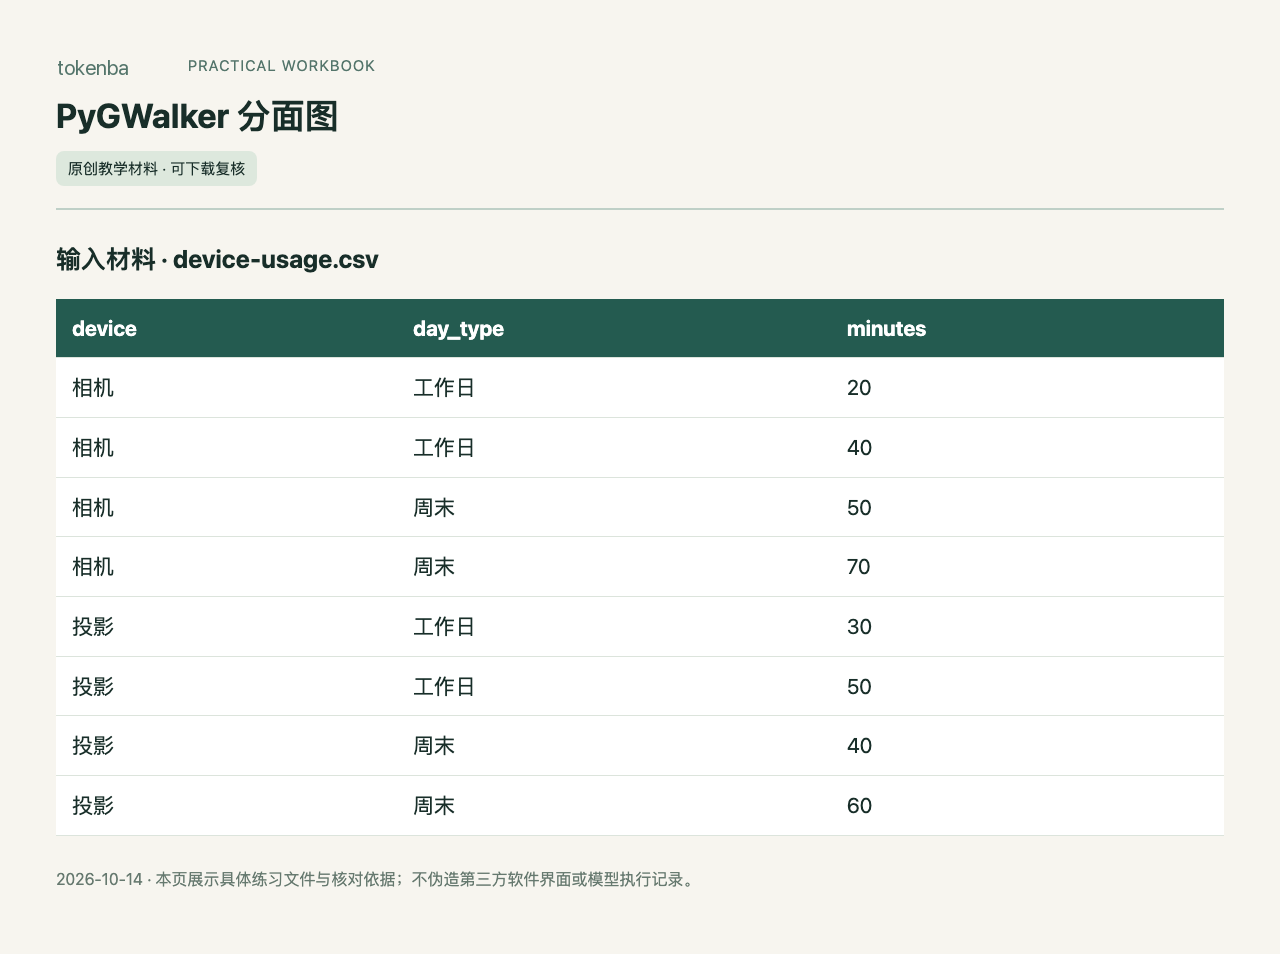
2. 启动锁定PyGWalker
安装requirements.txt并运行app.py。页面载入原创数据,不连接云端账户,不把PyGWalker默认界面等同于调用AI。
bash
python3 -m pip install -r requirements.txt
streamlit run app.py
3. 建立两个分面
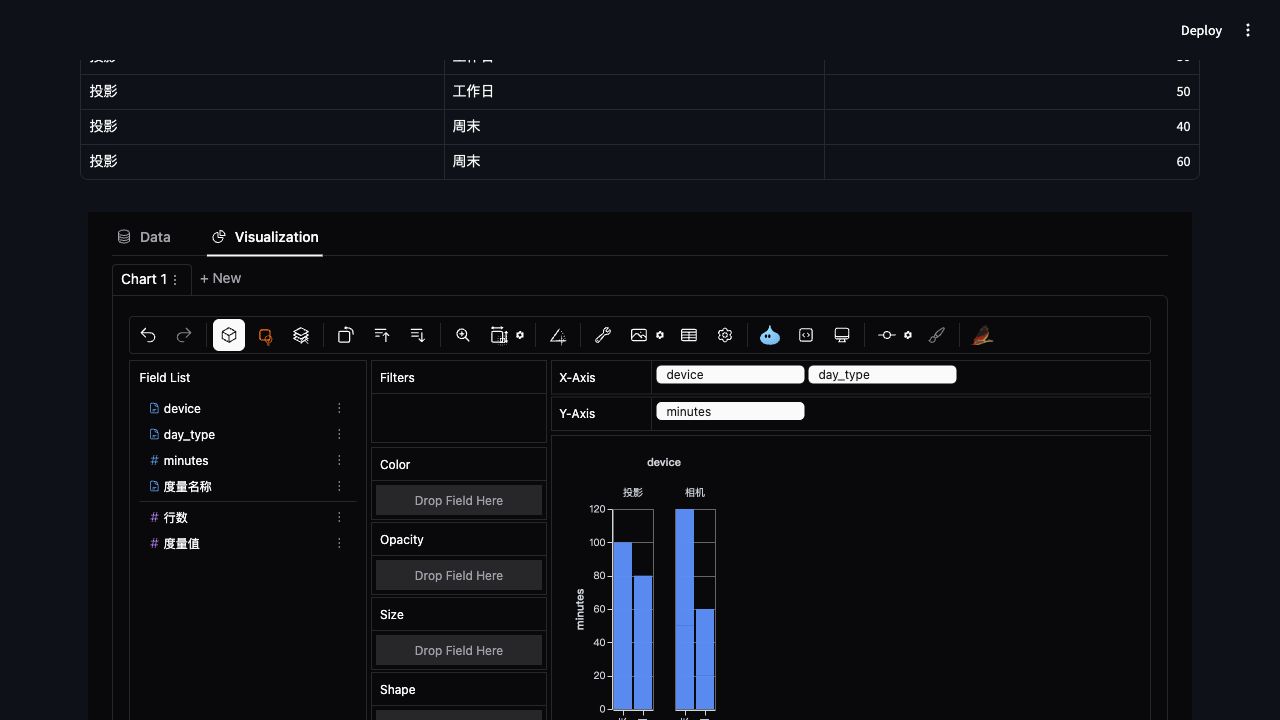
先检查字段角色:本次真实页面把minutes推断成维度,需要在字段菜单Move to measures移到度量。把device、day_type放到X/分面,minutes放Y后默认SUM会显示60/120/80/100;再明确改为Mean,最终应30/60/40/50。每个面板保持同一尺度。
4. 核对过滤条件
先展示两种日类型,再只选周末,确认剩下4行。恢复全部后每组n仍为2;保存过滤状态,避免只剩某个设备却没标明。
5. 检查均值与样本数
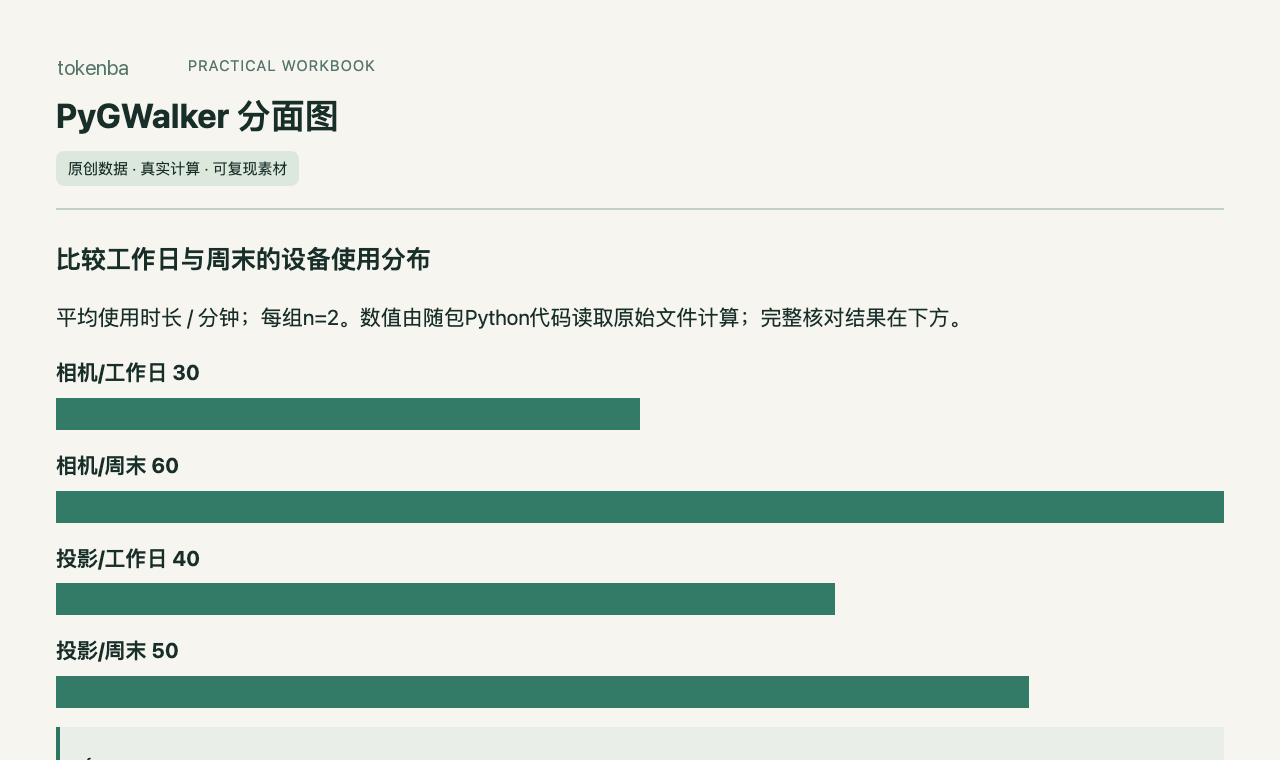
相机工作日30、周末60;投影工作日40、周末50。用表格额外保留样本数,不能因为周末均值高就推断所有周末都更高。
6. 保存实际图表
在UI保存图表或导出图像,打开检查标题和分钟单位。素材独立参考图来自实际CSV计算,真实PyGWalker页面截图另行标明。
bash
python3 analyze.py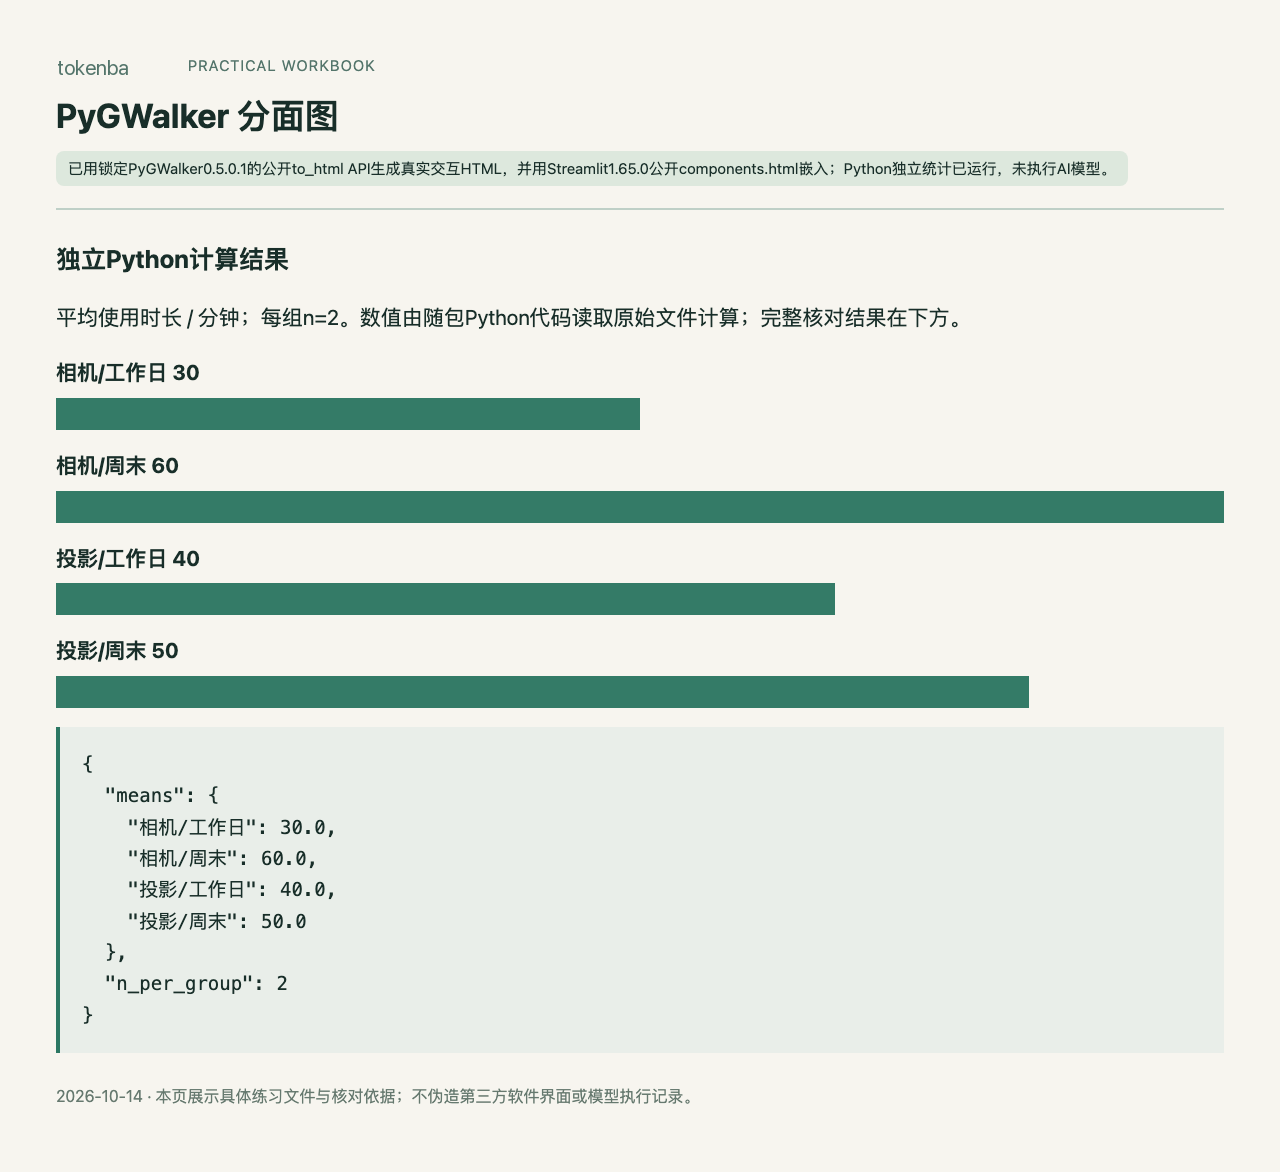
7. 复现分面配置
重新载入CSV并按同样拖拽操作核对。不同版本保存的spec可能有schema差异,更新前保留旧配置和运行版本。
怎样确认已经完成
- 自己的实际产物能打开,数字、标签、单位与原始输入一致。
- 执行随包verify.py检查真实文件;参考材料不能冒充自己的模型运行。
- 已用锁定PyGWalker0.5.0.1的公开to_html API生成真实交互HTML,并用Streamlit1.65.0公开components.html嵌入;Python独立统计已运行,未执行AI模型。
常见问题
下载素材后能直接看到AI生成结果吗?
已用锁定PyGWalker0.5.0.1的公开to_html API生成真实交互HTML,并用Streamlit1.65.0公开components.html嵌入;Python独立统计已运行,未执行AI模型。
PyGWalker 分面图要怎样判断完成?
按本页步骤执行自己的工具环境,核对原始输入、实际产物与检查清单;下载成功、程序启动或参考文件存在都不能代替实际结果验收。