
展开本页目录
开始前准备什么
- 下载并解压独立练习包,先读 README 的实际执行范围。
- 使用原创或获授权输入,保留原文件、软件版本与失败记录。
- 模型和在线渠道需要单独准备;不包含权重、真实密钥或付费额度。
- 分别打开角色和商品输入
- 选用支持多图的 Plus 管线
- 分清两张图各自职责
- 先做单张候选并记录参数
- 检查拿杯的手与接触
- 核对角色与商品关键点
- 保存授权、失败与真正结果
原创输入、操作脚本、来源与验收说明;未运行范围逐项标明。
1. 分别打开角色和商品输入
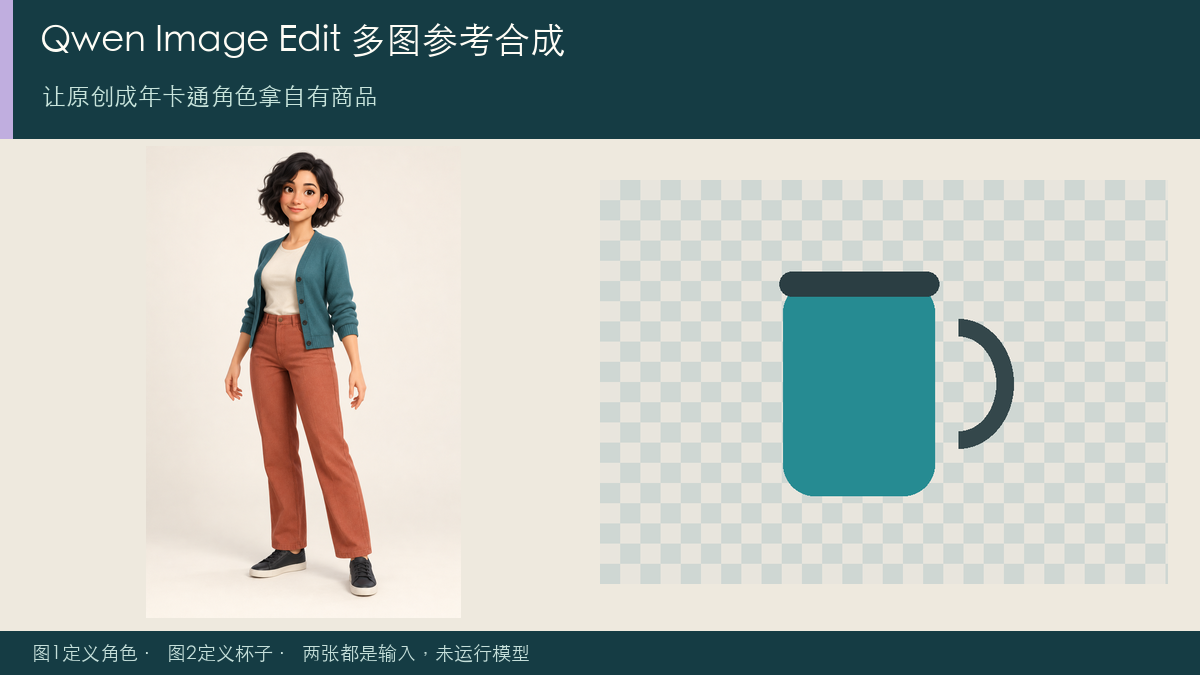
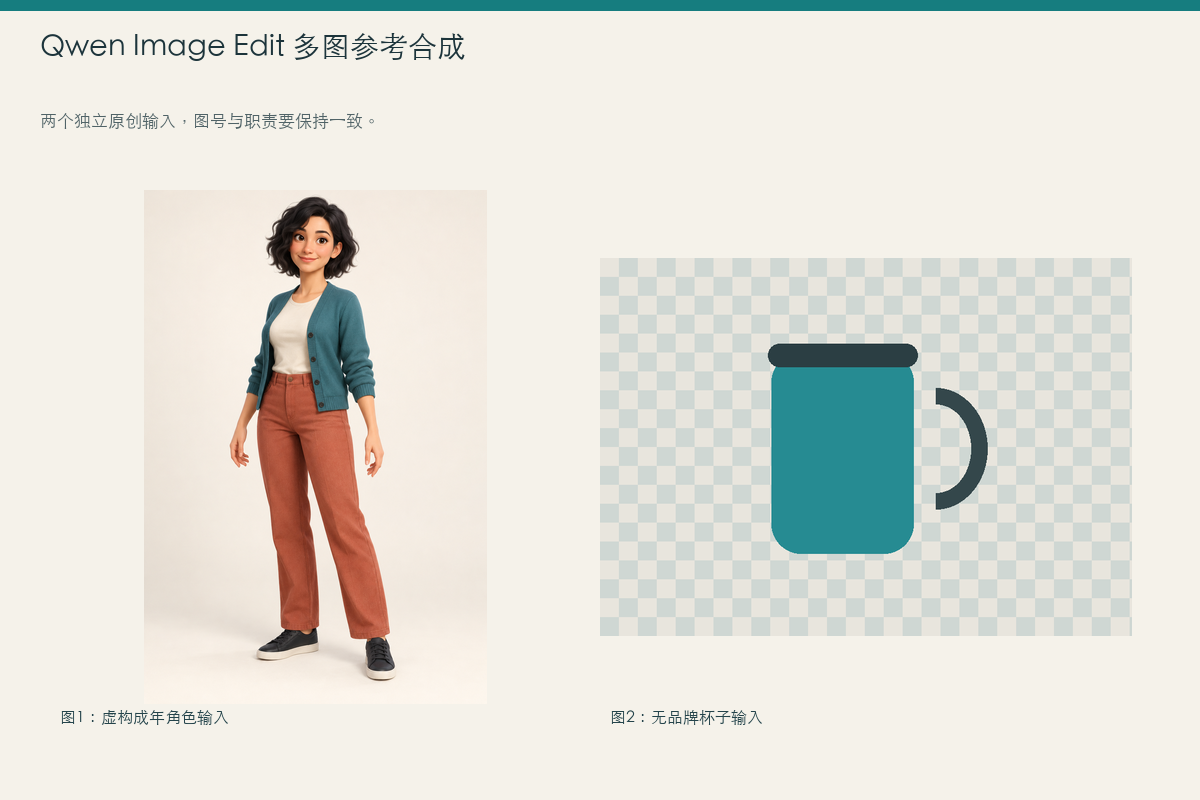
character.png 是 AI 生成的原创虚构成年角色,product.png 是本站程序绘制的无品牌杯子;两者都是输入。先确认原角色空手、杯子有一个手柄,避免无法判断后续改变。
2. 选用支持多图的 Plus 管线
使用 QwenImageEditPlusPipeline 和 Edit-2511;旧单图 QwenImageEditPipeline 不能通过把两张图拼成一张就自动变成官方多图接口。核实实际服务支持的图片数量。
3. 分清两张图各自职责
图1定义角色服装和身份,图2定义杯子形状与颜色;指令只要求角色单手拿杯。原文件按顺序存入 inputs.json,不能对调后仍套用相同图号说明。
4. 先做单张候选并记录参数
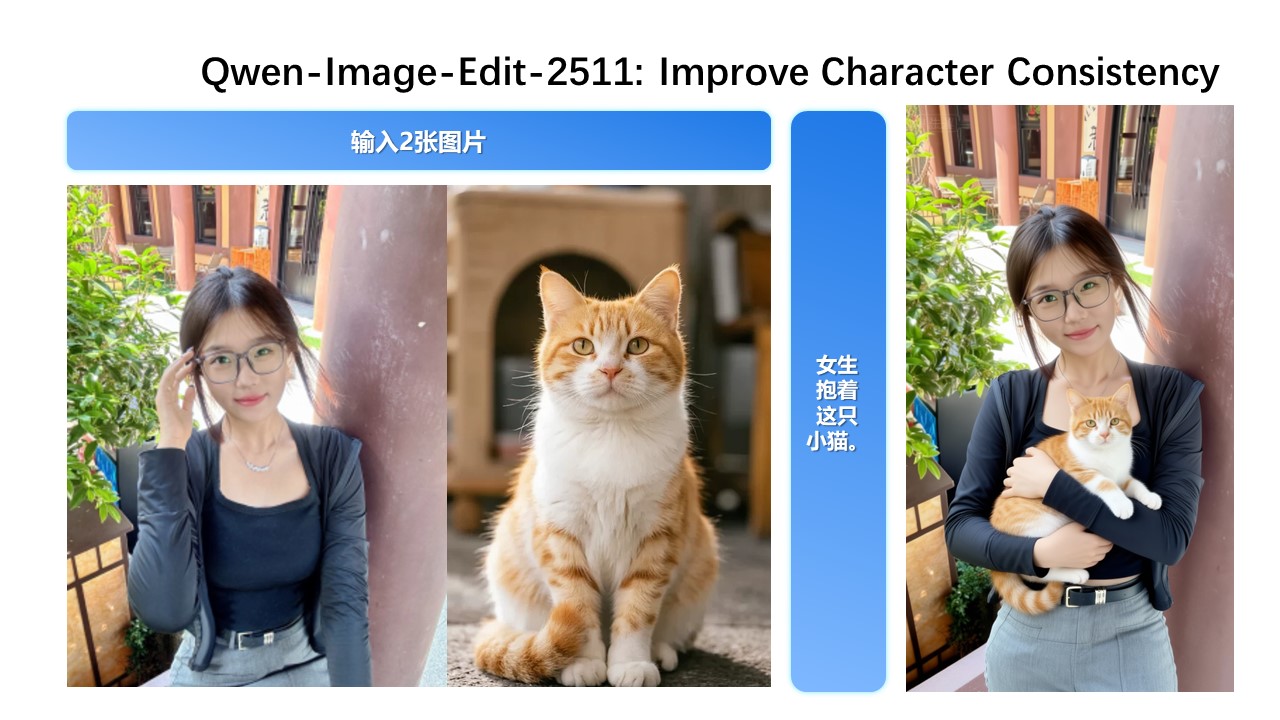
固定输入、seed 与提示词,保存真实返回和模型 ID。官方多图示例不是本站角色/杯子的结果;一致性是需要检查的目标,不是 API 自动保证。
model-example.py
from diffusers import QwenImageEditPlusPipeline
from PIL import Image
import torch
pipe = QwenImageEditPlusPipeline.from_pretrained("Qwen/Qwen-Image-Edit-2511", torch_dtype=torch.bfloat16).to("cuda")
images = [Image.open("character.png").convert("RGB"), Image.open("product.png").convert("RGB")]
result = pipe(image=images, prompt="图1的原创角色单手拿图2的杯子,保留角色服装和杯柄形状。", true_cfg_scale=4.0, num_inference_steps=40, guidance_scale=1.0).images[0]
result.save("actual-model-output.png")
5. 先看手与杯柄的真实接触
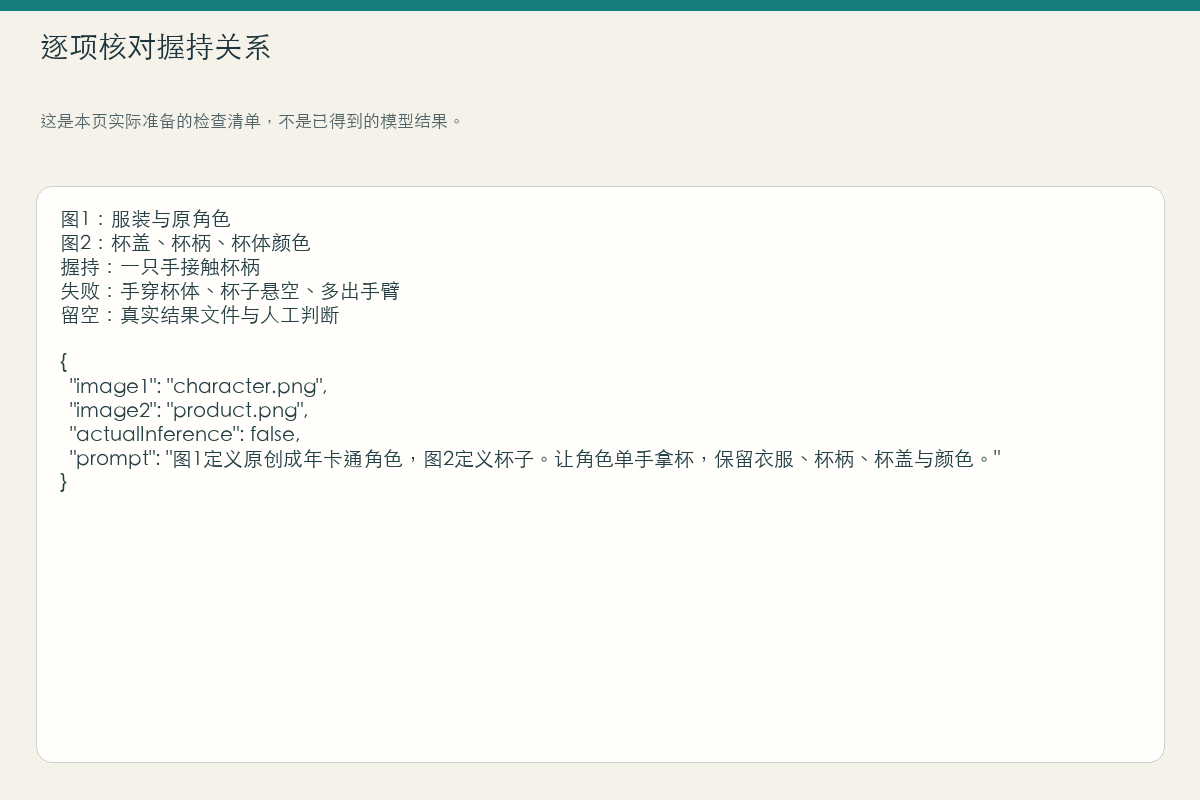
实际生成后先检查手指数、杯柄数量与握持位置,再看是否悬空、穿模或多出手臂。接触通过后再对照角色衣服、商品形状与颜色。
保留 inputs.json 中图 1/图 2 顺序和模型 ID,避免把参考错配归因于模型。包内 grip-target.svg 是人工动作目标,不是视觉模型检测结果。
6. 核对角色与商品关键点
检查围巾/上衣、杯盖/杯柄/颜色、左右位置,记录每项保留或改变。想要像素级商品保真时需要确定性合成,不能靠提示词保证商用品类细节不变。
7. 保存授权、失败与真正结果
实际输出要与两张输入分别归档。本页没有推理、不含真实代言人,也没有承诺任何真人授权;只提供原创虚构角色与无品牌产品练习。
怎样确认已经完成
- 7 个步骤使用同一明确输入,真实结果与人工/官方参考分别标识。
- 实际输出重新打开,核对文字、时间码、尺寸、图层或剪点;结构通过不代替内容验收。
- 保留原始输入、版本、参数、输出和失败样本,正式任务先做小样。
常见问题
Qwen Image Edit 多图合成怎么操作?
使用支持多图的实际管线,把角色图与商品图分别声明职责,先生成一张拿杯候选。检查手与杯子的接触、角色特征和商品比例;多图理解不等于多图生成支持,包内参考不是合成实测。
Qwen Image Edit 多图参考合成需要哪些输入,本站实际运行了什么?
已完成原创输入、可下载材料和文件预检;未运行本页工具的模型、TTS、付费 API 或外部生成。 输入与脚本在本页 ZIP,详细来源、命令和未运行范围见 README。
AI 人物拿产品怎么做,练习包能直接得到工具生成结果吗?
请按7步区分输入、官方示例、人工参考和真实输出。未运行模型的页面没有代造结果;免费代码也可能需要下载权重、硬件或外部服务额度。