
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 选择与目标底座兼容的草稿模型
- 固定硬件与采样控制变量
- 读懂作者算术反例
- 运行不启用草稿的基线
- 启用EAGLE3记录接受与总时延
- 定位变慢输入
- 交付配对结果与原始指标
1. 选择与目标底座兼容的草稿模型
替换USER_SUPPLIED路径,按官方支持表确认EAGLE3组合和启动选项。包内无模型文件,也不下载大权重。
2. 固定硬件与采样控制变量
baseline和speculative同底座、并发、输出长度与采样;分别记录预热次数,不能一边预热一边冷启动。
本题独立目录执行
bash
python reference/audit.py3. 读懂作者算术反例
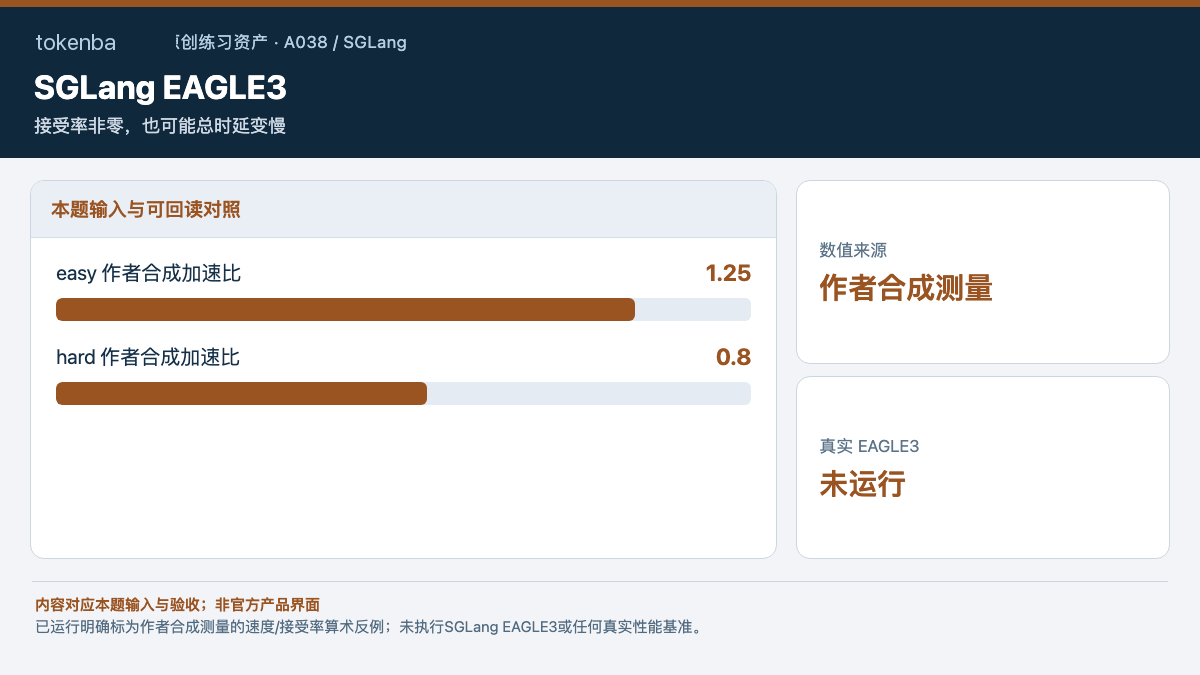
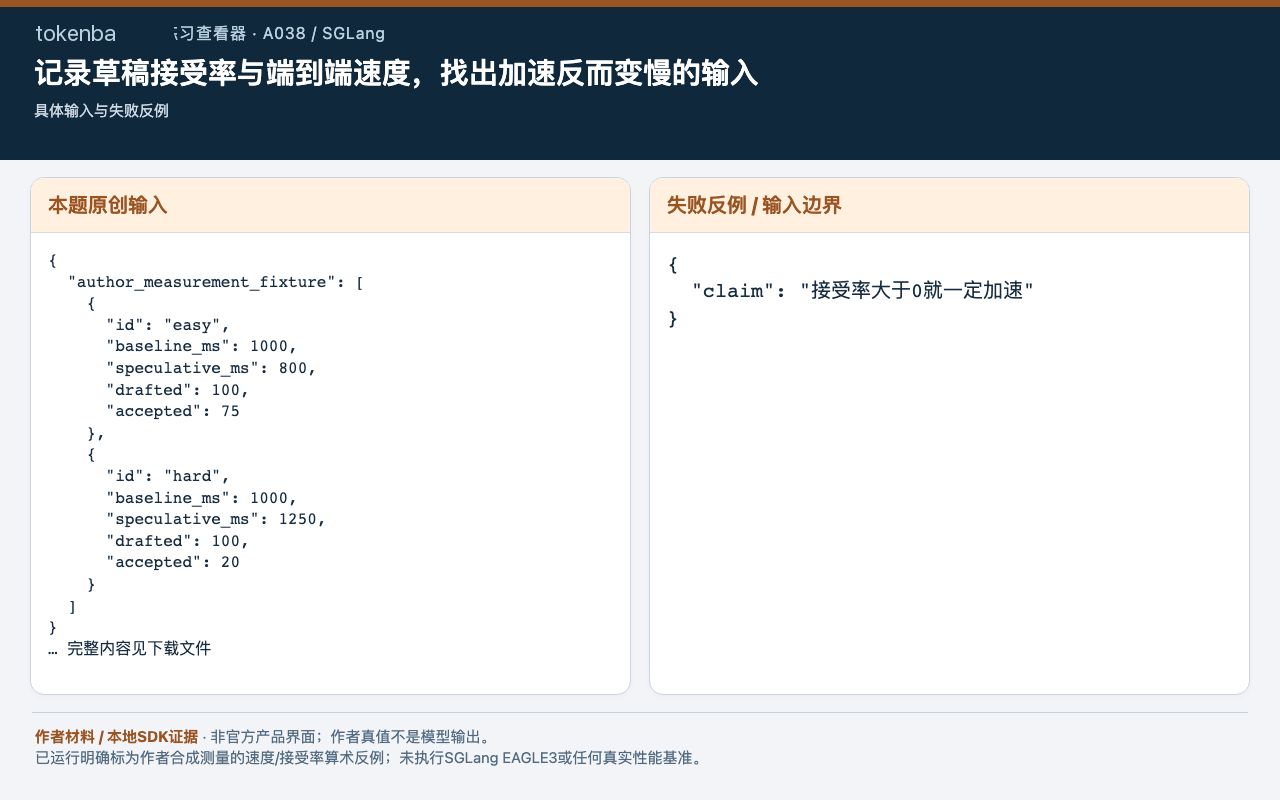
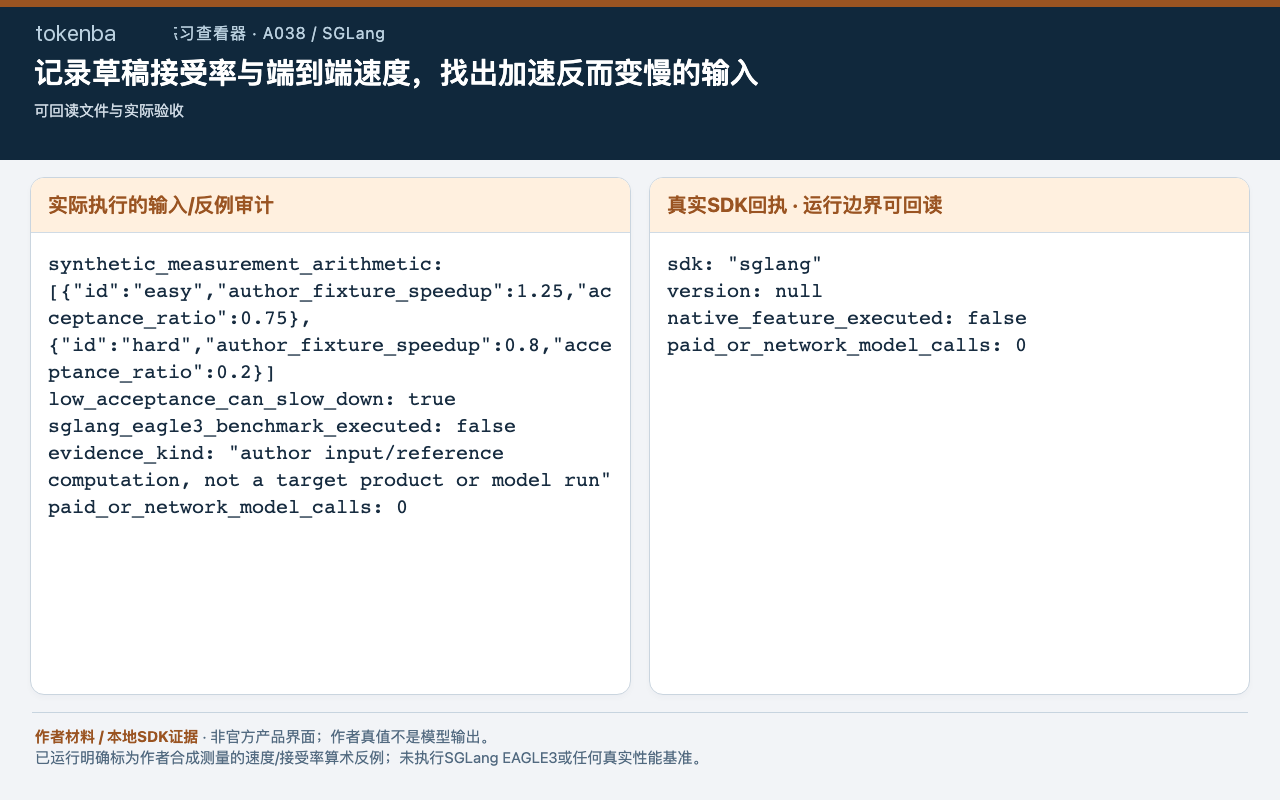
示例easy加速1.25倍、hard只有0.8倍,均是作者虚构测量输入,用来验证计算公式,不是SGLang性能报告。
本题SDK或目标环境入口
bash
python reference/run_sdk.py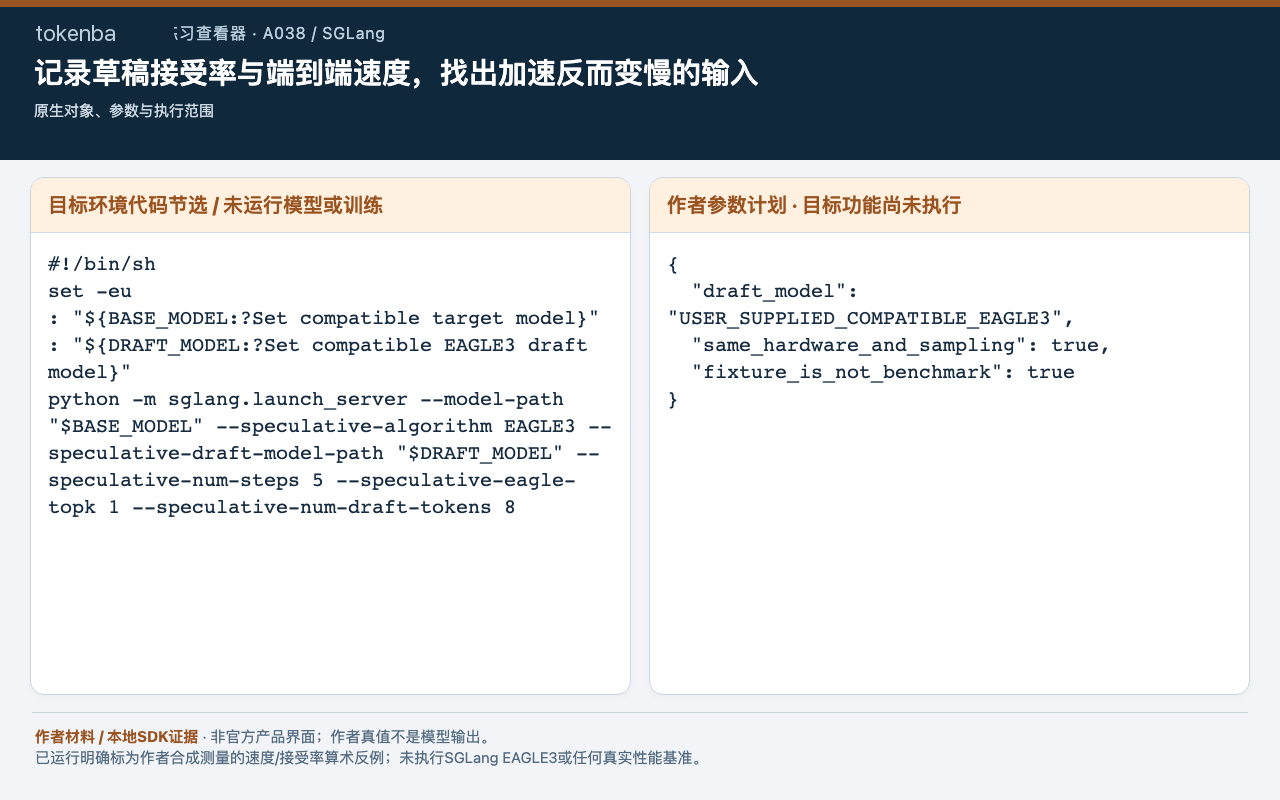
4. 运行不启用草稿的基线
保存每题耗时、生成token数与真实输出,长短答案差异应按相同终止条件核对。
5. 启用EAGLE3记录接受与总时延
保留草稿token数、接受token数以及总耗时。接受率高也可能被草稿计算、传输或批处理开销抵消。
6. 定位变慢输入
对hard类输入检查接受率、输出长度及并发,报告减速而不是删除反例。不能仅以token吞吐代替用户端总时延。
7. 交付配对结果与原始指标
按ID配对baseline/speculative并附命令与模型版本。本文只执行合成测量的算术审计,真实GPU结果仍待运行。
怎样确认已经完成
- 接受率不是最终质量
- draft权重兼容先核对
- 慢于基线也如实保留
- 已运行明确标为作者合成测量的速度/接受率算术反例;未执行SGLang EAGLE3或任何真实性能基准。
常见问题
SGLang EAGLE3为什么有时反而更慢?
草稿计算和低接受率可能超过节省的主模型开销。包内hard的0.8倍是作者合成测量算术,不是SGLang基准。
推测解码怎么同时看草稿接受率和实际吞吐?
相同硬件、并发和采样下保存drafted/accepted、输出token与总时延,同时报告变慢输入。没有真实GPU数据不能宣布加速。
这篇教程哪些步骤已经真正执行?
已运行明确标为作者合成测量的速度/接受率算术反例;未执行SGLang EAGLE3或任何真实性能基准。