
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 把任务类型加入数据
- 分别实现数学与格式函数
- 运行错误与不适用反例
- 接入GRPOTrainer多奖励入口
- 检查采样组和有效奖励
- 核对格式投机
- 交付函数、逐项奖励和边界
1. 把任务类型加入数据
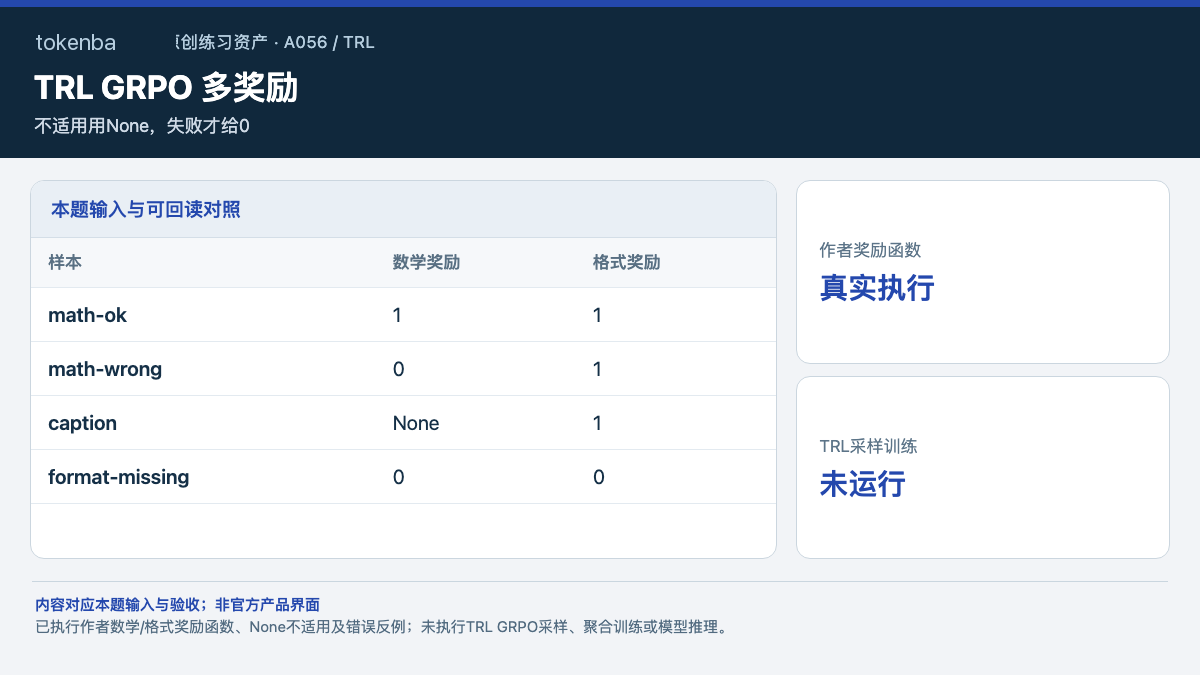
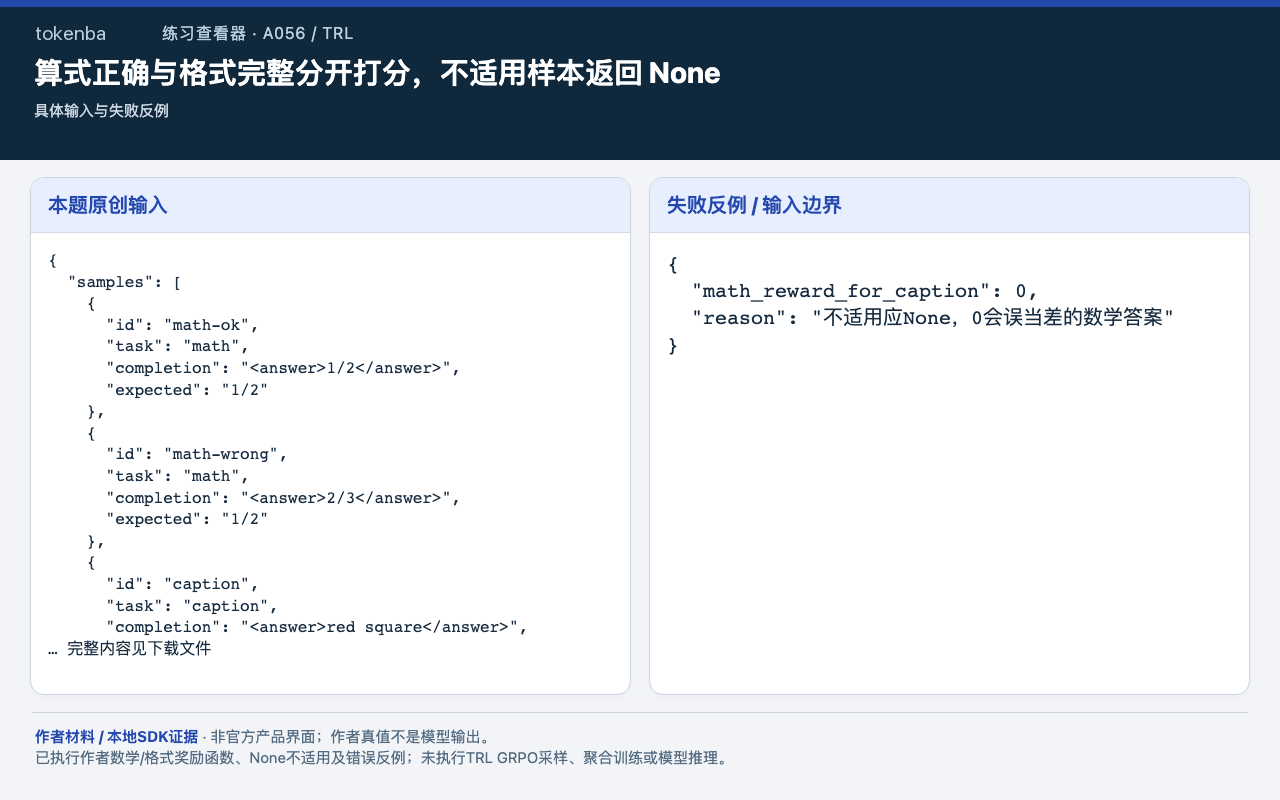
math和caption混合数据必须保留task列,不让数学奖励函数对图片描述题给0。None表示不适用,0表示适用但失败。
2. 分别实现数学与格式函数
包内数学函数只接受math,格式函数检查完整answer标签;两类得分独立。真实代码可执行,不是预填奖励表。
本题独立目录执行
bash
python reference/audit.py3. 运行错误与不适用反例
math-wrong数学0、caption数学None、format-missing格式0。不要把非数学样本的None改成0后误罚。
本题SDK或目标环境入口
bash
python reference/run_sdk.py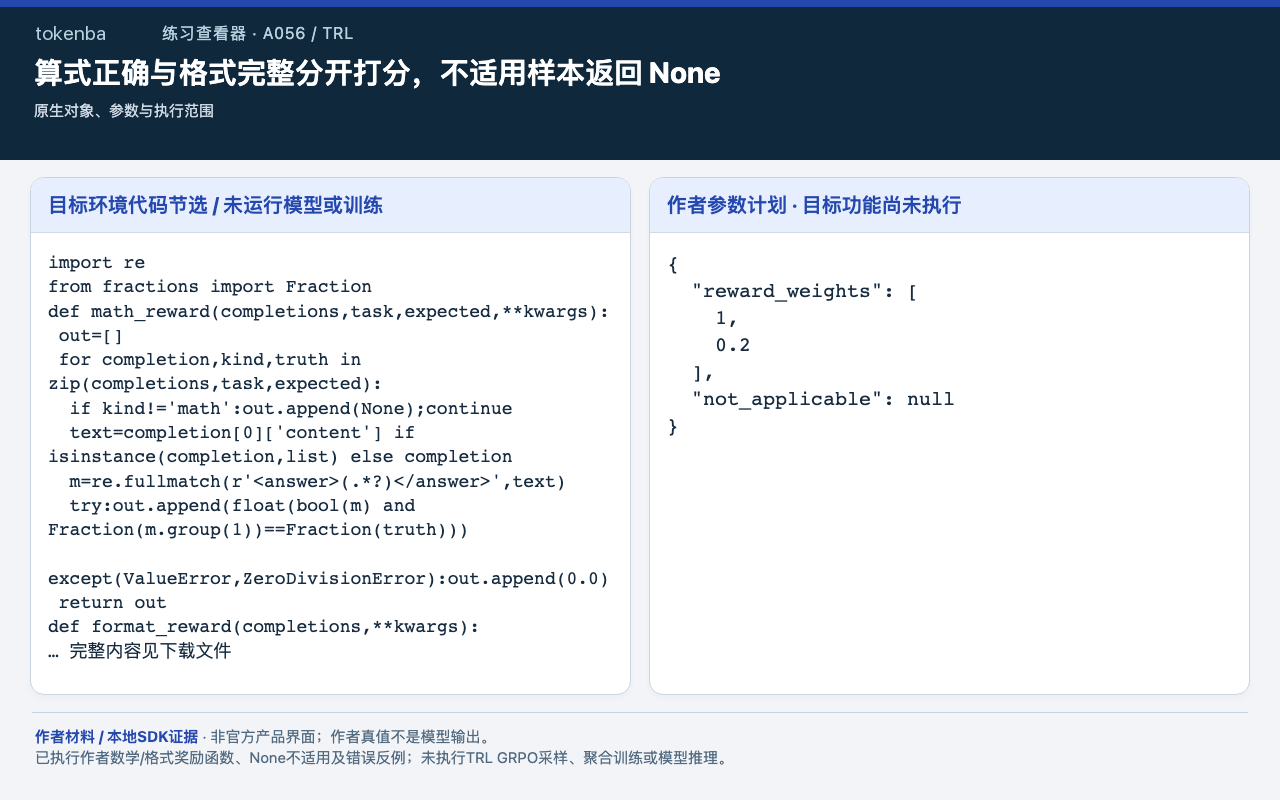
4. 接入GRPOTrainer多奖励入口
按当前TRL签名提供reward_funcs列表与reward_weights,确认数据额外列传入函数的方式。多奖励聚合的None处理须看安装版实现。
5. 检查采样组和有效奖励
保存每组completion及每个函数输出,防止一整组都无适用奖励。需要真实模型采样后才讨论优势和梯度。
6. 核对格式投机
只有标签正确而算错不能满分;答案正确但缺格式按分项显示。不能让低成本格式奖励压过核心正确性。
7. 交付函数、逐项奖励和边界
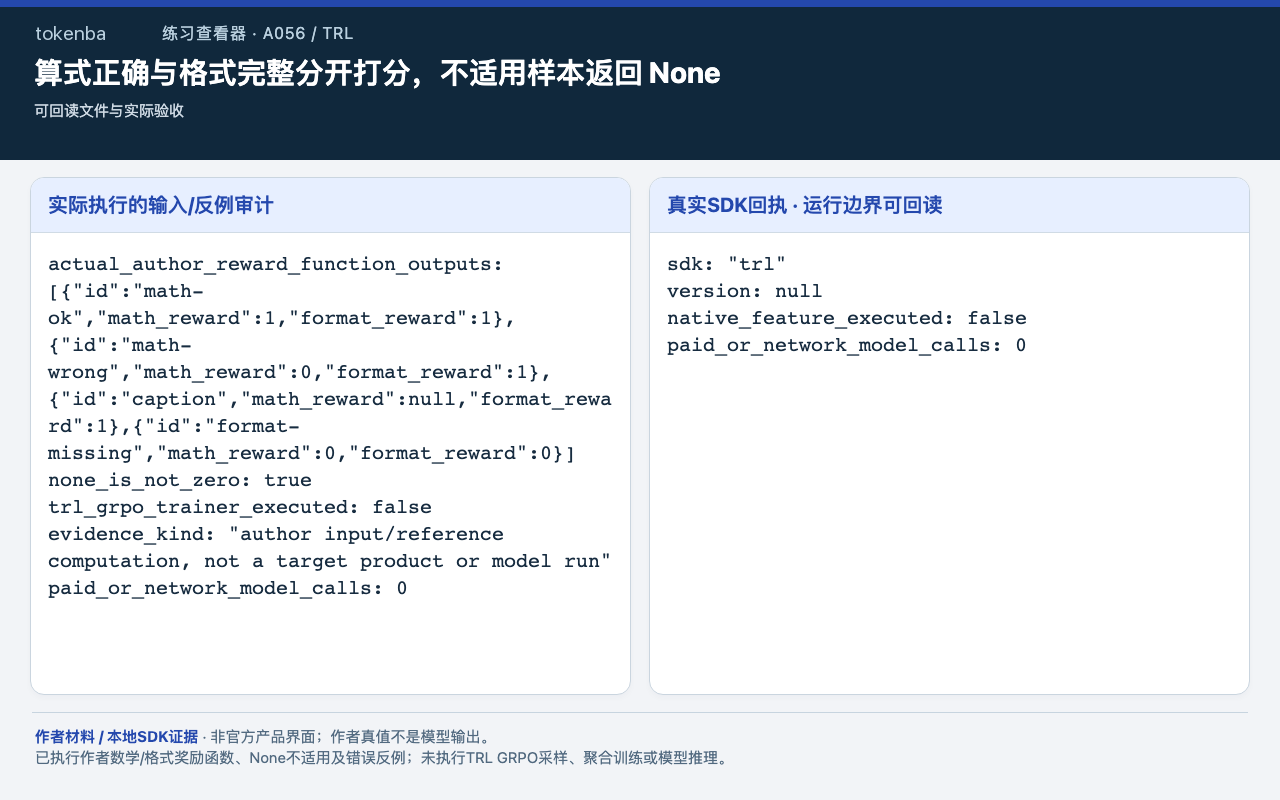
包内实际运行作者奖励函数,没有GRPO采样、模型训练或奖励汇总实测;目标环境需保留真实completion和聚合结果。
怎样确认已经完成
- None不能替代错误应得0
- 各奖励权重可回读
- 组内样本归属不混乱
- 已执行作者数学/格式奖励函数、None不适用及错误反例;未执行TRL GRPO采样、聚合训练或模型推理。
常见问题
TRL GRPO怎么组合格式和正确性两种奖励?
将数学正确性与answer格式写成独立reward_funcs,再按目标TRL文档配置权重并保留逐项结果。包内实际执行两份奖励函数,未跑GRPO。
奖励函数遇到不适用的样本,返回None和0有什么区别?
None表示这个函数不适用该样本,0表示适用但失败;caption数学应None,math-wrong应0。实际训练聚合还须核对安装版实现。
这篇教程哪些步骤已经真正执行?
已执行作者数学/格式奖励函数、None不适用及错误反例;未执行TRL GRPO采样、聚合训练或模型推理。