
展开本页目录
开始前准备什么
- 准备一张自己有权使用、可正常解码的静态图片,先用本页虚构素材。
- 在模型广场核对视觉能力、可用分组和当前最低价格;通用文本型号名称不能证明支持图片。
- 在服务端保存自己的 Key,并确认模型对应的请求协议。
- 明确问题是识别可见内容,不是编辑或生成新图片。
- 检查原图
- 确定接口
- 编码图片
- 只提交一次
- 对照输出
2026-10-23 核验材料;实际执行范围、结果与限制见下方记录。
补充:原有练习资料与下载
说明依赖版本、离线命令、请求协议与验收边界;所有素材为虚构资料。
本地编码真实图片,生成 Chat、Responses 或 Anthropic 请求体;不联网、不保存 Key。
要求绑定图片 ID、记录可见文字与不确定字段,不依据文件名猜内容。
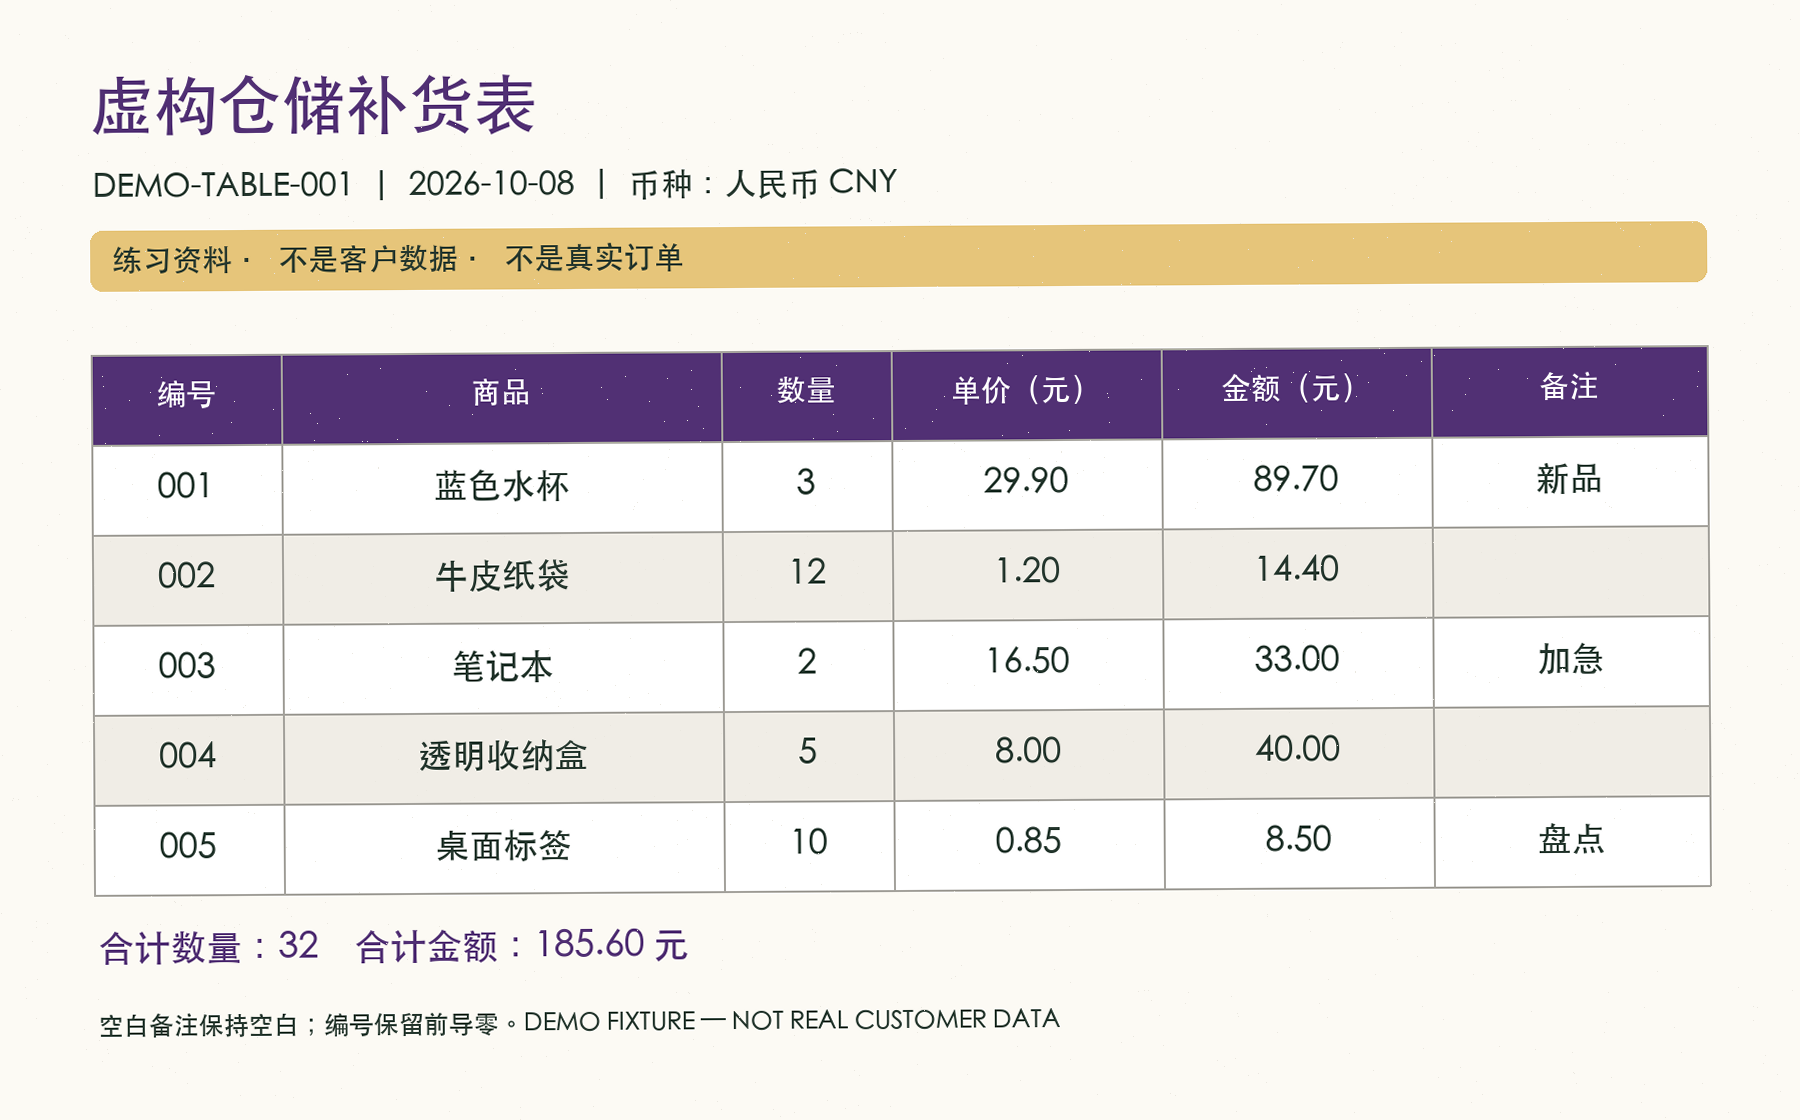
1800×1120 PNG,带虚构资料标记,用于消息结构和字段读取检查。
真实图片构造三种协议,并检查不支持视觉的失败
读取真实PNG生成Chat、Responses和Messages输入,校验图像字节;当前仅有文字模型,实际视觉推理结果不冒充完成。
· Pillow真实解码与本地协议构造;对不具视觉能力的本地模型执行负向检查。
已取得下列真实结果;仍有内容质量或功能范围需要按本页检查项复核。
- 运行环境
- node v24.14.0;ollama 0.40.9;openai 7.43.0;ai 7.0.130;@ai-sdk/openai-compatible 3.0.65
1. 保留图像原件并确认格式
练习图来自本站已有虚构表格素材;先解码确认PNG尺寸、字节和可见内容,不依据文件名猜答案。
2. 实际生成三个独立消息体
脚本读取同一张PNG,输出image_url/input_image/image三种对应结构,标签ID与原始文件绑定。
bashpython3 build-message.py --protocol chat --model tutorial-qwen3-proof:latest --images table=table-input.png --prompt prompt.txt --output new-chat.json3. 核对请求协议而不是只换路径
分别用--protocol responses与anthropic生成另外两份;Chat与Messages不是相同数组字段,不能只把端点名字替换。
4. 确认文字模型不能代替视觉验收
当前tutorial-qwen3-proof:latest没有vision能力;真实负向请求及错误正文保留在结果中,拒绝不等于已识别图片。
bashcd sdk && node run.mjs vision ../vision-image-input-api/new-result.json5. 有合适模型后逐字段验图片
选具视觉能力的真实模型,再校验行序、前导零、空白和无法判断字段;本轮本机无视觉型号;真实网关文字探针被当前测试Key分组429拒绝后已停止,未发送图片请求。
这次实际得到什么
- 真实PNG已由Pillow读取,三种协议构造命令均已执行;构造器没有网络请求。
- 本地不支持视觉的请求记录:{"status": 500, "message": "500 image input is not supported - hint: if this is unexpected, you may need to provide the mmproj"}
- 本API组真实发出2次非流式Chat探针,分别gemini-2.5-flash与gemini-2.5-flash-lite,均HTTP429(当前测试Key分组上游饱和)。以下共享该组探针,绝非本页另发调用;随后SSE、Vercel、n8n、图片请求均未发送。
- 另准备原创1200×800虚构订单表用于后续视觉验收;本轮未向网关发送,不能用预写表格内容冒充模型识别结果。
使用这份结果时注意
- 当前没有可用vision模型;图片语义、OCR、费用与apizt视觉链路均未验证。
- 本批获授权使用既有测试Key,OpenAI SDK两次最小探针均HTTP429:当前测试Key分组上游饱和,随后停止。不能据此声称全站不可用;本地成功不能当作apizt上游或实扣成功。
先从真实图片生成Chat请求体
需要Pillow。将自己的静态图片命名sample.png,设置支持视觉的准确VISION_MODEL后运行。请求体留在本地,不把Base64图片作为公开日志;本脚本不调用模型。
build_vision_body.py
import base64, json, os
from pathlib import Path
from PIL import Image

path = Path("sample.png")
with Image.open(path) as image:
    if getattr(image, "is_animated", False):
        raise ValueError("请先导出单张静态图片")
    image.load()
    mime = Image.MIME.get(image.format)
if mime not in {"image/png", "image/jpeg", "image/webp", "image/gif"}:
    raise ValueError("请选择本教程支持的真实图像格式")
url = "data:" + mime + ";base64," + base64.b64encode(path.read_bytes()).decode()
body = {"model": os.environ["VISION_MODEL"], "messages": [{
    "role": "user", "content": [
        {"type": "text", "text": "请只描述图中可见的物体。"},
        {"type": "image_url", "image_url": {"url": url}},
    ]
}]}
Path("vision-request.json").write_text(json.dumps(body), encoding="utf-8")
print("已保存Chat请求体;尚未发送API请求")
图片内容一样,三种消息结构不同
这是各厂商公开协议的结构差异,不是 apizt 所有型号三种端点都能互换的承诺。保持端点、消息结构、响应解析和所选型号一致;本页构造器可做离线检查,但实际支持仍要在自己的通道验证。
| 已确认的接口 | 图片字段 | 文字字段 |
|---|---|---|
| POST /v1/chat/completions | image_url: { url: data URL 或远程 URL } | type: text |
| POST /v1/responses | type: input_image,image_url 为字符串 | type: input_text |
| Messages 协议 | type: image,source 描述 Base64 或受支持来源 | type: text |
- 已确认的接口
- POST /v1/chat/completions
- 图片字段
- image_url: { url: data URL 或远程 URL }
- 文字字段
- type: text
- 已确认的接口
- POST /v1/responses
- 图片字段
- type: input_image,image_url 为字符串
- 文字字段
- type: input_text
- 已确认的接口
- Messages 协议
- 图片字段
- type: image,source 描述 Base64 或受支持来源
- 文字字段
- type: text
本站绘制的内容说明图:本页公开协议形态对照不是全部型号三端点互换承诺;构造器只做离线校验。
远程 URL 与 Base64 怎么选
浏览器能打开素材,不保证处理 API 的服务器也能打开。带 Cookie、内网地址或临时签名的图片,需要单独验证有效期和访问范围。Base64 只是编码,不是加密;请求体和运行日志仍包含图片内容。
| 来源 | 适合情况 | 先检查什么 |
|---|---|---|
| https:// 可读取图片地址 | 公开练习素材,避免请求体包含整张图片 | API 上游能访问,不跳登录,不返回 HTML |
| data:image/png;base64,... | 本地文件或无公开地址的练习图 | 编码来自真实 PNG,MIME 与文件一致,未超请求限制 |
| 本地文件名 / localhost URL | 只对你的电脑有意义 | 不能直接当作上游可读取的地址 |
- 来源
- https:// 可读取图片地址
- 适合情况
- 公开练习素材,避免请求体包含整张图片
- 先检查什么
- API 上游能访问,不跳登录,不返回 HTML
- 来源
- data:image/png;base64,...
- 适合情况
- 本地文件或无公开地址的练习图
- 先检查什么
- 编码来自真实 PNG,MIME 与文件一致,未超请求限制
- 来源
- 本地文件名 / localhost URL
- 适合情况
- 只对你的电脑有意义
- 先检查什么
- 不能直接当作上游可读取的地址
用真实文件生成请求体
需要 Pillow;先读练习包说明安装依赖。脚本会完整解码图片,检查实际类型、静态帧与输入范围,随后按所选协议编码。20 MiB、1600 万像素和 8 张图是示例脚本的本地范围,不代表厂商或通道上限。
先检查 vision-request.json,再在服务端提交到已确认的端点。不要把生成的 Base64 请求体、私密图片或 Key 放进公开仓库;超时先核对调用记录,关闭自动重复 POST。
只构造请求,不产生 API 费用
python3 growth-batch7-vision-image-message.py \
  --protocol chat --model YOUR_CONFIRMED_VISION_MODEL \
  --images image_A=table-input.png \
  --prompt growth-batch7-vision-input-prompt.txt \
  --output vision-request.json
用这张图检验模型是否真的看到了图片
- 问题写成:读出文档编号、表头和第一行商品;不要在提问里直接给标准答案。
- 模型应引用图片中的 DEMO-TABLE-001、六列表头和可见商品;图里没写的仓库地址、负责人应保持未知。
- 编号 001 要与数量 3、单价 29.90 分开读取,空白备注不能当成上一行的延续。
- 实际输出出现拒绝、无文字或格式变化时,记录 HTTP 状态和响应结构;不要用预计答案填充成功结果。
本站绘制的内容说明图:此页用固定练习图核对是否真的读图;未知字段不得由预计答案填入响应记录。
看得见,不等于每个细节都准确
密集小字、旋转、压缩和遮挡会降低可读性。优先保留清晰原图;需要裁剪时保留全图上下文并记录裁剪区域,不让局部文字失去表头和单位。
本地图片检查工具不能证明远程可访问、视觉模型能力或 OCR 准确率。正式业务应定义字段标准、样本集和人工复核入口,再决定是否自动化。
本次补测:先完成搜索要解决的问题,再进入下一步
仅展示图片格式不够,需要识别错误、模糊项与人工复核的实际样例。
这是识图请求,不是生图或视频任务;真实图片、两个模型尝试和业务检查都保留。
- 使用原创菜单 JPEG,发送 image_url 数据URL与识别要求,不发送人工答案。
- 原样保存模型返回;首轮把青柠读成青枣,不能改稿后声称首轮成功。
- 再次小样识别后逐项核对菜名和价格;模糊配料留 unknown,不补猜。
新增补测结果;与原有原生工具记录分别保存
{
  "items": [
    {
      "name": "青柠茶",
      "price": "12",
      "ingredients": "青柠、水、茶"
    },
    {
      "name": "坚果饼",
      "price": "18",
      "ingredients": "unknown"
    }
  ]
}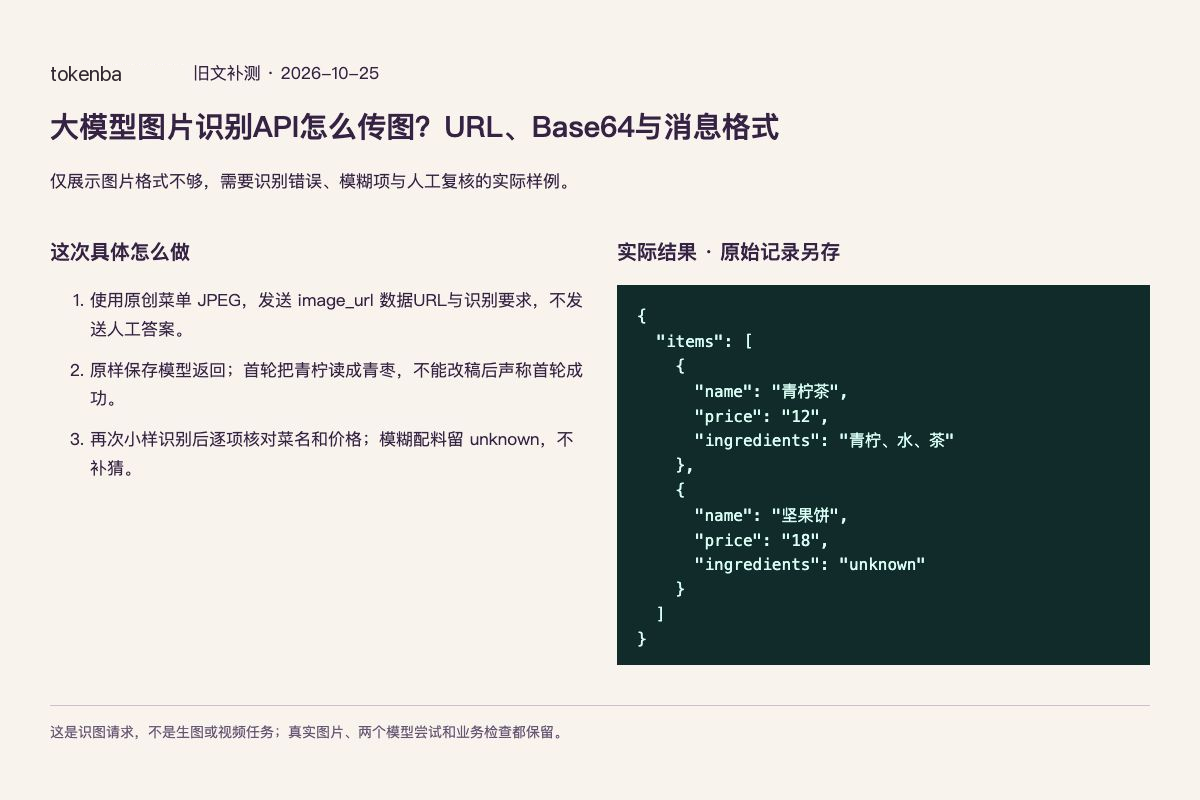
本次实际数据的浏览器执行报告截图,非第三方软件界面;原有配图和缩略图保留。
怎样确认已经完成
- 接口和图片字段来自同一协议。
- 图片实际格式与声明 MIME 一致,消息包含真实图像数据。
- 模型只读取可见内容,未知字段没有被补写。
- 记录原图、请求版本、响应和实际调用费用。
- 一张图的通过结果没有被推广成通道全功能兼容。
常见问题
只把sample.png文件名写进提示词可以吗?
不可以。通常要上传文件内容、使用有效文件引用,或按接口传入可访问URL/Base64。模型不会自动读取你电脑上的同名文件。
为什么URL在浏览器能打开,API却读不到?
浏览器可能有Cookie、内网权限或临时签名。处理API的服务器需要独立访问该URL;不适合公开的图片可按所选接口改用文件上传或Base64。
图片识别应该调用 Images 还是聊天接口?
Images 通常用于生成或编辑图片。图片理解应使用该型号已确认的多模态消息接口,返回文字或结构化结果。
API 报 invalid_image_url,本地图片也坏了吗?
可能是 URL 不可读取、消息字段错、MIME 不一致或通道限制。本地解码正常只能排除部分文件问题,还需要检查接口收到的实际消息。