
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 明确一个底座和两个真实适配器
- 检查适配器名称与请求归属
- 启动支持LoRA的vLLM服务
- 发送交替请求而不重启底座
- 执行未知适配器负例
- 比较两类任务质量与资源
- 交付配置和可追溯回执
1. 明确一个底座和两个真实适配器
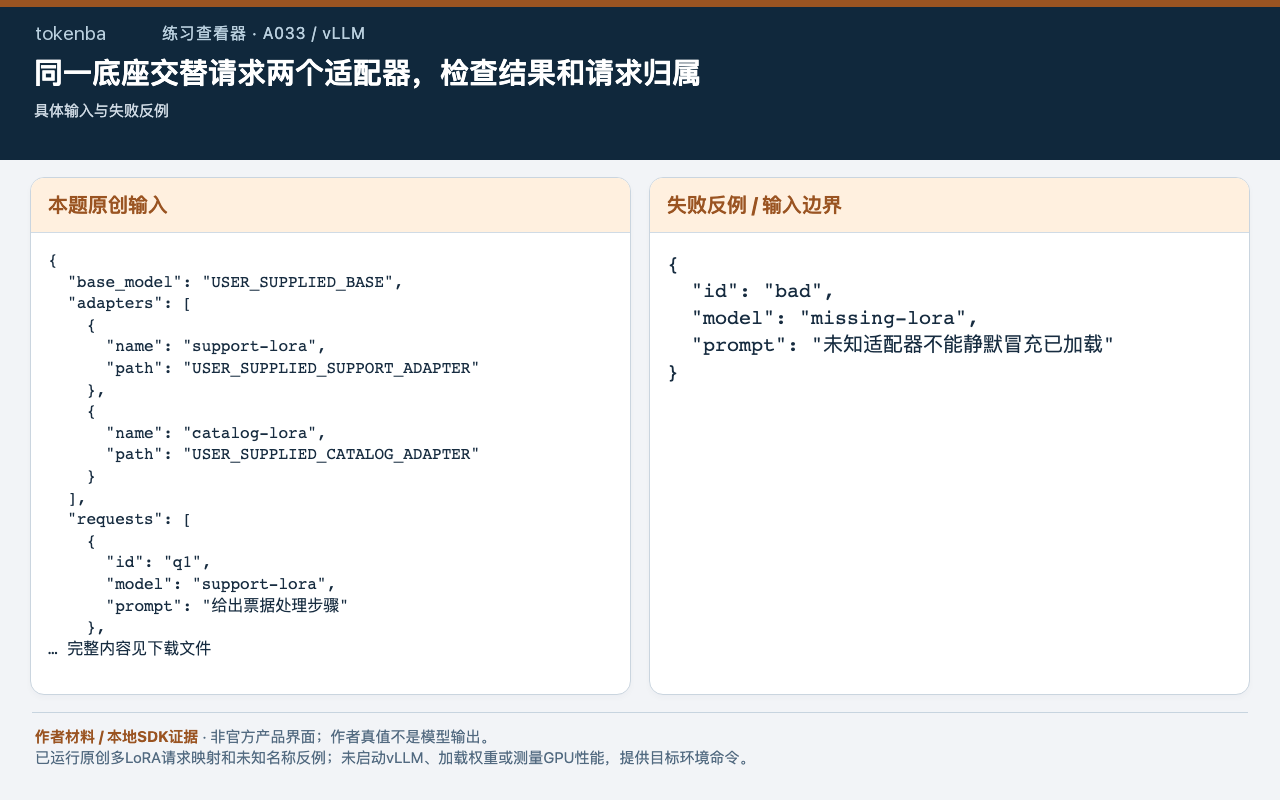
把USER_SUPPLIED占位路径换成自行训练且与底座兼容的LoRA。包内没有权重,也没有伪造adapter_model文件。
2. 检查适配器名称与请求归属
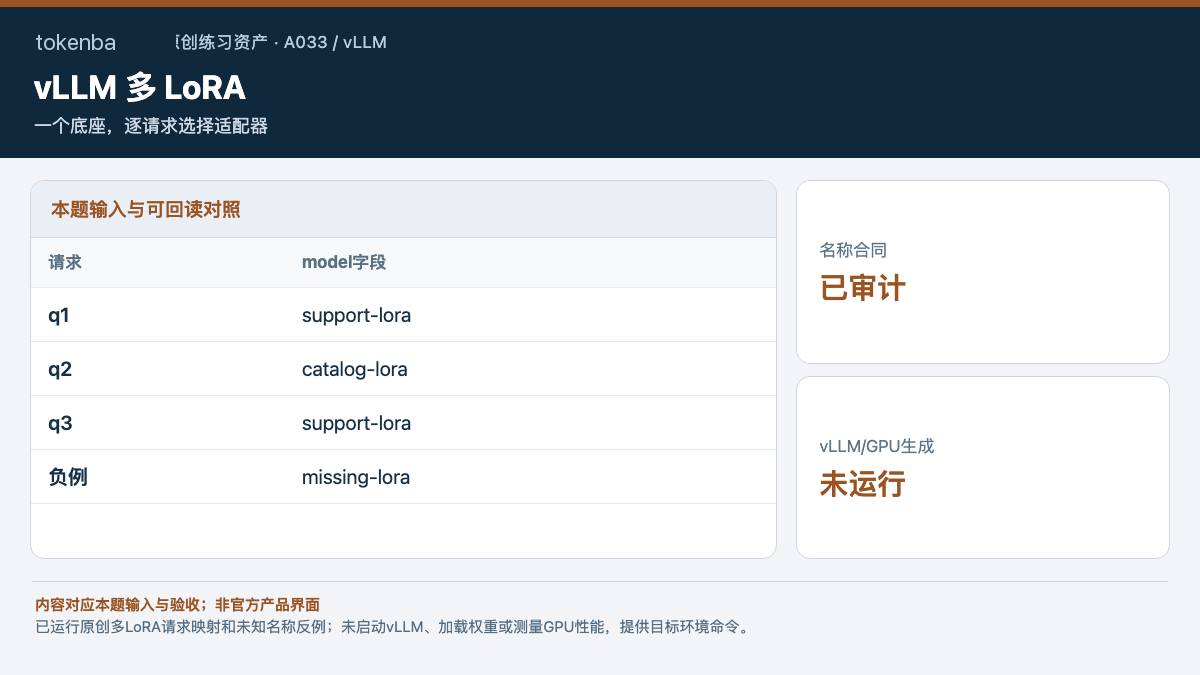
audit.py检查q1/q3走support、q2走catalog,并拒绝missing-lora。这里只验证请求合同,不代表vLLM已加载模型。
本题独立目录执行
bash
python reference/audit.py3. 启动支持LoRA的vLLM服务
在合适GPU环境使用--enable-lora、--lora-modules name=path,并按真实rank设置max-lora-rank与max-loras;先确认安装版本支持这些参数。
本题SDK或目标环境入口
bash
python reference/run_sdk.py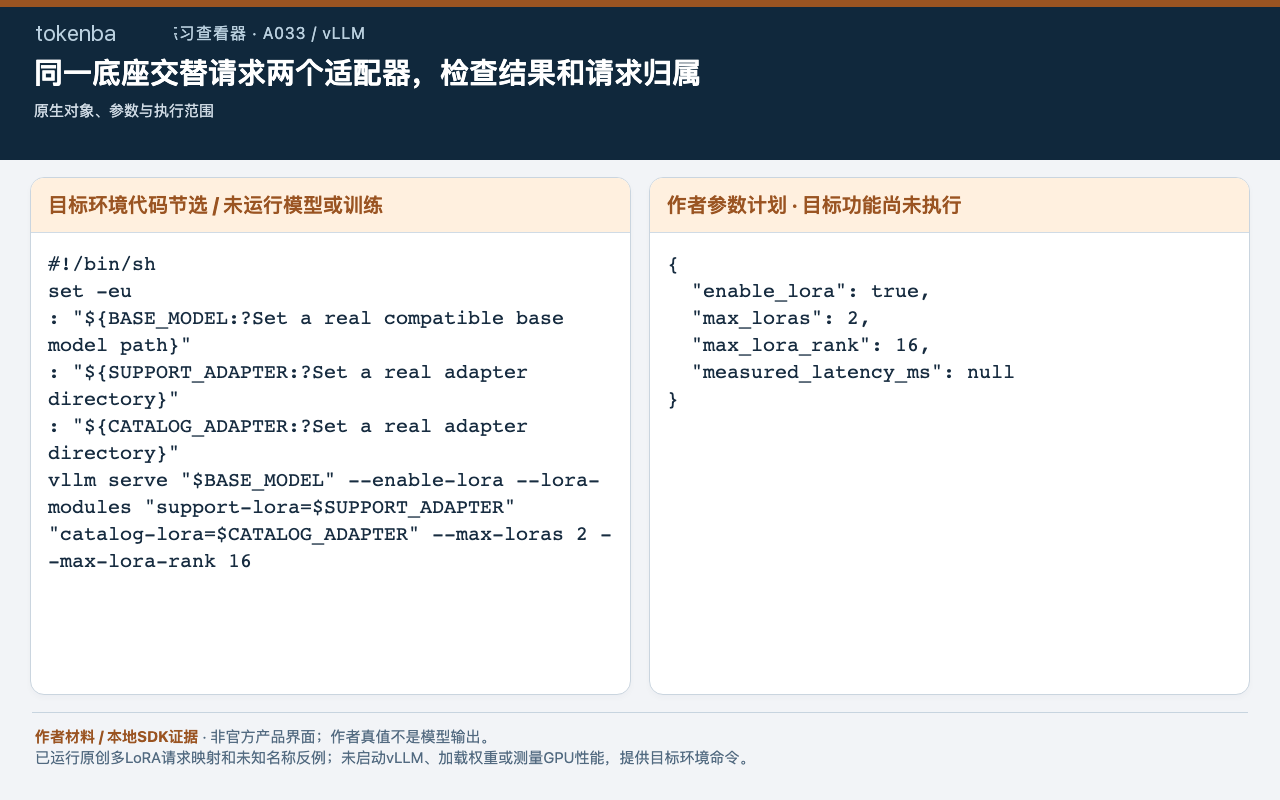
4. 发送交替请求而不重启底座
使用OpenAI兼容请求中的model字段选择适配器,逐条保存实际返回model、答案、耗时和服务日志。不要用请求顺序推测正确路由。
5. 执行未知适配器负例
发送missing-lora并保存真实错误状态;不能在客户端悄悄换成底座并把结果称为适配器输出。
6. 比较两类任务质量与资源
给两套任务各自设置人工真值,记录GPU显存、吞吐和错误。适配器共用底座不意味着两项任务都不退化。
7. 交付配置和可追溯回执
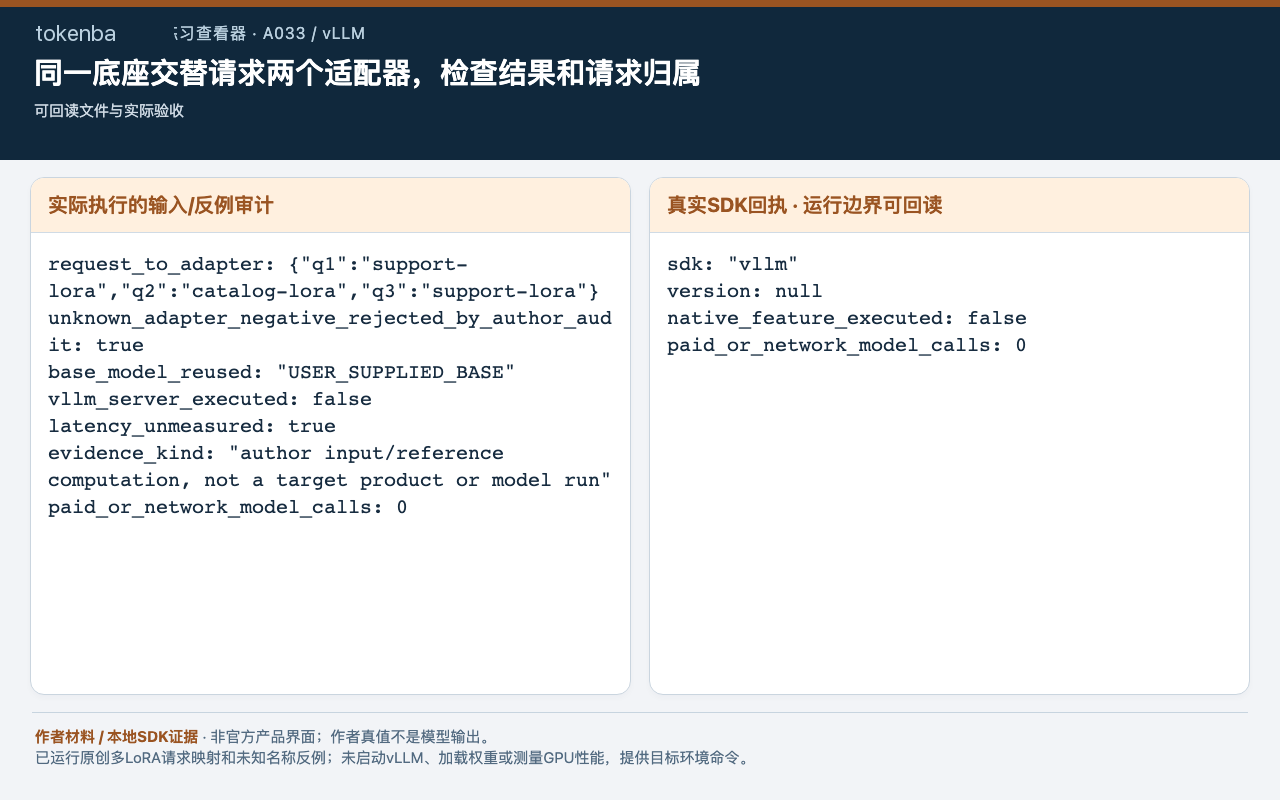
保留底座版本、适配器哈希及逐请求归属。当前包只运行名称合同审计,GPU加载、生成和性能测量均未执行。
怎样确认已经完成
- 记录实际adapter文件和hash
- 禁止同名覆盖
- 硬件版本和不可用特性明确
- 已运行原创多LoRA请求映射和未知名称反例;未启动vLLM、加载权重或测量GPU性能,提供目标环境命令。
常见问题
vLLM怎么在同一底座同时服务两个LoRA?
启用LoRA并登记两个兼容适配器名,客户端用model字段选择。包内提供目标启动和交替请求脚本,未加载权重。
交替请求不同adapter时怎么检查模型有没有串用?
逐请求保存所选adapter、真实返回和任务测试结果,再用missing-lora负例检查未知名。名称合同通过不等于模型归属已实测。
这篇教程哪些步骤已经真正执行?
已运行原创多LoRA请求映射和未知名称反例;未启动vLLM、加载权重或测量GPU性能,提供目标环境命令。