
展开本页目录
开始前准备什么
- 下载到独立练习目录,先运行材料校验,再连接自己的翻译服务。
- 准备 Python 与对应工具的隔离环境;PDF 检查使用 Poppler,翻译版本分别记录。
- 原文均为原创练习材料;密钥只填在本机,不写入下载文件或截图。
- 打开双栏原文与清单
- 区分引擎与 WebUI
- 安装后先查实际帮助
- 设置自己的可用服务
- 先限制一页并生成双语产物
- 按固定位置检查公式与栏序
- 保存三种证据
原创 PDF/CSV/EPUB/HTML、逐步说明、校验脚本与真实离线记录;不含模型译文。
对应本页操作、工具边界与验收范围。
本页截图使用的原始文档。
读取真实材料与文件结构;不请求模型、不读取凭证。
当前材料与脚本的实际运行结果。
本页专用练习材料;运行范围见 README。
只有占位值;复制为自己的 service.toml,填写后使用 --config,不分享真实 Key。
1. 打开双栏原文与清单
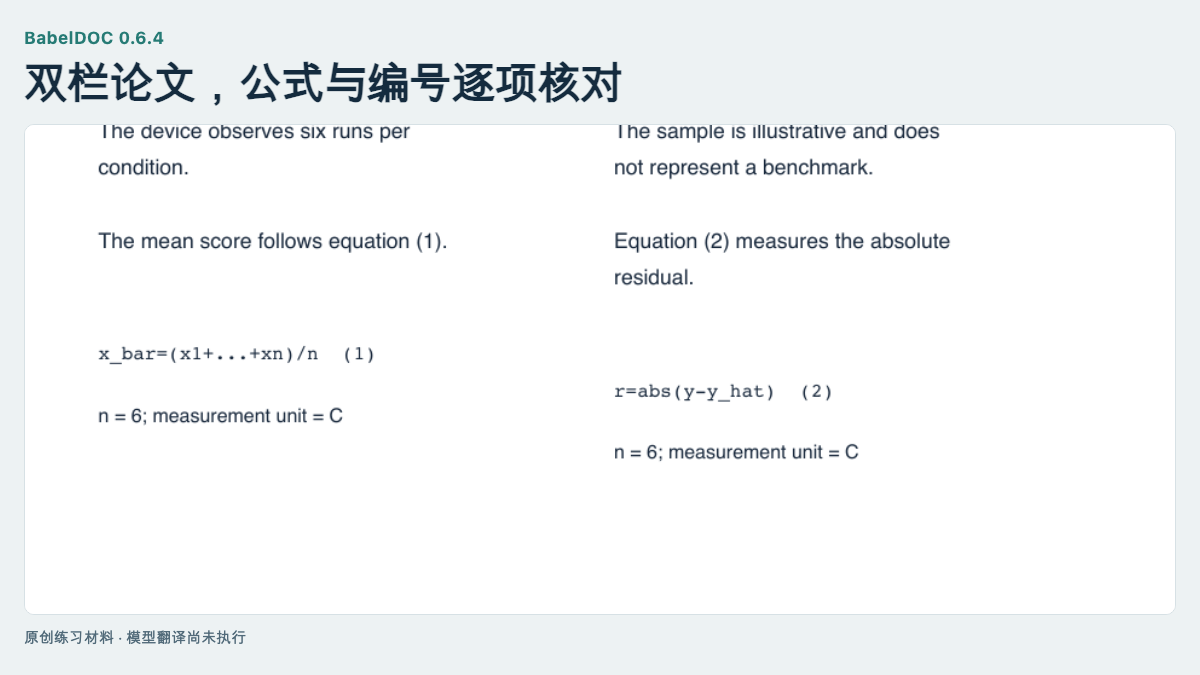
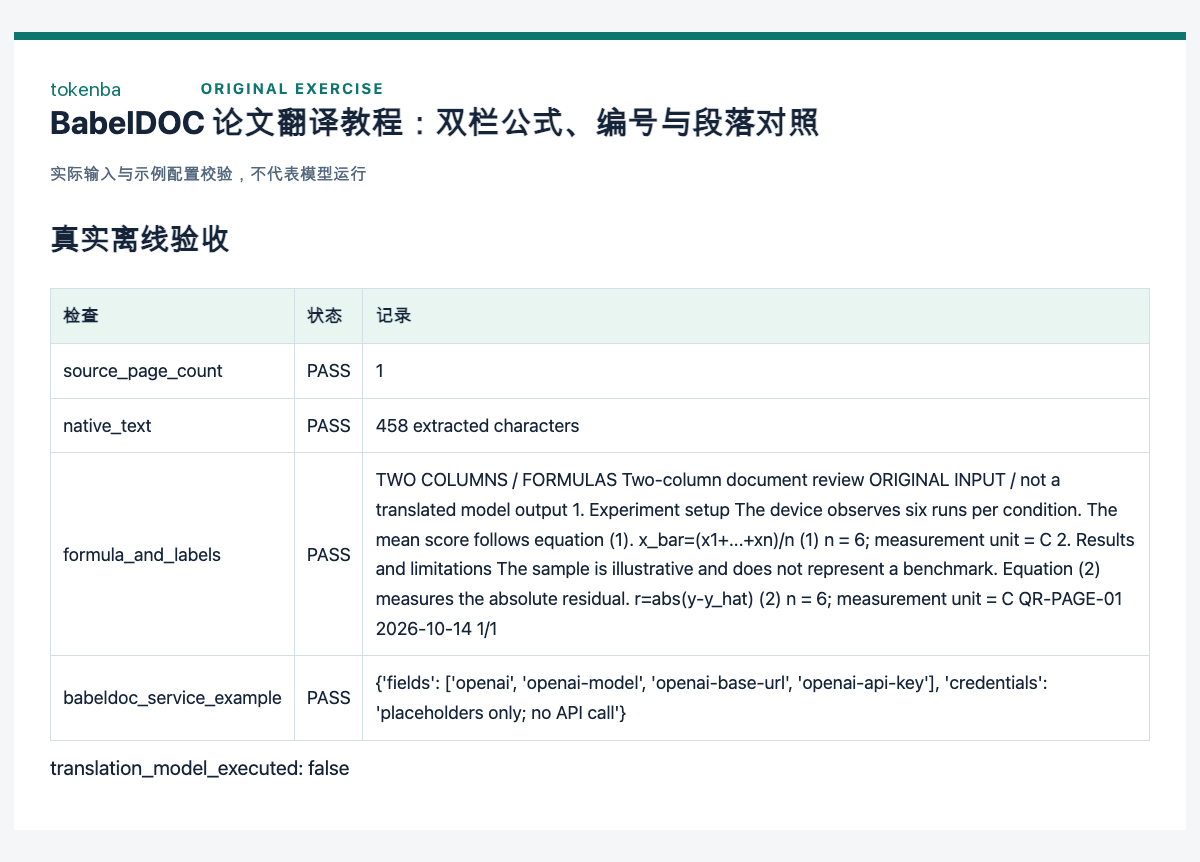
source.pdf 为原创两栏短文,包含编号 (1)、(2)、两处小标题与页脚。输入截图和公式细节图均直接渲染该 PDF;没有使用他人的论文。
bash
python3 verify.py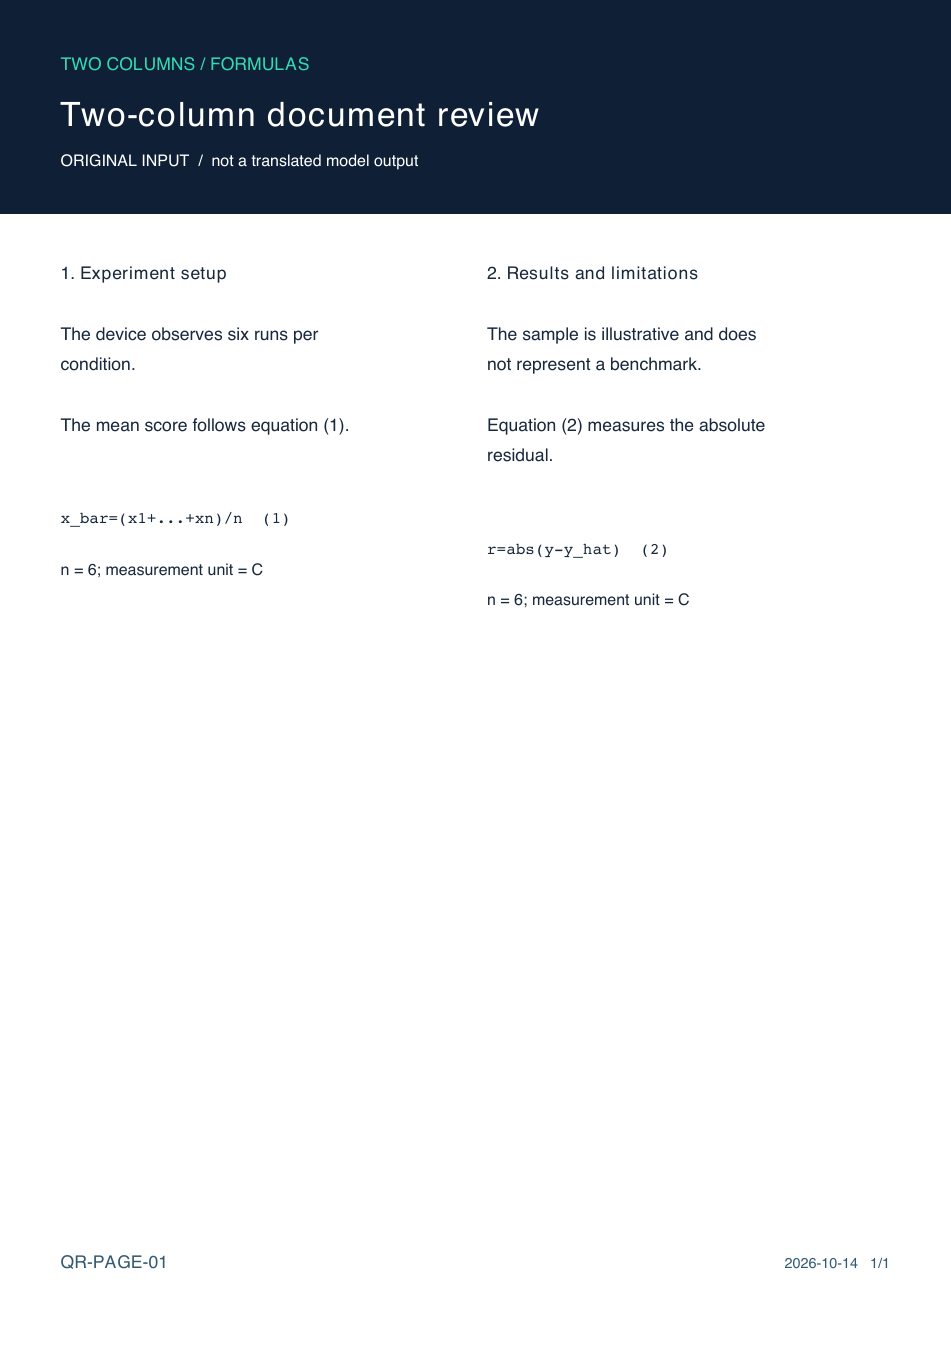
2. 区分引擎与 WebUI
BabelDOC 提供自己的 CLI 和 Python API;PDFMathTranslate-next 可以作为其上层界面。本文固定 BabelDOC 0.6.4 的公开参数;相似短选项不代表不同引擎的全部配置互通。
3. 安装固定发行版并查帮助
在独立环境安装 BabelDOC 0.6.4,记录版本并打开 --help。若希望用 WebUI,另按 Next 文档安装 pdf2zh_next --gui;不能把上层界面与 BabelDOC 包当作同一版本。教材只用官方解析器检查命令,没有安装翻译环境或调用模型。
bash
uv tool install --python 3.12 "BabelDOC==0.6.4"
babeldoc --version
babeldoc --help
4. 复制服务配置并填入自己的参数
把 service.example.toml 复制为 service.toml,在本机编辑 [babeldoc] 下的 openai-model、openai-base-url、openai-api-key,保留 openai=true。模型与 Base URL 来自你实际可用的服务,Base URL 通常含 /v1,不含 /chat/completions。配置键使用连字符,不能改成 openai_model。示例都是占位值;自己的 service.toml 含 Key,不分享或放进公开 ZIP。
bash
cp service.example.toml service.toml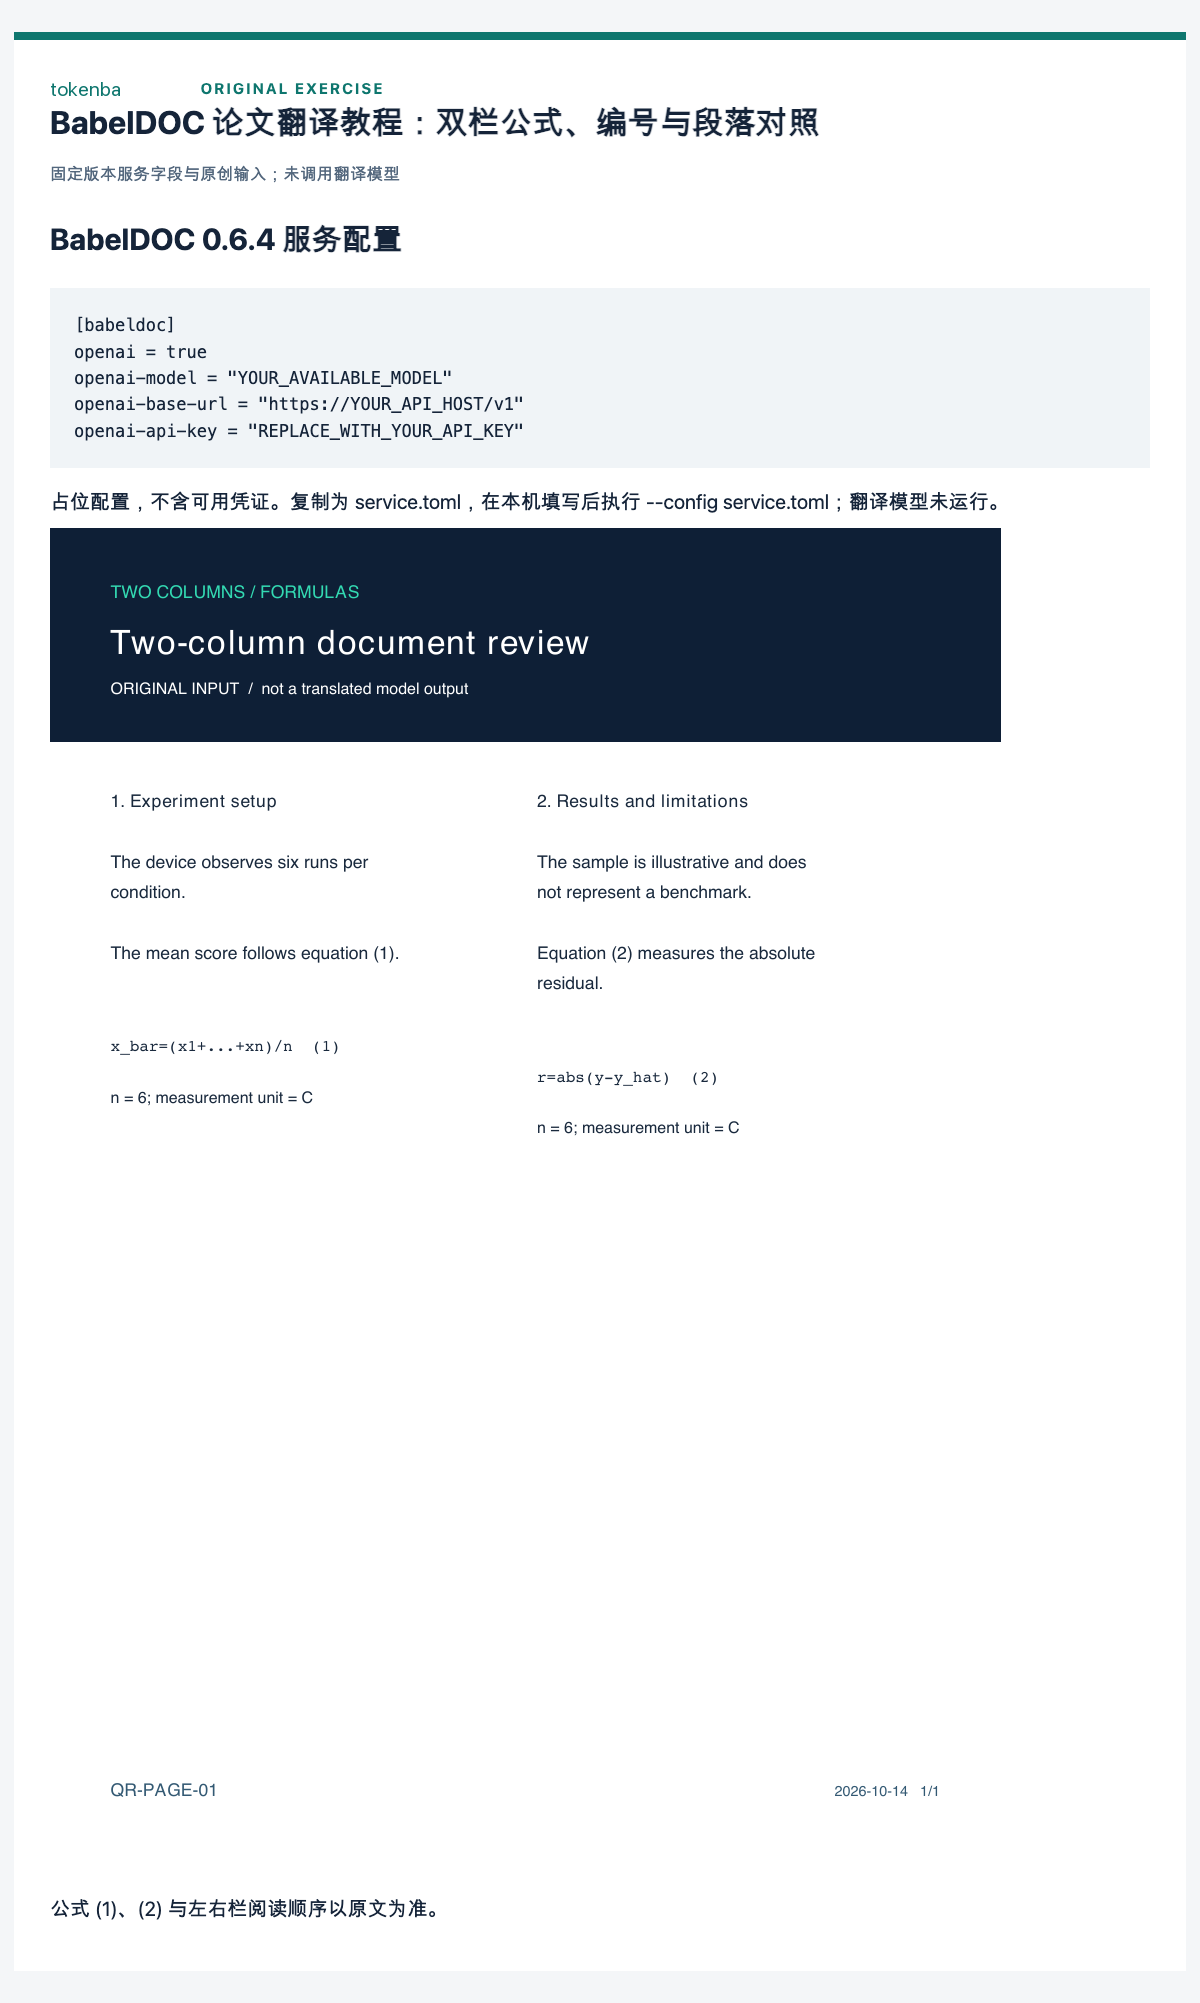
5. 先限制一页并生成双语产物
填完自己的 service.toml 后,执行下面完整的配置加文件命令。官方 0.6.4 解析器已离线检查 --config 与这些字段;真正翻译会使用所配服务的额度,教材未执行模型步骤,也没有伪造中文结果 PDF。
bash
babeldoc --config service.toml --files source.pdf --pages 1 --lang-in en --lang-out zh --output output6. 按固定位置检查公式与栏序
对照 formula-regions.csv:检查 x_bar=(x1+...+xn)/n 与 r=abs(y-y_hat) 的字符及编号;沿左栏从上到下、再右栏读,不能左右逐行交错。
bash
pdftotext -layout output/your-bilingual.pdf output/translated.txt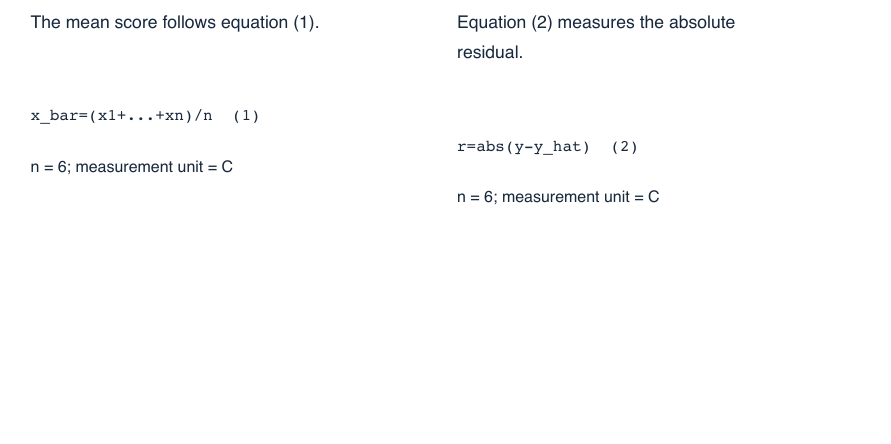
7. 保存三种证据
保留原文整页、公式裁切和实际译文同位置裁切,记录正文是否压缩、标题是否漂移。结构与公式检查通过后再人工评估译文,不把占位文本当模型输出。
怎样确认已经完成
- 两栏阅读顺序、两处标题与页脚未漏掉,原文保留完整。
- (1)/(2)、均值公式和绝对残差的符号与原文逐项一致。
- 实际翻译前后截图必须来自自己的执行;当前包仅有原创输入和真实离线检查。
常见问题
公式没变就说明翻译正确吗?
不能。公式可保持原图或独立对象,正文、引用和栏序仍可能出错,必须逐项核对。
BabelDOC 是在线网站吗?
这里指开源翻译引擎及其 CLI/Python API。使用上层网页产品时,还需单独核对该产品的版本、服务与输出设置。