
展开本页目录
开始前准备什么
- 下载独立练习包,阅读README的版本、套餐与实跑范围。
- AI prompt field 需要 Premium+ 与可用模型。Baserow OSE 为 MIT,premium/enterprise 另有协议。本包未运行 Baserow 或分类模型。
- 准备自己的可用模型与账户;不把示例模型占位名或地址当作已验证配置。
- 检查12条反馈与歧义行
- 先确认Premium和模型
- 建立Choices类型AI字段
- 先运行三条小样本
- 修改F09并观察更新
- 导出实际分类记录
- 保留失败与付费边界
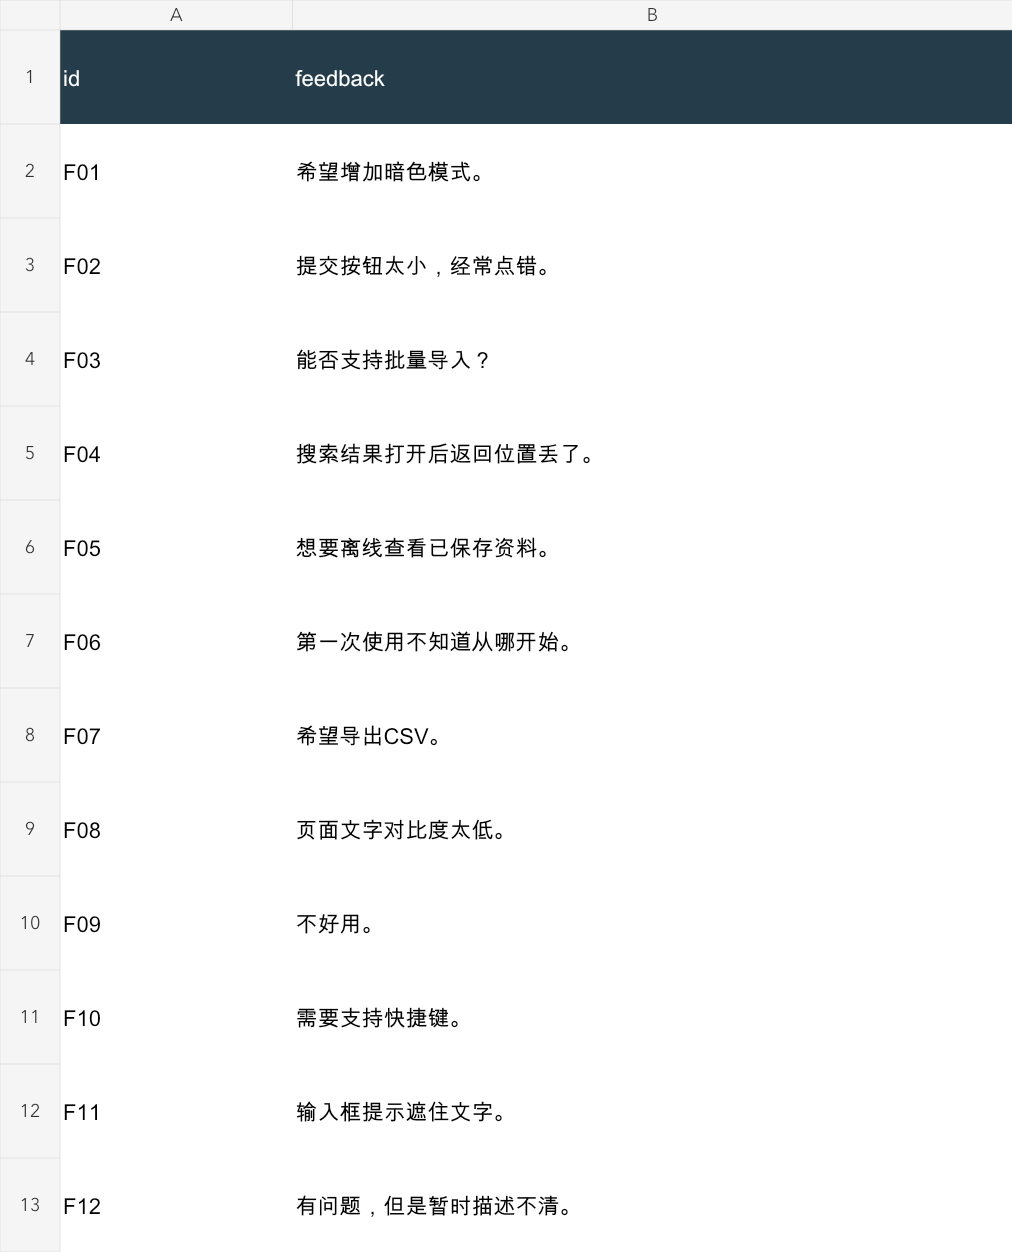
1. 检查12条反馈与歧义行
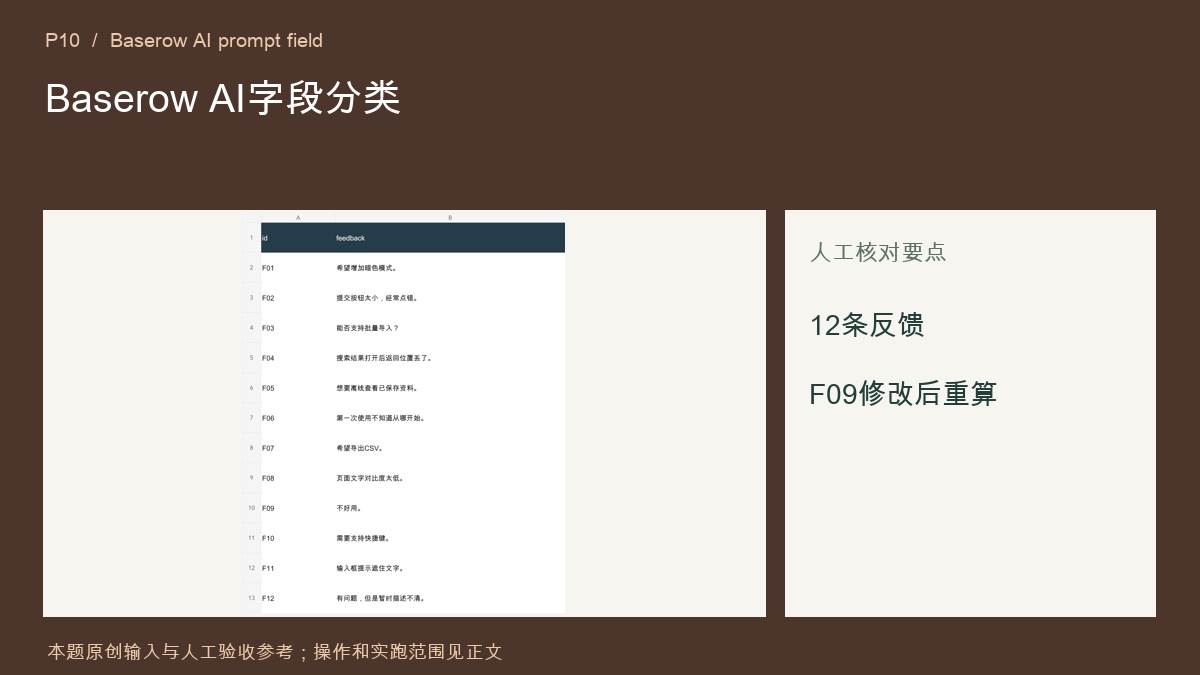
feedback.csv 是原创教学反馈,F09/F12 信息不足,人工预期为待补充。先读 prompt.md 的具体分类口径,不把任意标签都算正确。
bash
python3 verify.py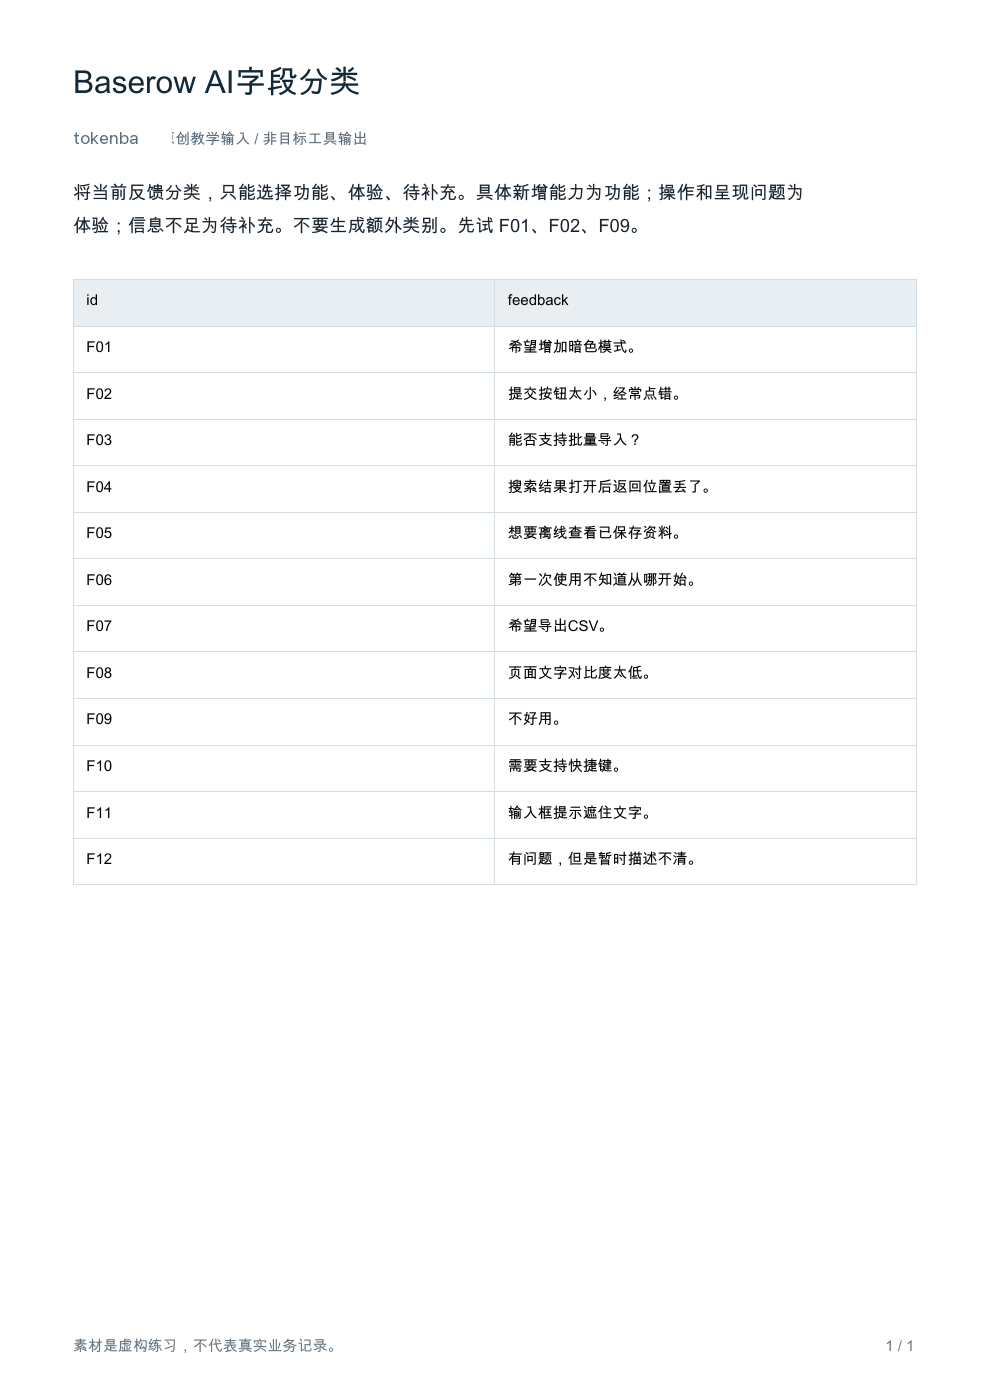
2. 先确认Premium和模型
AI prompt field 官方要求 Premium 及以上。配置 provider 并测试模型;免费 OSE 中没有该字段时,不应继续按不存在的界面操作。
3. 建立Choices类型AI字段
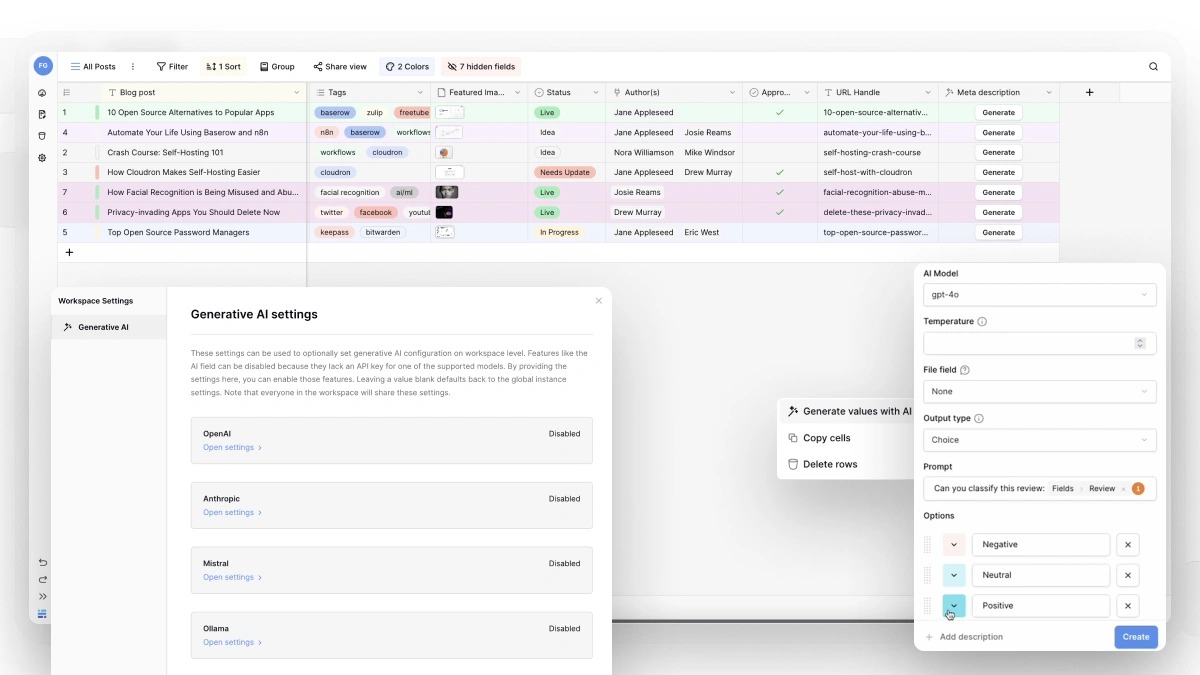
把反馈导入独立表,创建 AI prompt 字段,Output type 选 Choices,明确三个选项,提示引用 feedback 原文列;官方图只定位设置。
4. 先运行三条小样本
分别生成 F01、F02、F09,检查功能/体验/待补充三个代表。纠正提示后再用字段头的 Generate all AI values,不先处理上千条。
5. 修改F09并观察更新
开启 Regenerate when referenced fields change,将 F09 改为“希望增加多语言界面”。记录更新时间与实际分类;不是改了原文就先宣布重算成功。
6. 导出实际分类记录
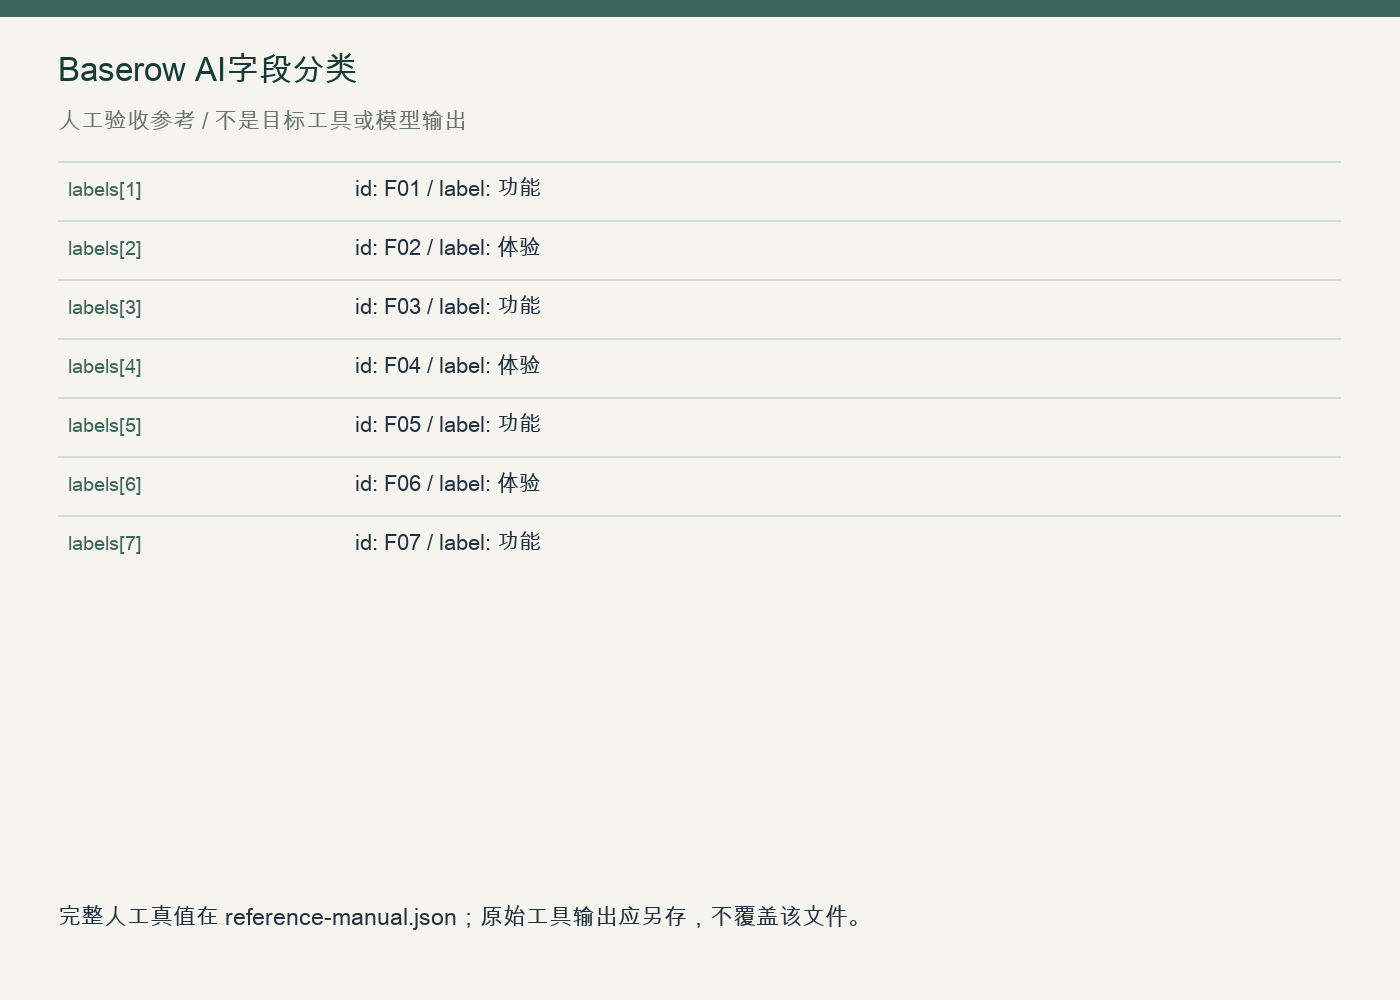
将实际结果整理到 actual-template.json,包含12条标签及修改后的F09。脚本核对本练习的人工分类口径,不判断任意用户反馈语义。
bash
python3 verify.py --actual my-labels.json7. 保留失败与付费边界
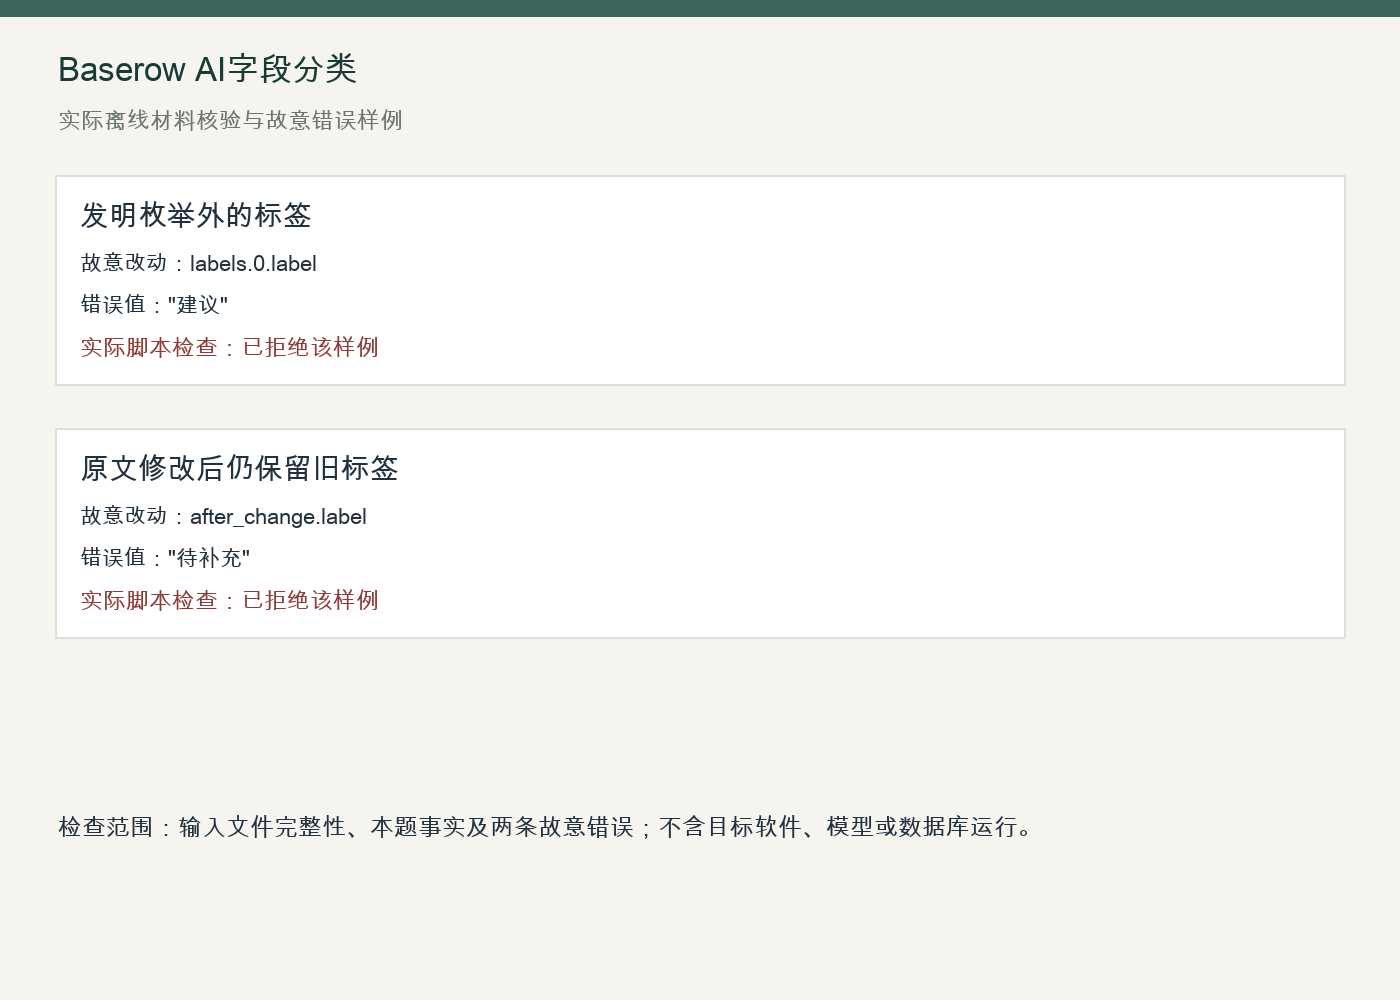
运行额外类别和陈旧标签负例。原始输入、提示词、实际导出分别保存;本站未运行 Baserow AI,图中的教材表不是其实际生成结果。
怎样确认已经完成
- 原始输入、来源和单位已保留,材料检查及两条故意错误样例均运行。
- 在真实工具保存原生输出,回读本题关键事实、缺值与来源;未运行部分仍标记未执行。
- 保存工具/模型版本和实际结果,人工修改与模型返回分开归档。
常见问题
Baserow AI字段分类需要哪些条件?
AI prompt field 需要 Premium+ 与可用模型。Baserow OSE 为 MIT,premium/enterprise 另有协议。本包未运行 Baserow 或分类模型。
Baserow AI字段分类的图片和检查通过代表什么?
原始输入、人工参考与实际离线材料检查均有对应文件;官方图说明操作入口。目标软件和模型未执行的部分已在步骤中注明,不能用材料检查替代真实产品运行。
Baserow AI字段在免费开源版就能用吗?
官方AI prompt field要求Premium及以上,模型使用还取决于provider与账户;OSE许可和商业功能可用性应分开检查。