
展开本页目录
开始前准备什么
- 下载独立练习包,阅读README的版本、套餐与实跑范围。
- Premium+;模型文件支持及大小限制依实际 provider。OSE MIT,商业目录另有许可。本站未运行 Baserow。
- 准备自己的可用模型与账户;不把示例模型占位名或地址当作已验证配置。
- 打开三份虚构收据
- 确认套餐和文件模型能力
- 建立单附件基准行
- 生成并逐项回读原页
- 单独测试多附件顺序
- 整理实际字段观察
- 记录选择歧义和失败
1. 打开三份虚构收据
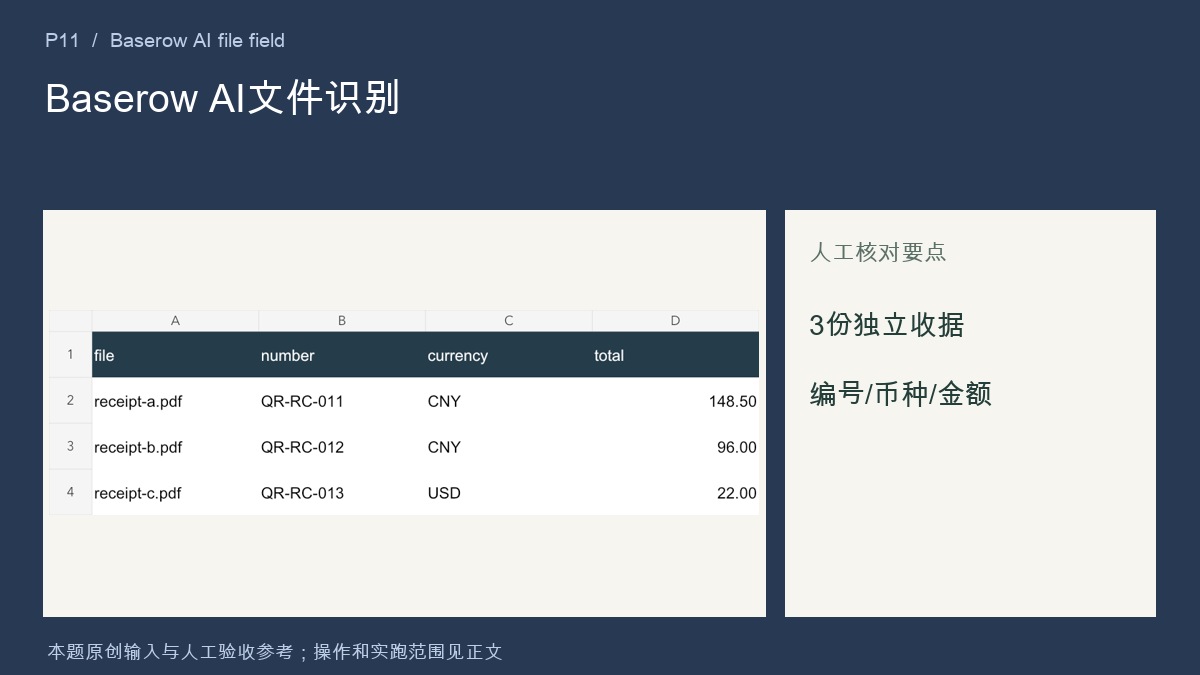
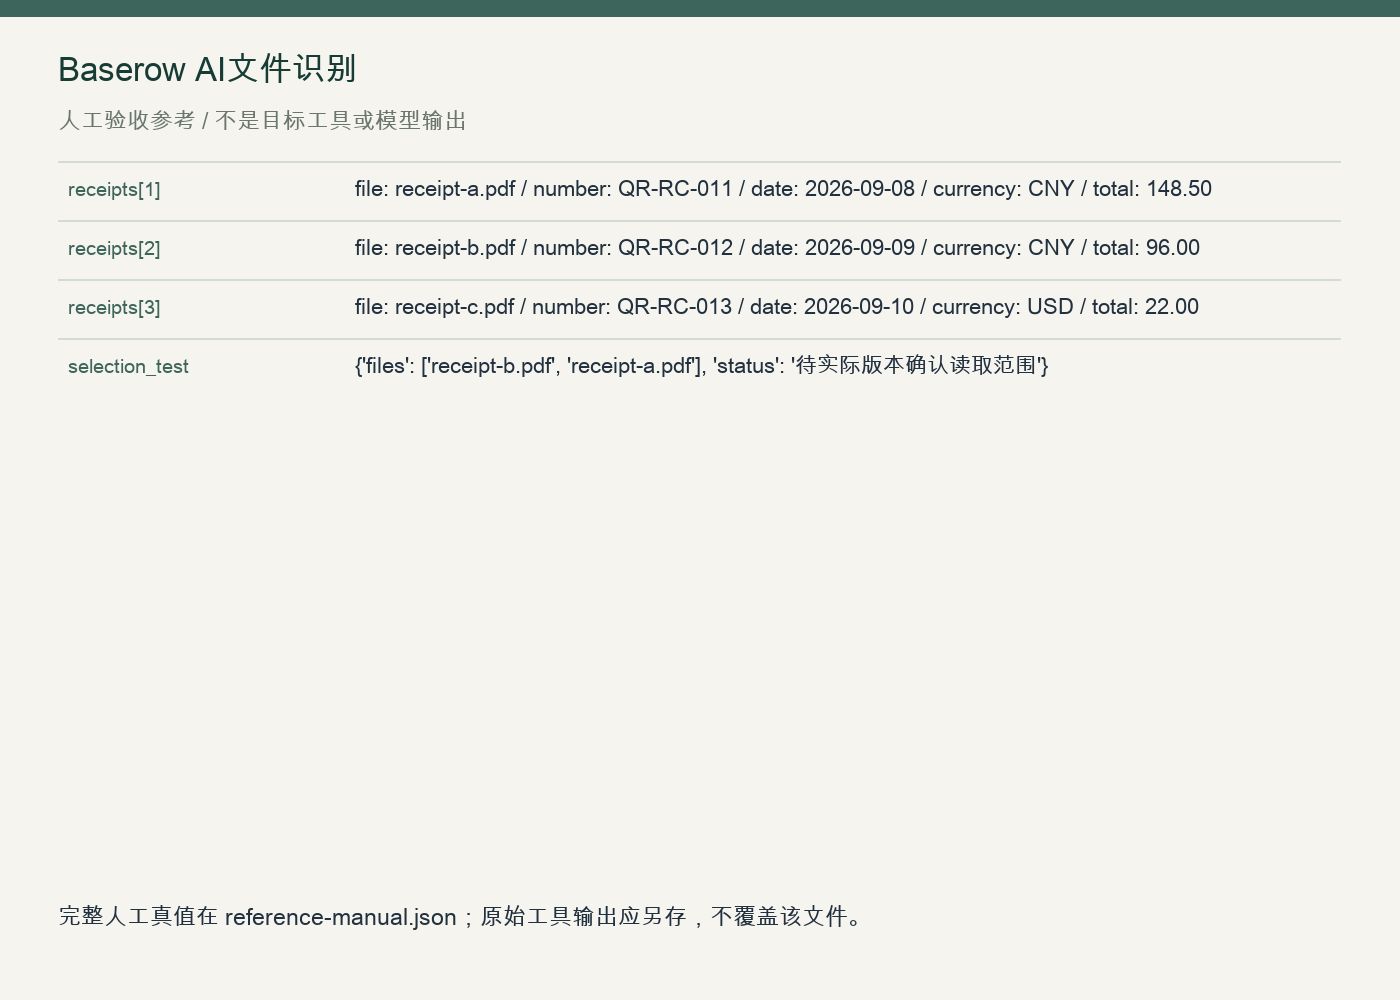
receipt-a/b/c.pdf 各一页,编号、币种和总额不同,全部标注原创教材。先对照 receipts.json,不能只提取金额而忽略币种与来源文件。
bash
bash
python3 verify.py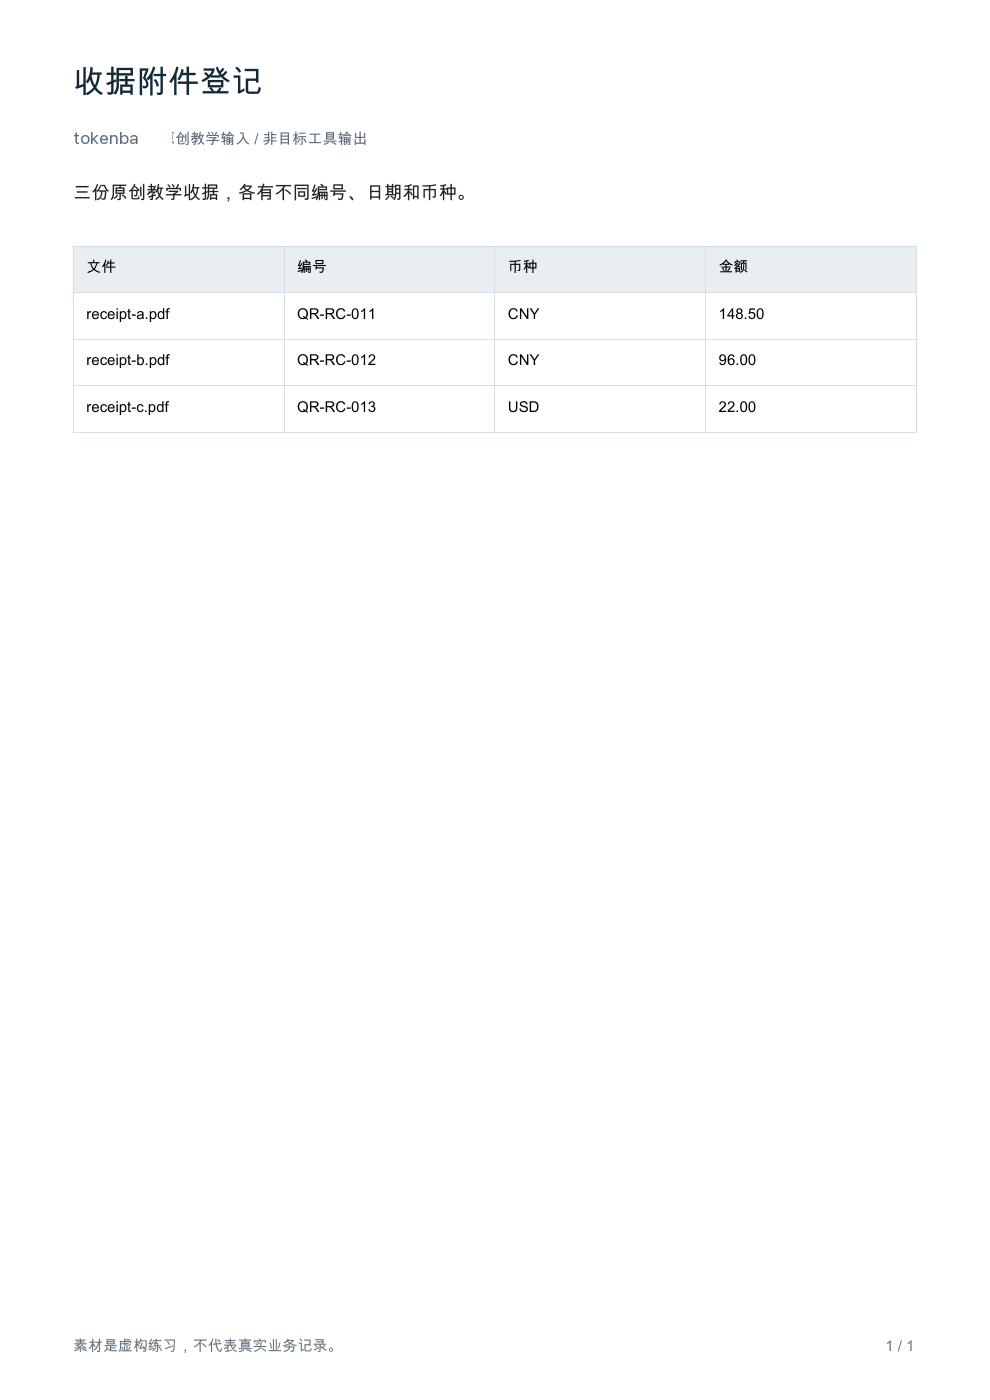
2. 确认套餐和文件模型能力
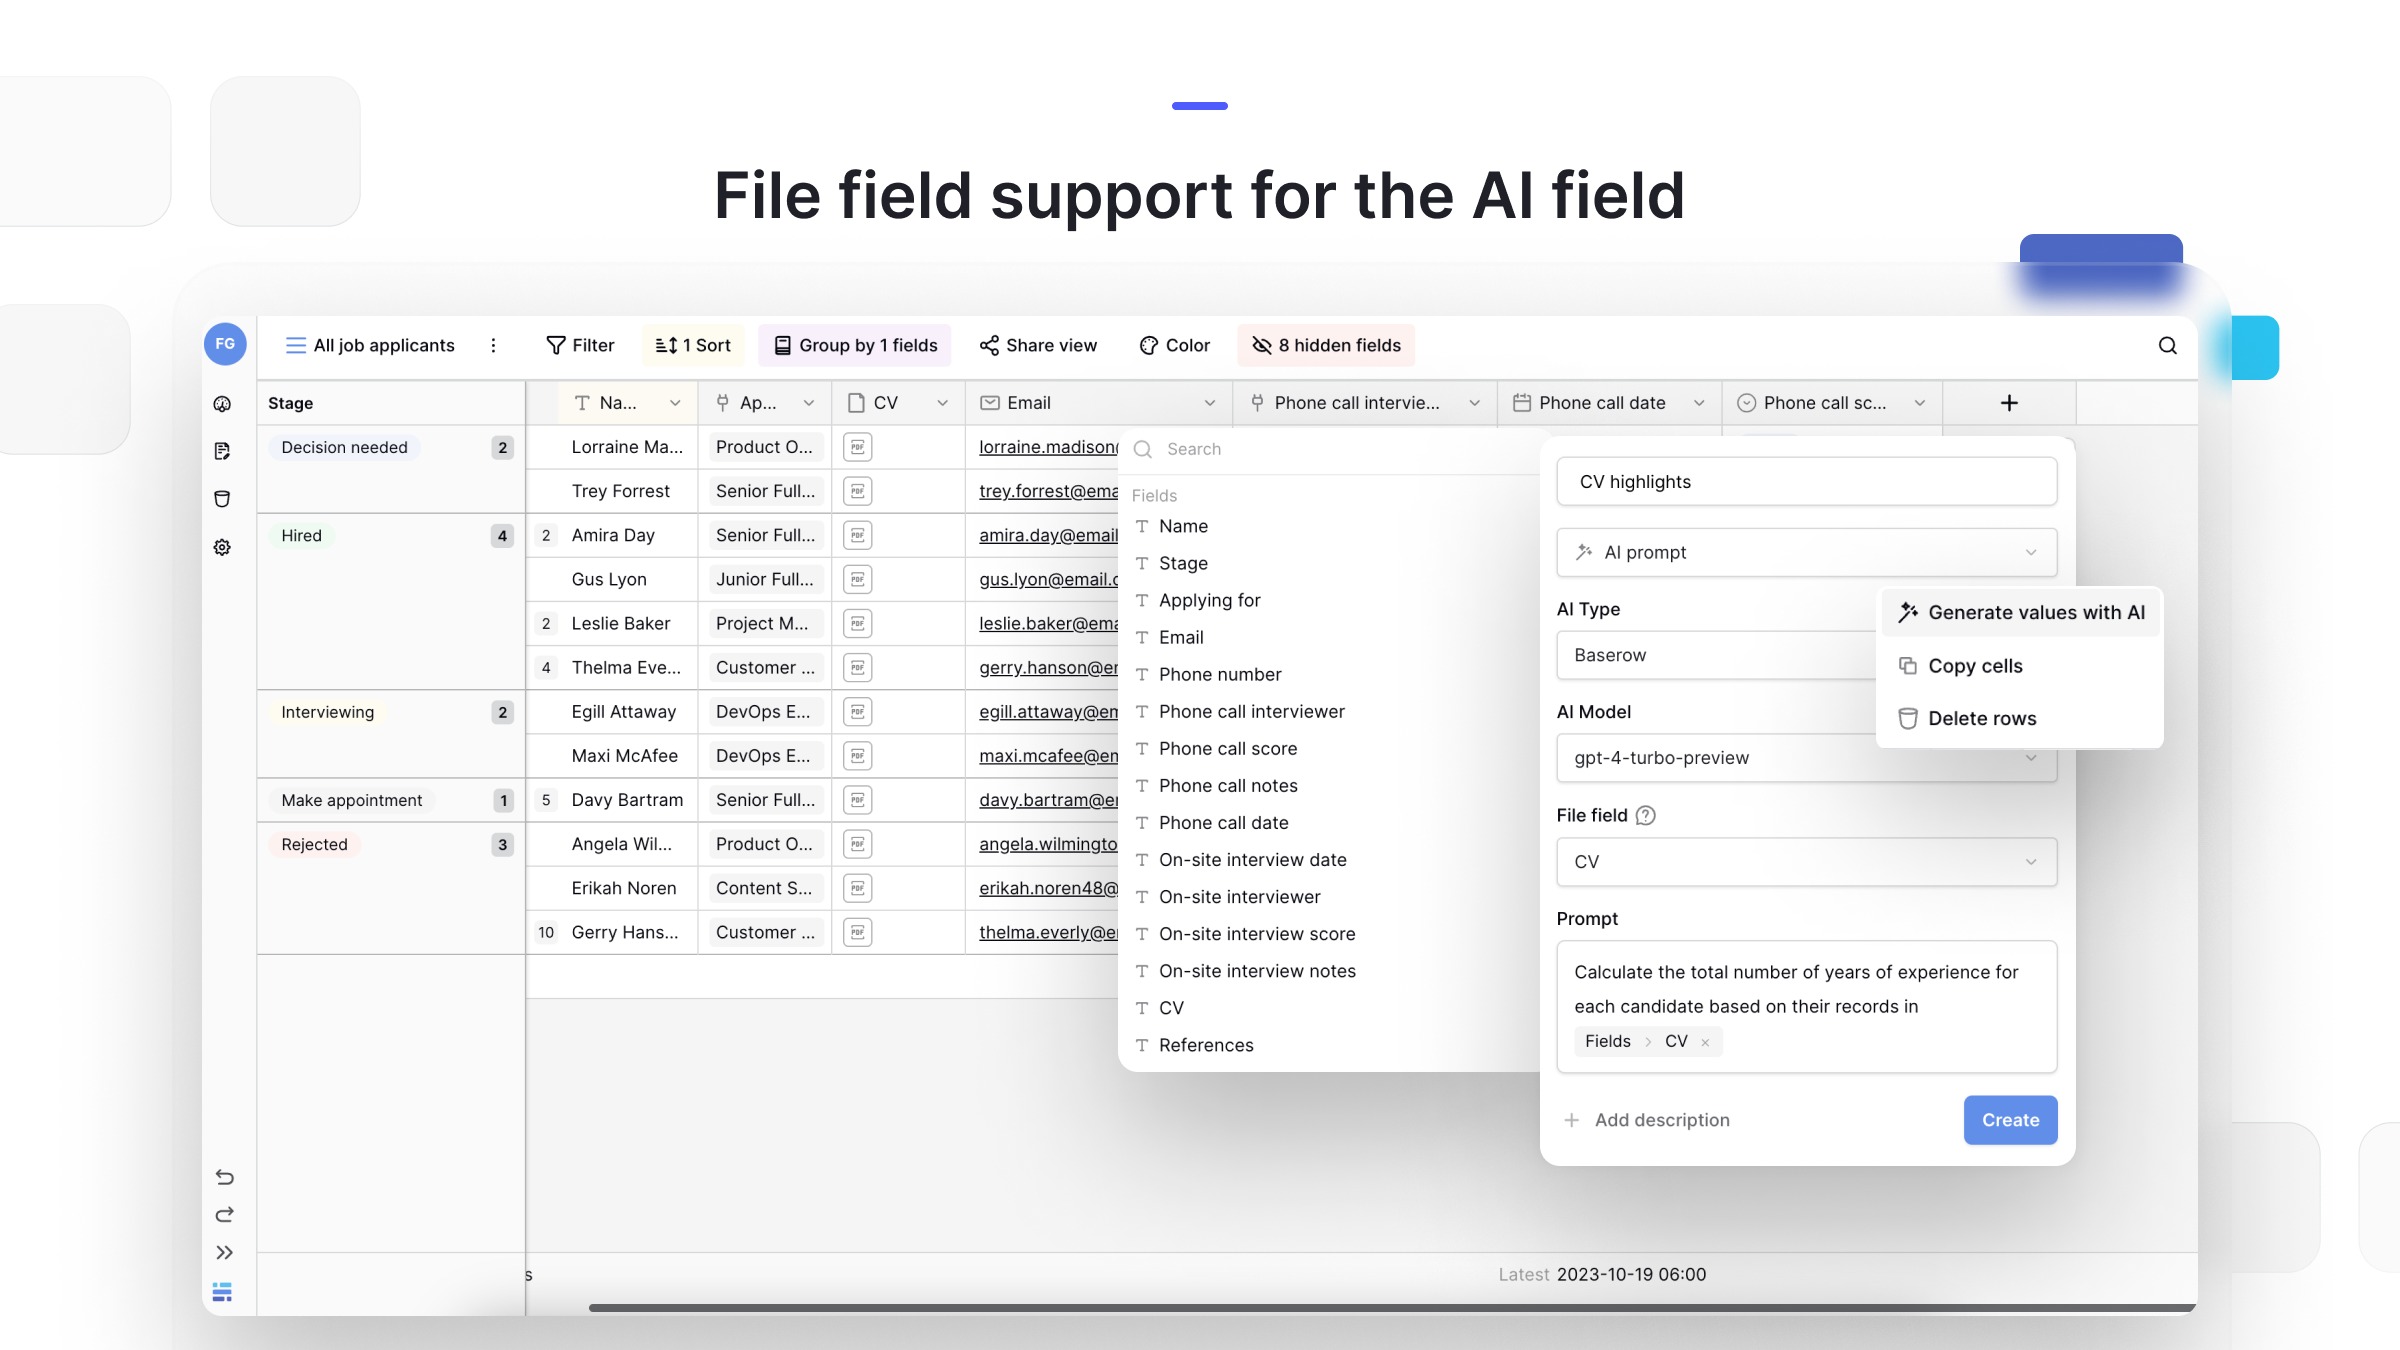
AI文件字段要求 Premium+,还需要实际模型支持相应文件输入。官方不同页面出现多文件与 first compatible file 表述,先以自己的版本实测读取范围。
3. 建立单附件基准行
先按 R1–R3 每行只放一个PDF,在 AI prompt 字段引用文件列。用 prompt.md 明确四个字段和缺值,不把多个附件混进第一轮。
4. 生成并逐项回读原页
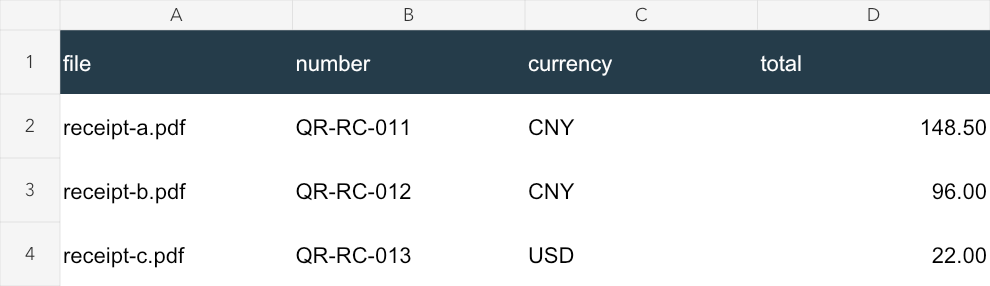
运行实际文件识别,逐行核对编号、日期、CNY/USD 和小数金额。出错后保留原始值与人工修正两个列,不能修正后声称初次提取准确。
5. 单独测试多附件顺序
建立 R4,依次附 receipt-b、receipt-a,记录版本、实际识别到的编号和读取范围;再换顺序做对照。官方表述差异未实测前不承诺一次分析全部附件。
6. 整理实际字段观察
按 actual-template.json 填三份实际结果,selection_test 单独保留实际说明。脚本检查文件归属、币种与金额,不直接调用Baserow。
bash
bash
python3 verify.py --actual my-receipts.json7. 记录选择歧义和失败
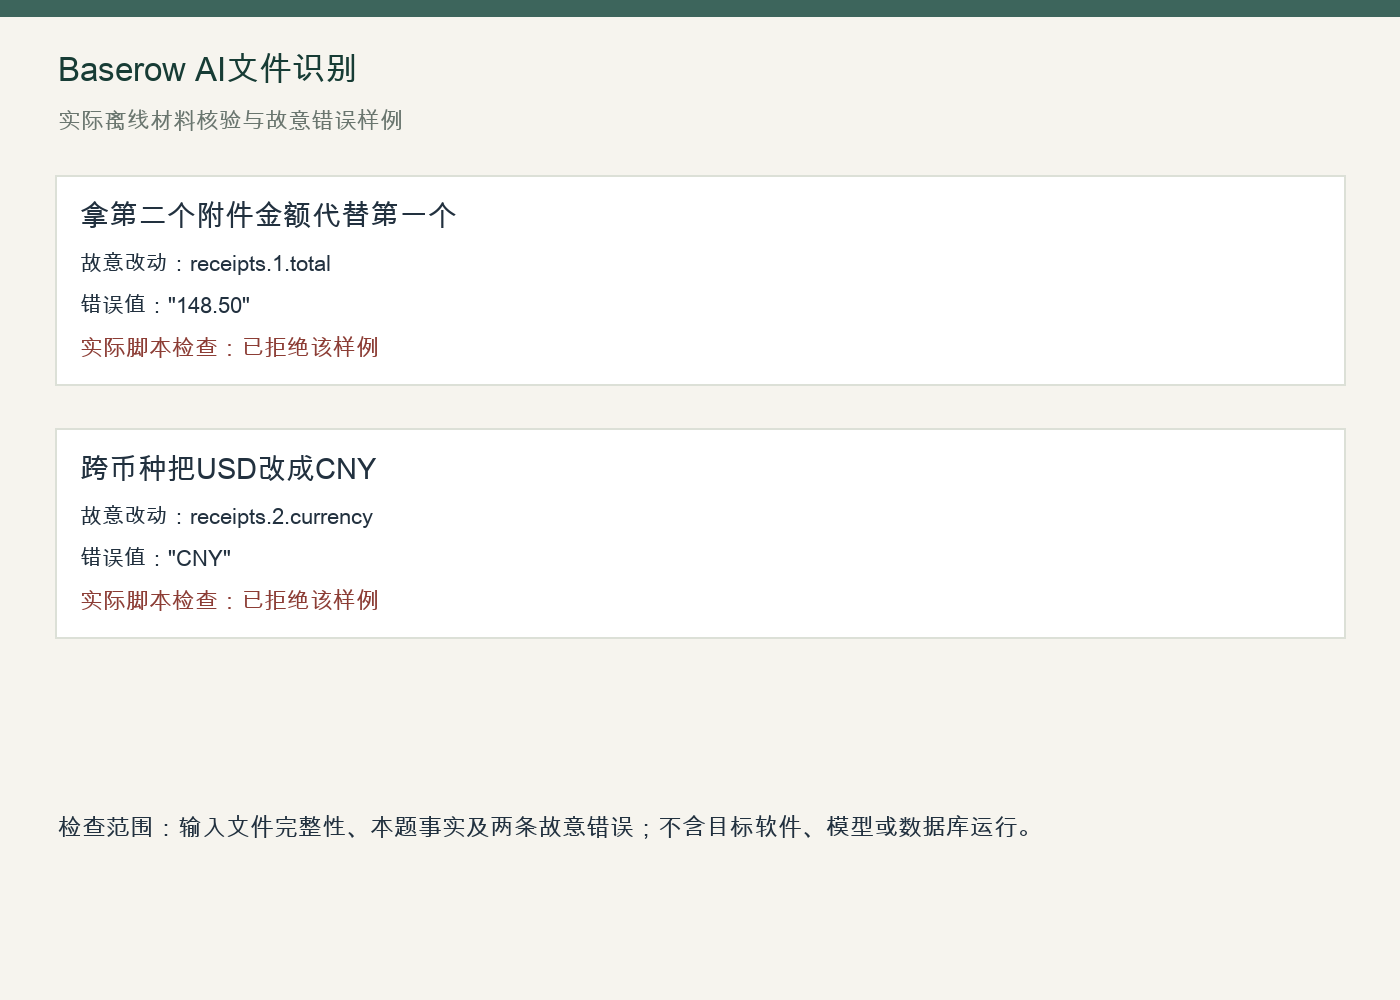
运行错附件金额与币种负例;下载包里的人工真值不能作为多附件支持的证明。本站只生成、渲染和核验教学PDF,未进行AI文件识别。
怎样确认已经完成
- 原始输入、来源和单位已保留,材料检查及两条故意错误样例均运行。
- 在真实工具保存原生输出,回读本题关键事实、缺值与来源;未运行部分仍标记未执行。
- 保存工具/模型版本和实际结果,人工修改与模型返回分开归档。
常见问题
Baserow AI文件识别需要哪些条件?
Premium+;模型文件支持及大小限制依实际 provider。OSE MIT,商业目录另有许可。本站未运行 Baserow。
Baserow AI文件识别的图片和检查通过代表什么?
原始输入、人工参考与实际离线材料检查均有对应文件;官方图说明操作入口。目标软件和模型未执行的部分已在步骤中注明,不能用材料检查替代真实产品运行。
Baserow AI字段在免费开源版就能用吗?
官方AI prompt field要求Premium及以上,模型使用还取决于provider与账户;OSE许可和商业功能可用性应分开检查。