
展开本页目录
开始前准备什么
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 核对规则与人工标签
- 隔离优化和留出材料
- 创建真正的DSPy程序
- 把错因写成可行动反馈
- 在授权环境启动GEPA
- 保存候选而非只截最佳分
- 只在最后打开测试集
1. 核对规则与人工标签
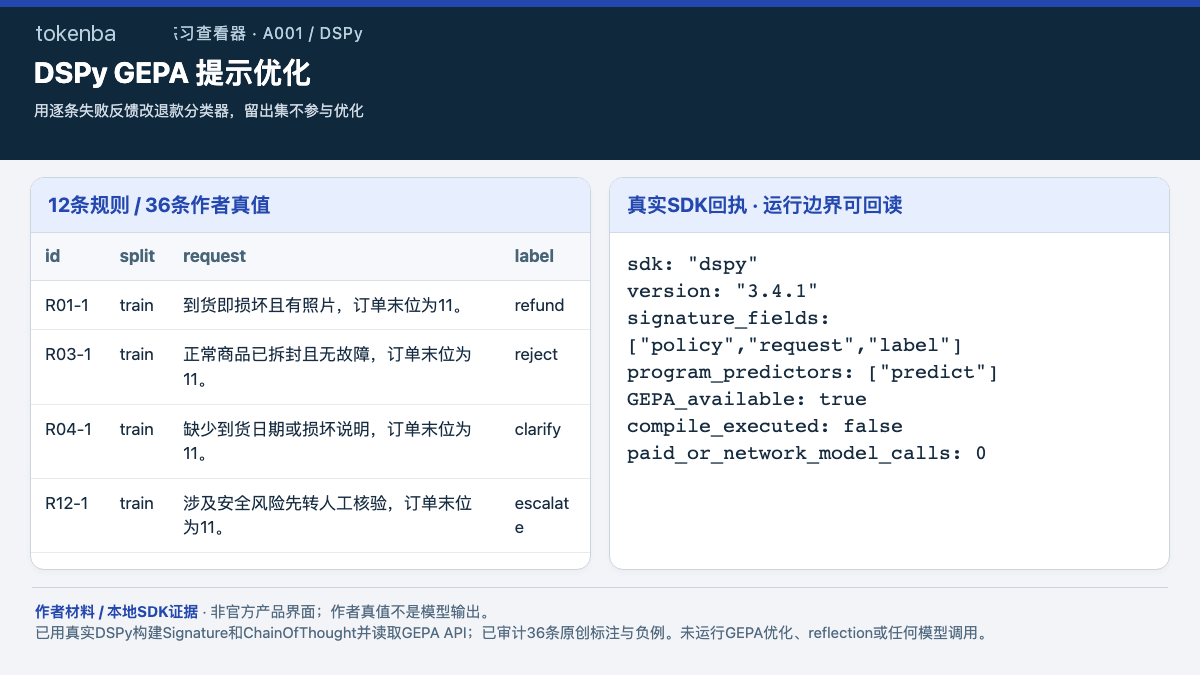
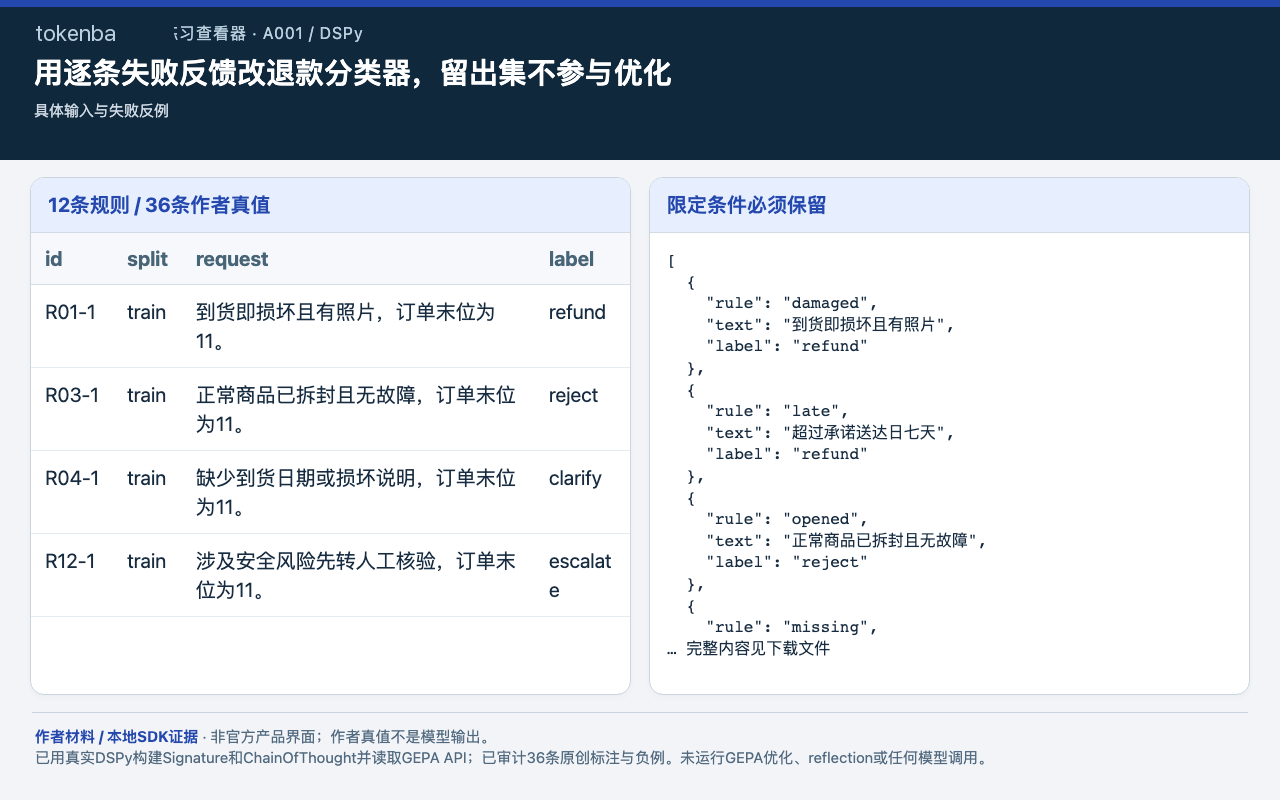
打开fixtures/policy.json和cases.json,特别读“无故障”“未拆封”“超过退货期但在保修期内”。36条标签是作者真值,不是模型预测。
2. 隔离优化和留出材料
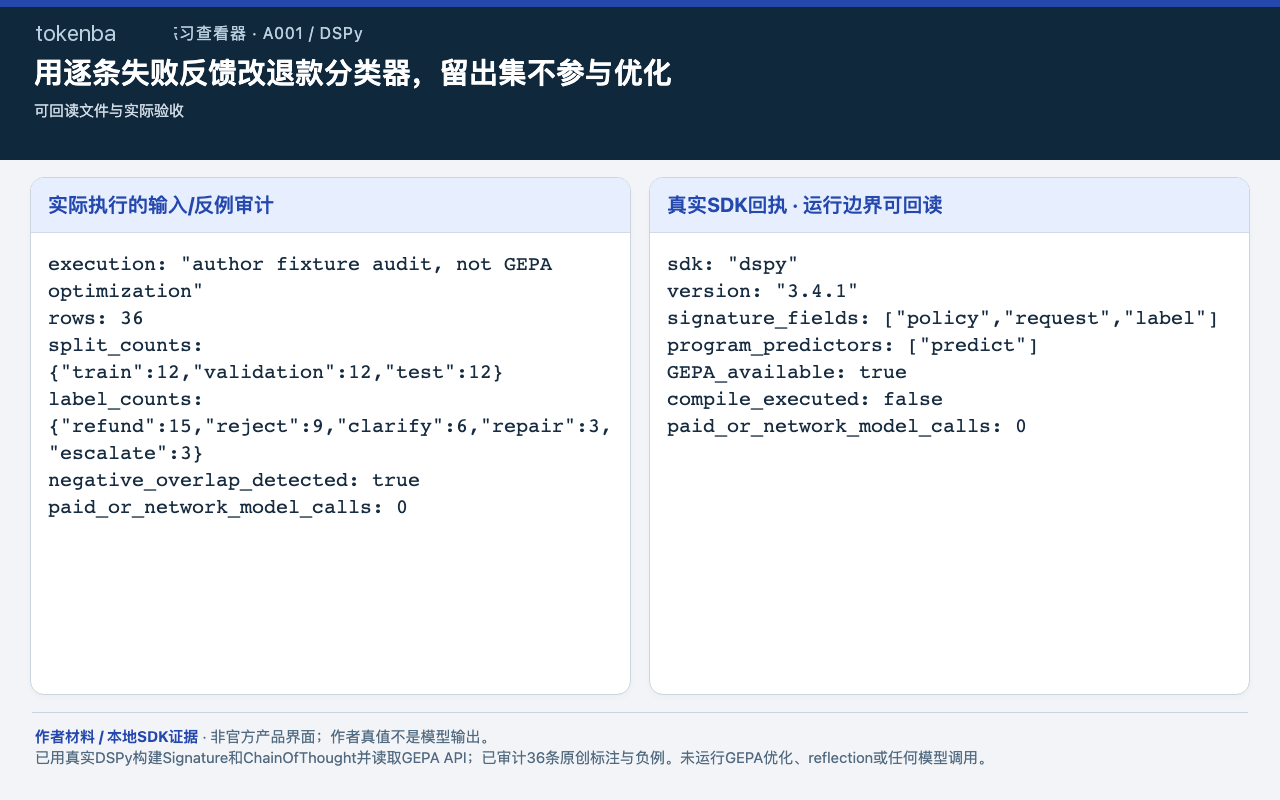
按split字段分为12条train、12条validation、12条test;先运行reference/audit.py。故意重叠ID的negative-overlap.json必须被识别,测试答案不要交给优化器。
本题独立目录执行
python reference/audit.py3. 创建真正的DSPy程序
运行reference/run_sdk.py确认本机DSPy版本、Signature字段及GEPA构造签名。程序将policy与request分开输入,输出label,避免把标签写在请求里。
本题SDK或目标环境入口
python reference/run_sdk.py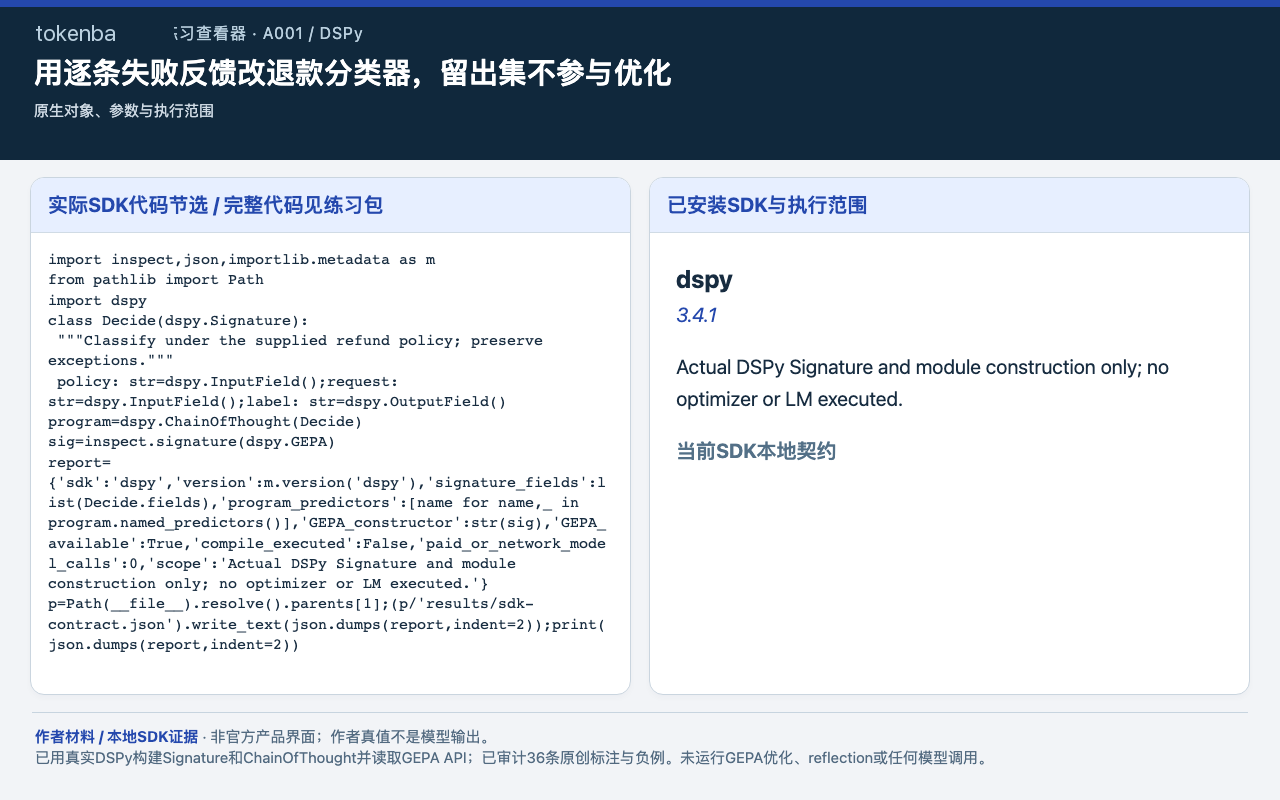
4. 把错因写成可行动反馈
metric应先核对pred.label,再返回score与具体feedback;指出漏看的限定条件而非只写“错了”。GEPA适配不同版本时,以sdk-contract.json里的签名和官方metric_with_feedback示例为准。
5. 在授权环境启动GEPA
安装与已记录版本一致的DSPy,配置自己的LM与reflection_lm;将训练与验证examples分开传入compile,设置明确的metric调用上限。本文未配置凭据或执行compile。
6. 保存候选而非只截最佳分
保存优化后程序、每轮候选反馈与全部请求计数;达到预算时保留未完成状态。不能将fixture-audit的标签分布当成优化后准确率。
7. 只在最后打开测试集
重载已保存程序后运行12条test,再按label做混淆矩阵。把原程序与优化程序的失败逐条列出;GEPA不保证每次提升,缺真实推理结果就记录未测。
怎样确认已经完成
- 优化集和留出集ID无交集
- 错例反馈保留原话
- 不保证提高
- 已用真实DSPy构建Signature和ChainOfThought并读取GEPA API;已审计36条原创标注与负例。未运行GEPA优化、reflection或任何模型调用。
常见问题
GEPA怎么利用错误原因自动改提示词?
让指标返回错误原因并由GEPA利用反思改写候选,再用独立验证集比较。包内只验证数据边界与SDK接口,没有跑优化模型。
DSPy优化提示词时怎么防止测试集泄漏?
按规则或业务组拆分训练、调参和最终测试;固定测试集,检查ID与近重复交叉。不能看过测试答案后再把它当未见测试。
这篇教程哪些步骤已经真正执行?
已用真实DSPy构建Signature和ChainOfThought并读取GEPA API;已审计36条原创标注与负例。未运行GEPA优化、reflection或任何模型调用。