
展开本页目录
开始前准备什么
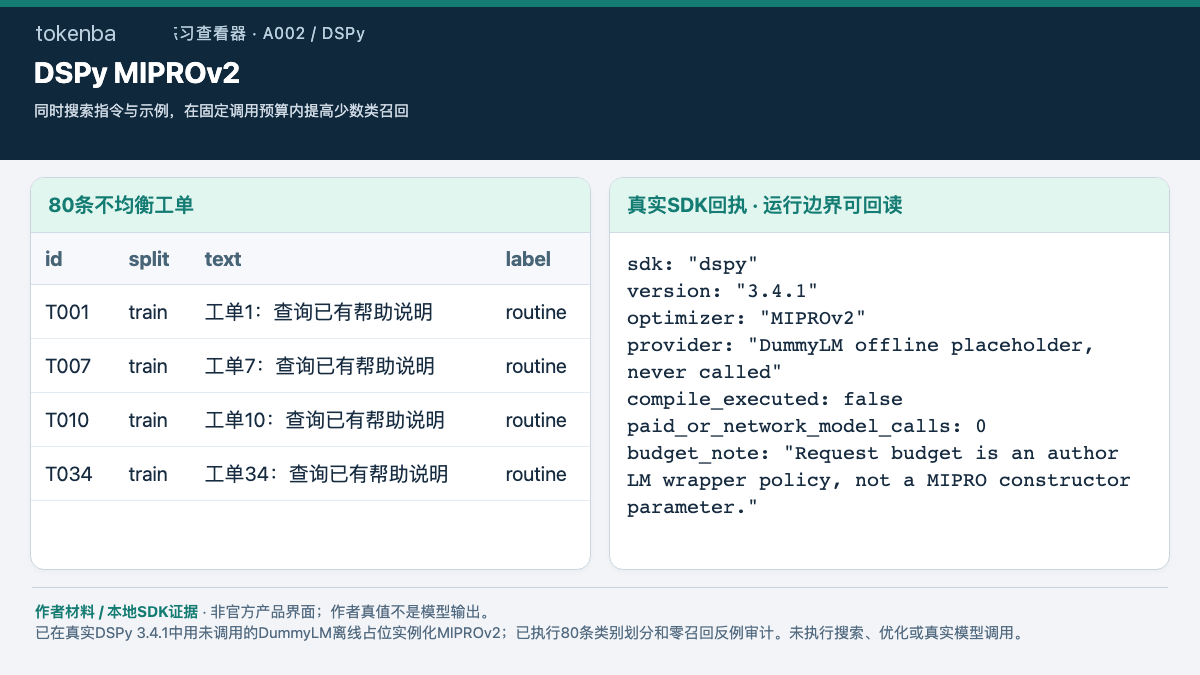
- 下载完整练习包,在独立目录阅读README与已执行范围。
- 安装requirements.txt指定版本或使用文中目标工具;依赖与模型权重不要混入网站工程。
- 只有明确标为已执行的部分有本次证据;真实模型、账号或GPU步骤按自己的环境另行验证。
- 查看真实的类别分布
- 建立零召回反例
- 实例化MIPROv2并核对签名
- 分开指令与示例候选
- 把预算放在实际LM调用处
- 执行小规模搜索并保存轨迹
- 用独立测试复核少数类
1. 查看真实的类别分布
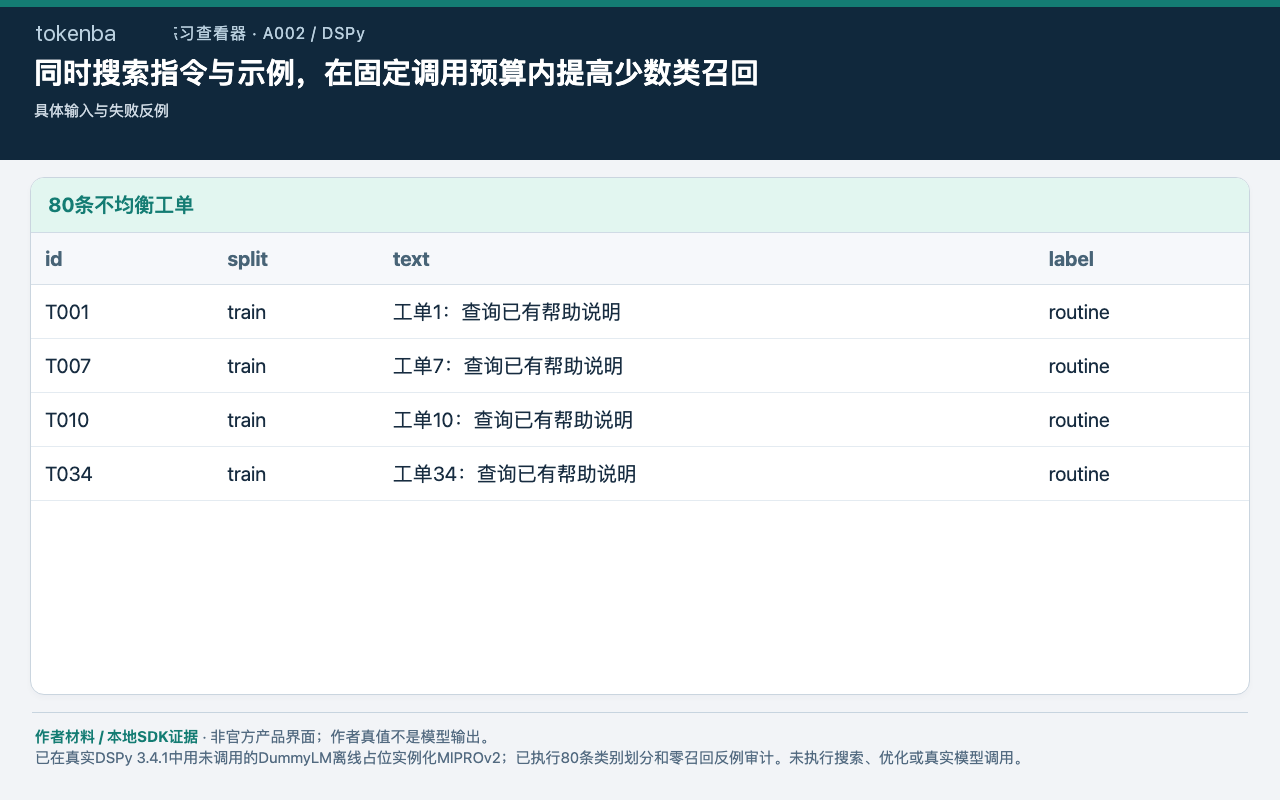
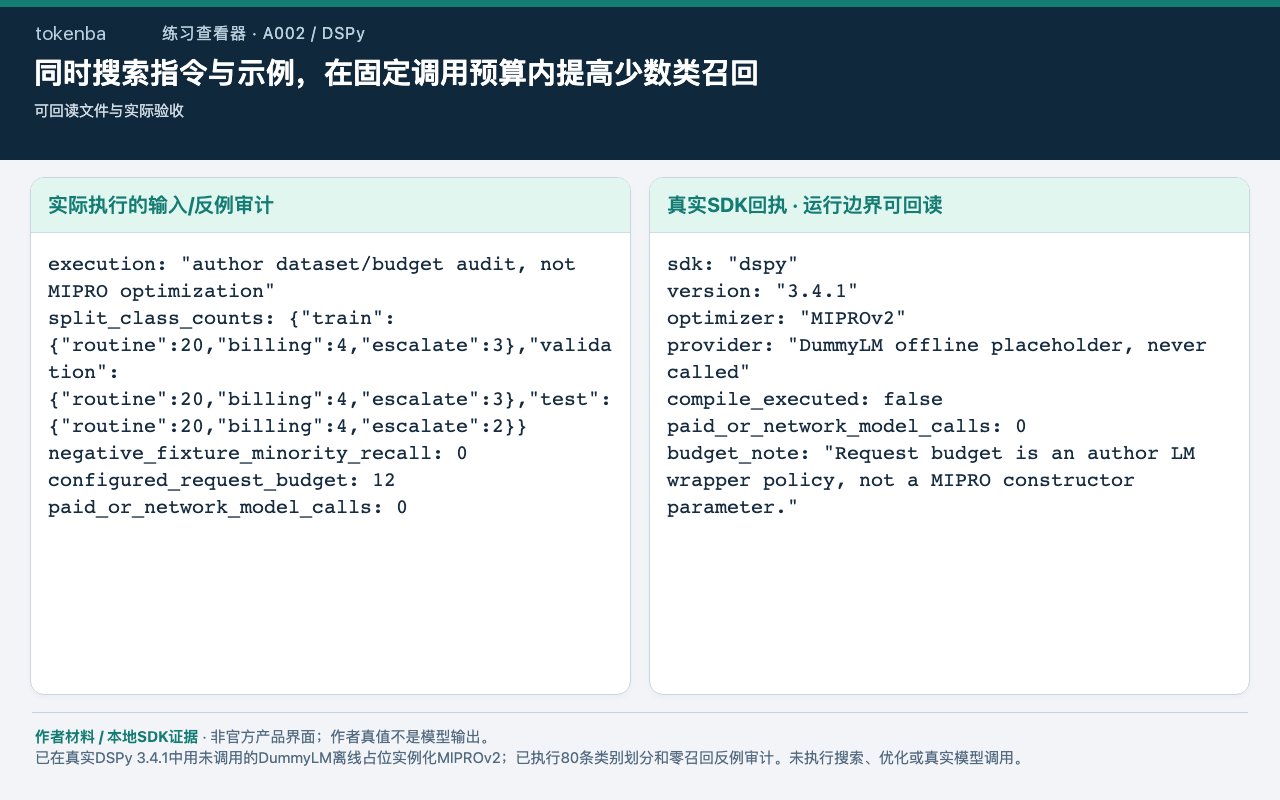
tickets.json有80条作者工单,routine 60、billing 12、escalate 8。先看每个split是否都有escalate,不能拿整体准确率掩盖少数类漏报。
2. 建立零召回反例
failure-predictions.json故意把两条escalate都预测为routine。运行reference/audit.py应得到少数类召回0;这些是作者反例,不是MIPRO的真实输出。
本题独立目录执行
python reference/audit.py3. 实例化MIPROv2并核对签名
运行reference/run_sdk.py,用SDK自带的DummyLM离线占位来实例化MIPROv2(auto=None,num_candidates=2)。不设置prompt/task LM会被当前版本拒绝;离线占位没有被调用,更不生成候选。保存compile签名。
本题SDK或目标环境入口
python reference/run_sdk.py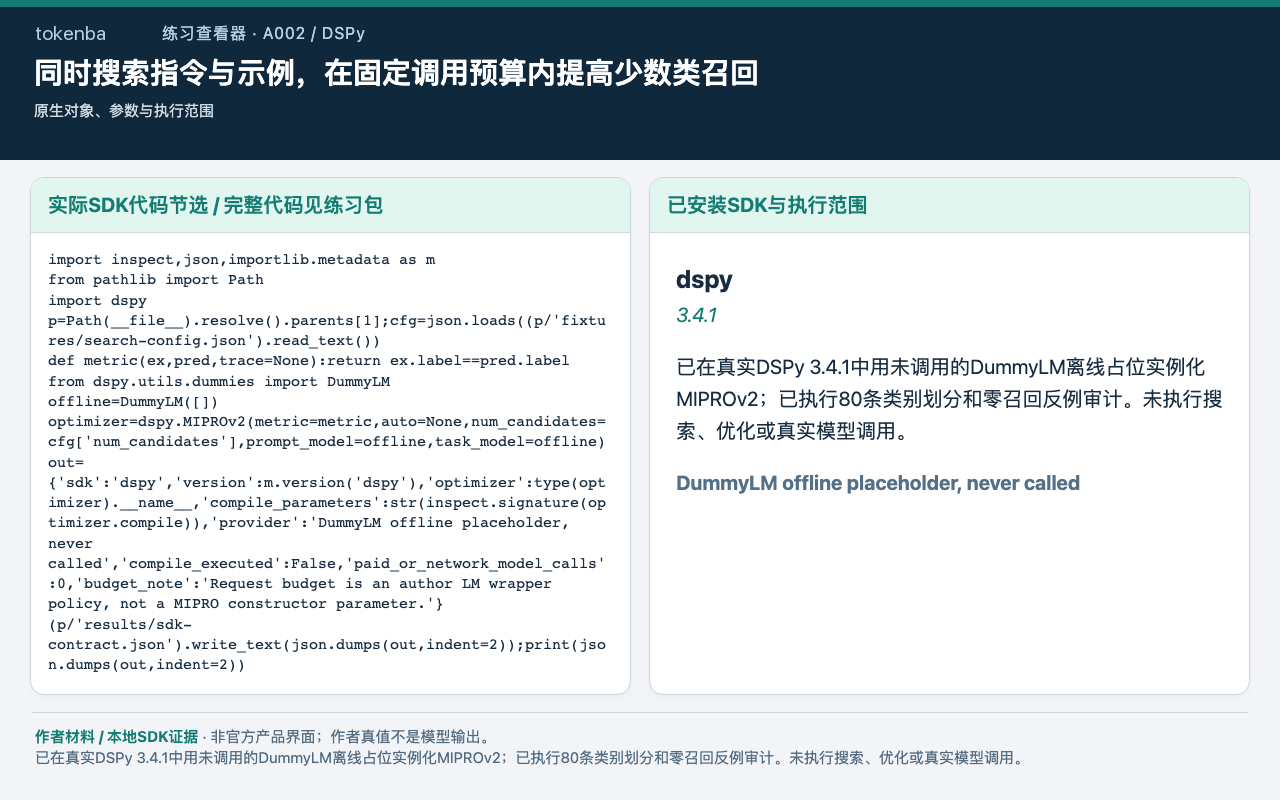
4. 分开指令与示例候选
search-config.json分别限制候选数、labeled demos和bootstrapped demos。指令只描述任务,示例必须来自train;validation用于搜索评分,test不参与提案。
5. 把预算放在实际LM调用处
request_budget是作者执行政策,不是MIPRO原生参数。授权实跑时在LM包装层计数,每次真实provider请求前检查上限;命中缓存、失败和重试分别登记。
6. 执行小规模搜索并保存轨迹
在有可用模型的环境调用compile,先用4个num_trials和小批验证。当前包只完成数据审计和optimizer实例化,没有候选搜索结果或费用结论。
7. 用独立测试复核少数类
保存并重载最佳程序,最后对test逐条推理。报告各类别TP/FN、escalate召回、整体准确率和全部调用数;超过12次预算时应停止并报告未完成。
怎样确认已经完成
- 少数类样本数可回读
- 候选不接触测试答案
- 超预算停止
- 已在真实DSPy 3.4.1中用未调用的DummyLM离线占位实例化MIPROv2;已执行80条类别划分和零召回反例审计。未执行搜索、优化或真实模型调用。
常见问题
MIPROv2怎么同时优化指令和示例?
MIPROv2搜索指令与few-shot示例组合,并在指定任务指标上比较。本文实际只构造优化器,DummyLM占位不调用,未执行compile。
DSPy分类样本不均衡,怎么检查少数类召回?
单独统计少数类TP/FN和召回。包内两条escalate都被routine覆盖,少数类召回0;总体准确率高也不能掩盖。
这篇教程哪些步骤已经真正执行?
已在真实DSPy 3.4.1中用未调用的DummyLM离线占位实例化MIPROv2;已执行80条类别划分和零召回反例审计。未执行搜索、优化或真实模型调用。