
展开本页目录
开始前准备什么
- ElevenLabs Studio可用账号/额度;输出用途按计划条款。Studio帮助页与API页对phoneme模型范围列举不同,首练只用alias;API需传字典ID与version locator。
- 解压本页独立练习包,先读README中的素材身份与执行范围;保留原文件并另存实际结果。
- 圈出三次虚构专名
- 在Studio新建短项目
- 打开Pronunciations Editor
- 首轮只添加alias规则
- 确认项目关联后生成A/B
- 三次出现分别回听
- 导出字典并分清API传参
原创输入、提示/参数、7步README、来源与检查表;无模型权重或账号。
分清真实输入、程序参考与待运行的模型输出。
用实际输出填写每一项,不把本地文件检查当效果验收。
教学记录格式,软件原生导入能力另行确认。
1. 圈出三次虚构专名
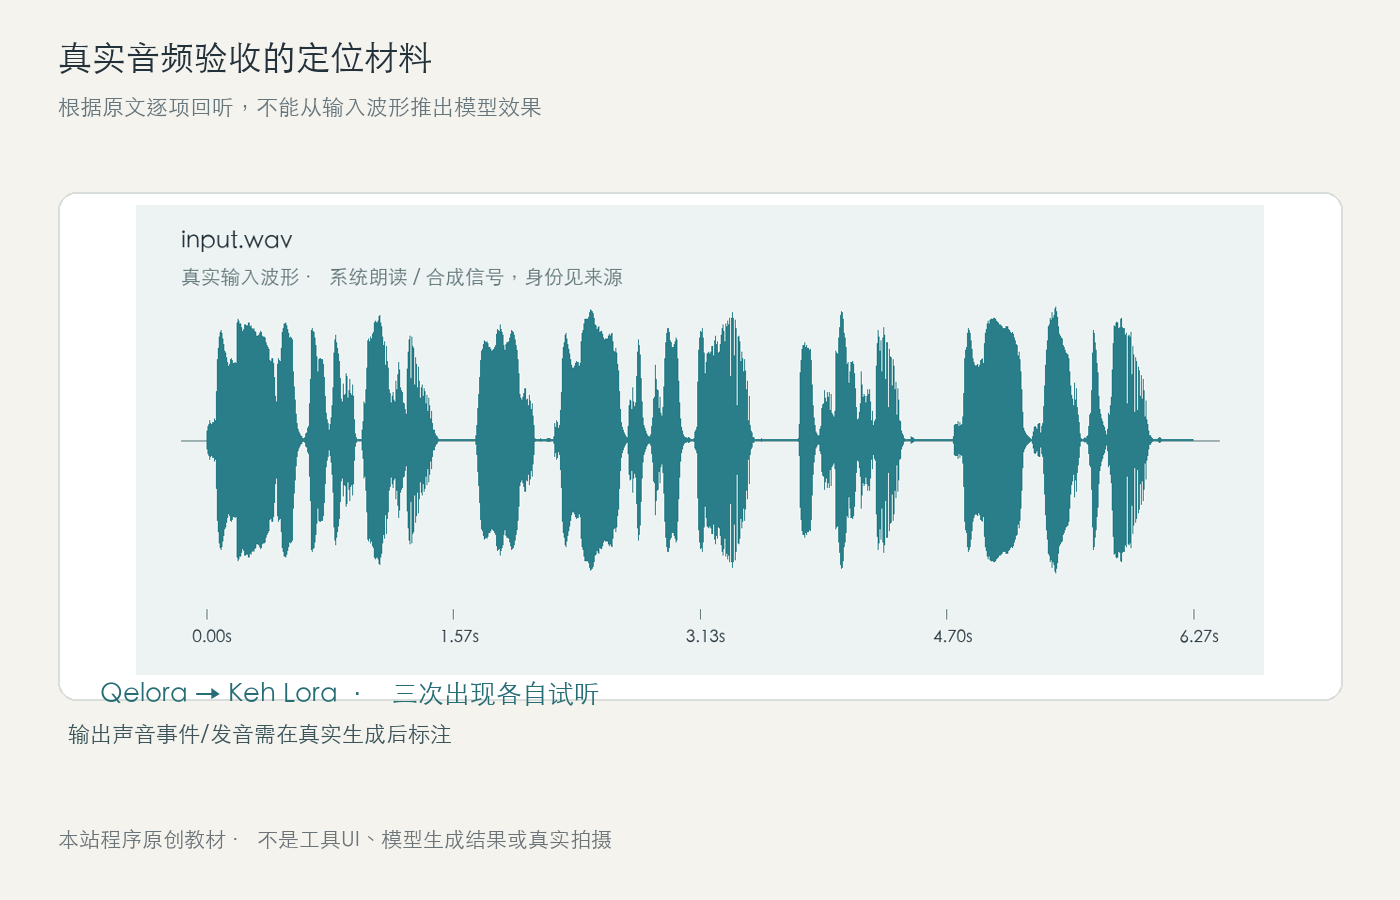
script.txt中虚构角色名Qelora出现三次,expected-reading.txt记为keh-LOR-ah;缩写另列,避免同时测试很多未知读法。input.wav是系统朗读审稿参考,不是ElevenLabs默认读法。
2. 在Studio新建短项目
把同一份script.txt导入Studio,选定可用voice和模型并先保存不带规则版本。网页项目不是通用聊天API请求,不能把专有功能靠改Base URL接到任何渠道。
3. 打开Pronunciations Editor
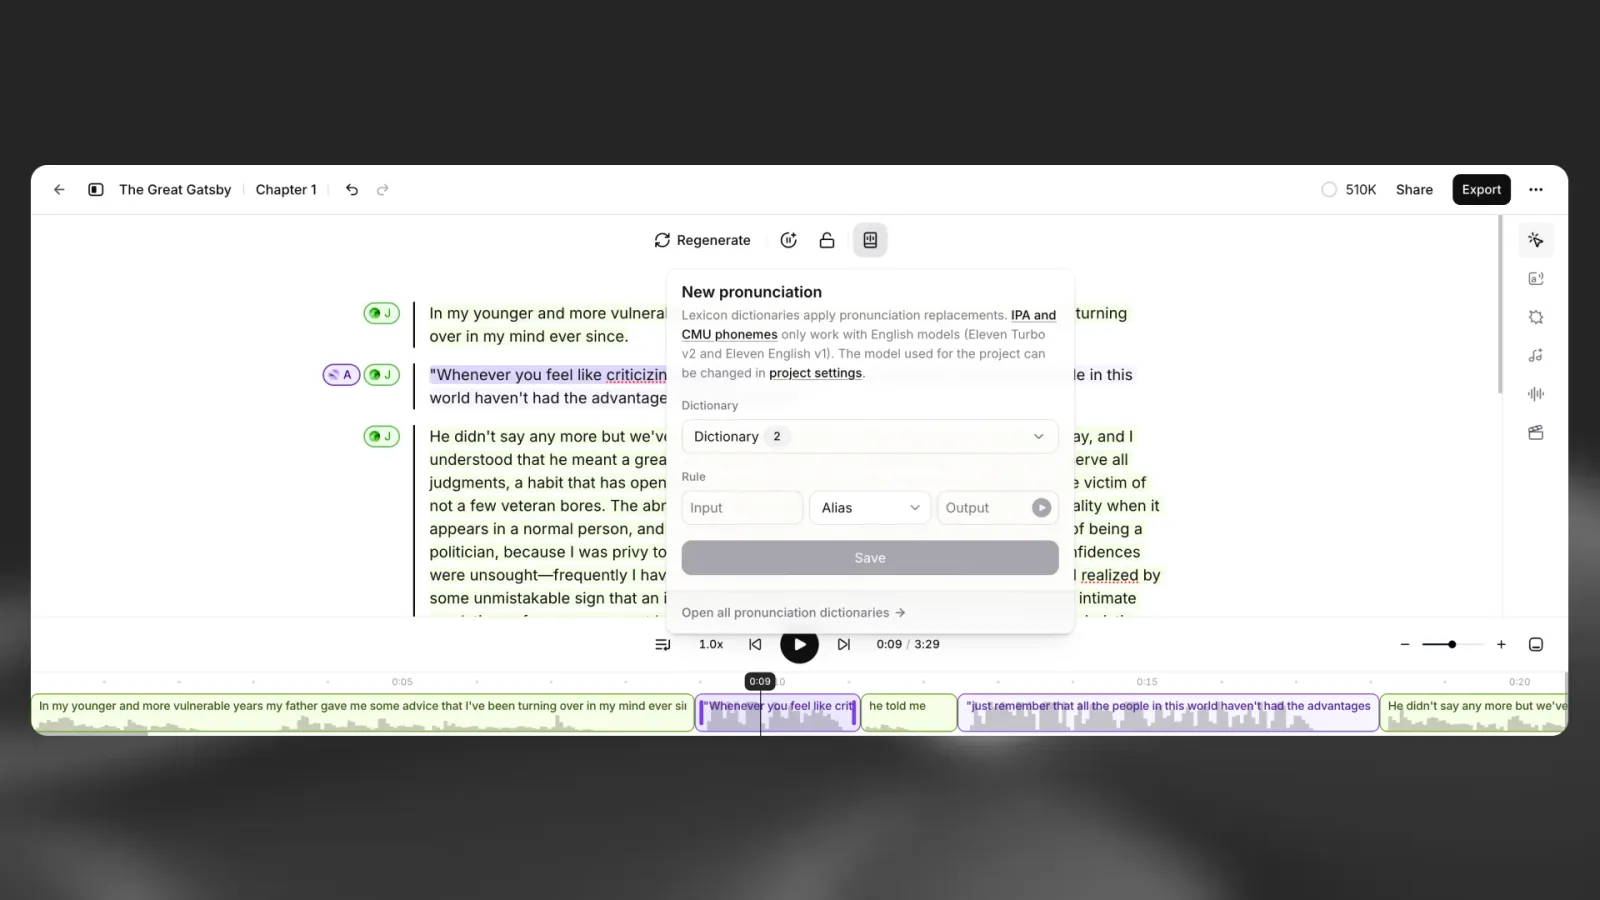
选中角色名后打开编辑器,确认输入框为完整Qelora。根据官方帮助页新建字典或选择已有字典;不要改正文拼写来掩盖字典没有关联项目。
4. 首轮只添加alias规则
用dictionary-rules.json里的string_to_replace和alias概念填写网页字段,把Qelora替换为有助发音的拼写。它是本题规则清单,不是保证可直接导入Studio的原生文件。
prompt.txt
Qelora opened the station. We asked Qelora to check the map. At sunset, Qelora closed the gate.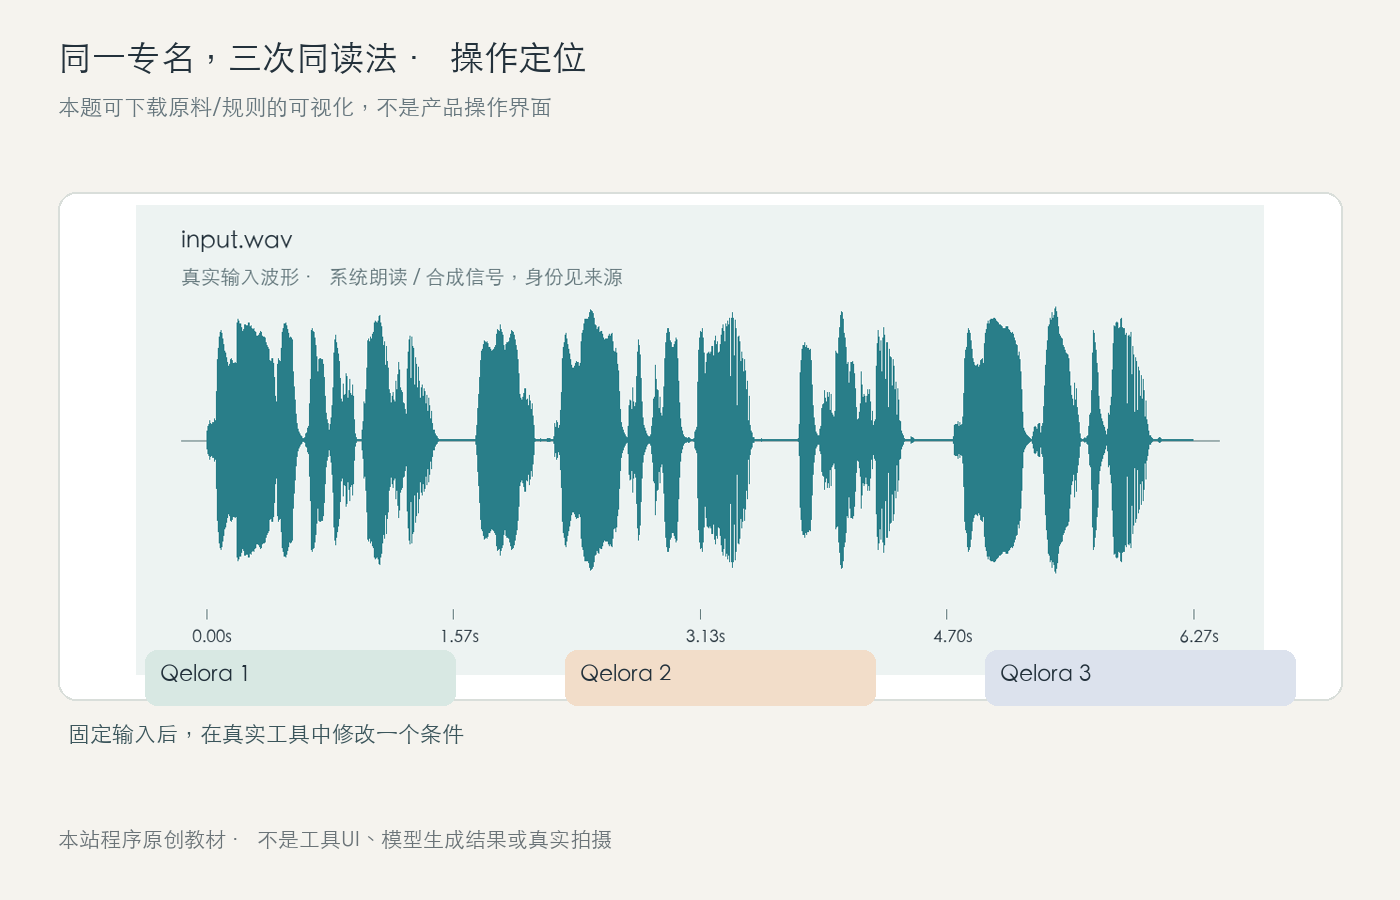
5. 确认项目关联后生成A/B
先播放编辑器预览,再生成同稿同声音的无规则/有规则两版,保存实际模型和字典版本。phoneme的支持依模型,不因为界面有按钮就假设每个模型都处理。
6. 三次出现分别回听
按occurrences.csv核对开头、中间、结尾是否均读成预期,检查规则没有误命中其他词。不要只听预览一次就认定整篇都一致;专名自然度仍需人工判断。
7. 导出字典并分清API传参
保存真实字典ID/version和台词,API路径按官方SDK传pronunciation_dictionary_locators。Studio项目设置不会自动随普通TTS请求带入;包内没有真实账号、Key或在线字典ID。
怎样确认已经完成
- 同稿三次专名均单独试听,规则没有误伤其他词。
- A/B保持同voice/model,字典关联与版本可回读。
- 本地规则清单不是在线字典,API显式传locator。
常见问题
AI配音品牌名总读错怎么办,这篇从哪里开始?
先用第1步的具体输入,再按照ElevenLabs Studio原生入口操作。用dictionary-rules.json里的string_to_replace和alias概念填写网页字段,把Qelora替换为有助发音的拼写。它是本题规则清单,不是保证可直接导入Studio的原生文件。
同一个角色名每段读得都不一样,怎么确认结果真的完成?
同稿三次专名均单独试听,规则没有误伤其他词。 A/B保持同voice/model,字典关联与版本可回读。 结构回读不代替播放、试听或逐处检查。
ElevenLabs 发音字典是否需要apizt API?
本题主要使用工具原生本地或官方网页能力,不要求apizt Key。ElevenLabs Studio可用账号/额度;输出用途按计划条款。Studio帮助页与API页对phoneme模型范围列举不同,首练只用alias;API需传字典ID与version locator。
ElevenLabs Studio的英文资料应该搜什么?
可用“ElevenLabs Studio pronunciation dictionary alias phoneme project”查找对应能力;先确认官方来源中的模型/工作流,再核对本文输入和实际输出,不套用同名第三方服务参数。