
Qwen3-TTS 声线设计:原创角色声音复用
载入 VoiceDesign 而非 Base,用固定台词和原创成年角色描述比较两条声线。选定后建立复用提示,再用新句子检查一致性;练习中的系统朗读不是设计声线或克隆结果。
阅读文章正在打开页面…
正在加载内容,请稍候。
114 篇教程,当前显示第 1–48 篇。选择页码继续浏览,或切换任务主题。
载入 VoiceDesign 而非 Base,用固定台词和原创成年角色描述比较两条声线。选定后建立复用提示,再用新句子检查一致性;练习中的系统朗读不是设计声线或克隆结果。
阅读文章
开启word_timestamps=True,遍历segments保存单词start/end/word/probability。附CPU示例与已有tiny实测,区分句级SRT、逐词高亮和人工对齐。
阅读文章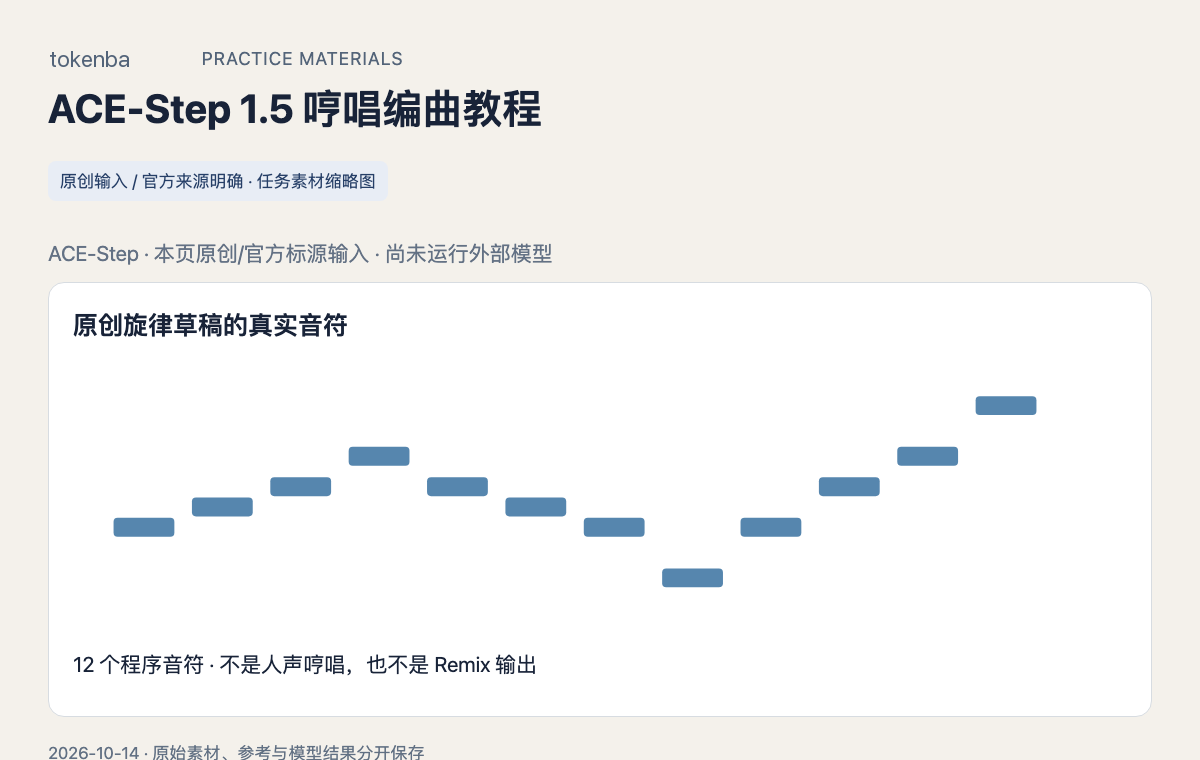
apizt 的 ACE 代理探测当前返回404,故本例按实际支持范围使用官方 ACE-Step 1.5 本地 Cover API:8秒原创程序旋律经4步CPU BF16推理得到48kHz WAV,耗时约308秒。输入是程序旋律,不能写成本人哼唱实测。
阅读文章
通过 apizt 的 gpt-audio-2025-08-28 实际输入原创合成语音,得到新的 WAV。另一次 Whisper 请求识别出原台词,但原音约7.17秒、结果约9.3秒,不能宣称时间与停顿完全保留。
阅读文章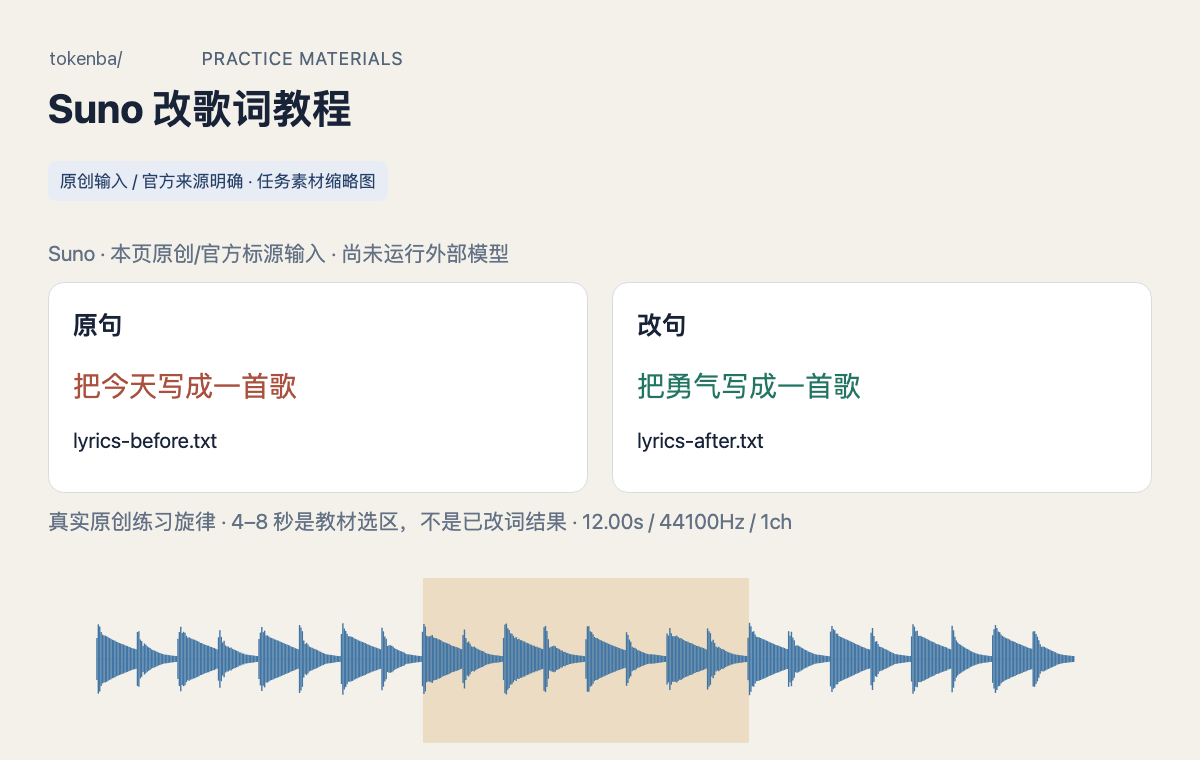
apizt实际生成原曲后,task=infill请求虽返回200,却输出34秒整首新版本,未证明原生局部替换。本例保留这个负例,再从真实新版本截取目标句,在18.8—23.3秒范围内做本地交叉淡化替换;读回验证区间外PCM逐样本一致,合成结果可下载。
阅读文章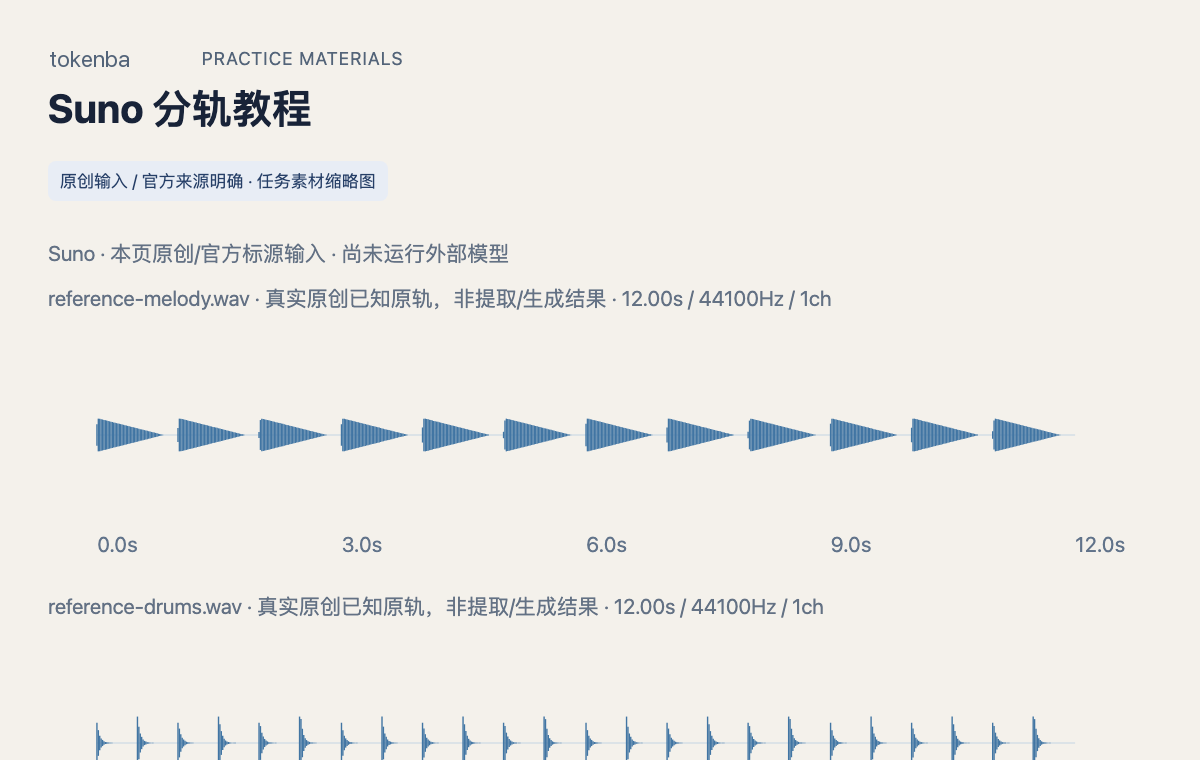
先通过 apizt 获得原创 Suno 歌曲,再使用真实 htdemucs 神经分离,导出 vocals、drums、bass、other 四条 WAV,并核对同起点、采样率、帧数和重合成差异。这是本地分轨路线,不是 Suno 网页 Get Stems 的直接导出。
阅读文章
用apizt抽取四封虚构发票邮件,再在本地SQLite验证幂等写入与回读:零税额保留,缺税额与金额冲突挂起,同附件转发不重复插入。模型漏掉重复邮件行的原输出保留,源邮件去重由程序控制,不能交给模型隐式决定。
阅读文章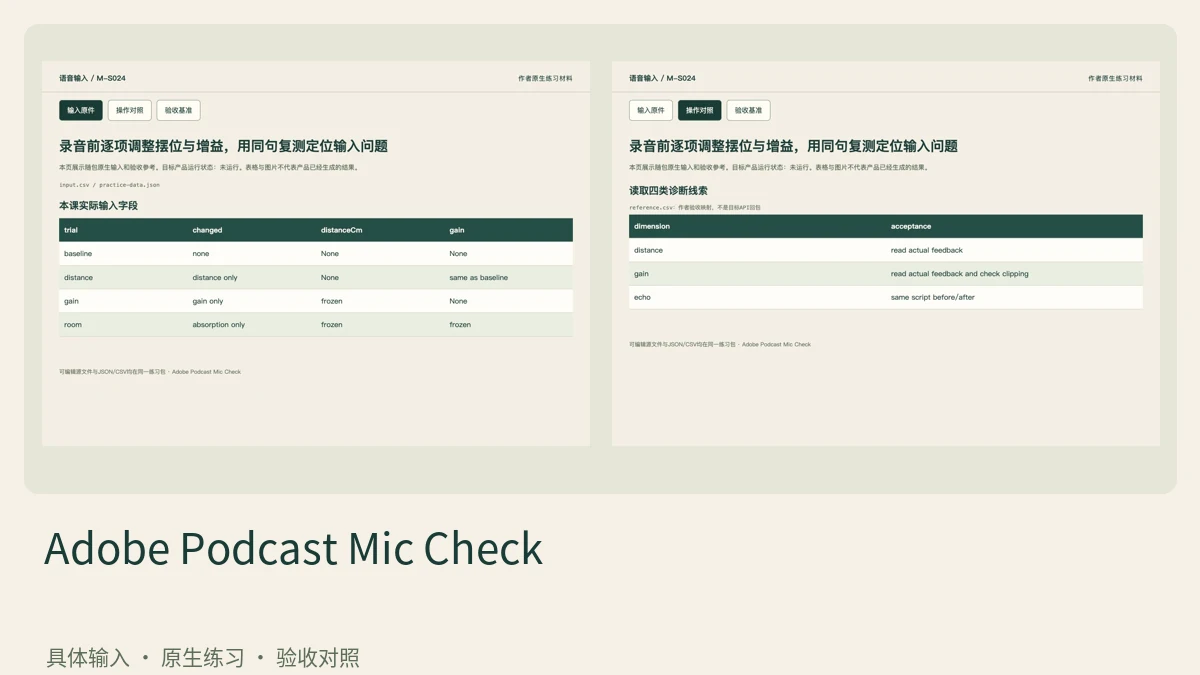
选择真实输入设备,用同一句台词录基线,读取距离、增益、噪声与回声反馈,再一次只调一个条件复测。保存实际诊断,不把 Mic Check 当作已经清理录音的输出文件。
阅读文章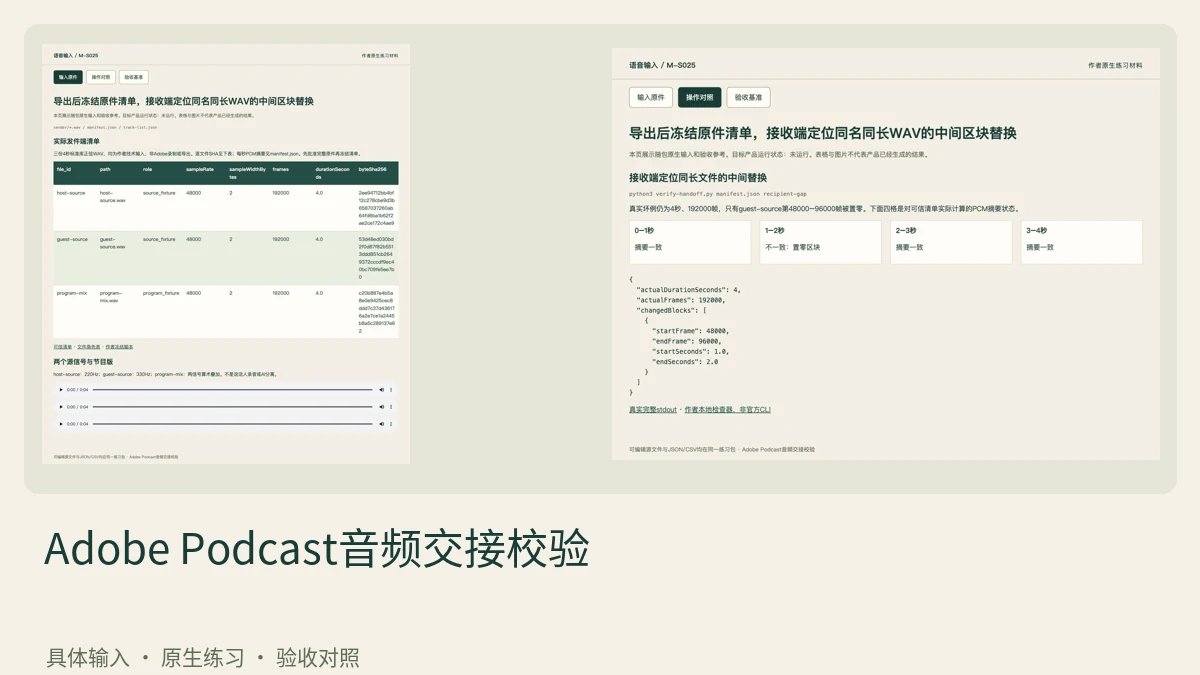
由发件端在导出后冻结可信 SHA-256 清单,区分节目版与各说话人原轨;接收端按路径逐件复算。整文件不一致时再定位区块,重新拿回正确源轨;本页合成样例不是 Adobe 远程录音实测。
阅读文章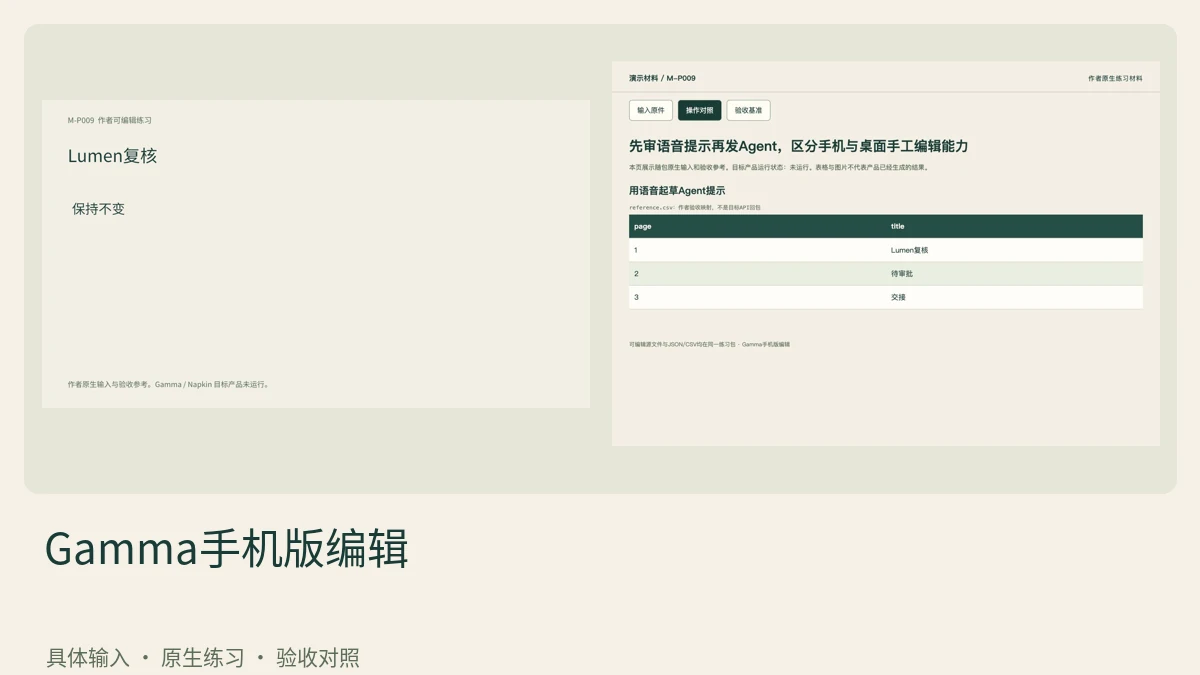
先确认当前移动 app/网页能力,把“只改第二页标题”录为待发送草稿并修正识别词。交给 Agent 后比较各页,保持其它事实;不要虚构手机端桌面式双击改字能力。
阅读文章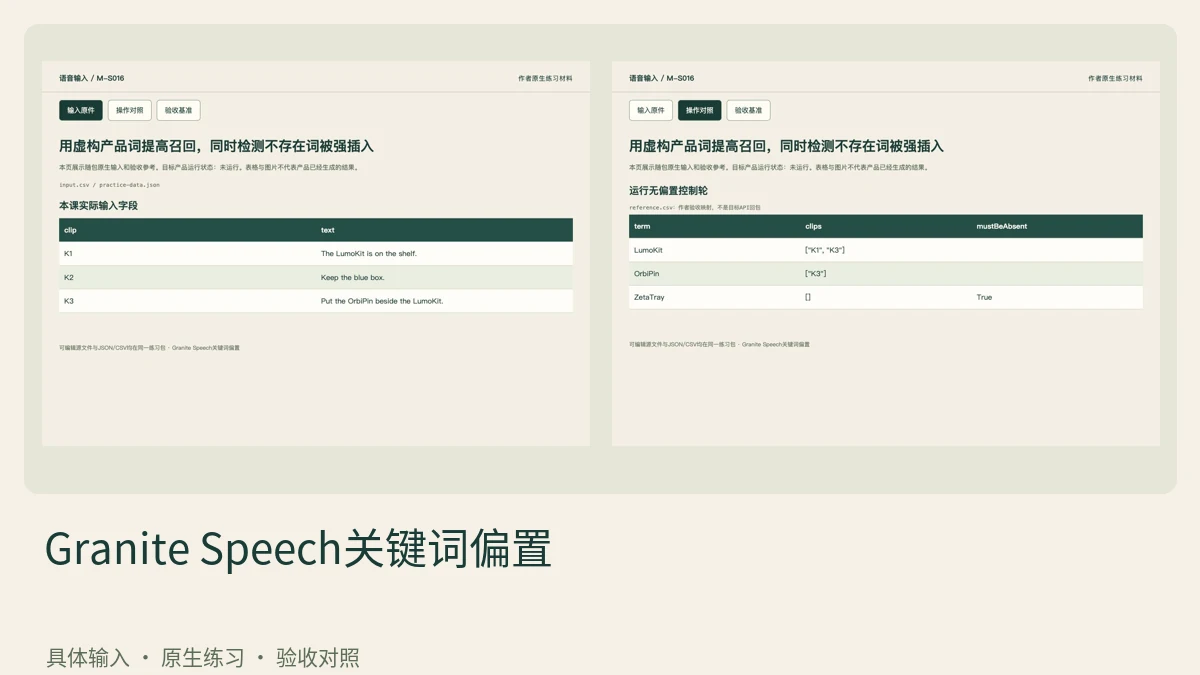
用含词与缺席词两类同源音频先跑无偏置基线,再只添加实际支持的关键词提示。分别统计命中和不存在词被插入的情况;基线本来正确也如实保留,不能人为改坏来制造改善。
阅读文章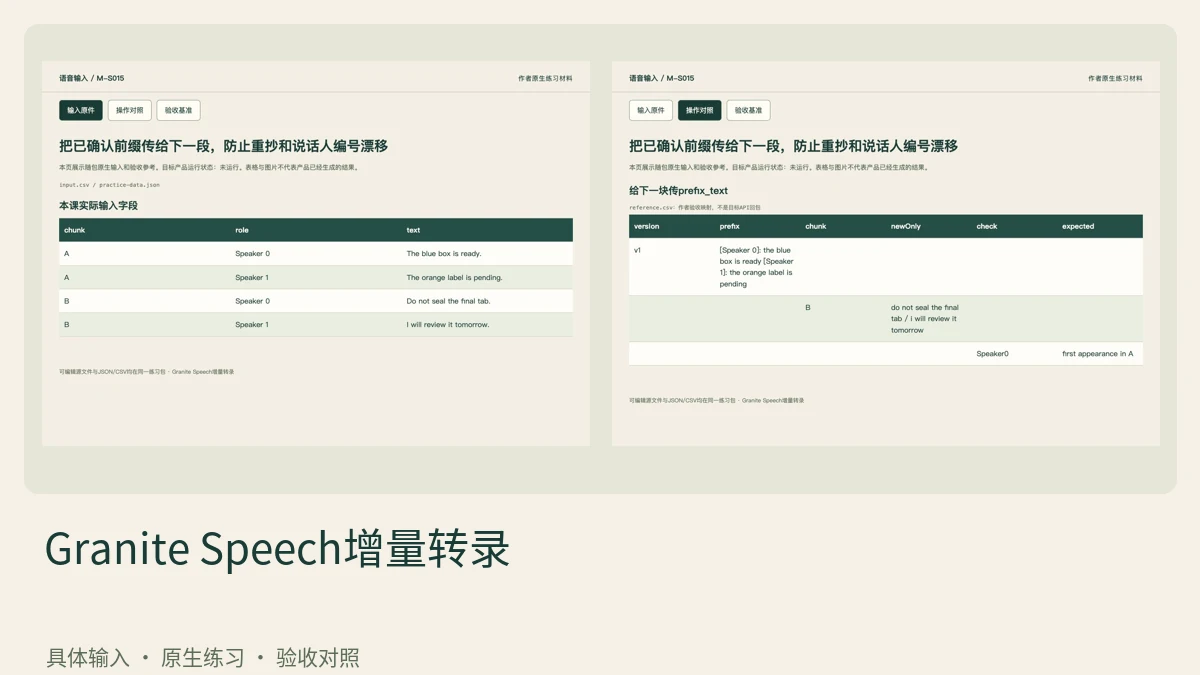
确认上一块逐字稿后,把它按当前 Plus 格式放入 prefix_text,下一块分别保存原始返回与新增文字。回查重抄和说话人编号延续;前缀表示此前文本,不是让模型重新转录同一音频。
阅读文章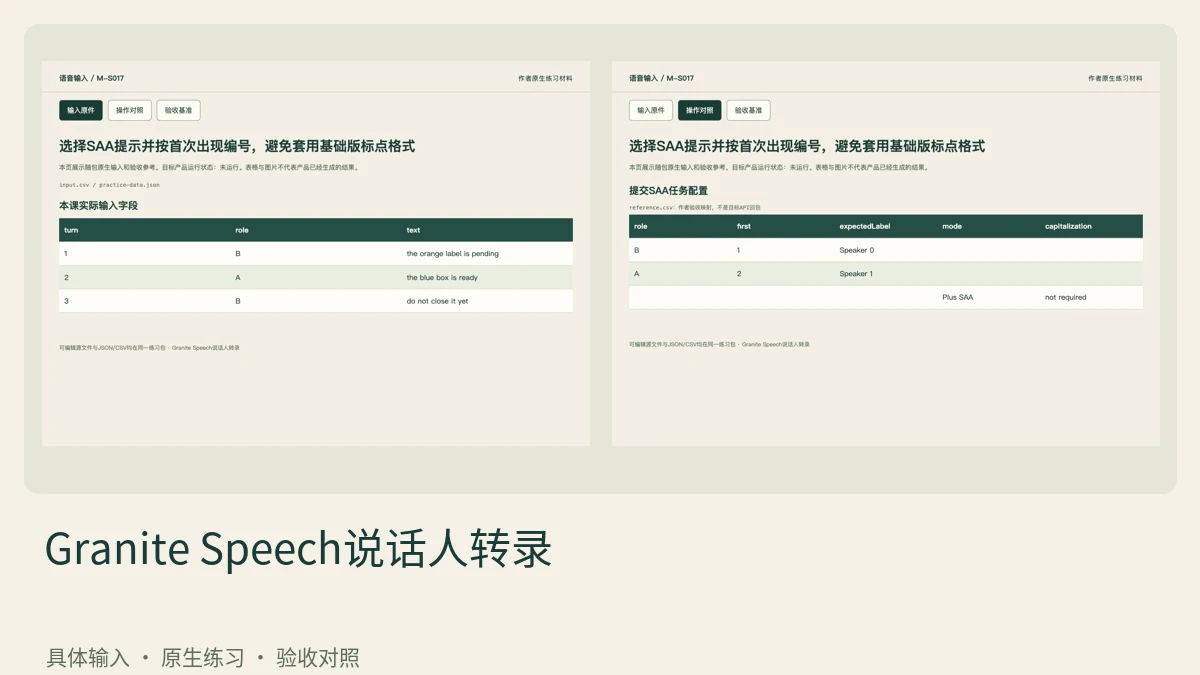
保持单声道音频不变,按 Plus 官方示例选择 SAA 任务,先保存原始返回再处理格式。按首次出现顺序核对说话人编号,区分识别内容与排版;不要用基础 ASR 提示替代 SAA。
阅读文章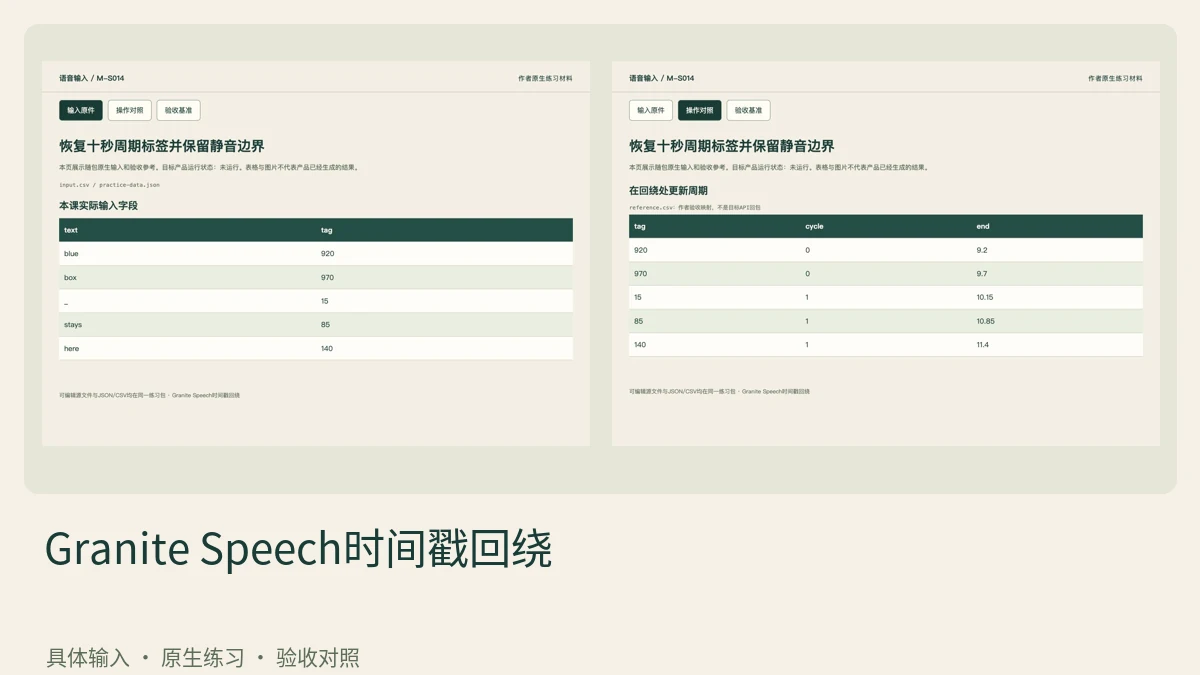
保存原始顺序标签,从 920、970 到 15 时增加周期计数,用 N/100+10R 恢复绝对秒数。保留静音端点并检查单调和音频长度;解析练习不是新的语音识别结果。
阅读文章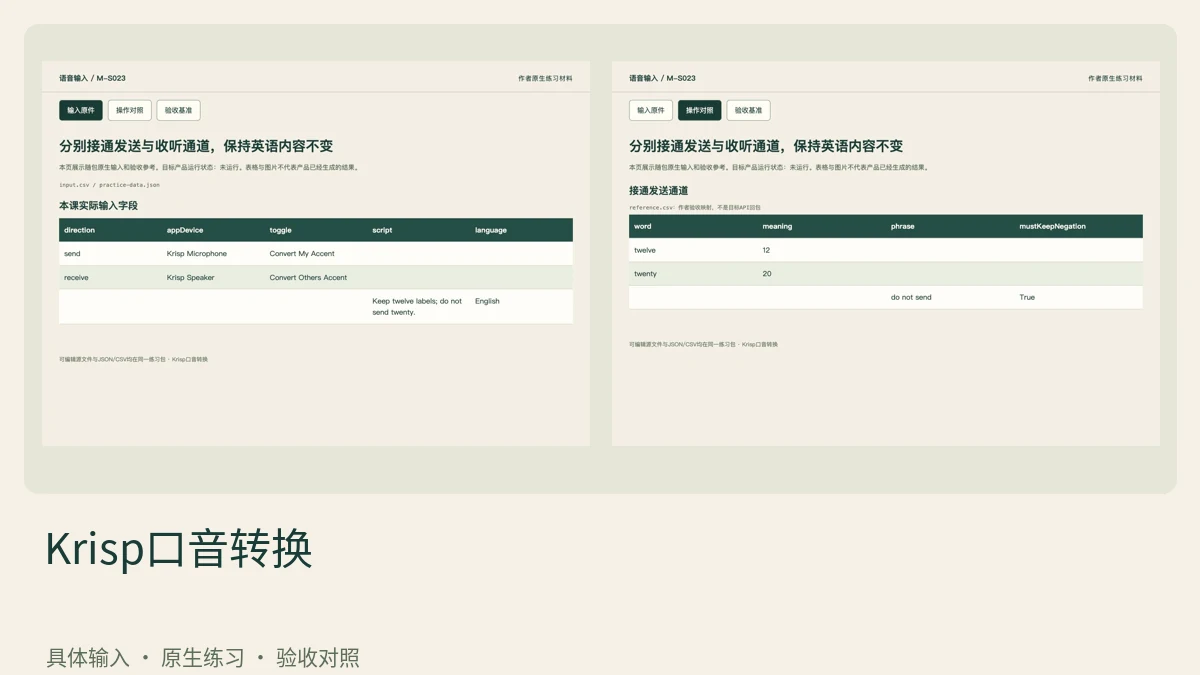
在Krisp选实际输入设备并启用Convert My Accent,再把会议软件输入改为Krisp Microphone。只打开Krisp窗口不足以证明会议音频经过它。
阅读文章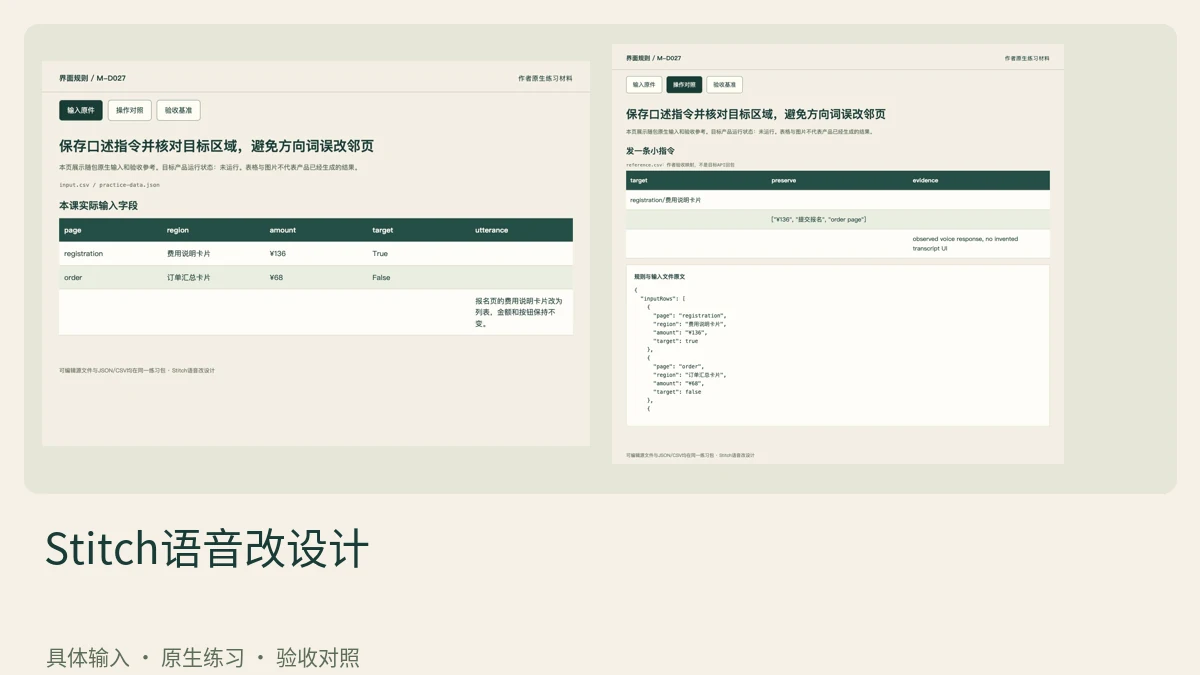
先选中报名页并保存 screen 身份,口述明确对象名称和保留项,核对实际理解后再评审改动。相邻订单页另作对照,避免“右侧卡片”指代混乱;未执行的语音会话不写成功结论。
阅读文章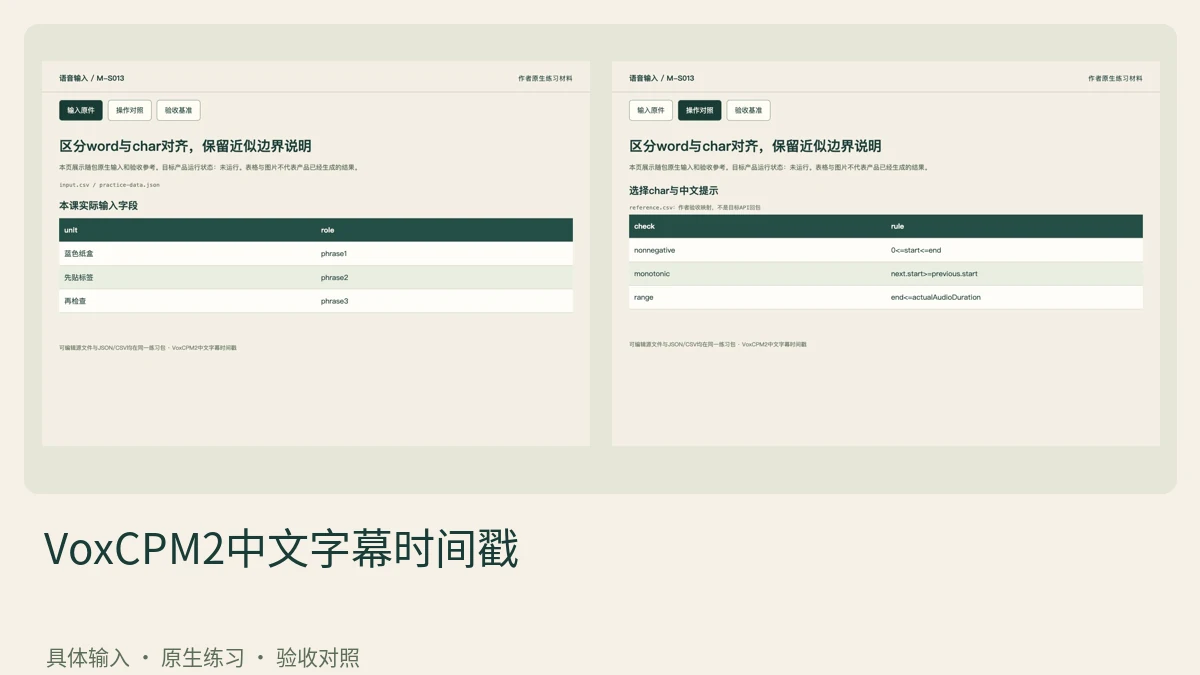
生成时启用--timestamps,设--timestamp-level char和--timestamp-language zh。另留word级对照配置,避免认为char只是文件扩展名。
阅读文章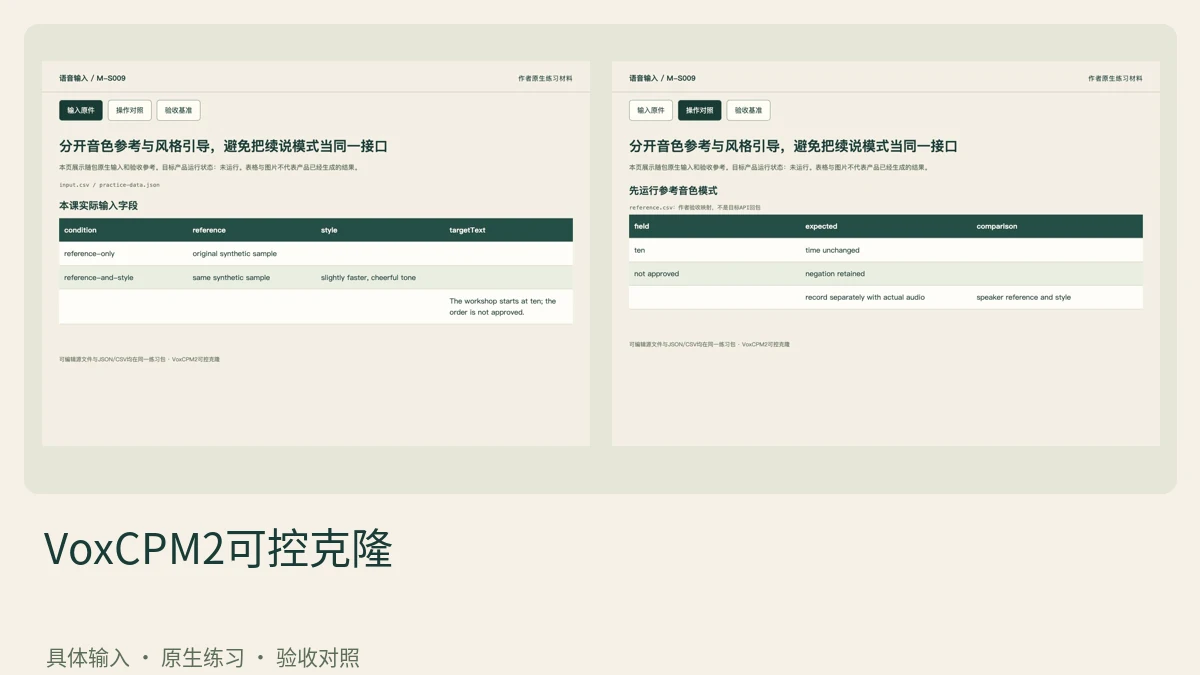
按当前官方API把参考路径放到reference_wav_path,text只填新台词。不要为这轮无意附加prompt_wav_path与prompt_text,后者属于音频续说式配置。
阅读文章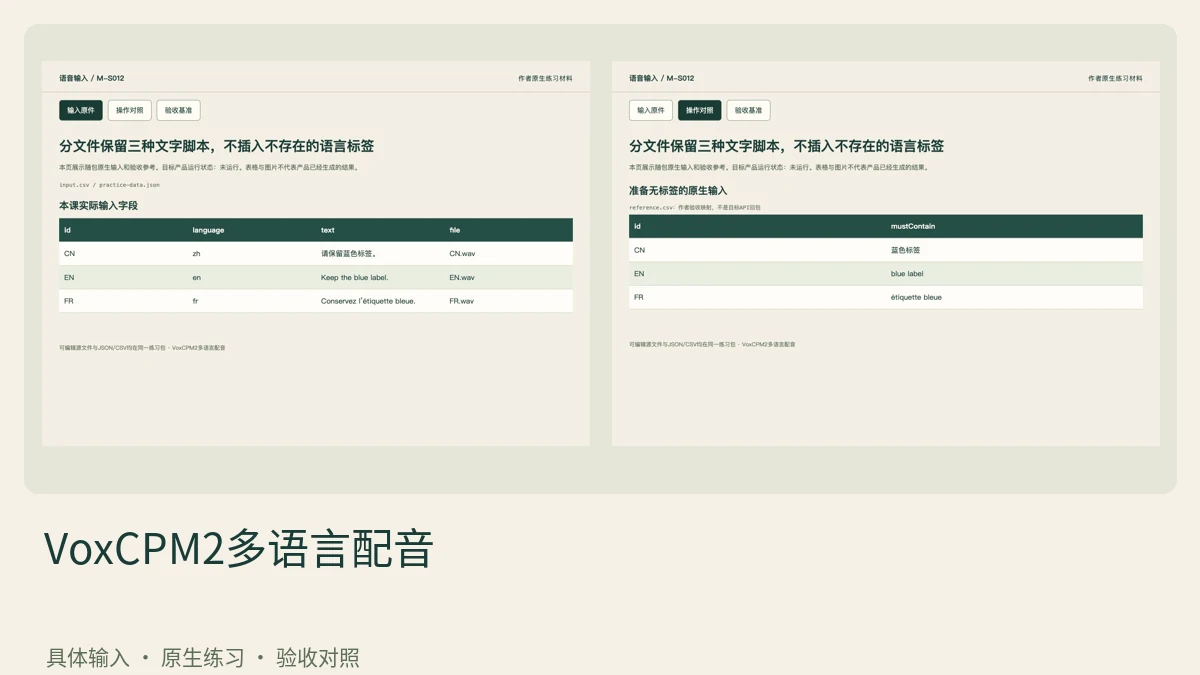
把三种语言分成独立文本,按官方 text 入口直接传入并固定参考和设备。分别回听实际内容,不插入接口不存在的语言标签;第三方包装参数不能冒充模型原生约定。
阅读文章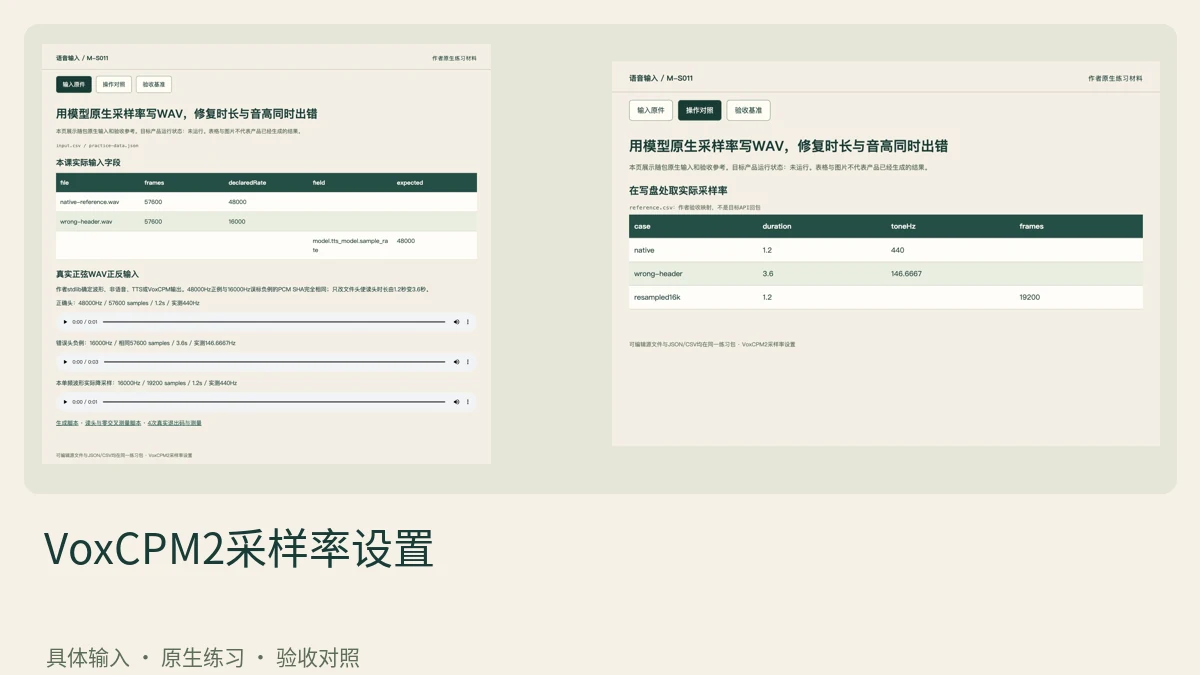
把生成的PCM与模型实际sample_rate一同传给sf.write。保存运行版本和该值,别在多个模块分别硬编码不同常量。
阅读文章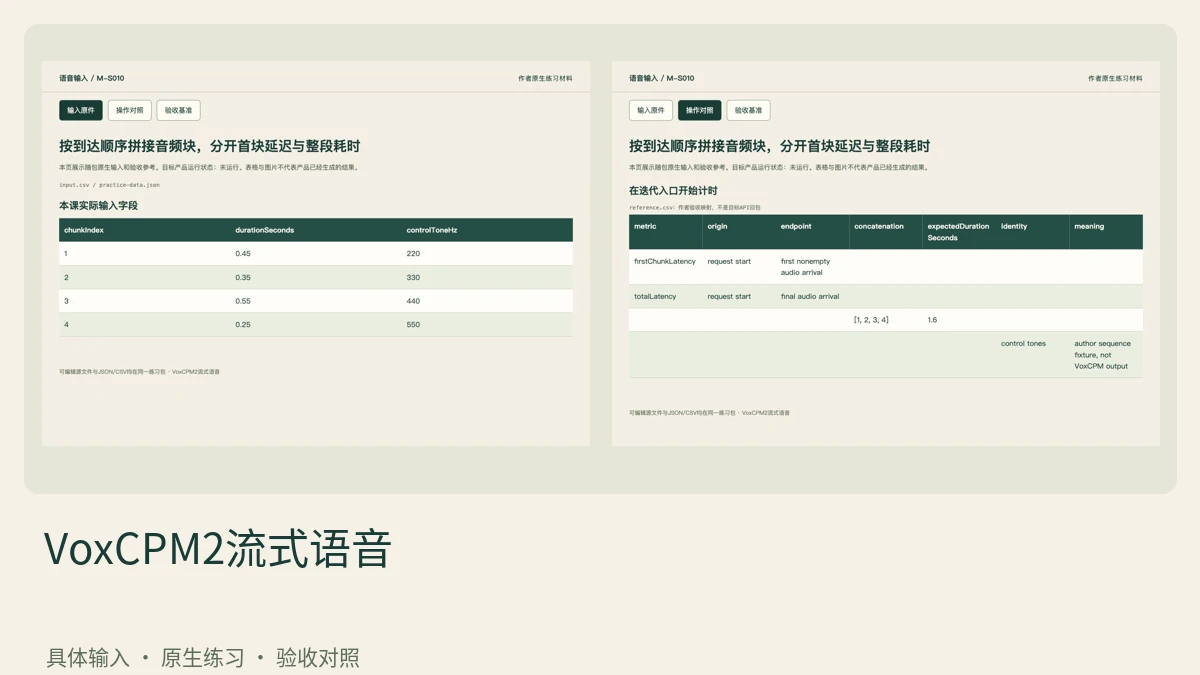
调用前记录单调时钟起点,每收到一块就保存到达序号、样本数与时间,再按原顺序拼 PCM。分别计算首块延迟与整段耗时,检查拼接边界;离线块样例不是在线性能实测。
阅读文章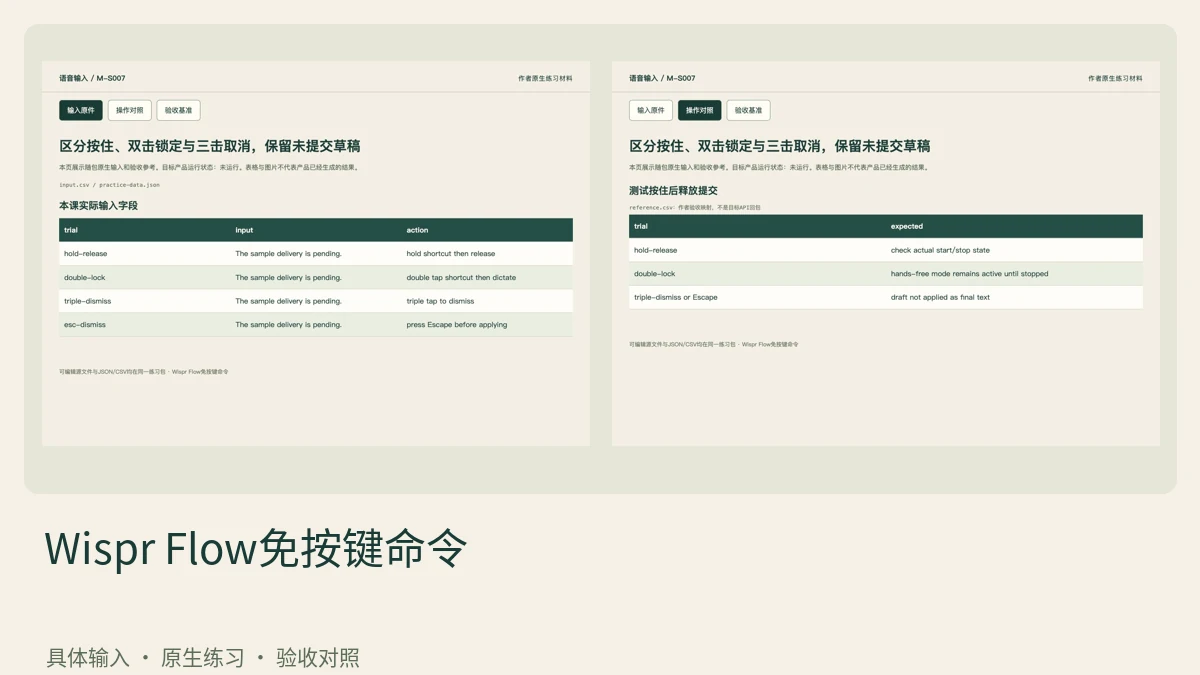
按住快捷键说一条短指令,释放后观察是否开始处理。非常快释放可能只结束会话,实际发生什么要留记录。
阅读文章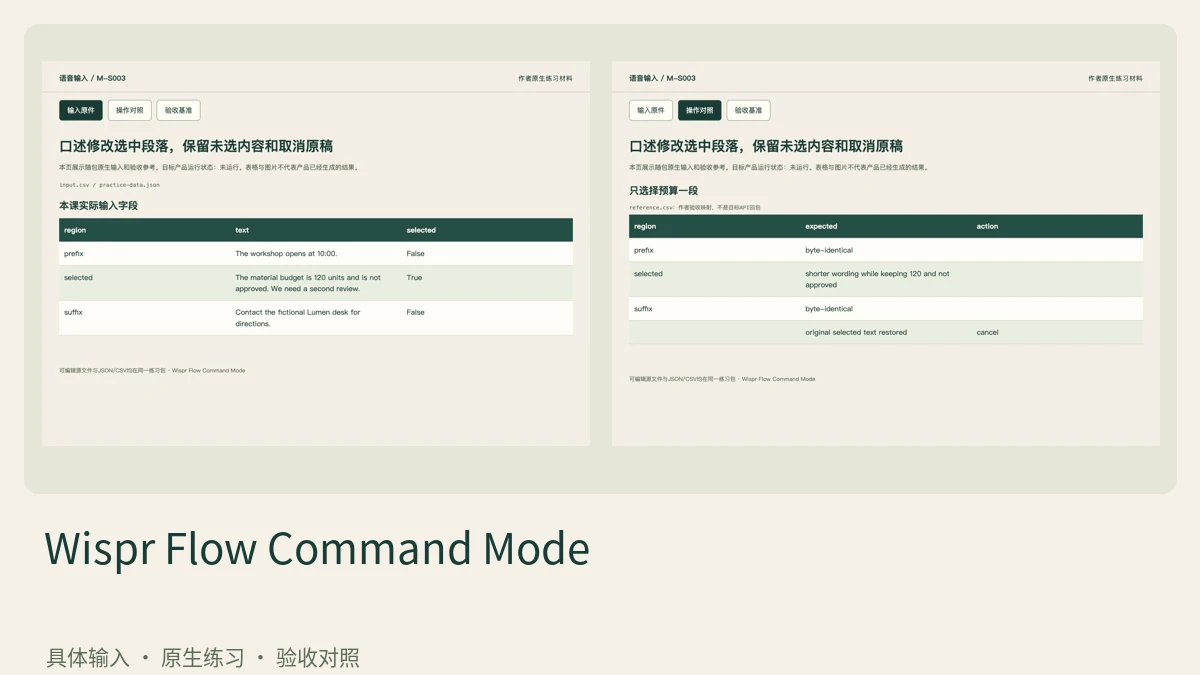
用鼠标选中预算段落,不要把标题、联系人或空白尾段一并选入。拍下选区和相邻文字,给后续差异核对留证据。
阅读文章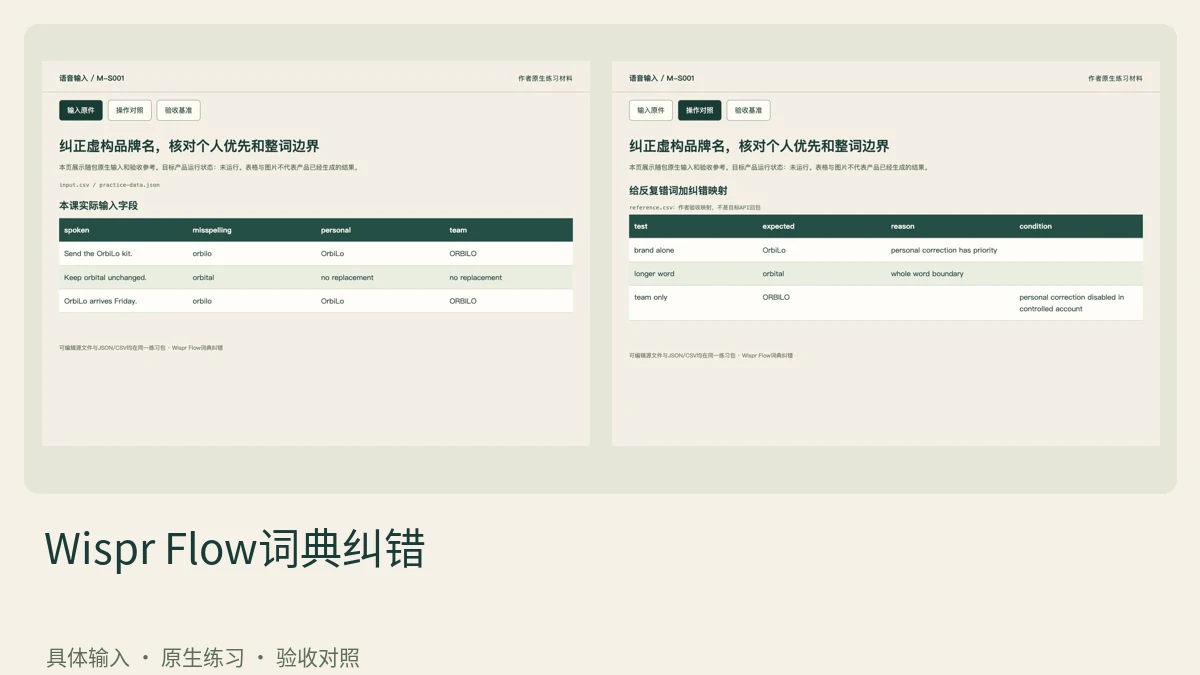
若原输出持续为orbilo,在新增条目启用Correct a misspelling,填错形与期望拼写。每个条目只持有一组纠错,先确认不是改了另一条团队词。
阅读文章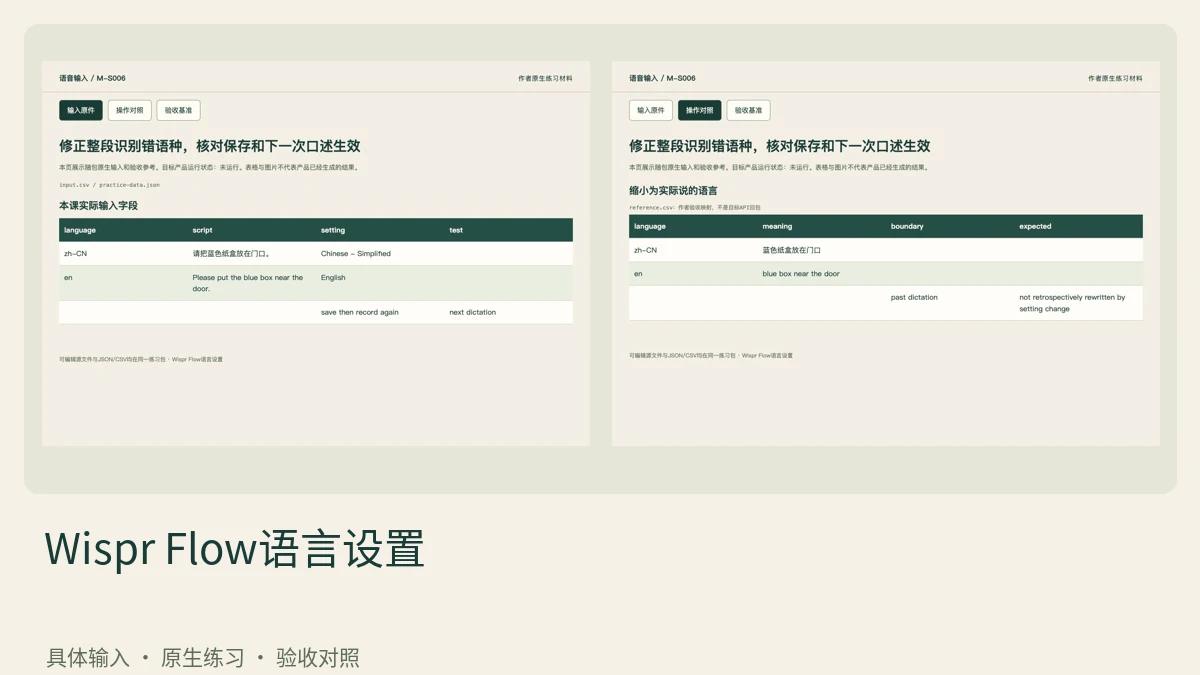
在桌面Settings的General进入Languages,关闭自动识别并只留Chinese-Simplified。选择同组变体会替换旧变体,核对最终列表而不是只看刚点过的行。
阅读文章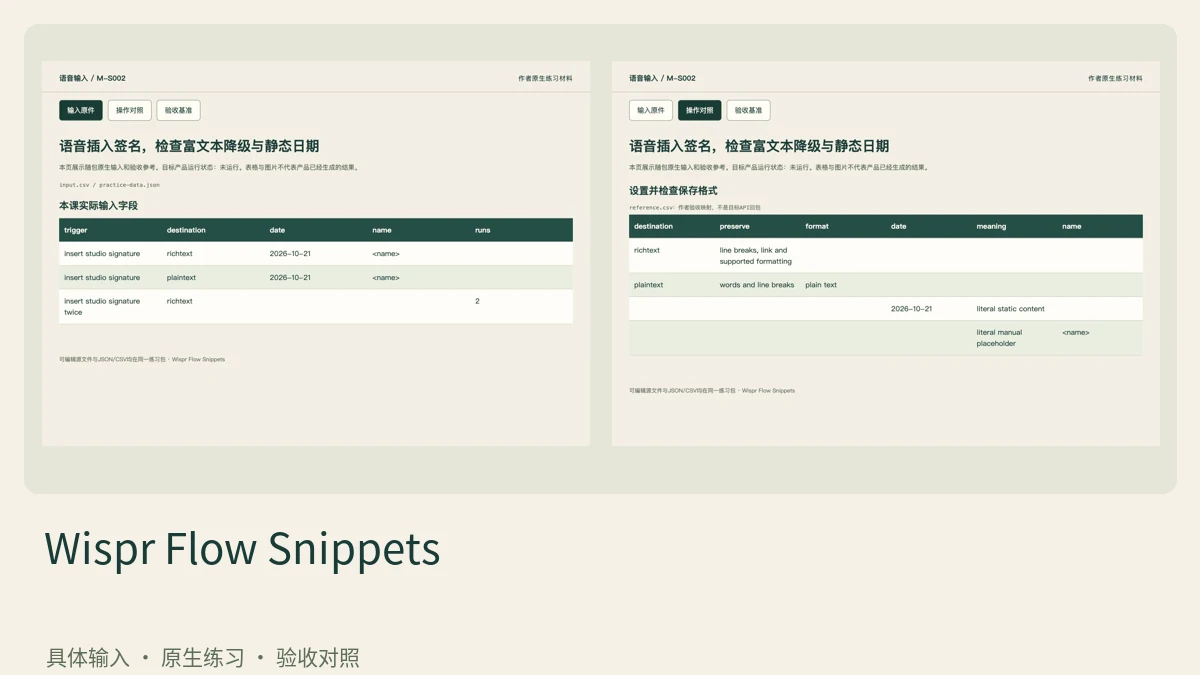
在 Snippets 建独特触发短语,为工作室名设置粗体、官网设置实际链接,再分别插入富文本和纯文本框。检查格式降级与静态日期;换行不等于富文本,文本中的日期不会自动变为当天。
阅读文章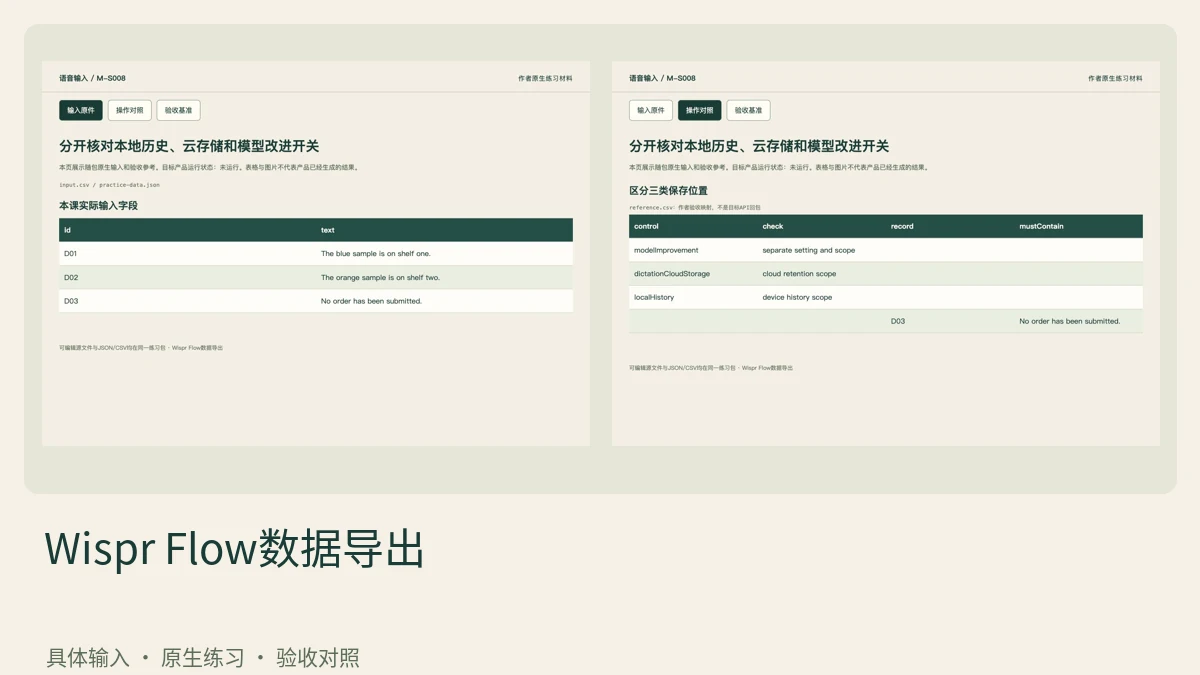
把设备上的本地口述历史、Wispr保留的云端口述和词典片段分成不同栏。会议Notetaker与Scratchpad也有独立范围,不用单一口述开关推断全部数据。
阅读文章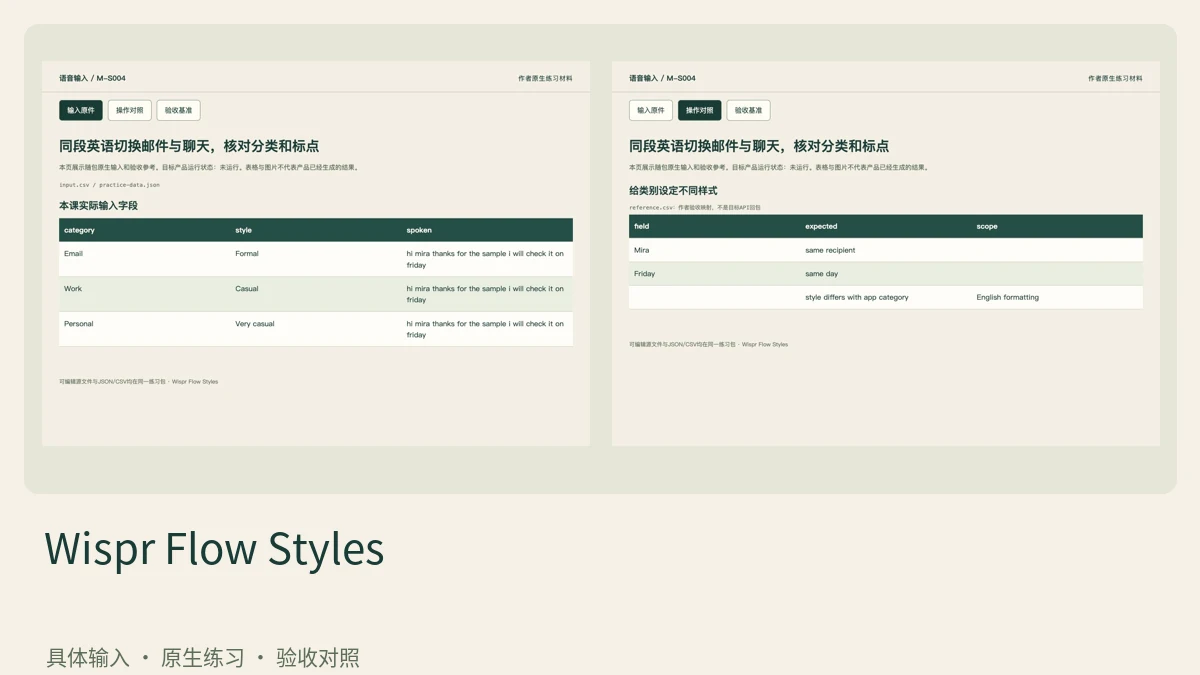
在桌面给Email选Formal、Personal选very casual,Work另选可用样式。桌面卡片即点即存,iOS某些布局需Save,按实际界面完成。
阅读文章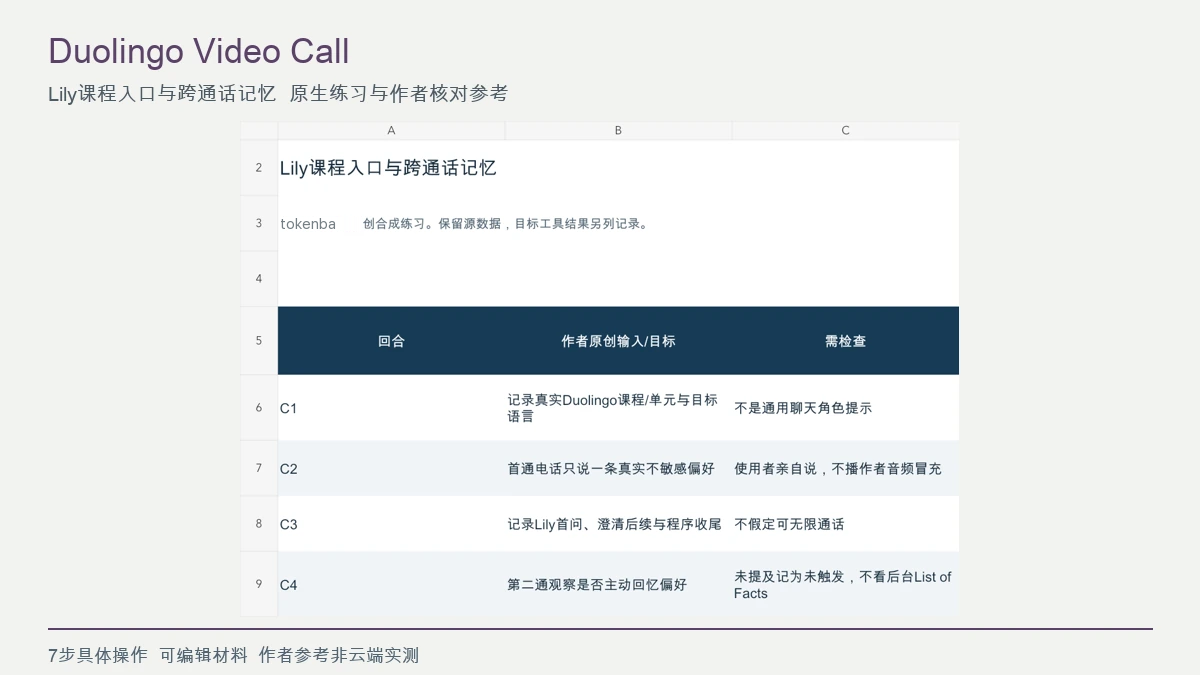
从实际课程的 Video Call 入口开始,记录 Lily 首问,亲自表达一条偏好并完成澄清,等待自然结束。第二次通话再观察是否回忆,不强行补写成功;通用语音助手角色扮演不能替代原生通话。
阅读文章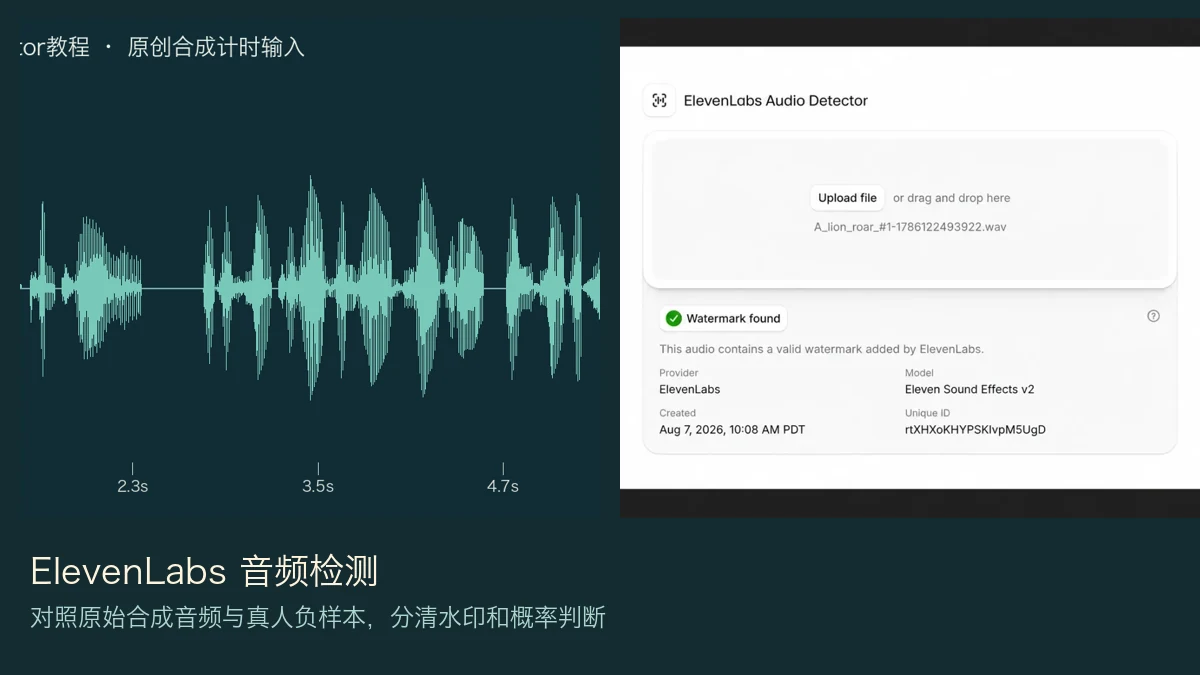
准备有来源的 ElevenLabs 原始输出和本人真实负样本,先保留文件摘要,再分别上传并记录水印、分类结果。重编码副本另测;该检测不是所有 AI 音频的通用来源鉴定。
阅读文章
在 Audio Native 中限定文章正文与允许播放的网站,嵌入实际代码后在允许站点试听,再检查未允许来源。回听是否读入导航或漏正文;URL allowlist 与网页可见性不是同一设置。
阅读文章
先确认所选 music_v2/v2_5 的实际 schema,用 chunks、duration_ms 与 styles 安排三段原创歌词,离线校验后再提交。
阅读文章
提交有来源的混合事件音频并开启实际支持的 event tagging,把语音 word 与非语音 event 分开保存。逐段回听掌声、笑声和误判,再导出可访问字幕;不把合成参考当模型识别结果。
阅读文章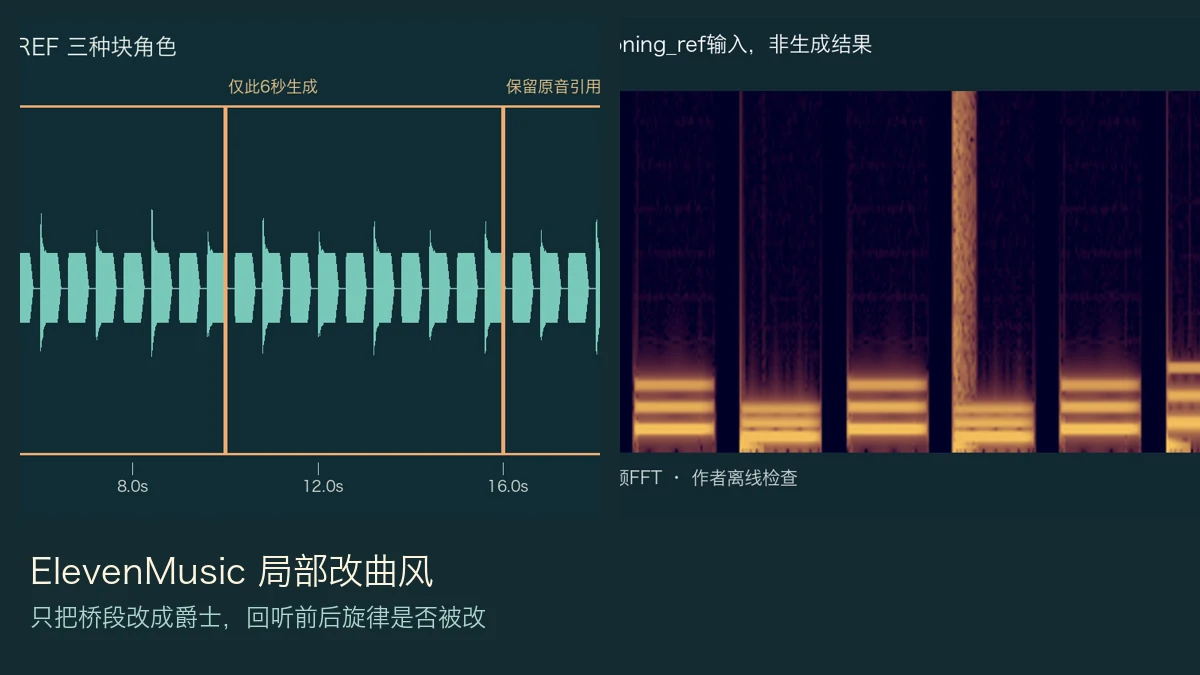
取得真实 song_id 后,用音频参考保留原曲两侧,只给六秒桥段设置新的风格与时长。提交前检查当前 chunks 类型,生成后听两处接缝;包内 PCM 是输入参考,不是平台重写输出。
阅读文章
用有权使用的小样在当前入口建立 Style,保存真实标识,再用另一份原创歌词生成。分别评审节奏、配器与情绪继承,避免把参考曲内容照抄当成成功;本页目标服务未运行。
阅读文章
在 Vocal Library 选择实际 Vocal 条目,为两首原创歌词沿用同一标识,分别保存参数与音频。制作等响试听副本后比较音区、咬字和身份;同一标识不保证每个结果听感完全一致。
阅读文章
为十二轮原创剧本固定说话人编号,按实际支持格式使用 speaker 标签并绑定有权参考音。完整保存生成音频,逐轮检查换人、漏句与串音;包内系统参考不冒充多人模型输出。
阅读文章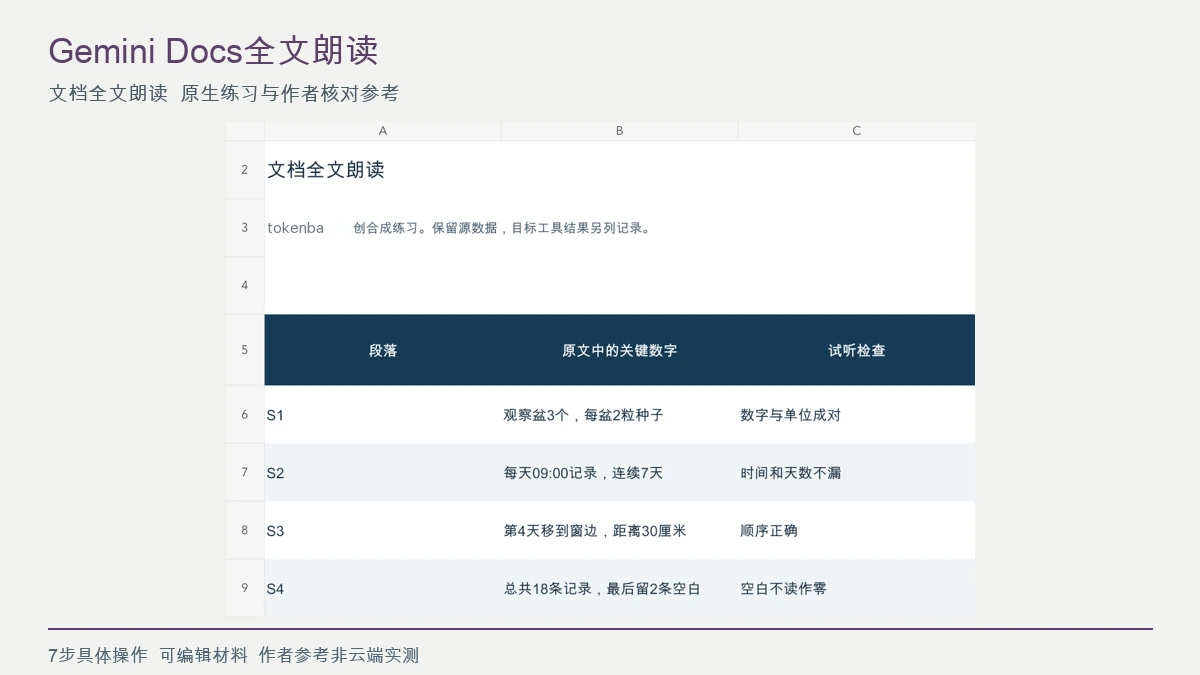
把附录放独立标签,在当前 Listen to tab 选择全文并插入文内音频按钮,切换可用声音与语速。逐段回到原文核对八个数字与漏听句;听到摘要不能当作全文朗读完成。
阅读文章
确认 macOS、账户和插件条件,只要求可导出的标准合成器,取得真实 fmx 后放入对应 Flow Instrument/Effect。
阅读文章
分别读取自有歌曲的发布范围与 Allow community remix 设置,关闭不需要的重混后保存实际分享链接。退出登录检查访问,再下载 ZIP 核对文件;不能把本地设置表当线上权限生效。
阅读文章
从自有歌曲的 Music Video 入口建立项目,先锁定歌曲区间和四镜叙事次序,再预览与下载。检查接点和原歌对应;包内三十秒音频是输入,不是已生成的 MV。
阅读文章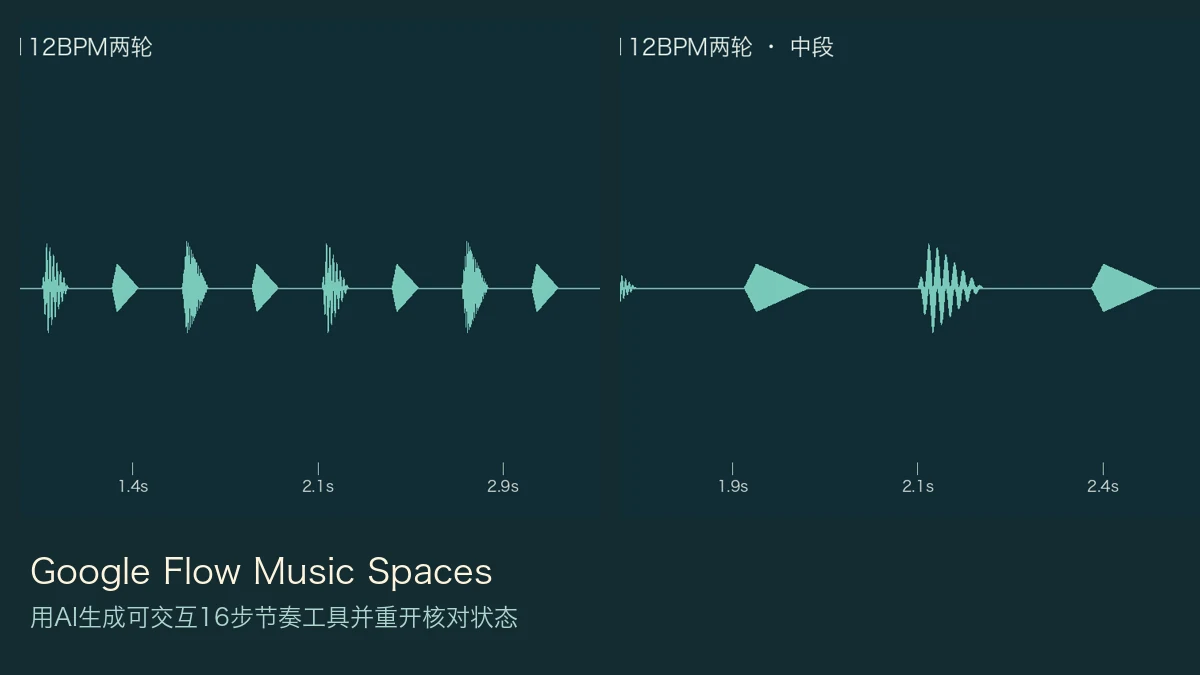
从 New Space 描述十六步节奏器的开关、速度和状态需求,先试听初始鼓型,再只改三个步点。重开实际作品检查状态与声音;Spaces 在这里是交互工具,不能当成员协作文档容器。
阅读文章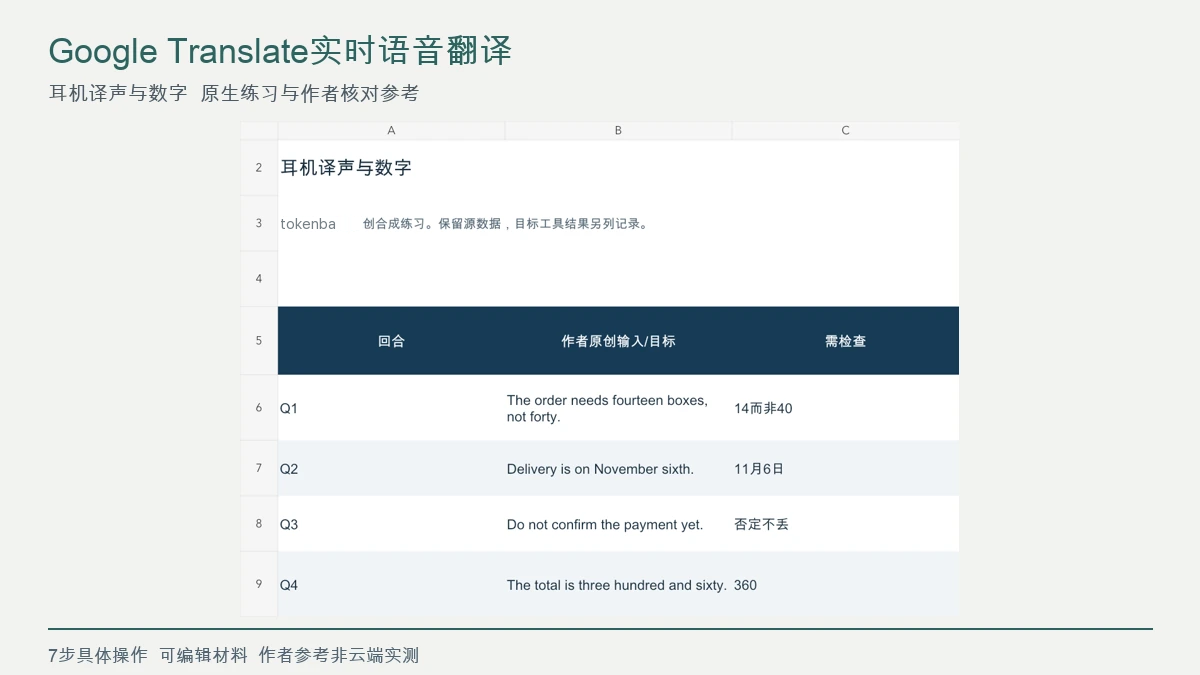
先确认设备、语言与当前支持,进入实际耳机翻译后每次说一句并等待译声。逐句听写数字、日期与否定,再对照原文;设备设置截图和测试音频不能证明真实译声已播放。
阅读文章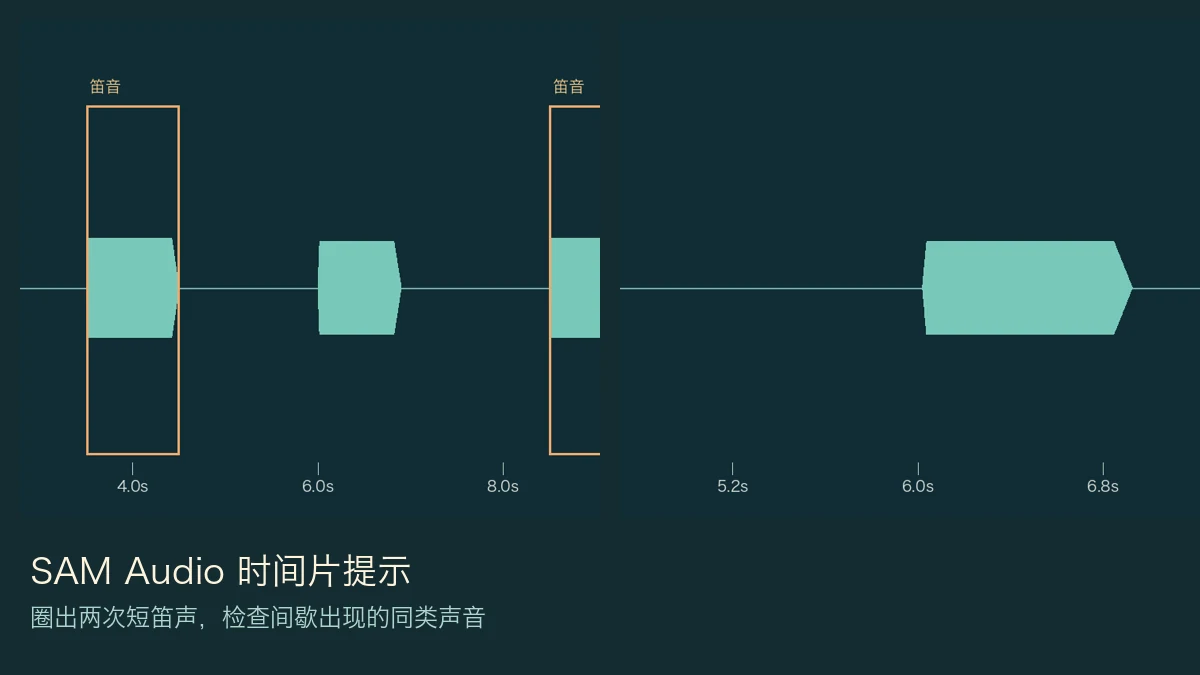
在混音中圈出两次短笛时间片作为提示,并留下未圈测试段。生成 target/residual 后分别回听提示内外,检查漏提和其它声音残留;本页合成真值用于评估,不是目标推理输出。
阅读文章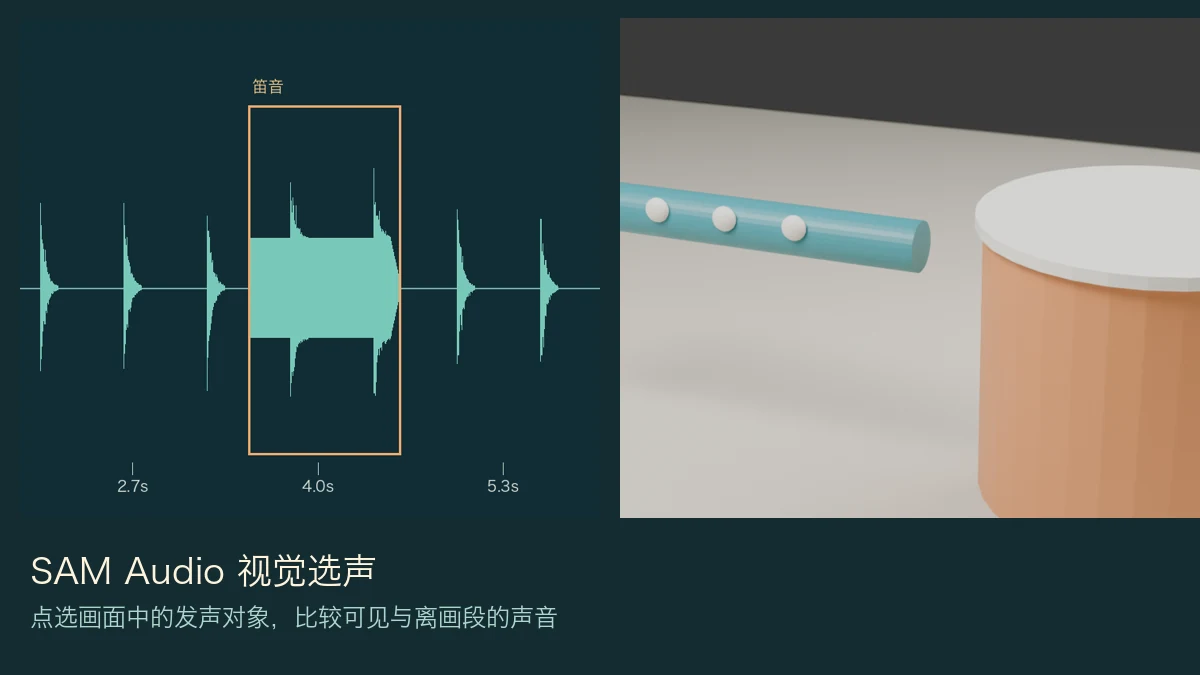
在实际支持的 Visual prompting 中选画面目标,保存 target 与 residual 两轨。分别回听可见段和离画段,检查串音及漏提;点选对象不是身份鉴定,包内分轨不代表模型分离结果。
阅读文章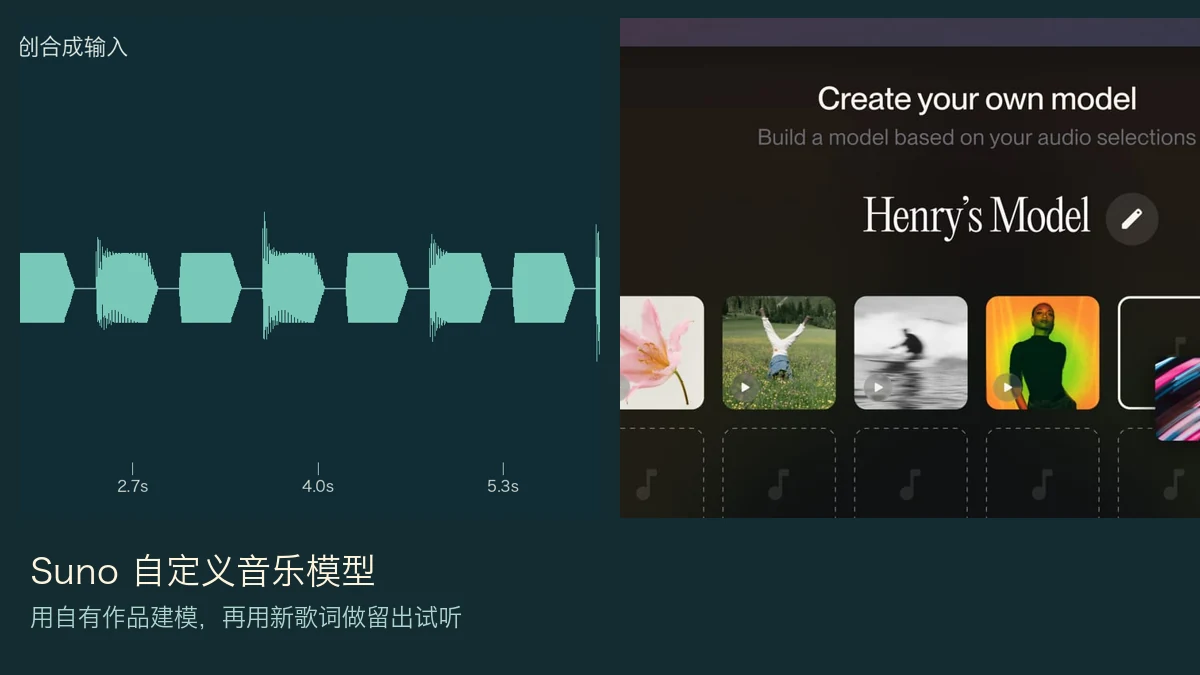
先核对建模资格与作品权属,把训练作品和新歌词留出项分开,再建立模型并保存真实标识。用未参与建模的歌词试听结构与声音;不能由功能存在推出该用户账号已可用。
阅读文章
在当前 Voices 入口上传或录制本人声音,朗读实际核验短语并裁切代表片段,再用新旋律试听。保存原生授权与可用范围记录;包内练习材料不能代替本人核验或证明创建成功。
阅读文章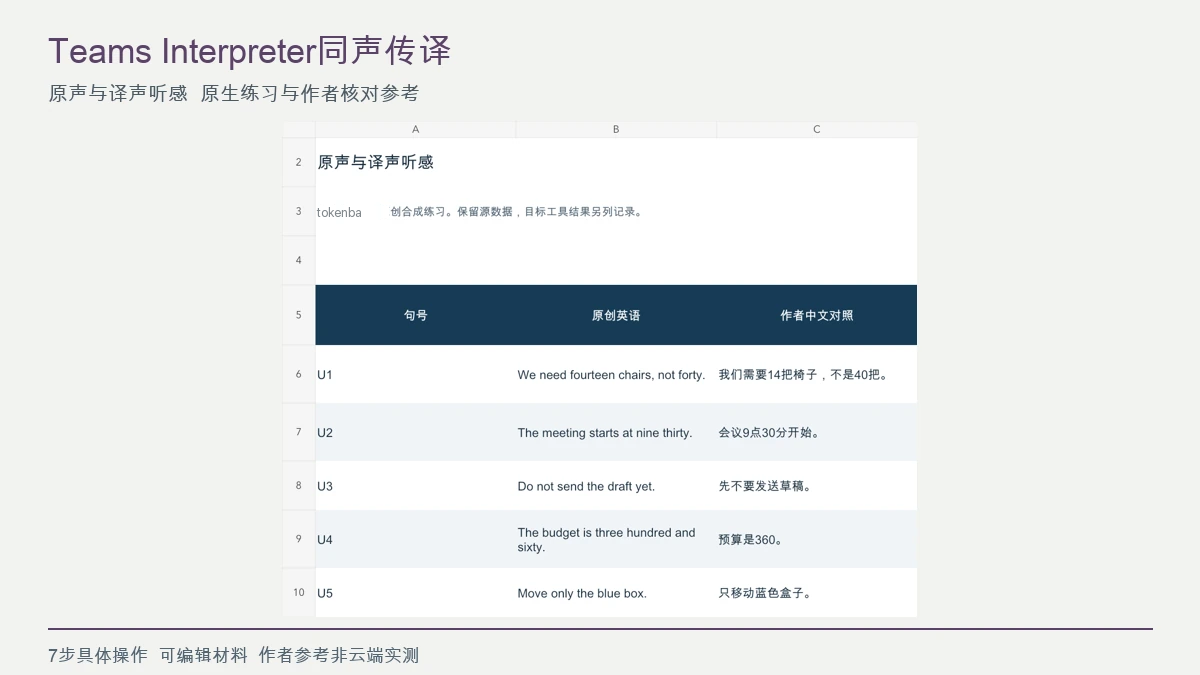
在授权测试会议确认语言和许可,启用 Interpreter 并选择实际可用译声,调整原声/译声比例后轮流说话。回听数字和否定,字幕正确不能代替可听翻译正确。
阅读文章注册后创建 apizt API Key,选择客户端和模型,再生成接入配置。从一次简单请求开始,按实际用量付费。
在控制台创建令牌,选择需要使用的模型权限。
按工具要求填写 API Key、接口地址与模型 ID。
确认收到有效结果,再到控制台查看用量与费用。