
展开本页目录
开始前准备什么
- 下载本页素材,使用有权处理的声音,保留原始输入。
- 为对应工具建立独立 Python 环境,核对实际模型与版本。
- 先在小样中试听并保留失败记录,再处理长录音。
- 检查真正的双声道源
- 分离 L 和 R,避免先混成 mono
- 分别转录两条轨道
- 按时间排序,保留重叠情况
- 回听会议时间和房间号码
- 导出分轨稿与待确认人名
本任务输入、脚本、原始输出或明确待运行模板、原文、校验与损坏负例;不含模型权重。
macOS say 合成的本站原创任务输入;不是模型生成成功证明。
朗读输入与回听依据,独立于机器实际稿。
包含具体命令、步骤、来源与未运行范围。
保留原始文件;准确性需回听,脚本存在不代表模型已运行。
1. 检查真正的双声道源
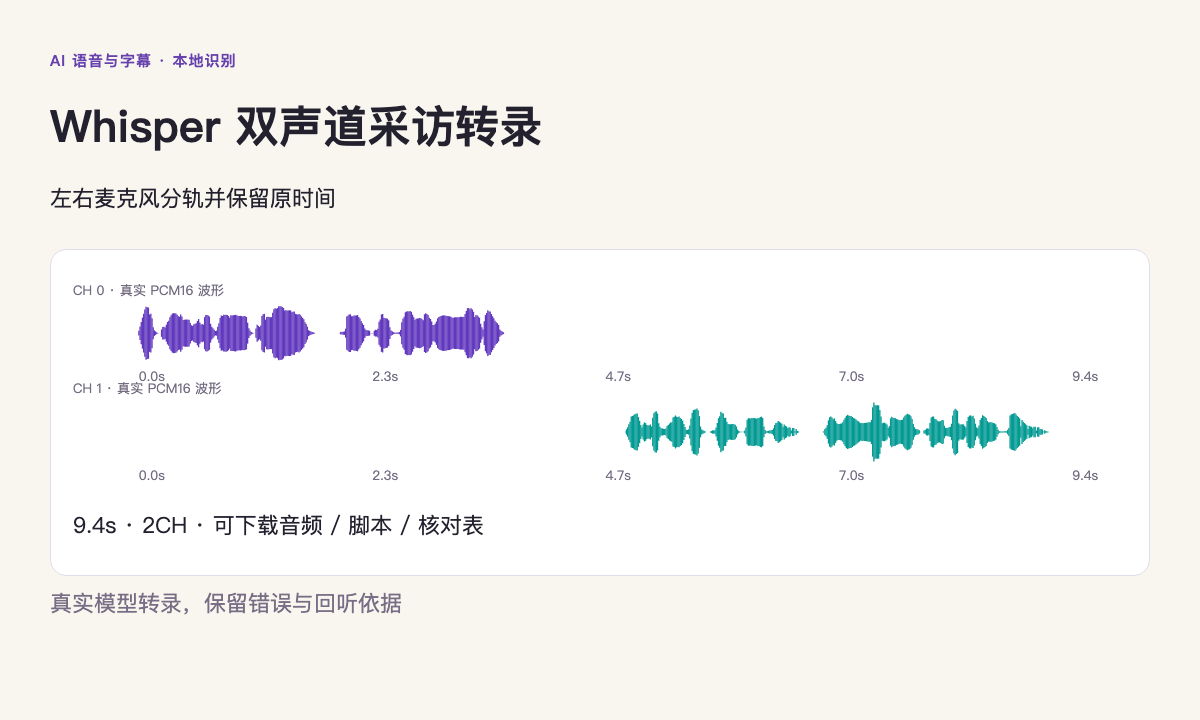
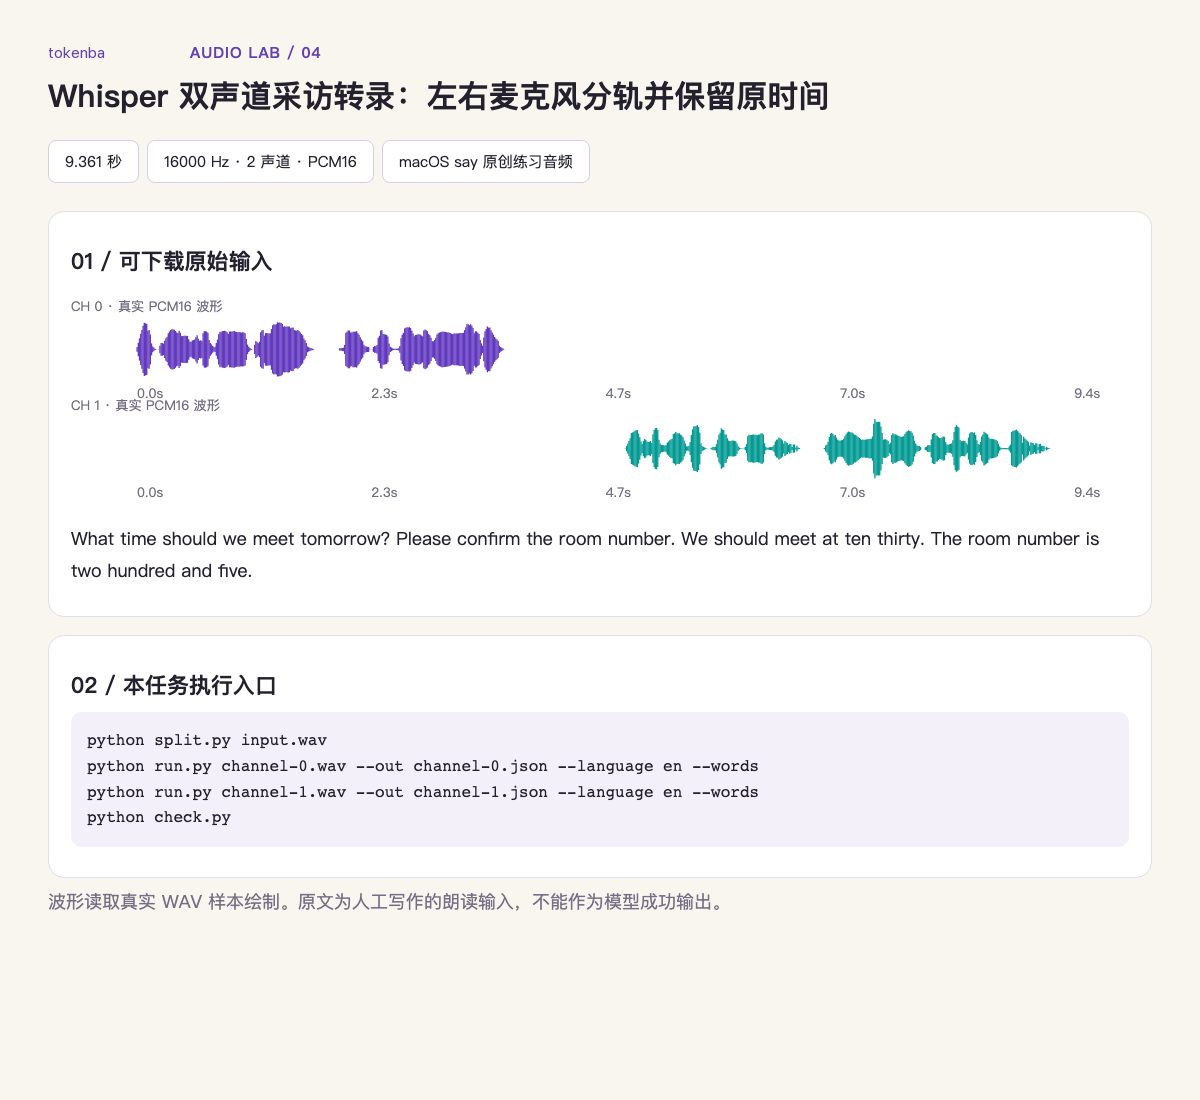
input.wav 左声道是原创提问、右声道是回答,使用不同系统音色且不同时讲话。它演示双麦克风分轨,不是模型识别人身份。先戴耳机确认左右录音与原始起点。
2. 分离 L 和 R,避免先混成 mono
运行 split.py,按原样本序号把两轨写成 channel-0.wav 和 channel-1.wav;两条都保持完整时长。若提前删除各自静音,再合并时间将失去共同零点。
3. 分别转录两条轨道
两轨使用相同模型参数。实际 JSON 的时间基于完整轨道,右轨前方静音不会让回答起点变成零秒;保留 channel 字段再合并。
run-commands.sh
python split.py input.wav
python run.py channel-0.wav --out channel-0.json --language en --words
python run.py channel-1.wav --out channel-1.json --language en --words
python check.py
4. 按共同零点合并左右声道
把两条完整声道返回的 segments 按 start 排序,并保留 channel_0/channel_1 来源。不要分别删除开头静音;否则两条轨道的零点不同,直接排序会把回答挪到问题前。
同一麦克风里混了多人时,声道标签不能替代说话人分离。对于重叠时间保留两条记录并回听,不用先后顺序硬改成互不重叠。
5. 回听会议时间和房间号码
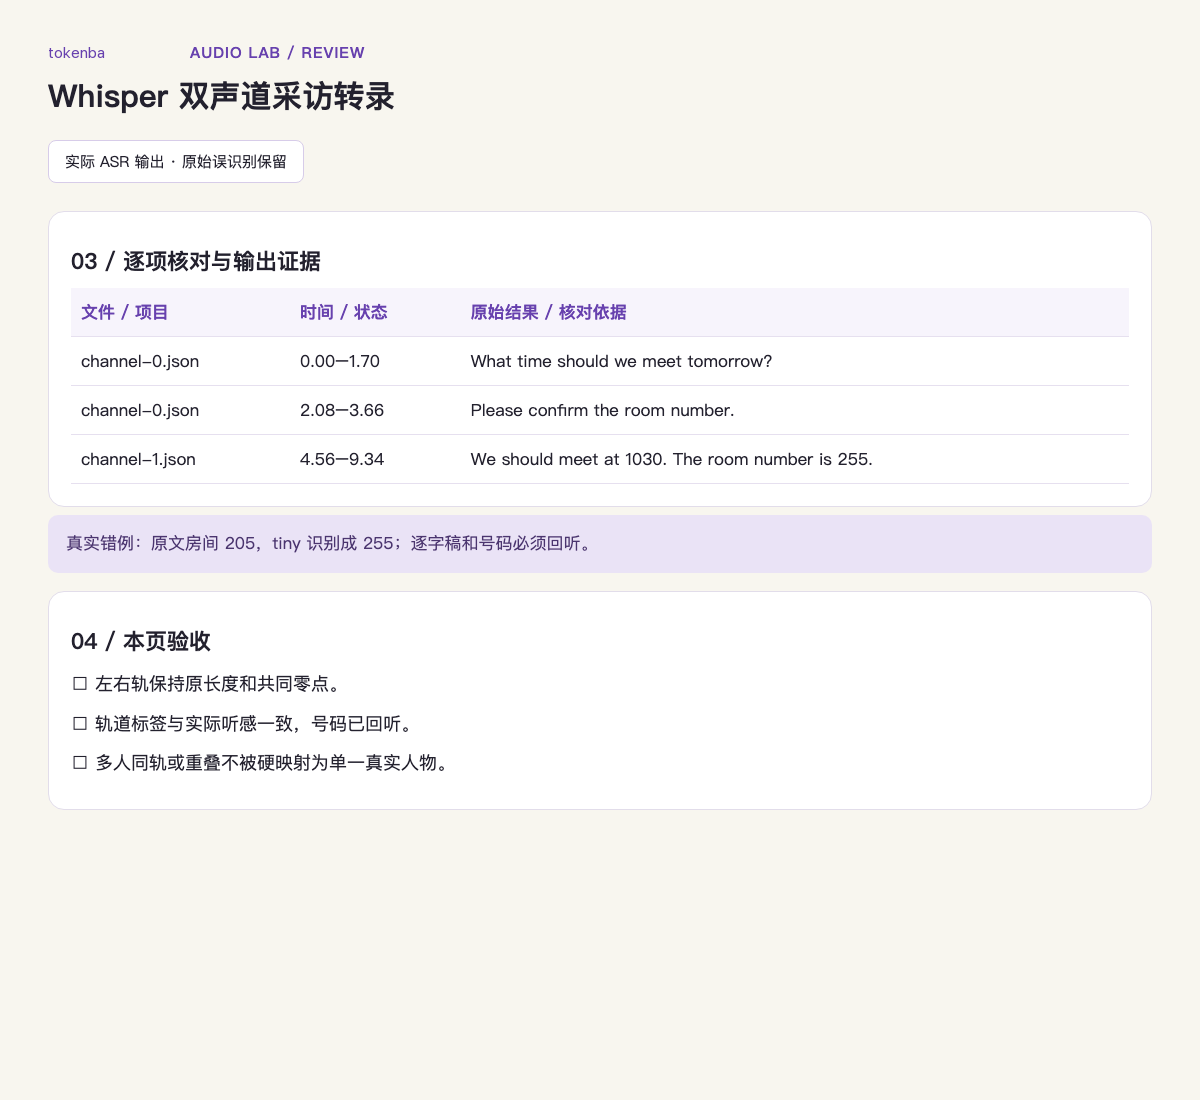
素材中的 ten thirty 与 two hundred and five 专门用于数字检查。先比较 expected 文本与实际识别,再填写 reviewed.csv;不能只核对总字数。
6. 导出分轨稿与待确认人名
把角色名称留作人工确认字段,不从声音自动认出真实人名。需要同一轨多人分离时转到 WhisperX 页,本页只验证明确双轨输入。
7. 下载材料、检查负例与继续操作
解压素材包后先运行 python check.py,再运行 python check.py --self-test。前者读取真实 WAV / JSON / SRT 与源 hash;后者拒绝损坏 WAV、倒置时间、越界时间和缺失词时间。文件通过不代表文字、情绪或说话人判定已通过。
怎样确认已经完成
- 左右轨保持原长度和共同零点。
- 轨道标签与实际听感一致,号码已回听。
- 多人同轨或重叠不被硬映射为单一真实人物。
常见问题
左右声道就是两位说话人吗?
只有录音结构明确把各自麦克风分在左右时才能做此假设。双声道音乐、复制单声道和多人同轨不能据此分人。
为什么回答轨开头有长静音?
为了保持与原双声道录音的时间基准;不要单独裁掉后直接合并文字,否则回答时间会提前。