
展开本页目录
开始前准备什么
- 准备自己有权使用的合成练习资料,不上传他人的录音或私密内容。
- 按官方文档核对当前平台、版本与套餐;本轮目标产品操作未执行,练习文件可离线查看。
- 练习包提供口述脚本、规则与验收数据,不附目标工具生成录音。按录音说明自行录制有权使用的输入,并在运行后保存实际音频。
- 拆成明确续说的录音块
- 确认第一块逐字稿
- 给下一块传prefix_text
- 分开原始返回与新增部分
- 检查说话人延续
- 处理前缀纠错分支
- 交付增量请求链
1. 拆成明确续说的录音块
为两位合成角色记录各自台词和分块边界,保留少量上下文说明。每块加唯一短句,便于发现重复追加。
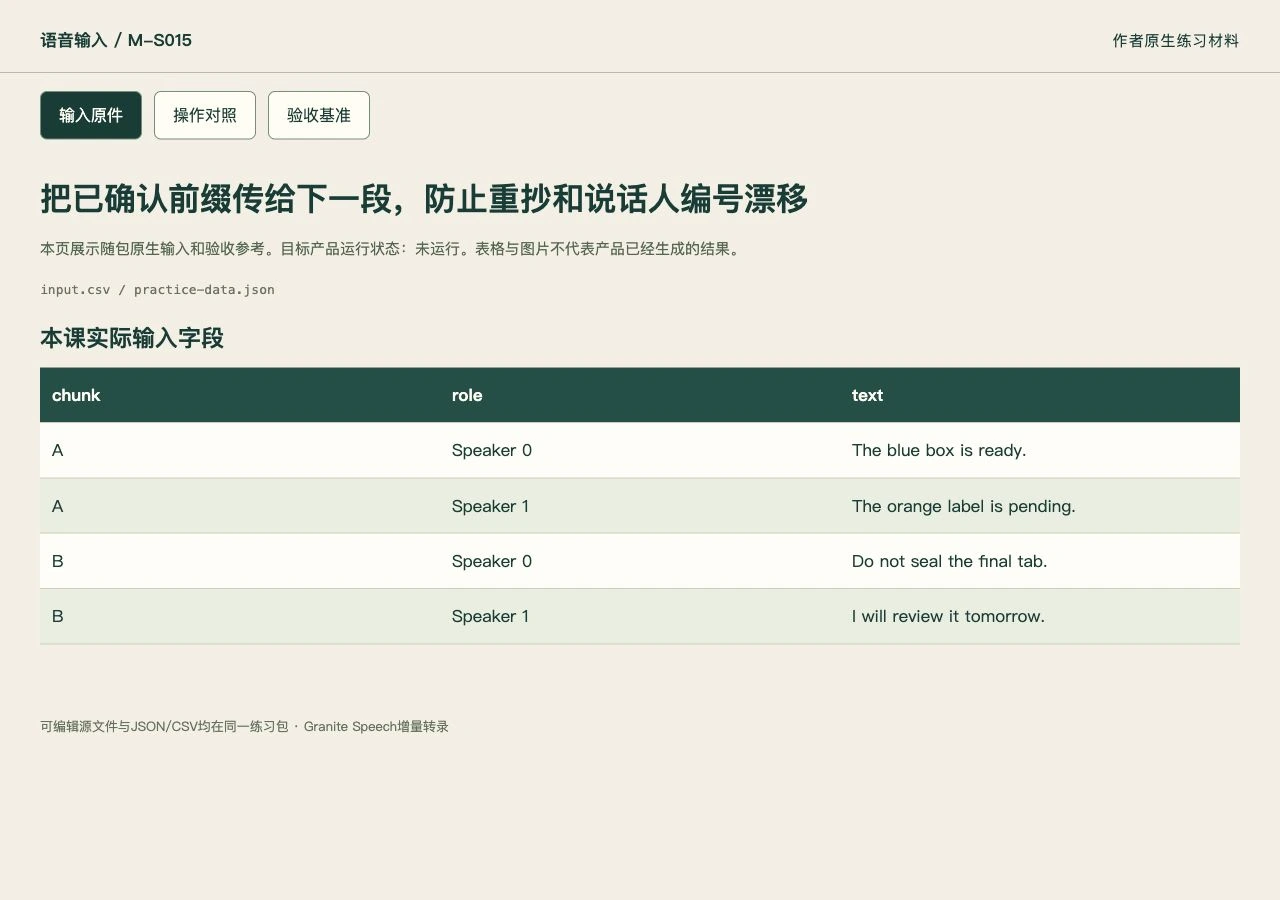
2. 确认第一块逐字稿
先核对第一块说话人顺序与文本,再把已确认内容冻结为prefix-v1。不要把待纠正的猜测也塞进后续上下文。
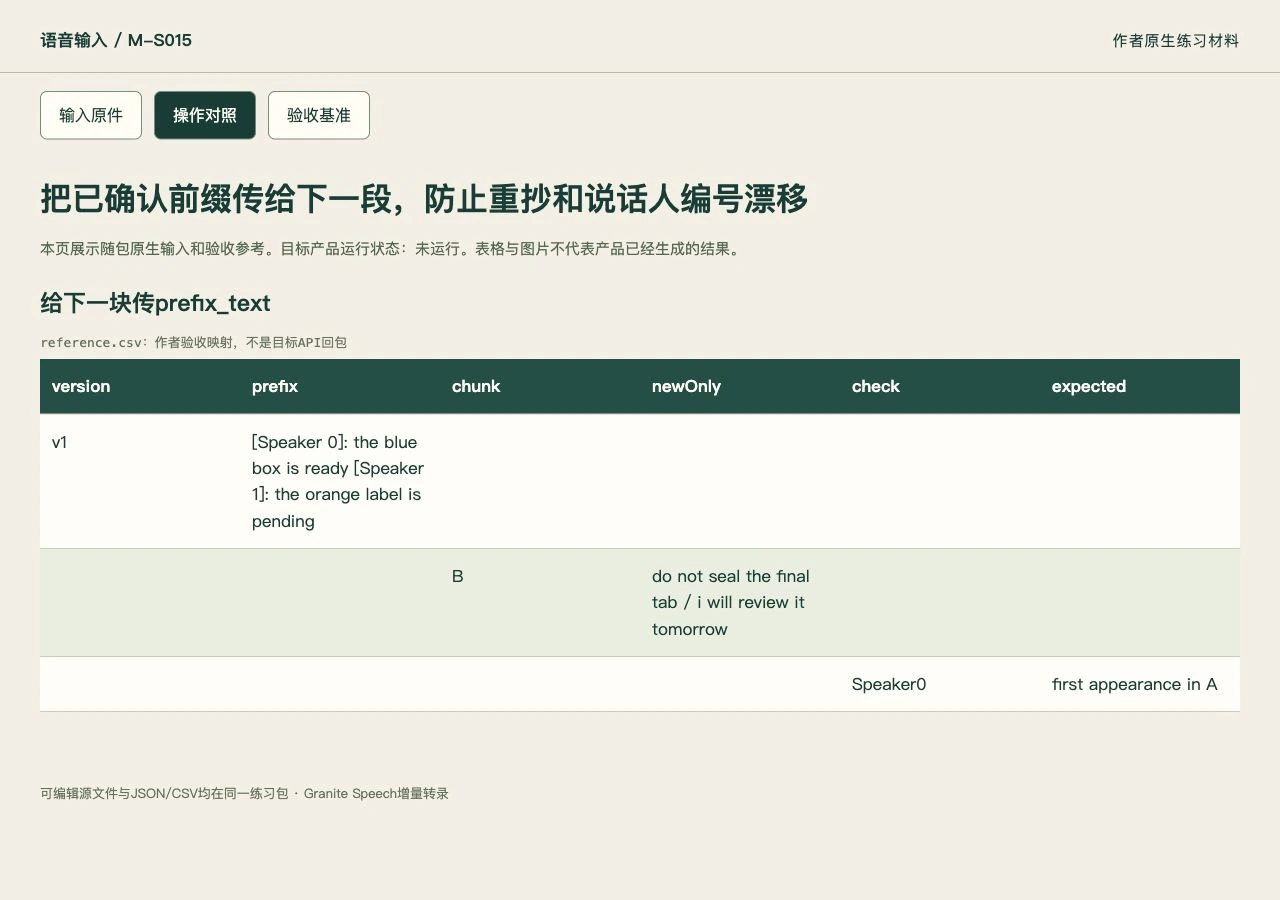
3. 给下一块传prefix_text
按官方Plus调用把上一份已确认逐字稿放到prefix_text,并记录音频块编号。该参数表达此前文本,不是要求模型再次朗读或转录同一音频。
4. 分开原始返回与新增部分
保存第二块原始输出,再判断需要追加的新增文字。不能先用字符串去重删掉真实重复话语而不留原稿。
5. 检查说话人延续
对照首次出现顺序与角色脚本,观察编号是否延续。编号只代表本轮对话结构,不能当作声纹识别出的真实身份。
6. 处理前缀纠错分支
若V1有错,修订为V2后重新评估受影响块,保留两个版本。不同前缀生成的结果不能混到一份连续稿而不记录来源。
7. 交付增量请求链
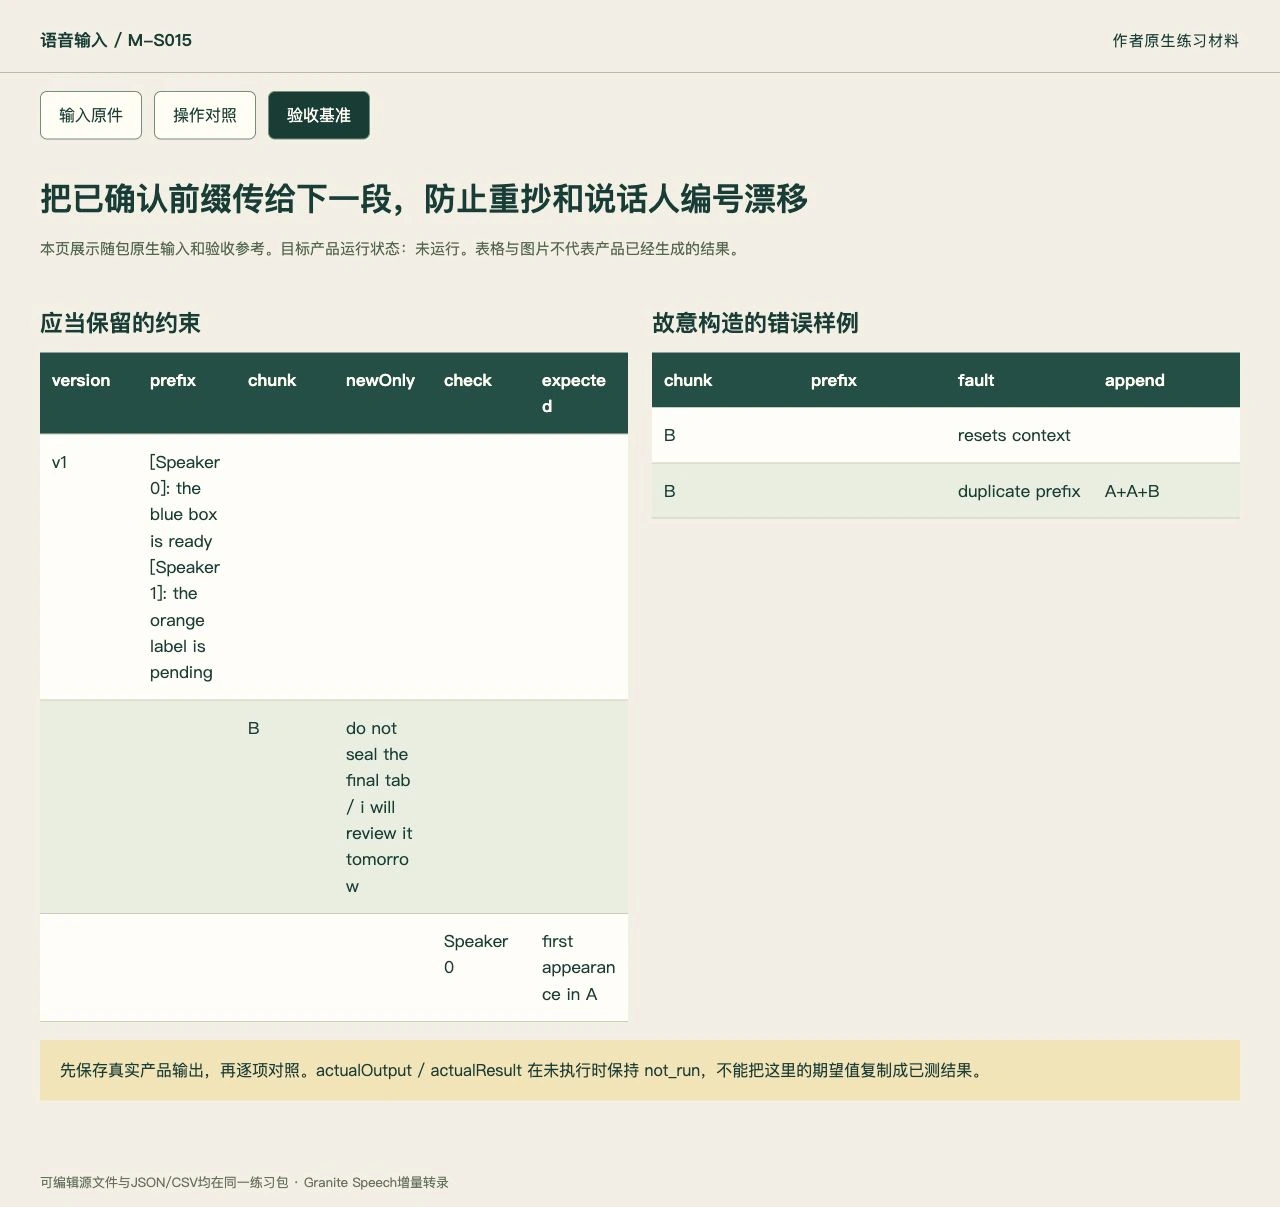
归档每块音频、前缀哈希、原始返回和拼接差异。作者脚本作为内容验收基准,未运行模型时返回栏保持未测。
下载本课材料并开始操作
练习包包含本课的具体输入、可编辑数据、正反样例与七步说明。index.html 可离线查看原件和验收参考,actual-results.csv 用于记录你实际操作后的结果。
怎样确认已经完成
- 第二块请求记录确切prefix_text与版本,输出拼接不重复已确认文本。
- 说话人编号按首次出现顺序,不当作真人身份或跨文件永久ID。
- 前缀错误可追溯重做,不用覆盖原始第一块。
常见问题
Granite分段转录怎么减少前文重复?
确认上一块逐字稿后,把它按当前 Plus 格式放入 prefix_text,下一块分别保存原始返回与新增文字。回查重抄和说话人编号延续;前缀表示此前文本,不是让模型重新转录同一音频。
Speaker0一定一直是同一个真人吗?
它是当前对话按首次出现排序的标签,不是实名或永久声纹ID。跨文件、重置请求或修订前缀时都要重新核对映射。