
展开本页目录
开始前准备什么
- Python环境与本地CPU;Indra使用ONNX,不需要PyTorch或GPU,首次运行需下载约76MB默认模型,math模型另计。
- 代码Apache2.0;权重modified OpenRAIL-M,有企业规模与竞争用途限制,不能宣传无限制免费商用。
- 本课原生材料可离线免费检查;目标识别未执行,实际page.source/conf/坐标只能运行后填写。
- 准备三类页面
- 运行auto基线
- 比较强制ocr
- 比较强制text
- 解释hybrid来源
- 检查每页覆盖
- 交付路由矩阵
1. 准备三类页面
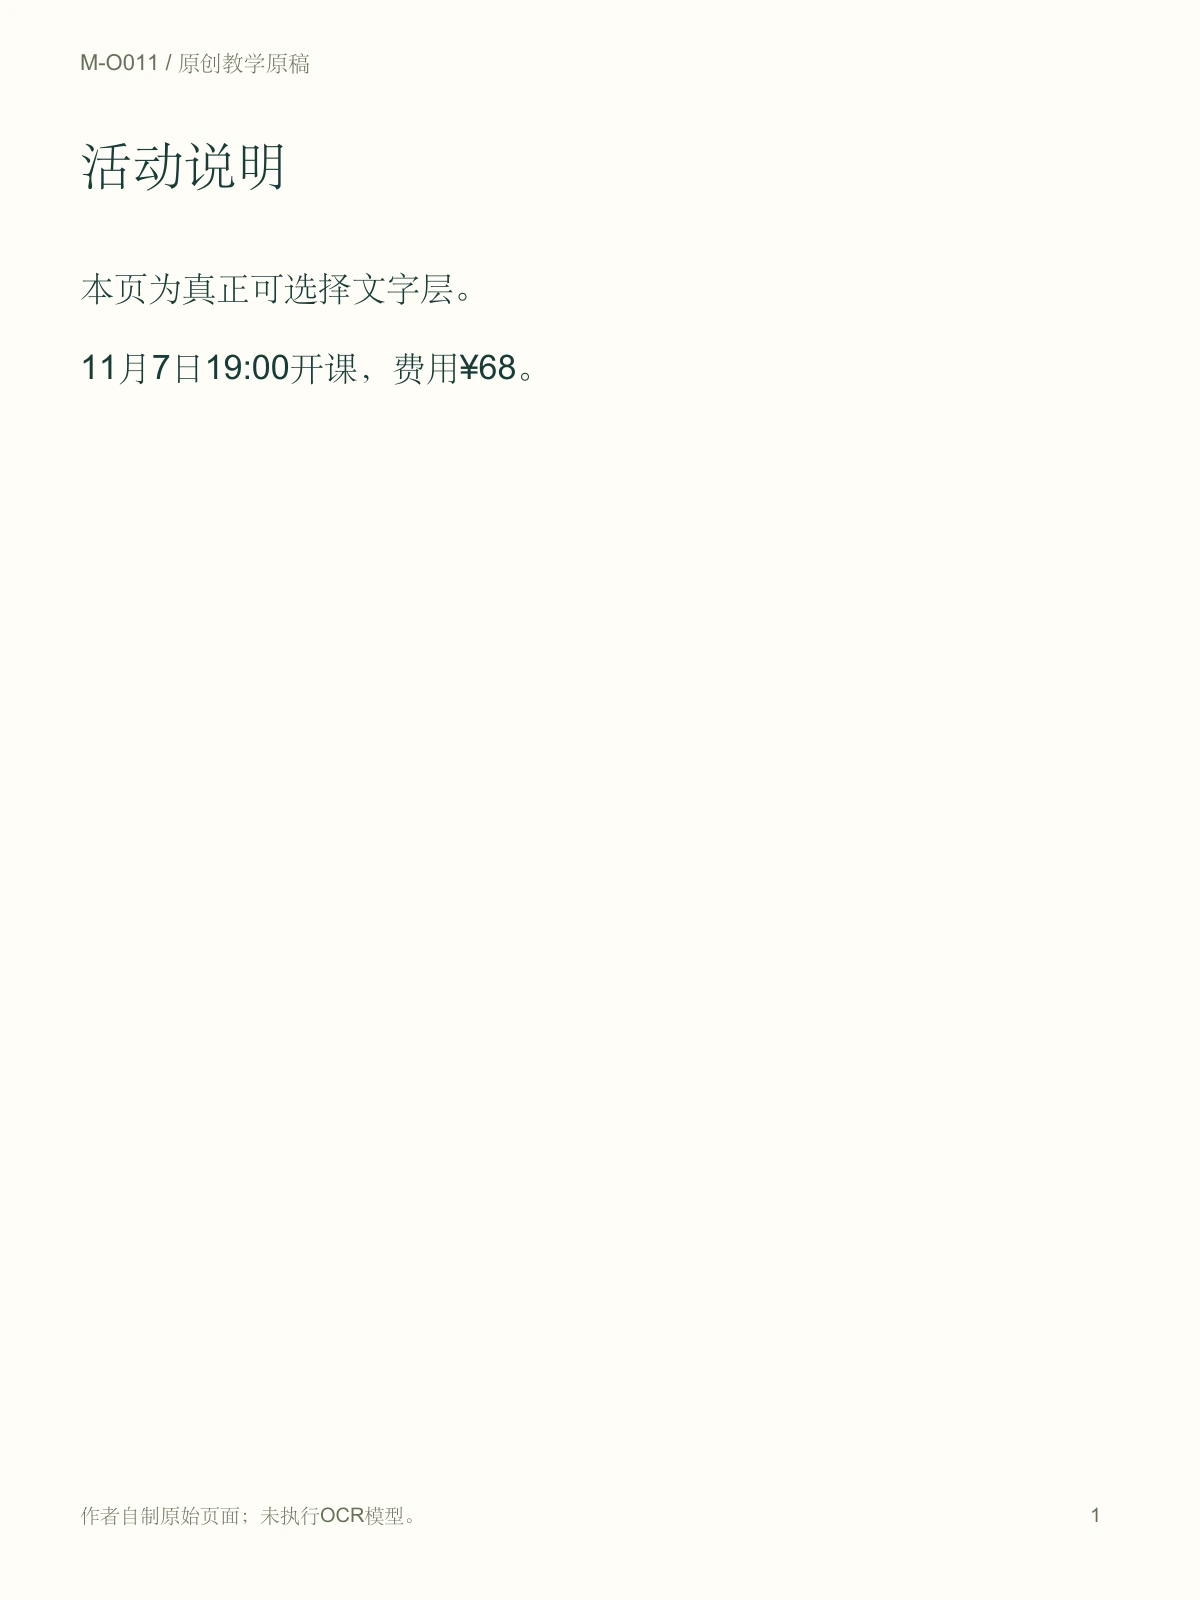
第一页为可选择文字,第二页为仅图像扫描,第三页含文字与图片内标签。
保存每页实际组成,不用扩展名推断有无文字层。
2. 运行auto基线
用--mode auto与--format json记录逐页source和note。
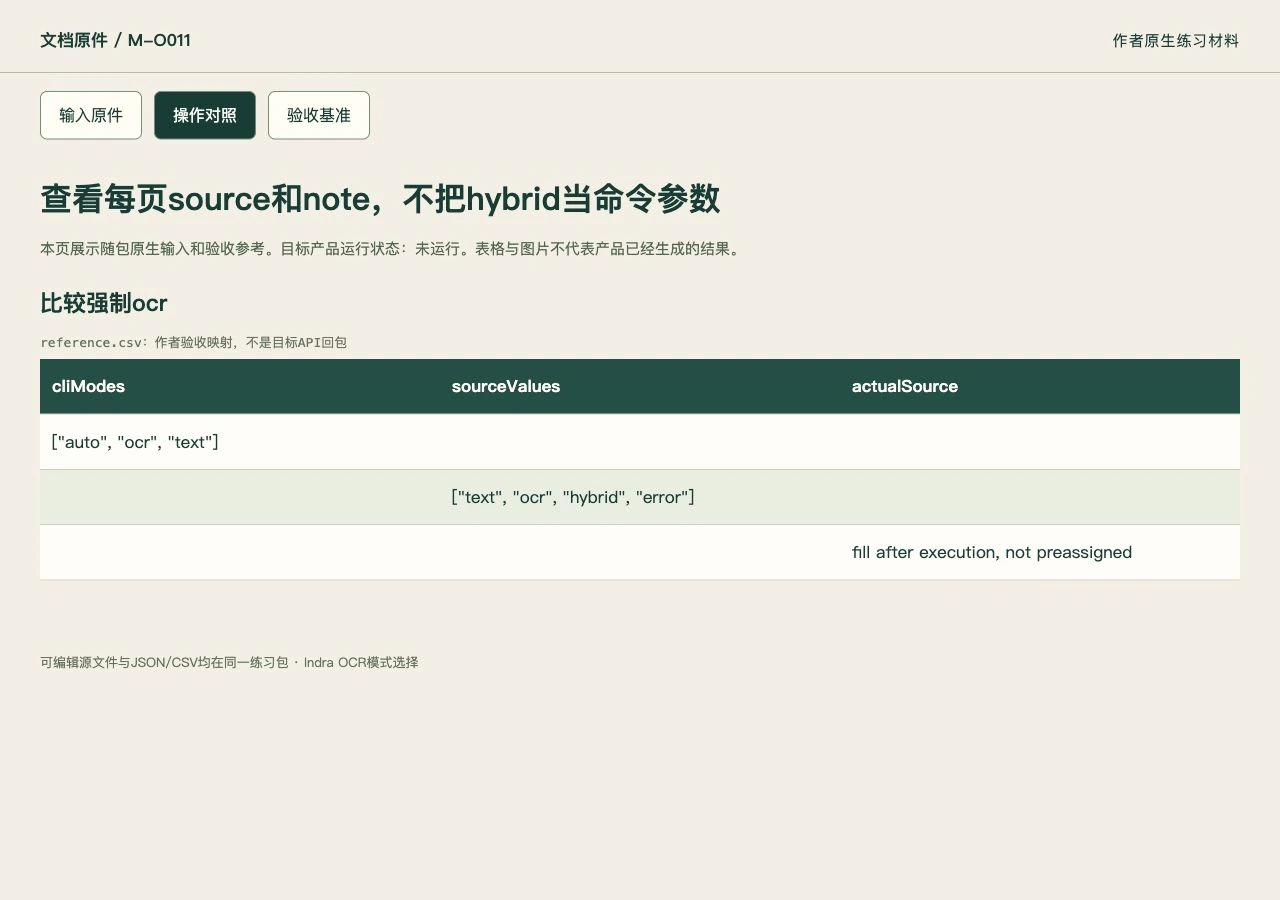
auto通过检查才读文字层,其余会走OCR,不是整份文件只选一个方式。
3. 比较强制ocr
在同一输入用--mode ocr重跑并另存结果。
该模式不读文字层,耗时和字符差异需实际记录。
官方界面与功能位置
以下为官方文档配图,具体版本与账号入口以当前产品为准。本课练习输入与验收对照见相邻步骤。
4. 比较强制text
用--mode text观察纯扫描页缺内容的风险。
text会使用文字层即使检查失败,不是“更安全”的默认选项。
5. 解释hybrid来源
遇到hybrid时回查是否文字层页又识别了图片内文字。
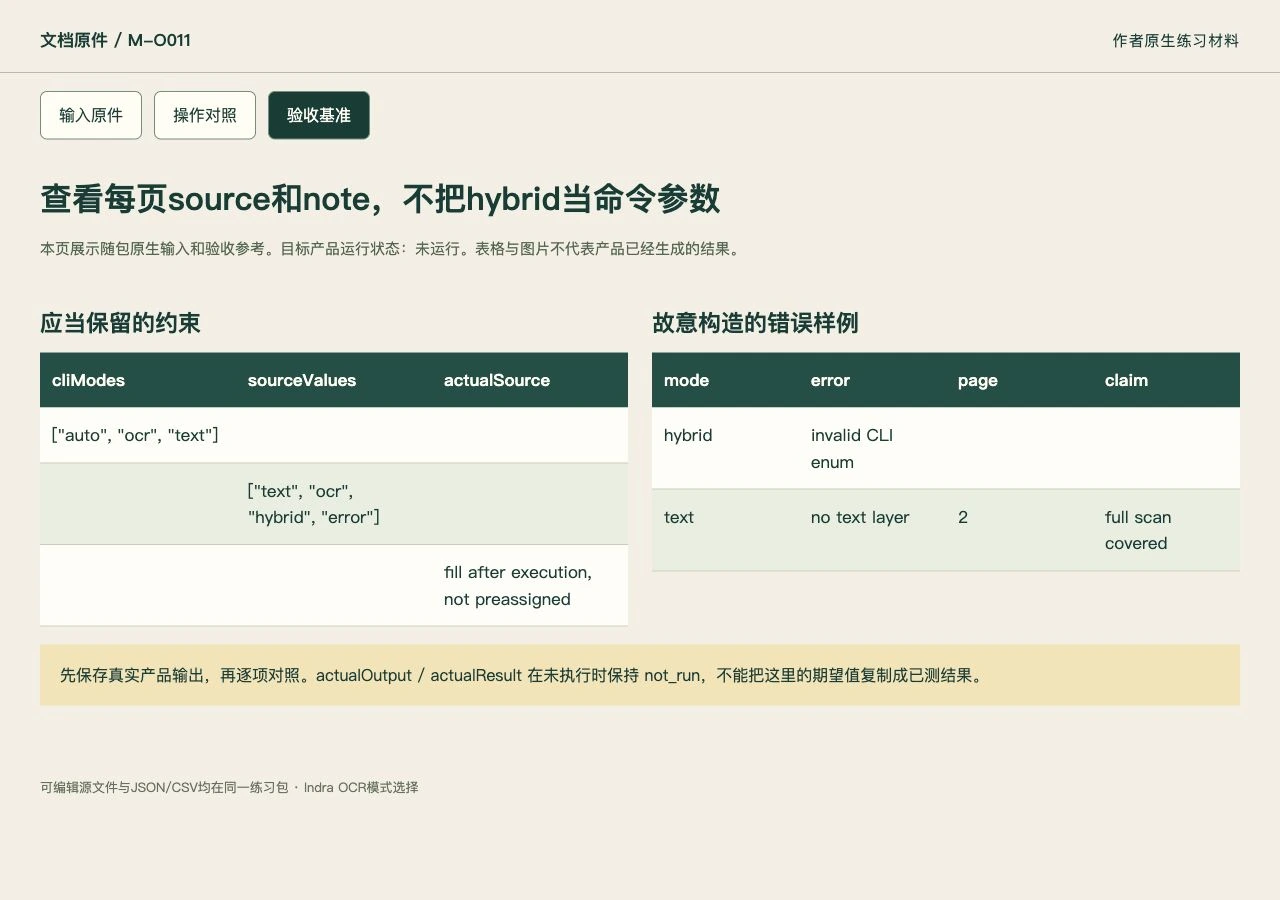
不要提交--mode hybrid,CLI没有这个枚举。
6. 检查每页覆盖
逐页确认标题与标签有无遗漏,并把source差异连回输入组成。
不同路由的结果不能只比总字数。
7. 交付路由矩阵
保存三模式命令、原始JSON与逐页结论。
未运行时source留待填,不把作者分类冒充程序判定。
下载本课材料并开始操作
练习包包含本课的具体输入、可编辑数据、正反样例与七步说明。index.html 可离线查看原件和验收参考,actual-results.csv 用于记录你实际操作后的结果。
怎样确认已经完成
- CLI模式只用auto/ocr/text。
- source与输入页组成逐项对照。
- hybrid没有被误当可传模式。
常见问题
Indra的hybrid模式怎么开?
hybrid是page.source的结果值,不是CLI模式。auto可在文字层页补识别图片中文字,从而形成hybrid;命令参数仍是auto、ocr或text。
PDF能复制文字,就一定不用OCR吗?
不一定。文字层可能不完整或未通过检查,也可能图片里还有字。本课保存每页source和note,再回看原页覆盖范围。