
展开本页目录
开始前准备什么
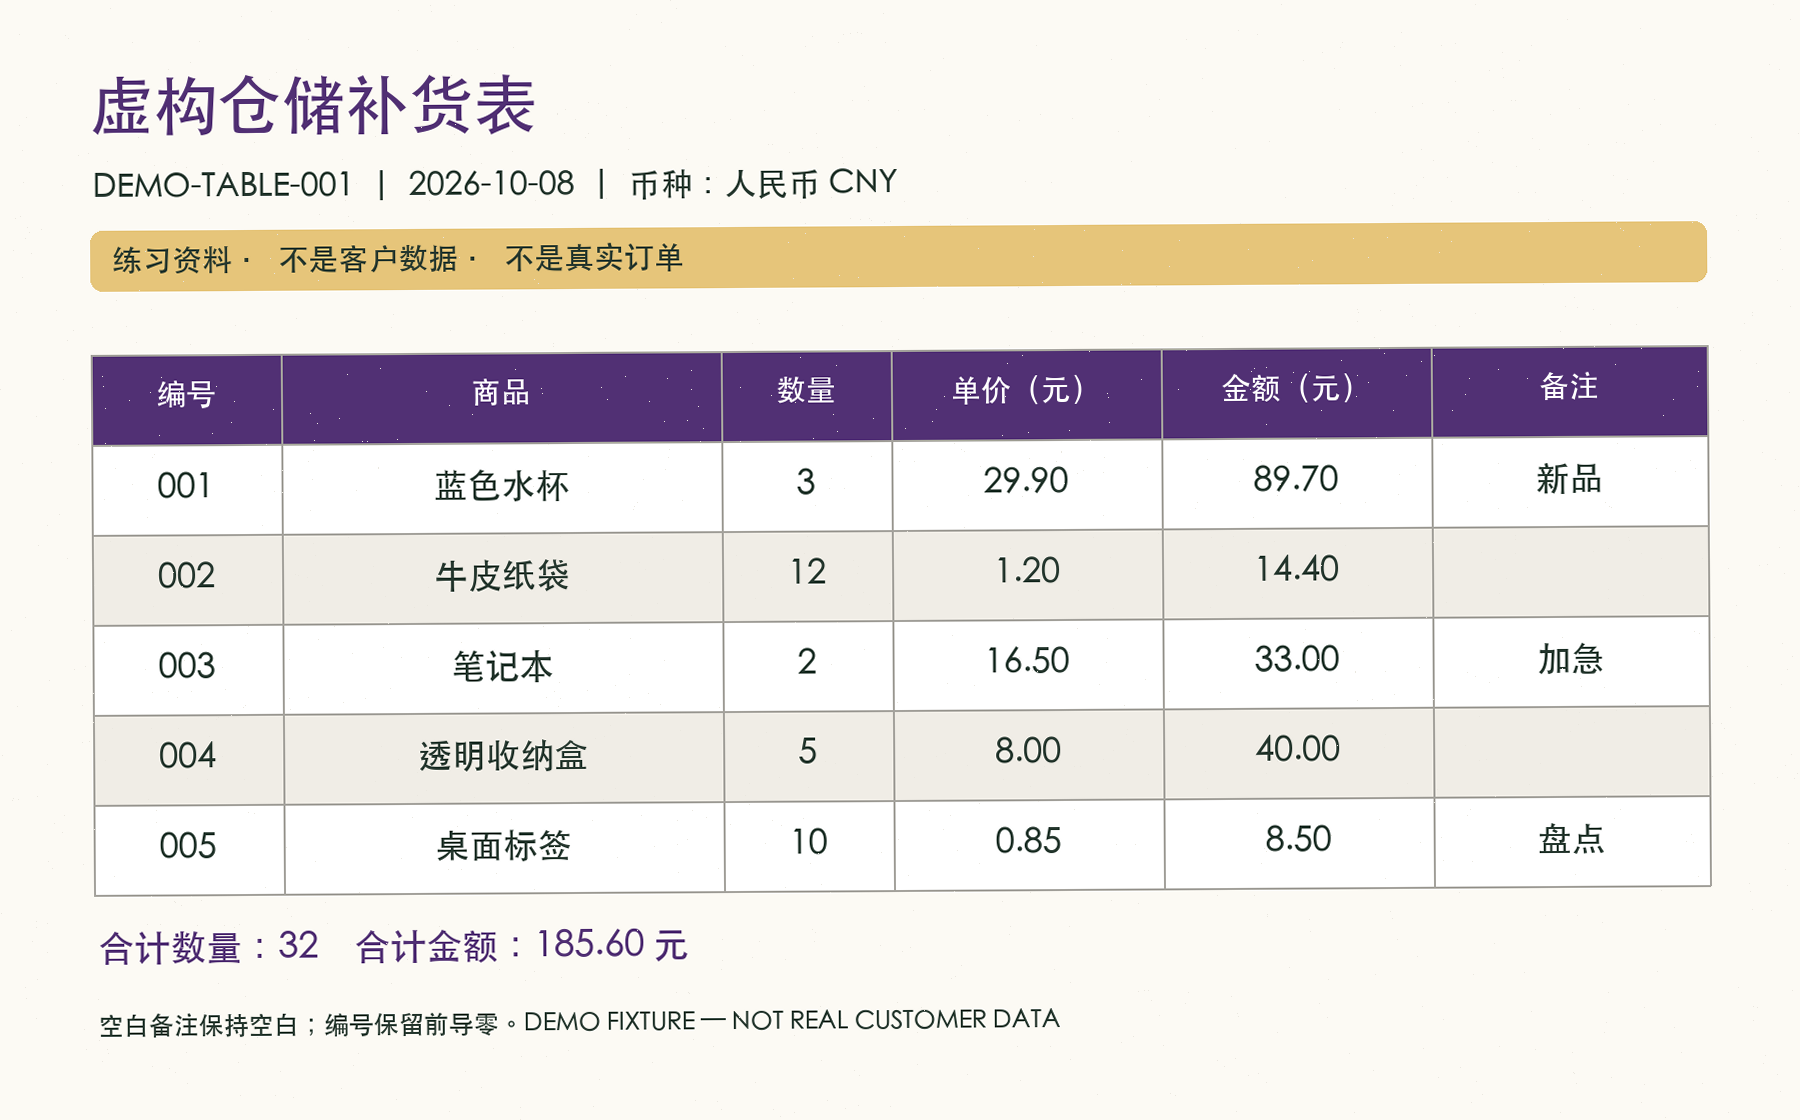
- 准备非敏感、已授权的 PDF;本页提供一页虚构表格扫描件。
- 检查加密、页数、实际页面大小和文字层;不要只依据 .pdf 后缀判断。
- 先本地渲染一页并检查清晰度,随后只提交需要识别的页。
- 在目标通道核对视觉消息能力;原生 PDF 支持需要单独验证。
- 识别 PDF 类型
- 逐页渲染
- 固定页序
- 提取块与表格
- 按页复核
说明依赖版本、离线命令、请求协议与验收边界;所有素材为虚构资料。
一页图片型 PDF,无可复制文字层;不是客户扫描件或原生 PDF API 实测。
本地 PyMuPDF 渲染,输出页码、实际宽高、SHA256 和文字层字符数,不联网。
要求保留页 ID 和文字块,不把合计、页眉或跨页表格盲目合并。
gpt-5.4-mini 读取原始 PNG 的 HTTP、耗时、usage 与检查;不是原生 PDF 上传测试。
本地编码真实图片,生成 Chat、Responses 或 Anthropic 请求体;不联网、不保存 Key。
先判断你手里的 PDF 属于哪一种
本页练习 PDF 仅嵌入虚构表格栅格,文字层字符数为 0。该判断来自本地文件检查;没有文字层并不表示页面空白,也不是 OCR 已执行。
| 类型 | 常见表现 | 处理路线 |
|---|---|---|
| 文字层完整 | 可以复制文字,文本内容与页面一致 | 优先本地提取文字;只对必要图表补视觉识别 |
| 扫描件 | 选不中字,整页是一张或多张图片 | 逐页转图,视觉读取或专用 OCR |
| 混合 PDF | 部分页有文字,部分页只有图片 | 按页分流,不能只检查第一页 |
| 旧 OCR 隐藏层 | 能复制但错字、顺序或内容不一致 | 对照页面;错误文字层不能当标准答案 |
- 类型
- 文字层完整
- 常见表现
- 可以复制文字,文本内容与页面一致
- 处理路线
- 优先本地提取文字;只对必要图表补视觉识别
- 类型
- 扫描件
- 常见表现
- 选不中字,整页是一张或多张图片
- 处理路线
- 逐页转图,视觉读取或专用 OCR
- 类型
- 混合 PDF
- 常见表现
- 部分页有文字,部分页只有图片
- 处理路线
- 按页分流,不能只检查第一页
- 类型
- 旧 OCR 隐藏层
- 常见表现
- 能复制但错字、顺序或内容不一致
- 处理路线
- 对照页面;错误文字层不能当标准答案
离线转图时,页号和文件一起保存
安装练习包说明中的 PyMuPDF 后运行。输出 page_001.png 与 manifest.json,记录源 PDF 哈希、source_page、实际宽高和文字层字符数。输出目录必须全新,避免不同版本的页混在一起。
示例限定 50 MiB、20 页、72–300 DPI 和每页 1600 万像素,这是本地处理范围;不是 API 接受上限。DPI 应以小字可读性和实际像素为准,盲目提高会增加文件大小及处理成本。
本地渲染,不上传 PDF
python3 growth-batch7-vision-pdf-to-images.py \
  scanned-table.pdf --dpi 144 --output rendered-pages
本站绘制的内容说明图:这是本地 PDF 渲染操作,不上传文件;50 MiB、20 页等限制属于脚本,不是 API 统一上限。
每页都有独立的提取状态
- 文本块按页面阅读顺序保留原文;表格另外保留列数、表头和空单元格。
- 页眉、页脚和合计单独标注,不能把重复页眉当新商品行。
- 一页失败只修该页;已获得响应的页不要整份 PDF 重跑。
- 跨页续表根据页码、表头和显式行号确认关系;相似名称不能证明是同一行。
候选记录结构,字段值为示意
{
  "document_id": "DEMO-TABLE-001",
  "page_id": "page_001",
  "source_page": 1,
  "status": "needs_review",
  "blocks": [
    { "block_id": "page_001_table_01", "kind": "table", "rows": [] }
  ],
  "uncertain_fields": []
}
转图方案与原生 PDF 上传要分别验
OpenAI 和 Claude 的公开文档描述了原生 PDF 输入,但协议、型号和平台处理方式各有条件。本页采用可检查的本地转图流程,不把公开文档当作 apizt 对应端点的实测结果。
若准备改用原生 PDF,先用同一练习件验证目标端点能否接收、页面顺序、图片内容是否被读取及实际费用;不要把 Chat 的图片块原样换成 PDF Base64。
OCR 完成后,仍要对照来源页
| 检查项 | 本页标准 | 失败处理 |
|---|---|---|
| 页序 | 原 PDF 第 1 页对应 page_001 | 错误页号先修映射 |
| 表格形状 | 6 列、5 条明细,合计另存 | 列偏移回看原图 |
| 数字 | 001 等前导零、两位小数与 CNY | 看不清留待确认,不补数字 |
| 空值 | 002 与 004 的备注为空 | 不能沿用相邻行备注 |
| 合计 | 数量 32、金额 185.60 | 计算冲突只标记,不改原文 |
- 检查项
- 页序
- 本页标准
- 原 PDF 第 1 页对应 page_001
- 失败处理
- 错误页号先修映射
- 检查项
- 表格形状
- 本页标准
- 6 列、5 条明细,合计另存
- 失败处理
- 列偏移回看原图
- 检查项
- 数字
- 本页标准
- 001 等前导零、两位小数与 CNY
- 失败处理
- 看不清留待确认,不补数字
- 检查项
- 空值
- 本页标准
- 002 与 004 的备注为空
- 失败处理
- 不能沿用相邻行备注
- 检查项
- 合计
- 本页标准
- 数量 32、金额 185.60
- 失败处理
- 计算冲突只标记,不改原文
本站绘制的内容说明图:这些条件来自本页扫描练习材料;算术冲突只标记,不改写图中原文以制造通过。
这张扫描图的视觉调用,已经与标准逐格核对
本地 PDF 检查和逐页渲染通过;真实模型请求读取的是原始 PNG,没有把 PDF 作为文件输入上传,也没有另跑渲染后图片的付费请求。两份证据分别支持文件处理和这张图的字段读取,不是整批 PDF 或原生文件端点的通过证明。控制台记录于2026-10-08 11:32:48(Asia/Shanghai),按本人测试凭证、型号、完成时间与输入1267/输出156 tokens匹配;USD 0.000364为控制台6位小数显示,不是通用报价。
| 本次实际记录 | 结果 | 范围 |
|---|---|---|
| 接口与型号 | gpt-5.4-mini · /v1/chat/completions | 实际输入为原始 table-input.png |
| HTTP / 耗时 | 200 / 11.812 秒 | 一次真实视觉请求,没有原生 PDF 上传 |
| 表格字段 | 5行6列、前导零、两处空白、表头和合计一致 | 仅这张虚构练习图 |
| usage | 输入1267 / 输出156 / 合计1423 tokens | 记录真实返回,不换算通用报价 |
| 实际扣费 | USD 0.000364 | 控制台花费列显示6位小数,仅代表本次通道 |
- 本次实际记录
- 接口与型号
- 结果
- gpt-5.4-mini · /v1/chat/completions
- 范围
- 实际输入为原始 table-input.png
- 本次实际记录
- HTTP / 耗时
- 结果
- 200 / 11.812 秒
- 范围
- 一次真实视觉请求,没有原生 PDF 上传
- 本次实际记录
- 表格字段
- 结果
- 5行6列、前导零、两处空白、表头和合计一致
- 范围
- 仅这张虚构练习图
- 本次实际记录
- usage
- 结果
- 输入1267 / 输出156 / 合计1423 tokens
- 范围
- 记录真实返回,不换算通用报价
- 本次实际记录
- 实际扣费
- 结果
- USD 0.000364
- 范围
- 控制台花费列显示6位小数,仅代表本次通道
怎样确认已经完成
- 全部页检查过文字层,混合 PDF 没有遗漏扫描页。
- 输出保留源文档、页号、哈希和真实图片宽高。
- 文字、表格、页眉与合计没有混入同一种明细。
- 不确定字段保留为空并能定位到原页。
- 本地转图、图片识别和原生 PDF 输入验证分别记录。
常见问题
没有文字层为什么提取出来是空文本?
普通文字提取读取文字层;扫描件的字在图片里。应检查页面图像,再使用 OCR 或已确认的视觉接口。
一次把几十页都传给模型会更准确吗?
不保证。先逐页保留来源与状态,只在需要跨页关系时补相邻页上下文,按任务核对限制和费用。