
展开本页目录
开始前准备什么
- LightOnOCR-3采用本地或自有授权服务;4B/0.8B为Qwen3.5架构,1B架构不同,显存还受图片与上下文影响,不承诺某张卡必定够用。
- 使用官方仓库锁定的兼容依赖;当前仓库说明vLLM0.30.0与Transformers5.16.1,模型卡的旧最低版本不能替代锁文件。
- 模型Apache2.0;仅空prompt或grounding是文档支持输入,原生PDF与检查无需付费,模型识别未执行。
- 准备含边栏的报告
- 保存全量grounding块
- 查看过滤集合
- 生成正文投影
- 核对脚注保留
- 回查来源位置
- 交付双层材料
1. 准备含边栏的报告
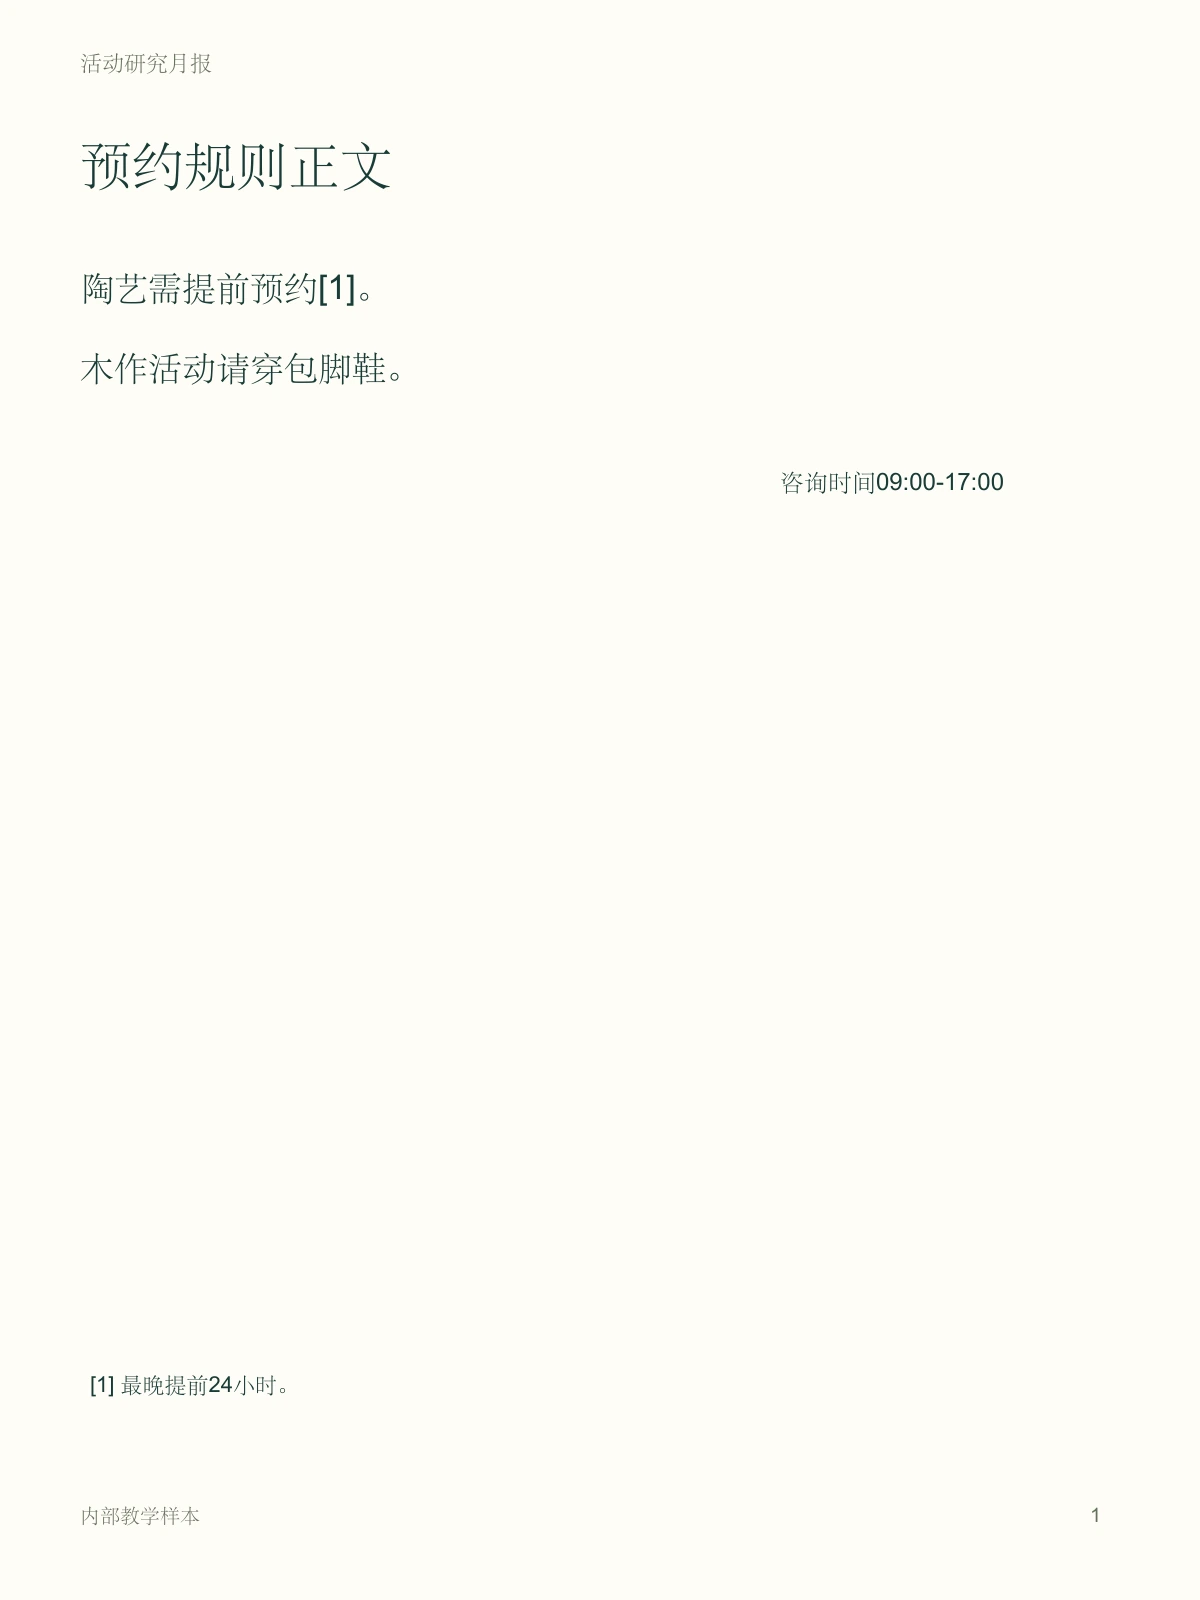
每页有页眉、页脚、页码和一条正文脚注。
原稿明确“脚注”与“页脚”不是同一用途。
2. 保存全量grounding块
从ocr.grounding取得完整blocks,逐项记label和来源页。
在生成正文视图前不删除任何原始块。
3. 查看过滤集合
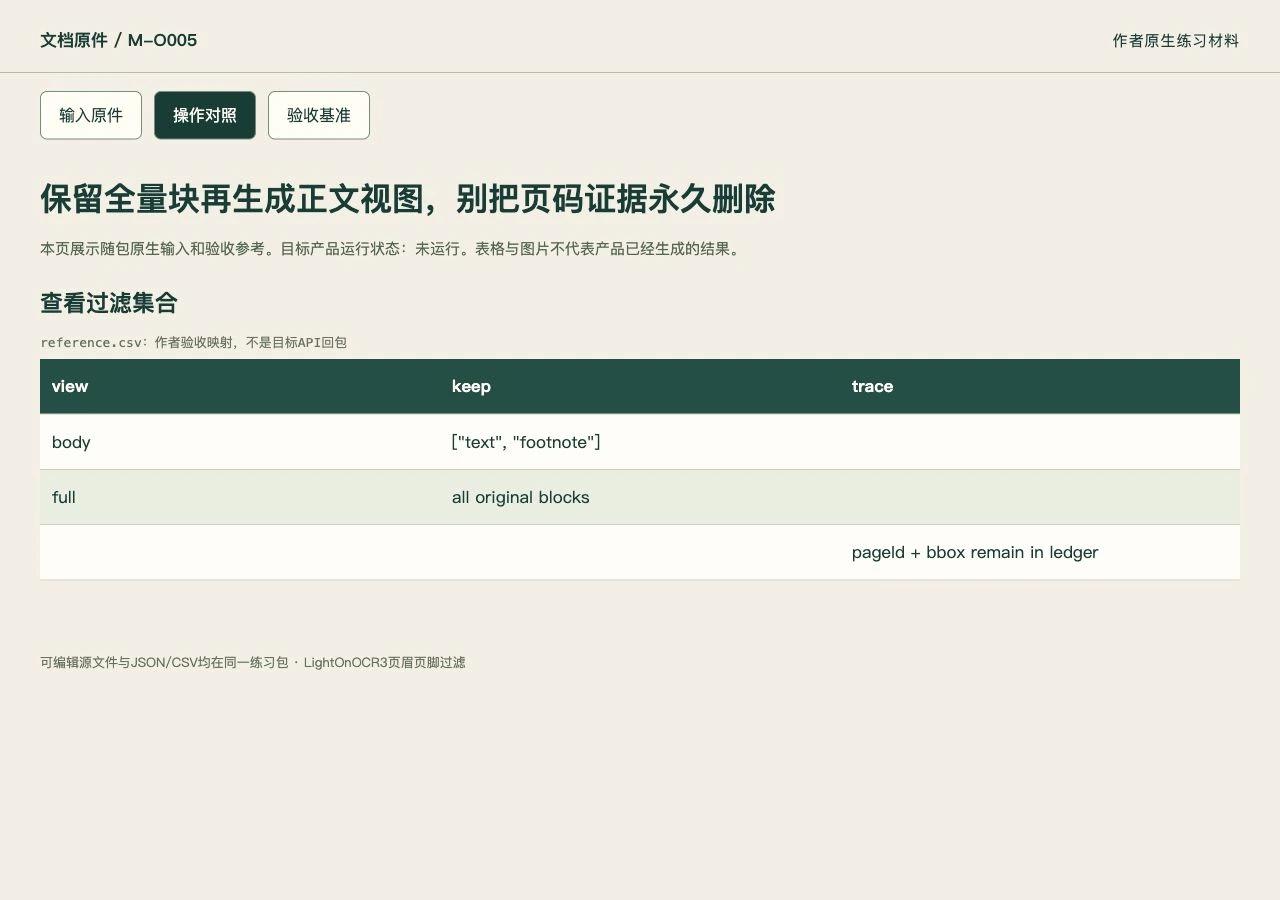
按当前官方HEADER_FOOTER常量理解被剔除标签。
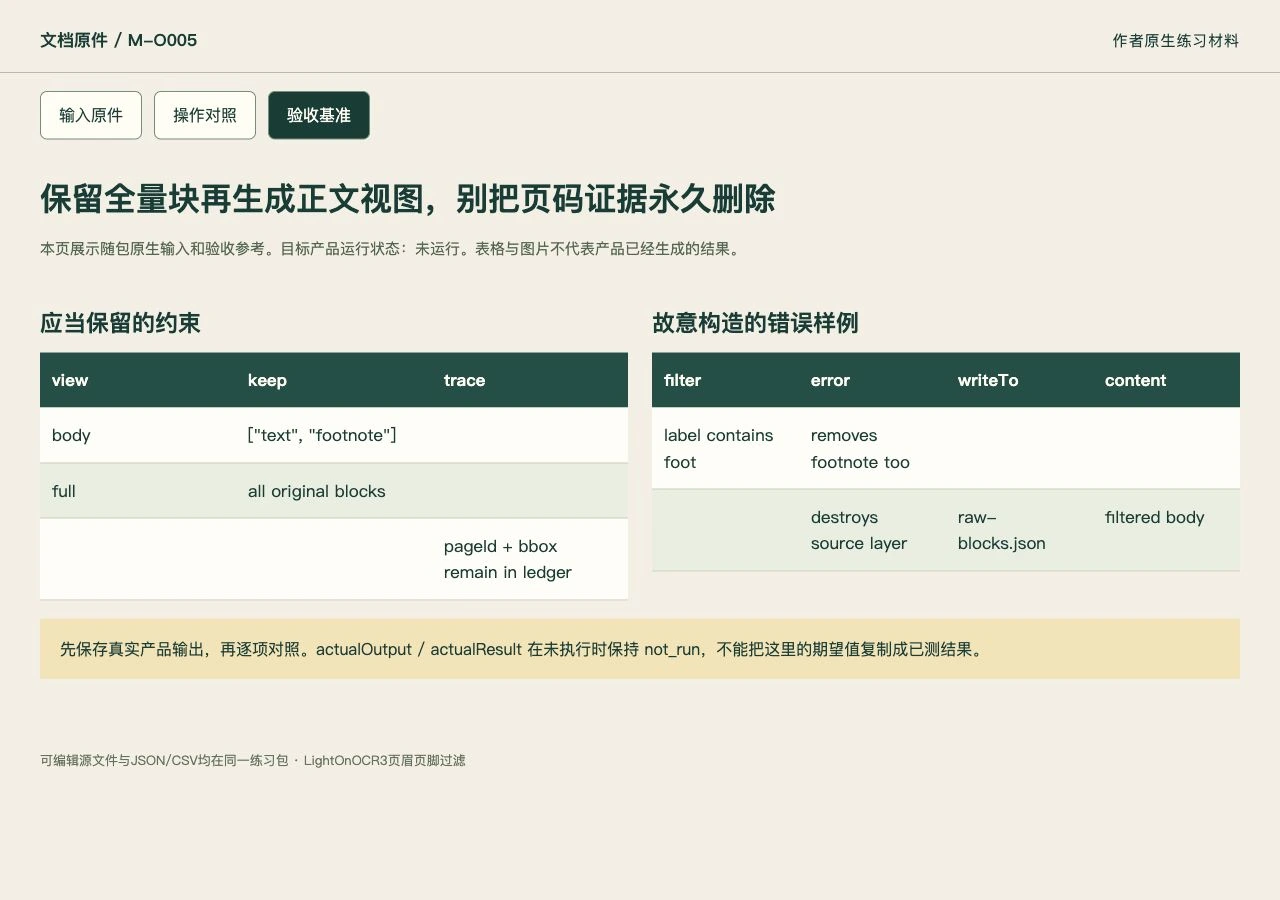
不要凭字符串包含foot就把footnote也删掉。
4. 生成正文投影
调用to_markdown(blocks,drop=HEADER_FOOTER)形成阅读版。
这是派生视图,不能覆盖全量块文件。
5. 核对脚注保留
检查正文提到的[1]与原页footnote仍可对应。
若规则将脚注误剔除,先修过滤条件,再重建视图。
6. 回查来源位置
从阅读版条目回到原始pageId与bbox。
没有页码显示不意味着来源可以不保存。
7. 交付双层材料
保存完整块和正文Markdown,并列出过滤策略。
未执行时用作者标签清单演示投影,标明不是识别结果。
下载本课材料并开始操作
练习包包含本课的具体输入、可编辑数据、正反样例与七步说明。index.html 可离线查看原件和验收参考,actual-results.csv 用于记录你实际操作后的结果。
怎样确认已经完成
- 全量块不被过滤输出覆盖。
- footnote和footer明确区分。
- 正文条目能回到原页框。
常见问题
去页脚时脚注也没了怎么修?
检查过滤是否用模糊的foot字符串匹配。本课使用明确label集合,并保留footnote,因为它可能解释正文条件。
已经有干净Markdown,还留全量块干嘛?
全量块保留页码和定位证据,派生正文便于阅读。两层材料分开,后续能重新调整清洗策略而不用重新OCR。