
展开本页目录
开始前准备什么
- 下载独立练习包,阅读README的版本、套餐与实跑范围。
- 教程按 MinerU 4.0 文档编写,需核对实际安装版本及 tier。许可为 Apache 2.0 加额外条款;在线服务标识、规模门槛与模型许可见官方 LICENSE。本站未安装 MinerU 或运行解析模型。
- 准备自己的可用模型与账户;不把示例模型占位名或地址当作已验证配置。
- 打开三页原创版式材料
- 取得完整的实际解析结果
- 分别调用两种布局模式
- 逐页核对位置和留白
- 选择文字并回读字段
- 检查实际PDF的页数和文字
- 保存两种结果与异常截图
1. 打开三页原创版式材料
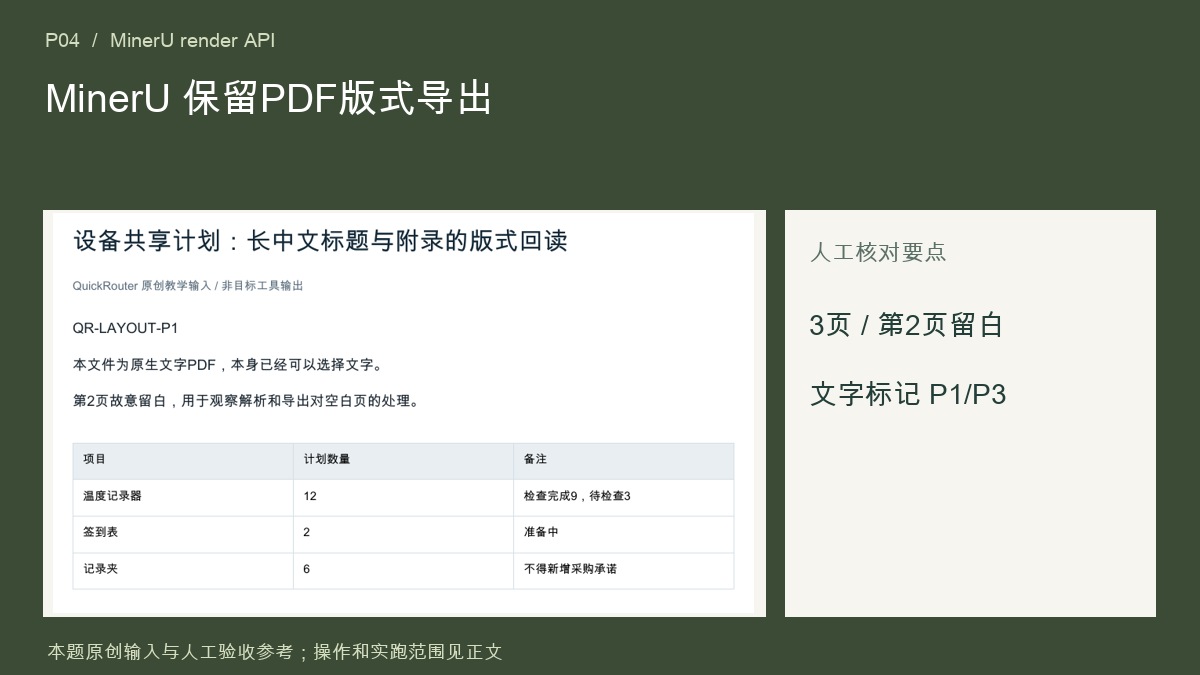
source.pdf 第1页是长中文标题与三列表,第2页故意留白,第3页是附录。它本来就含可选择文字,不是扫描件;本练习用于版式导出比较,不能证明 OCR 成功。
bash
python3 verify.py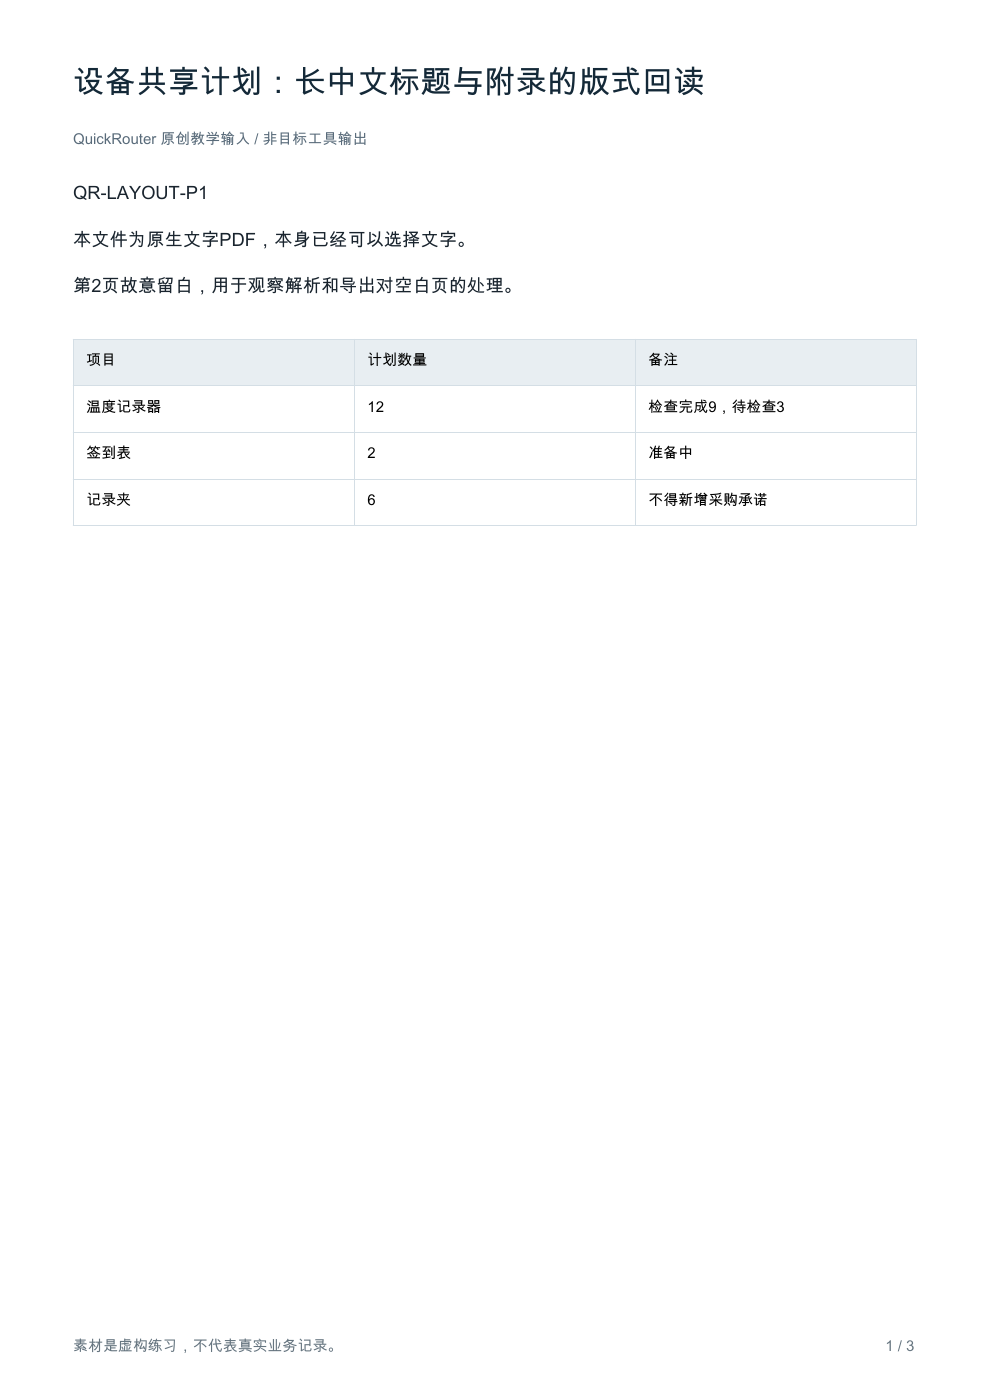
2. 取得完整的实际解析结果
用匹配的 MinerU 版本解析,保留 MiddleJson、页面几何和图片。mineru parse --json 是命令回执,不可直接冒充 ParseResult 的原生序列化结果。
3. 分别调用两种布局模式
参考 render-example.py,将自己的 ParseResult 交给 render_pdf;分别用 ORIGINAL 与 REFLOW 输出。渲染器支持 PDF 不代表 mineru parse 有任意 --format pdf 参数。
4. 逐页核对位置和留白
在同一个 PDF 阅读器比较同一页,确认长标题不重叠、表格没裁掉、第2页留白和页码范围均有解释。ORIGINAL 需要源几何,不完整时要按实际错误处理。
5. 选择文字并回读字段
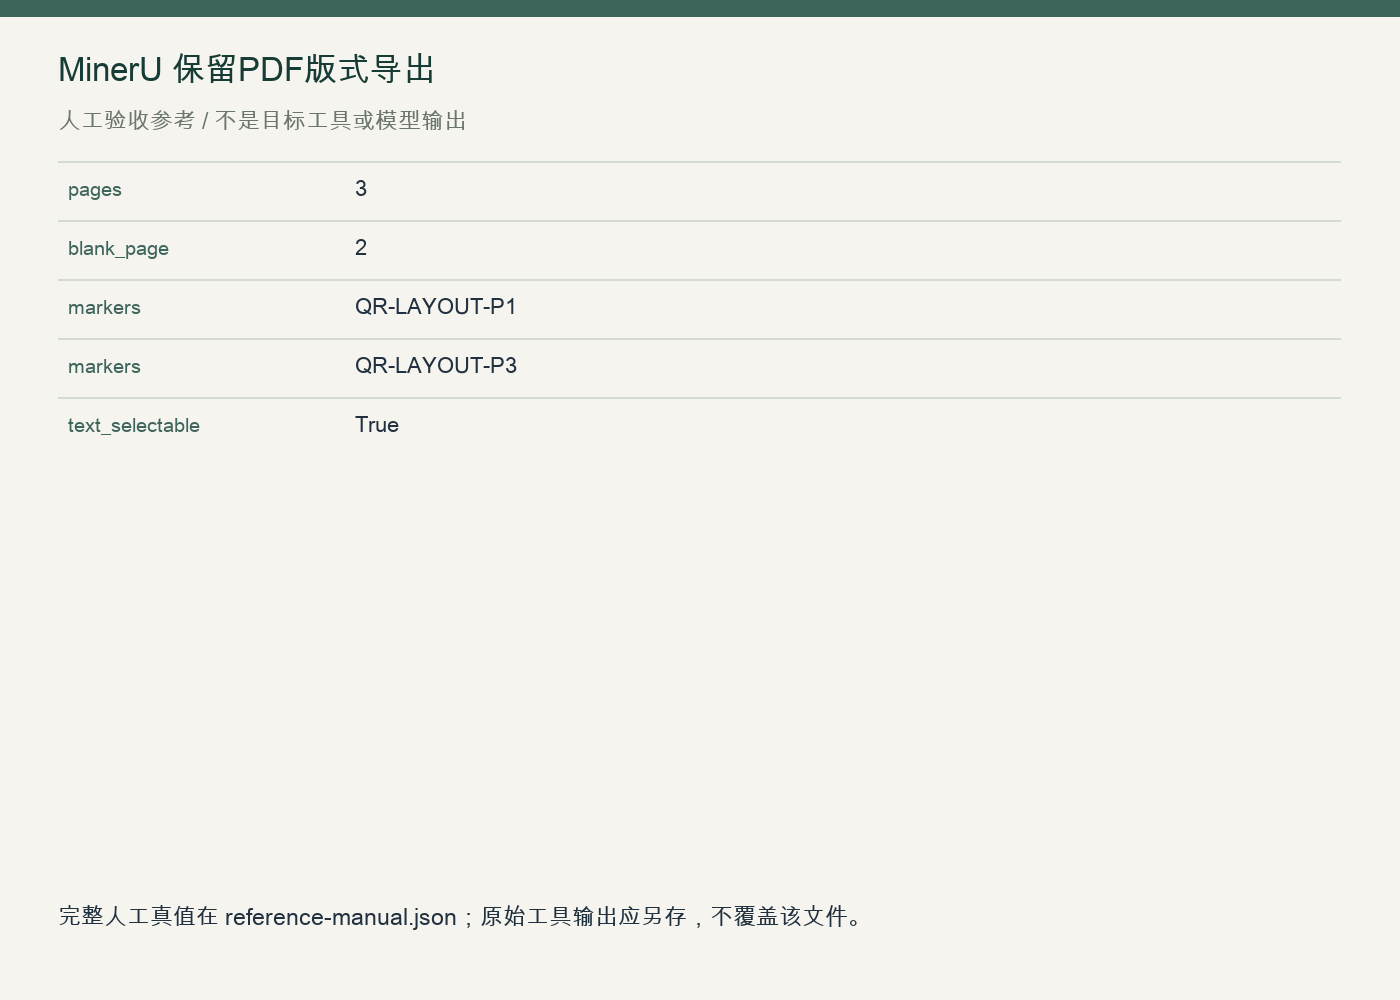
在自己导出的 PDF 选择 QR-LAYOUT-P1 和 QR-LAYOUT-P3,复制回文本编辑器核对。可选择文字与可编辑 Word 是不同结果,表格可能仍使用区域图像。
6. 检查实际PDF的页数和文字
安装 pypdf 后,用 --pdf 检查自己导出的文件页数与标记。该结构检查不能判断所有版式,仍需逐页看。
bash
python3 verify.py --pdf original.pdf7. 保存两种结果与异常截图
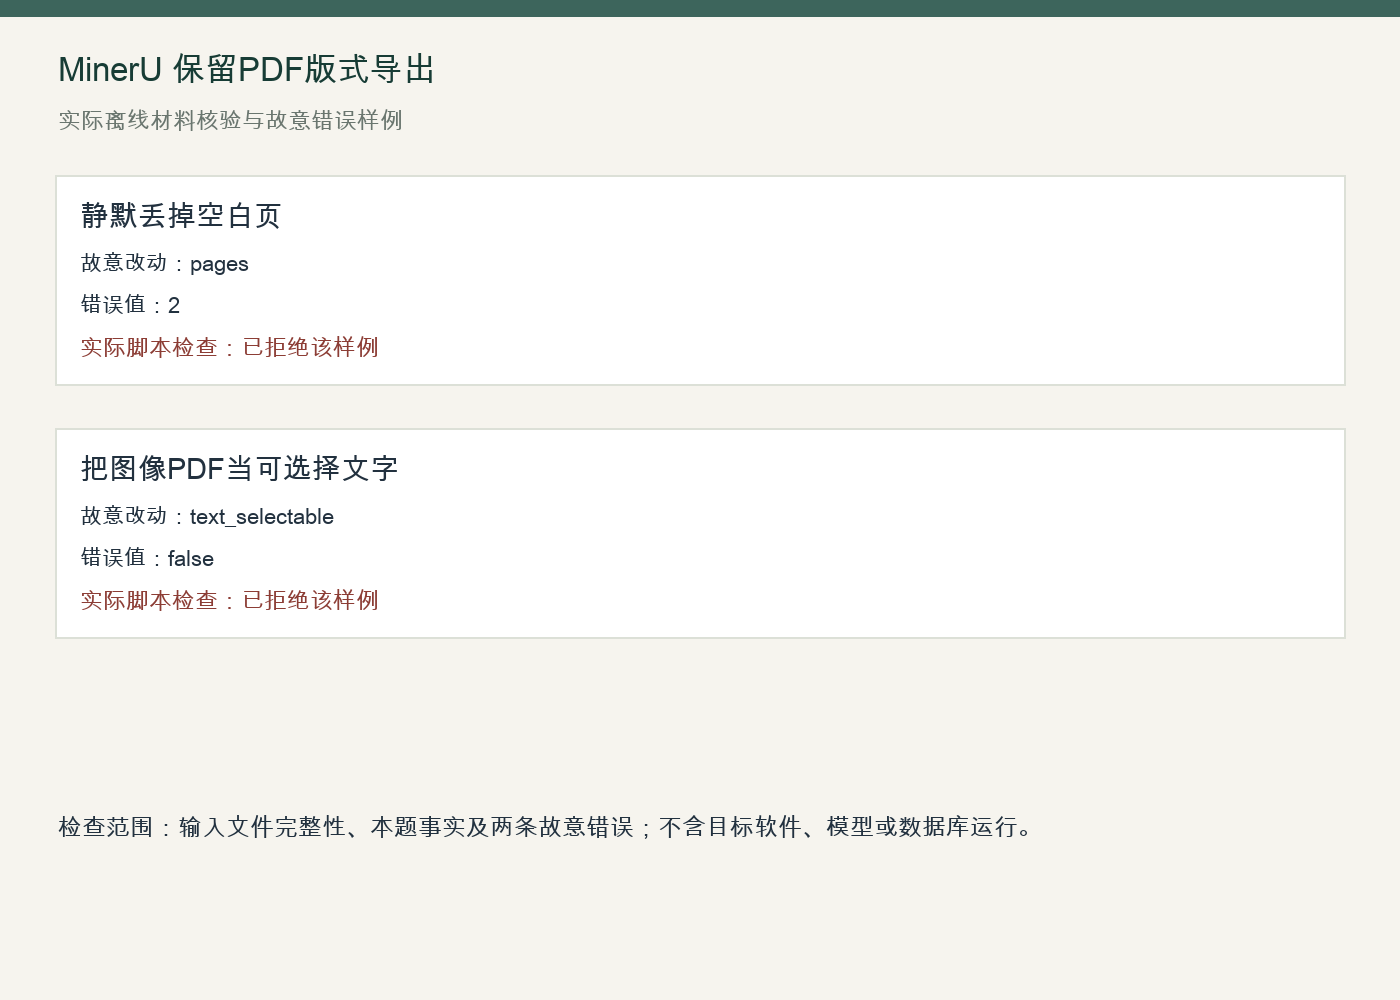
不要用本包原始 PDF 冒充 MinerU 导出;记录 parse/render 版本、模式与实际文件哈希。负例检查确保空白页丢失和无文字层不会被算作通过。
怎样确认已经完成
- 原始输入、来源和单位已保留,材料检查及两条故意错误样例均运行。
- 在真实工具保存原生输出,回读本题关键事实、缺值与来源;未运行部分仍标记未执行。
- 保存工具/模型版本和实际结果,人工修改与模型返回分开归档。
常见问题
保留原版与重排版PDF分别检查什么?
ORIGINAL检查原位置、表格与空白页;REFLOW检查重排后的文字顺序、缺漏与可读性。两版都回读实际文字层和页数,不能只看下载成功。
MinerU 保留PDF版式导出需要哪些条件?
教程按 MinerU 4.0 文档编写,需核对实际安装版本及 tier。许可为 Apache 2.0 加额外条款;在线服务标识、规模门槛与模型许可见官方 LICENSE。本站未安装 MinerU 或运行解析模型。
MinerU 保留PDF版式导出的图片和检查通过代表什么?
原始输入、人工参考与实际离线材料检查均有对应文件;官方图说明操作入口。目标软件和模型未执行的部分已在步骤中注明,不能用材料检查替代真实产品运行。