
展开本页目录
开始前准备什么
- Orange3.40.0,数值CSV与桌面环境;本题无需LLM Key/GPU。GPL-3.0-or-later;代码/扩展许可分别确认,不把聚类标签当个人价值判断。
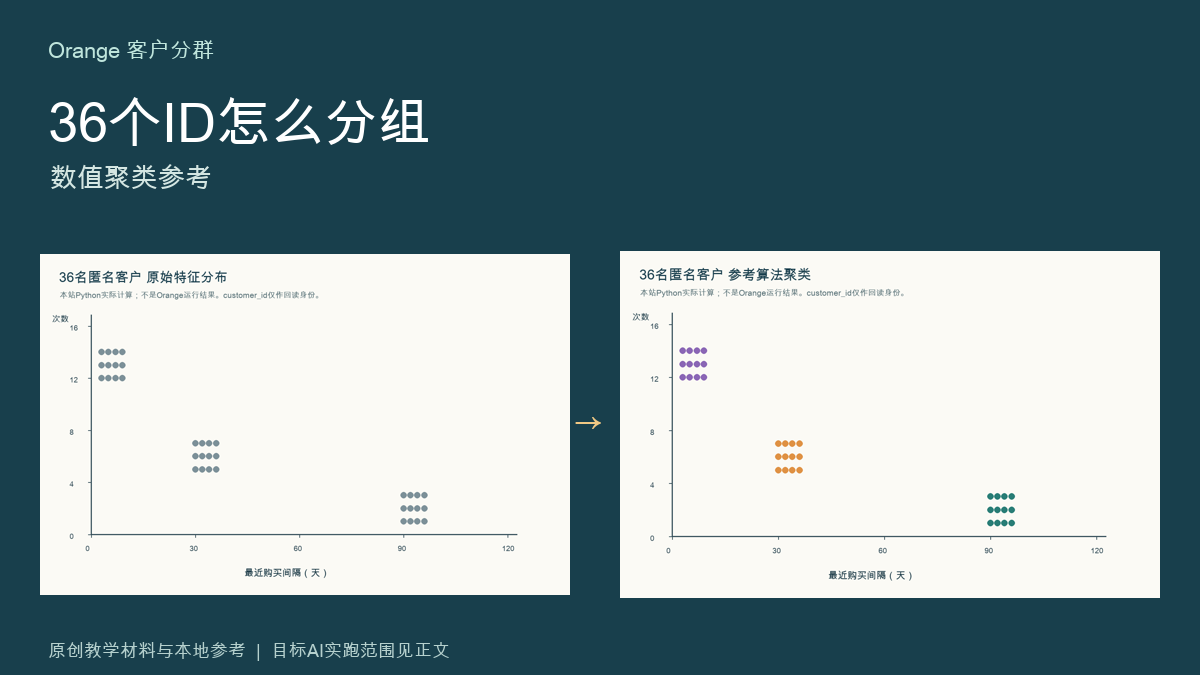
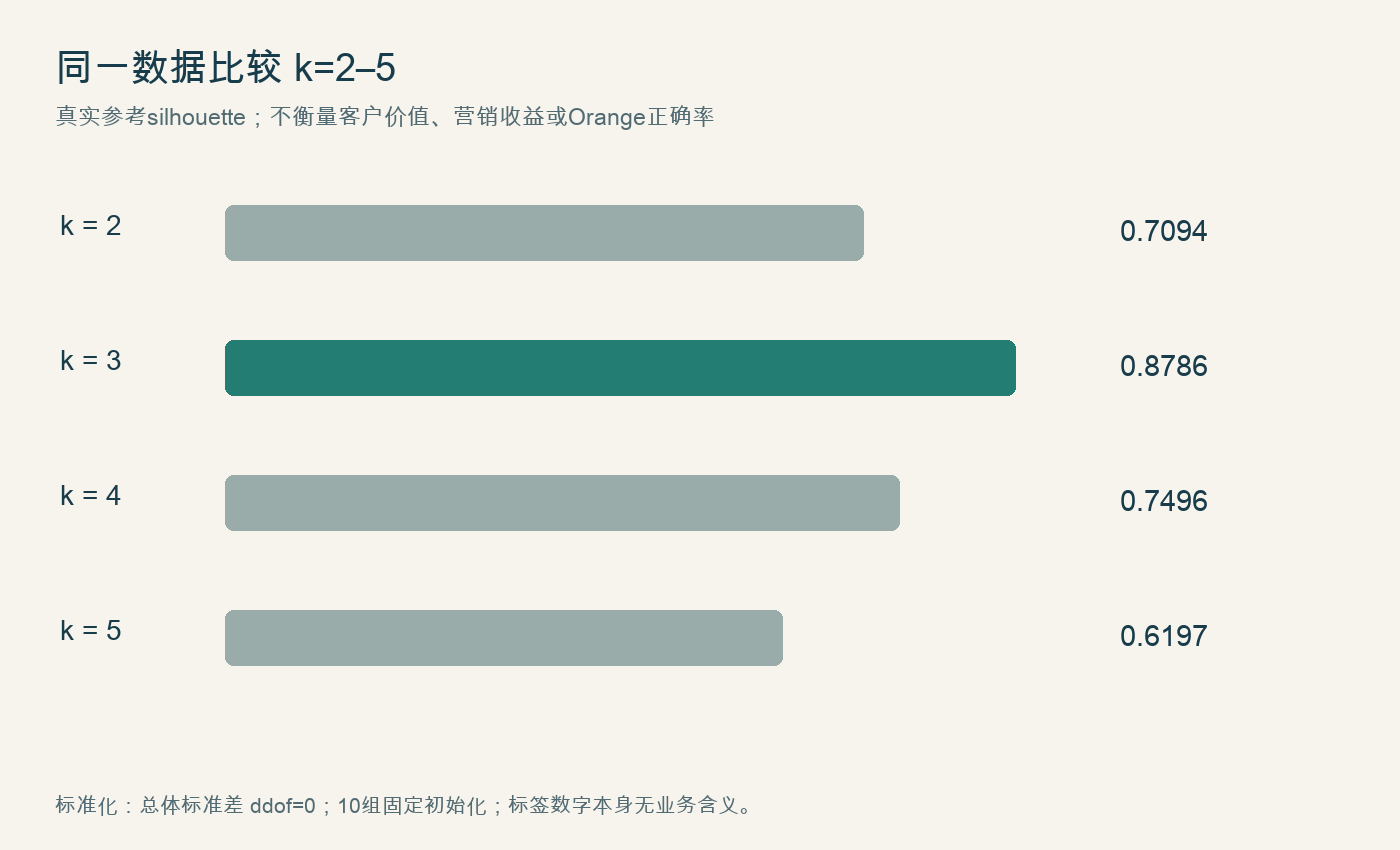
- 已用本站纯Python固定随机种子运行k-means参考,计算标准化、k=2–5与silhouette并导出逐行标签;未运行Orange桌面或保存其.ows。参考不代表客户分群业务效果。
- 使用原创或获授权资料;实际目标工具运行记录与本包参考分别保存。
- 读取匿名客户特征表
- 在Orange设置File和Select Columns
- 统一缺值和标准化规则
- 比较k=2–5的silhouette
- 查看散点、中心与边界样本
- 为群组写可核对的数值描述
- 用Save Data导出逐行标签
- 换数据复用前重新检查
原生输入、提示词、8步说明、独立参考和材料检查;运行范围见README。
区分目标工具操作、人工参考和本地实际执行。
本题独立原生输入或参考文件;身份和使用方法见README。
本题独立原生输入或参考文件;身份和使用方法见README。
本题独立原生输入或参考文件;身份和使用方法见README。
1. 读取匿名客户特征表
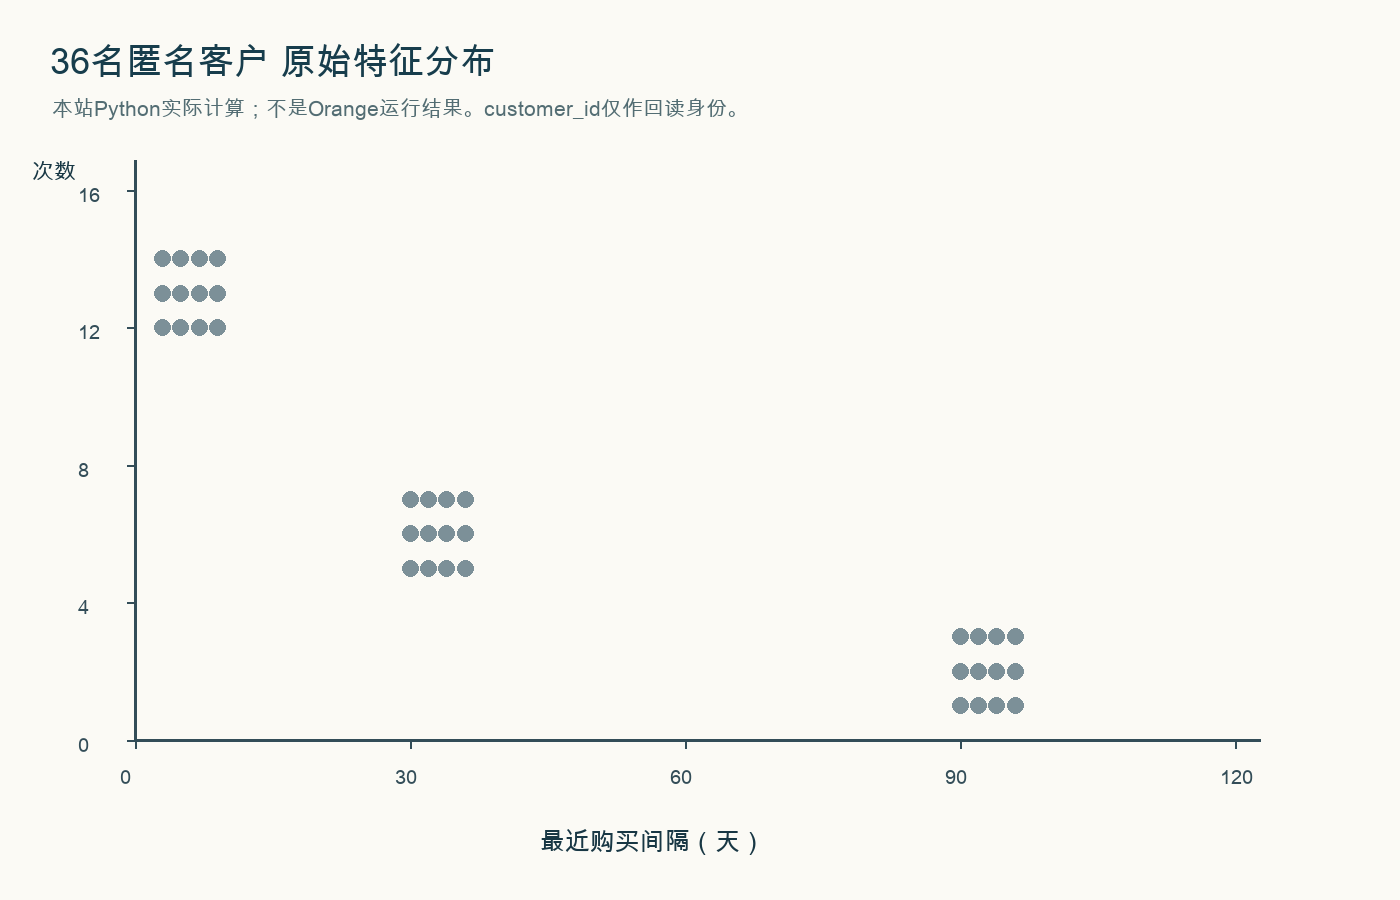
customers.csv是36行原创匿名教材,包含最近购买间隔、订单次数和金额。它故意有三类明显数值形态,适合演示流程,不能据此声称真实客户天然分三群或预测营收增长。
2. 在Orange设置File和Select Columns
用File载入CSV,再接Select Columns。customer_id放Meta,不要当数值特征;其余三列确认数值类型。ID只是回读行身份,不能把C01/C02数字当距离的一部分。
3. 统一缺值和标准化规则
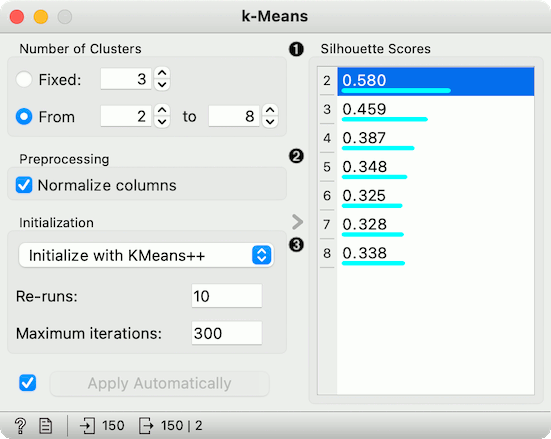
本样本没有缺值;自己的数据有缺值时先规定处理。k-Means会做默认预处理,文档说明可能以均值填补。勾选Normalize columns后观察各特征单位影响,不能把金额天然当成更重要的距离维度。
4. 比较k=2–5的silhouette
连接k-Means,范围设2到5,记录Re-runs与初始化方式。查看silhouette,用同一数据和设置比较;高分只表示当前距离定义下分离度更好,不表示销售额或营销转化更高。
5. 查看散点、中心与边界样本
把Data接Scatter Plot,按cluster着色,再接Silhouette Plot查看边界点。中心在标准化空间还是原尺度要说清楚,不能把标准化中心直接当成元或天。本包Python参考会明确ddof和随机种子。
6. 为群组写可核对的数值描述
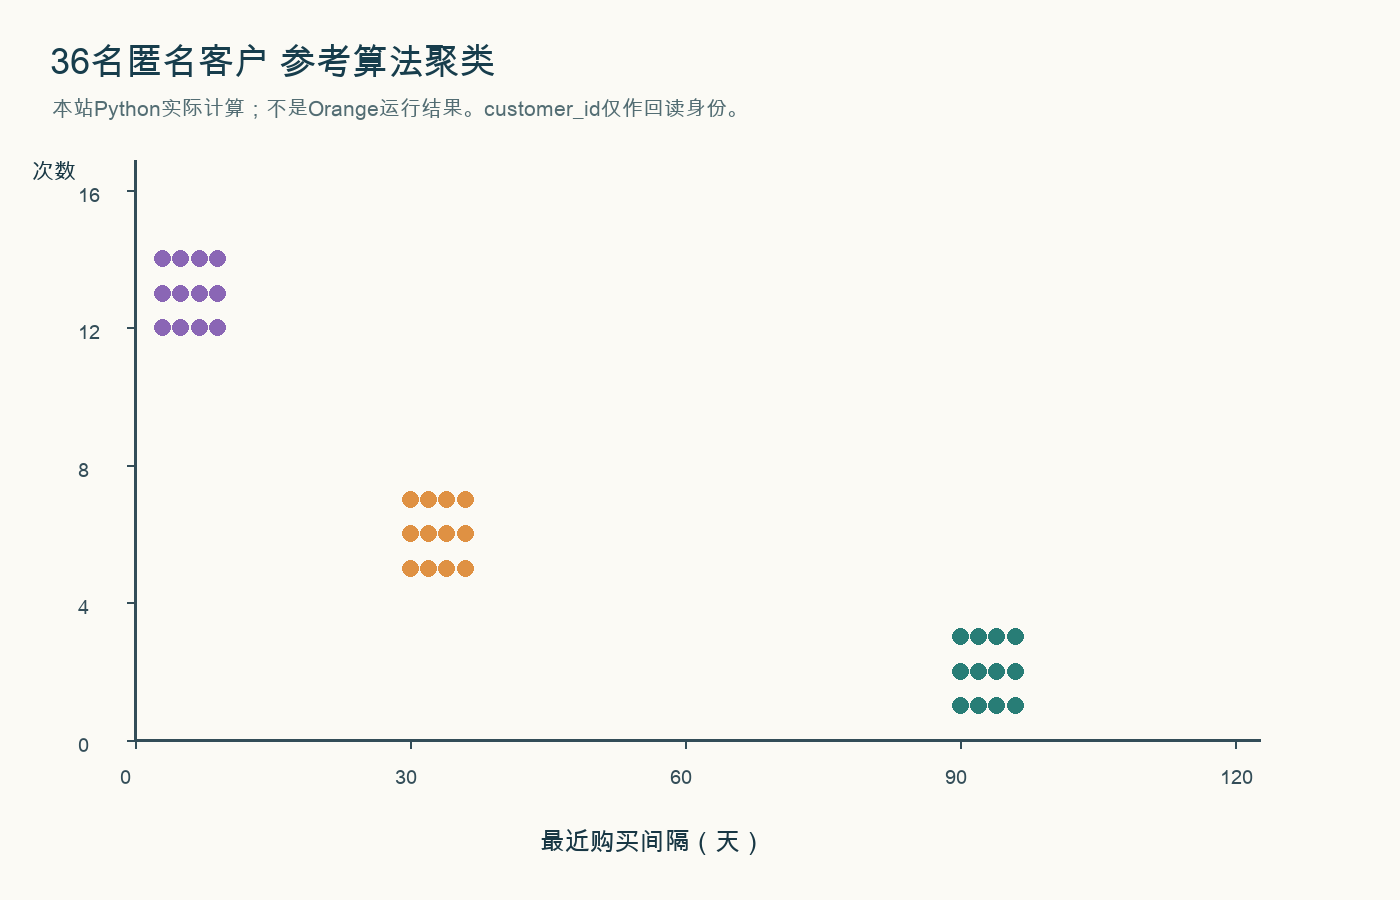
根据原尺度成员特征写“近期高频”“中等间隔”等描述,避免用优质/低价值当事实标签。检查异常或边界客户,不强迫每个人属于一个稳定不变的真实身份。
7. 用Save Data导出逐行标签
接Save Data导出带cluster的完整数据,核对36个ID各一行且没有Meta丢失。再在Orange保存自己的.ows。本包workflow-instructions.md说明真实连线,未伪造Orange .ows或运行截图。
8. 换数据复用前重新检查
替换CSV后先查类型、缺值、标准化和ID,再重新聚类与导出。cluster数字本身可能重排,不要仅凭C0/C1命名做跨期结论。本题下载的cluster-reference.csv是确定性算法参考,不能当Orange原生输出。
bash
python3 cluster_reference.py怎样确认已经完成
- 把Data接Scatter Plot,按cluster着色,再接Silhouette Plot查看边界点。中心在标准化空间还是原尺度要说清楚,不能把标准化中心直接当成元或天。本包Python参考会明确ddof和随机种子。
- 接Save Data导出带cluster的完整数据,核对36个ID各一行且没有Meta丢失。再在Orange保存自己的.ows。本包workflow-instructions.md说明真实连线,未伪造Orange .ows或运行截图。
- 已用本站纯Python固定随机种子运行k-means参考,计算标准化、k=2–5与silhouette并导出逐行标签;未运行Orange桌面或保存其.ows。参考不代表客户分群业务效果。
常见问题
Orange 客户分群需要什么版本和条件?
Orange3.40.0,数值CSV与桌面环境;本题无需LLM Key/GPU。GPL-3.0-or-later;代码/扩展许可分别确认,不把聚类标签当个人价值判断。
不会写代码怎么做客户分群,这份练习能证明哪些部分?
已用本站纯Python固定随机种子运行k-means参考,计算标准化、k=2–5与silhouette并导出逐行标签;未运行Orange桌面或保存其.ows。参考不代表客户分群业务效果。
一张客户表分成几类比较合理?
接Save Data导出带cluster的完整数据,核对36个ID各一行且没有Meta丢失。再在Orange保存自己的.ows。本包workflow-instructions.md说明真实连线,未伪造Orange .ows或运行截图。
Orange Data Mining customer segmentation k-means silhouette export labels 对应哪份可下载材料?
从本题独立练习包开始,先看customers.csv;按正文目标工具步骤生成自己的结果,不能把人工或参考算法文件改名当成模型输出。