
展开本页目录
开始前准备什么
- 下载并解压独立练习包,先读 README 的实际执行范围。
- 使用原创或获授权输入,保留原文件、软件版本与失败记录。
- 模型和在线渠道需要单独准备;不包含权重、真实密钥或付费额度。
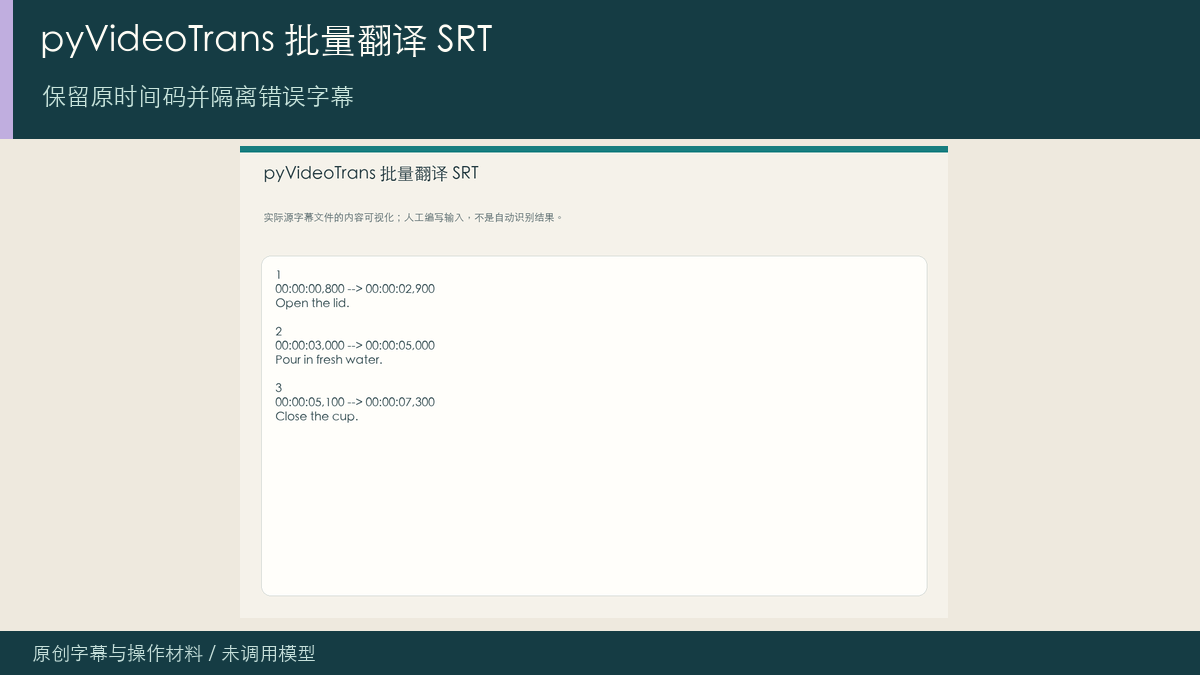
- 检查三份原始字幕
- 进入翻译字幕功能
- 固定源语言与目标输出
- 设置渠道和上下文
- 另存到新的目录
- 逐条比较时间码与内容
- 仅重试失败文件
原创输入、操作脚本、来源与验收说明;未运行范围逐项标明。
1. 检查三份原始字幕
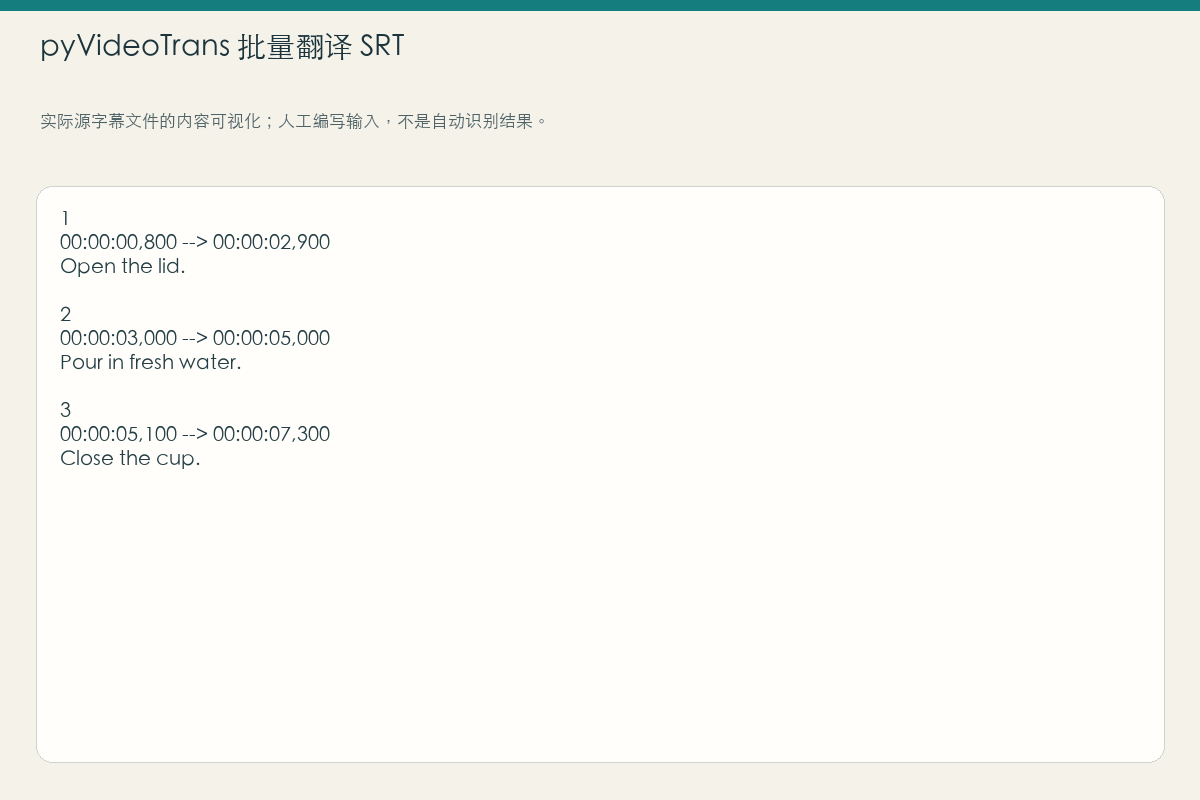
inputs/ 含三份原创 UTF-8 SRT,另有 broken.srt 作为有意错误的负例。先运行 verify.py;坏时间码必须拒绝,不应悄悄跳过后仍宣称全部翻译成功。
2. 进入翻译字幕功能
使用 v4.16 的翻译字幕入口,选择文件夹或多份文件。任务只翻已有字幕,不重新提取音频,也不自动给没有视频的 SRT 生成 MP4。
3. 固定源语言与目标输出
设定英语到简体中文,先选单语输出以便逐条比较。双语输出应另存新文件,不能把多一行文字误判为多出字幕事件。

4. 设置渠道和上下文
选择实际可用的 AI 翻译渠道,按需开启发送完整字幕与术语表;先检查兼容请求和费用,密钥只填本地配置。包内不带真实密钥,也没有已调用的翻译结果。
run-example.sh
uv run cli.py --task sts --name "$PWD/source.srt" --target_language_code zh-cn5. 按输入文件分别保存翻译状态
为三份合法 UTF-8 SRT 建立输入摘要和输出文件映射,译文写入新目录,坏时间码的 broken.srt 单独拒绝。保留每个文件的成功或失败,不因其它文件可打开就把整批标完成。
比较时按字幕事件编号核对 start/end 与译文;双语多一行文字不是多一个事件。源码 CLI 的 sts 任务与 Windows 整合包 GUI 分开记录。
6. 逐条比较时间码与内容
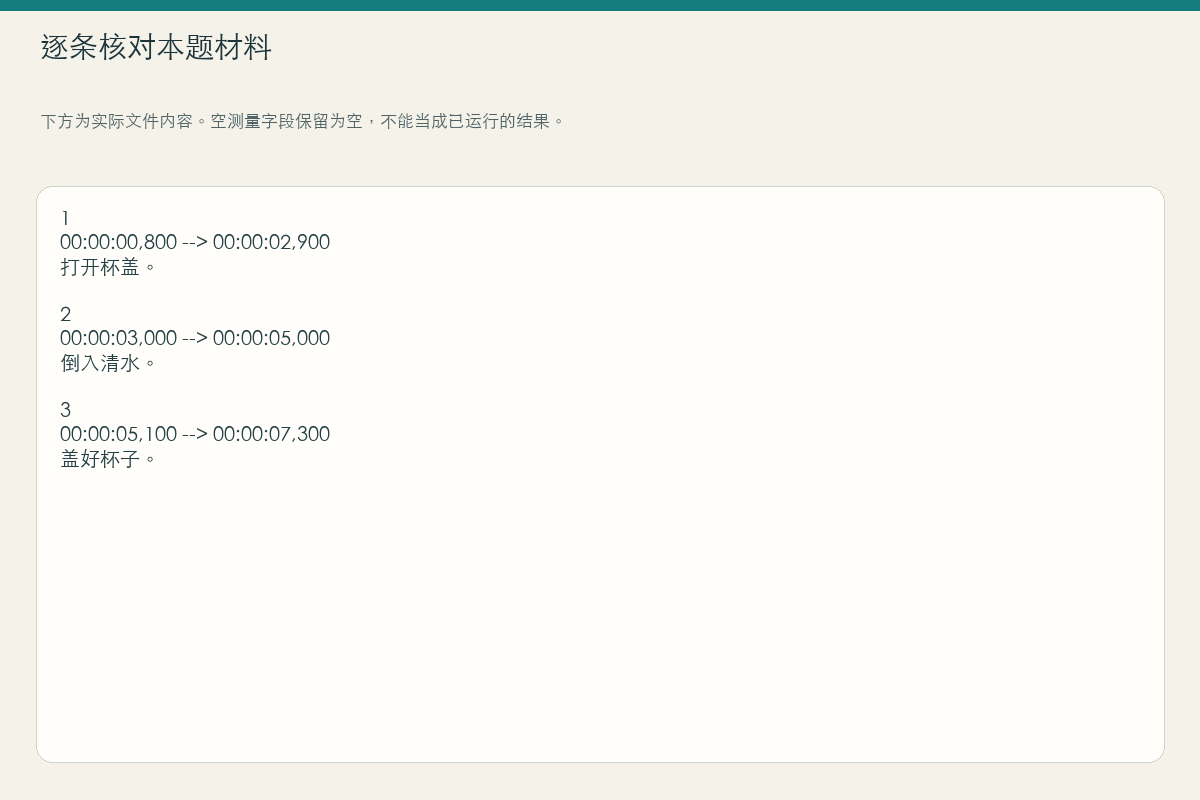
每份结果用 verify.py --source-srt inputs/demo-2.srt --result-srt 实际demo-2结果.srt 指定对应源文件,查编号、起止和空文本;三份输入内容和时间码不同,不能全部误比对到同一个源字幕。manual-reference/ 是人工答案,不是模型结果。
7. 仅重试失败文件
保留成功文件与失败原因,修正坏输入后只重跑对应文件;不要为了一个错误覆盖整个文件夹。归档模型、版本和输出数量,结构检查不能证明译文质量。
怎样确认已经完成
- 7 个步骤使用同一明确输入,真实结果与人工/官方参考分别标识。
- 实际输出重新打开,核对文字、时间码、尺寸、图层或剪点;结构通过不代替内容验收。
- 保留原始输入、版本、参数、输出和失败样本,正式任务先做小样。
常见问题
pyVideoTrans 批量翻译 SRT怎么操作?
先用 verify.py 检查 UTF-8 字幕和坏时间码,再从翻译字幕入口选择多份文件,固定源语言与翻译渠道,另存输出。逐条比较时间码和译文;这是字幕翻译流程,不会凭空补出没有输入的视频。
pyVideoTrans 批量翻译 SRT需要哪些输入,本站实际运行了什么?
已完成原创输入、可下载材料和文件预检;未运行本页工具的模型、TTS、付费 API 或外部生成。 输入与脚本在本页 ZIP,详细来源、命令和未运行范围见 README。
一整个文件夹字幕怎么翻译,练习包能直接得到工具生成结果吗?
请按7步区分输入、官方示例、人工参考和真实输出。未运行模型的页面没有代造结果;免费代码也可能需要下载权重、硬件或外部服务额度。