
展开本页目录
开始前准备什么
- 下载独立练习包,阅读README的版本、套餐与实跑范围。
- 需可用 RAGFlow 1.0.0-rc1 实例、embedding/chat 模型和实际解析记录。官方部署起点为 x86-64、16GB RAM、50GB 可用磁盘;本练习未部署 RAGFlow、未嵌入、未编译知识。代码 Apache-2.0,模型许可另计。
- 准备自己的可用模型与账户;不把示例模型占位名或地址当作已验证配置。
- 读取五页手册和三个问题
- 确认当前Knowledge Compilation版本
- 配置PageIndex编译流程
- 上传并运行实际编译
- 检查章节层级再问问题
- 填写事实与来源观察
- 保存失败节点和缺来源负例
1. 读取五页手册和三个问题
source.pdf 是本站原创设备借用手册,共5页。规则在第3页,天气例外在第4页;先人工回答 Q1–Q3,避免把答案是否顺耳当检索成功。
bash
python3 verify.py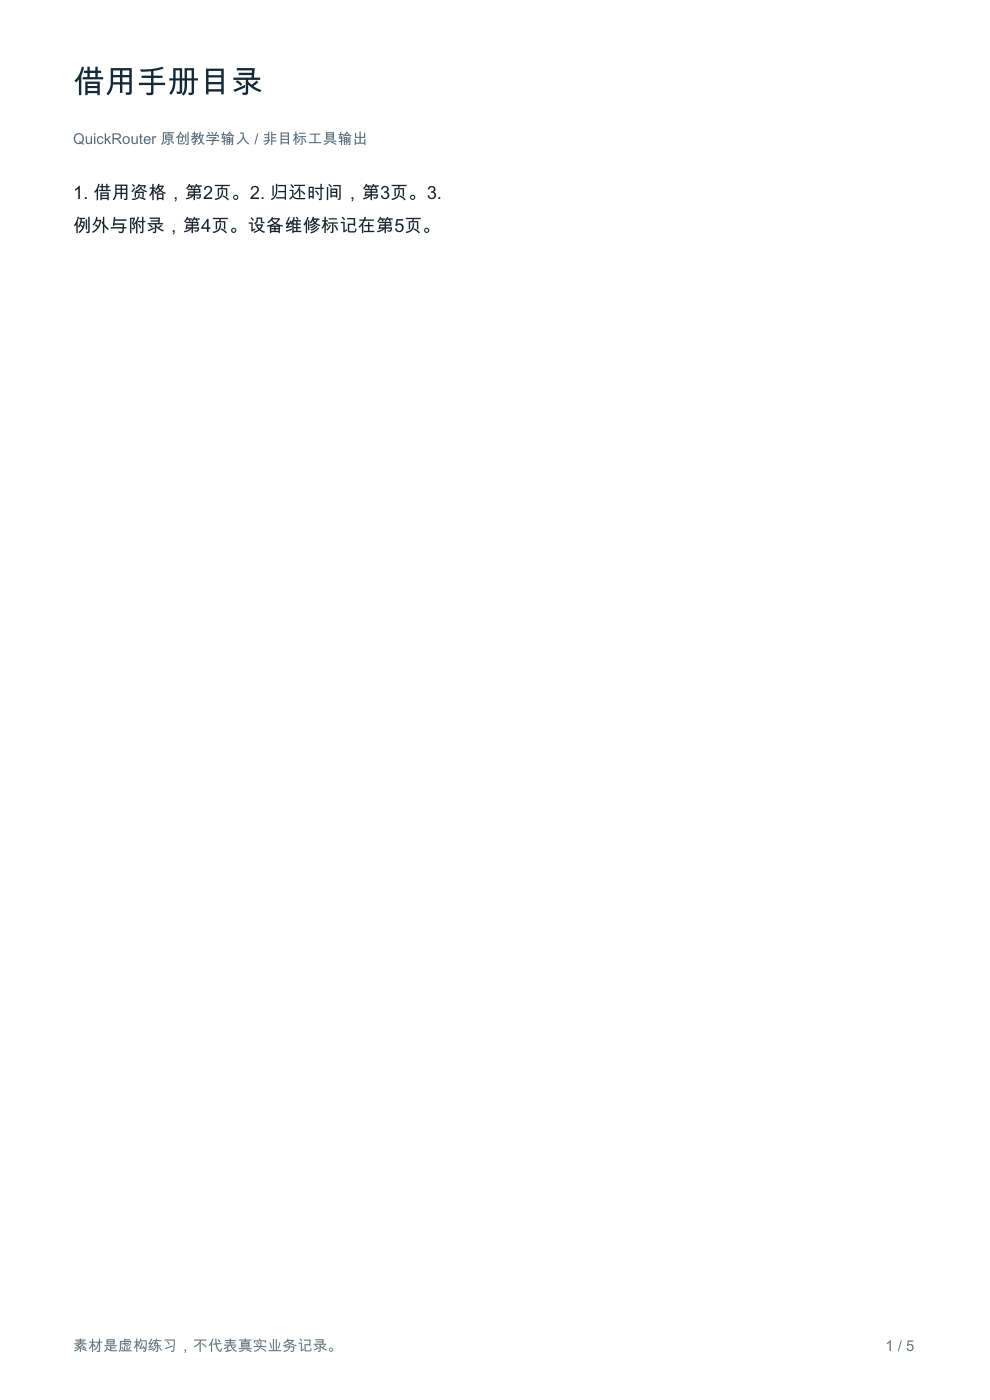
2. 确认当前Knowledge Compilation版本
固定自己的 RAGFlow 版本。1.0.0-rc1 文档使用 Knowledge Compilation;旧 RAPTOR 开关的截图与参数不能直接替代当前 PageIndex 模板。
3. 配置PageIndex编译流程
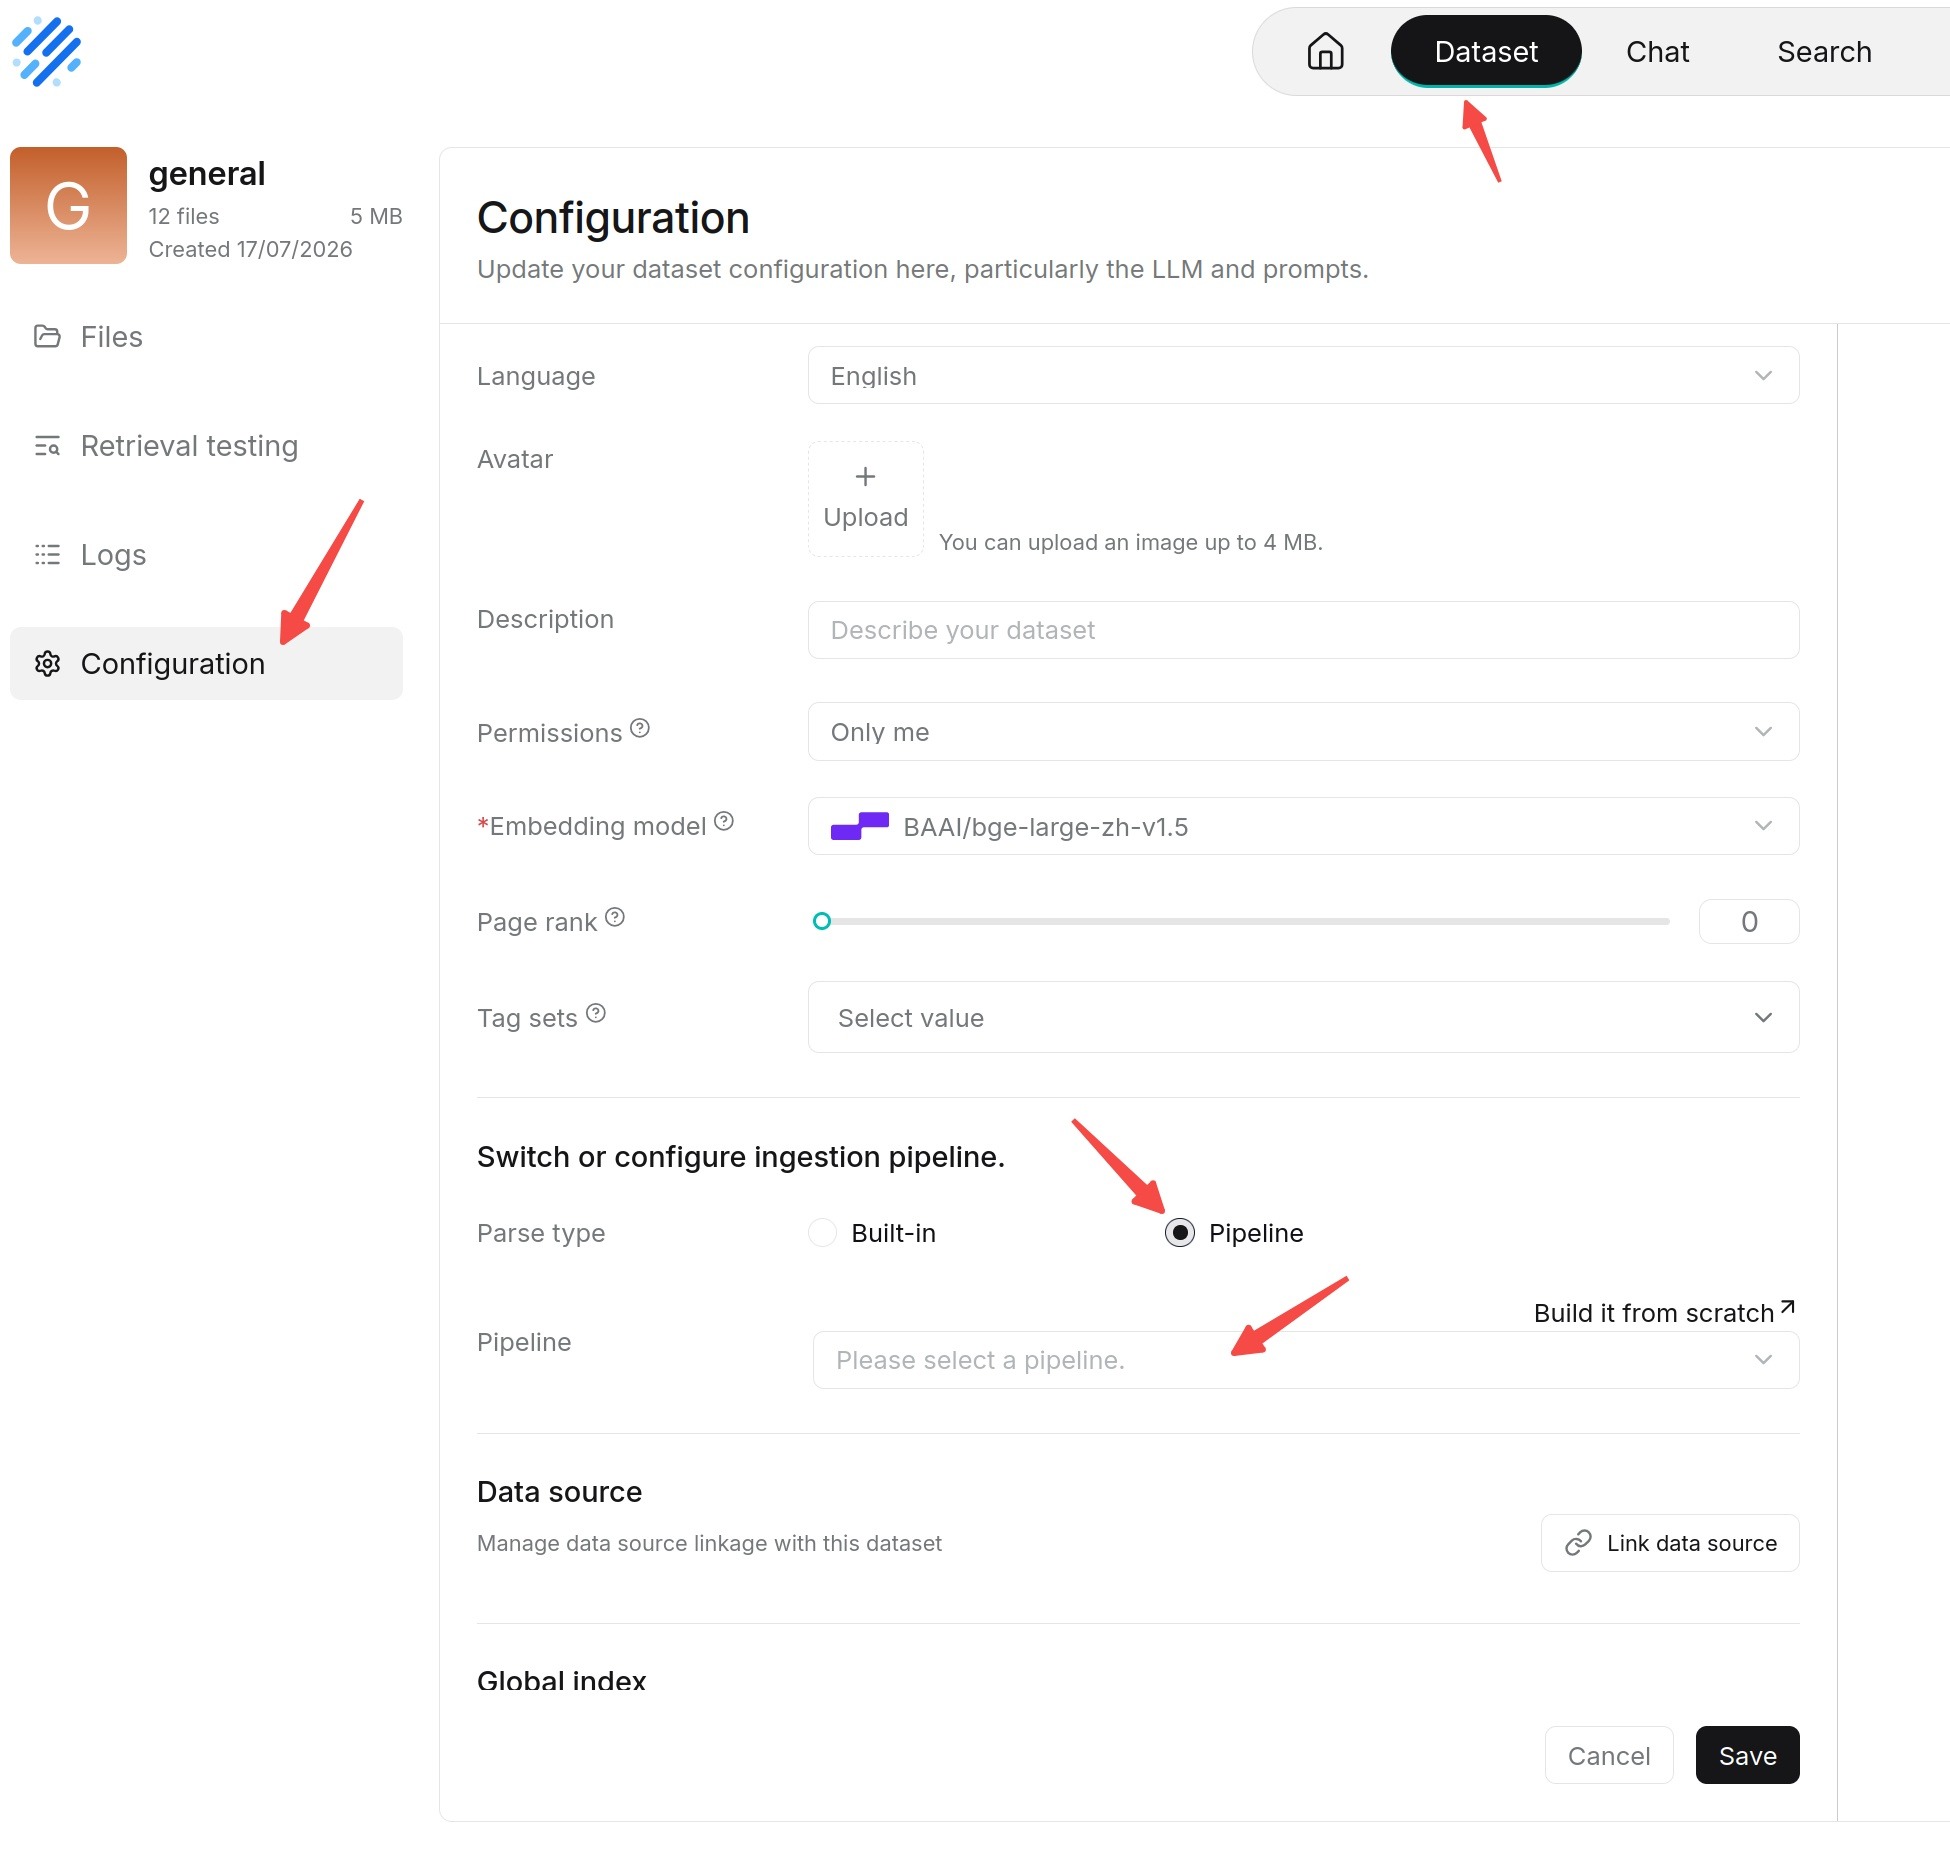
在实际实例创建 PageIndex 模板,将 Parser、Chunker、Compiler、Indexer 连接到 Ingestion Pipeline,Compiler 选择该模板;仅创建模板不代表已经生成产物。
4. 上传并运行实际编译
将 source.pdf 上传专用测试 Dataset,选择对应 Pipeline 并执行。等各节点实际完成,保存任务日志;本站未部署该实例或运行编译。
5. 检查章节层级再问问题
在 Artifacts 查看 PageIndex,核对目录顺序和附录位置。查询 Q2 时回读第3和第4页,区分普通18点规则和需值班员确认的例外条件。
6. 填写事实与来源观察
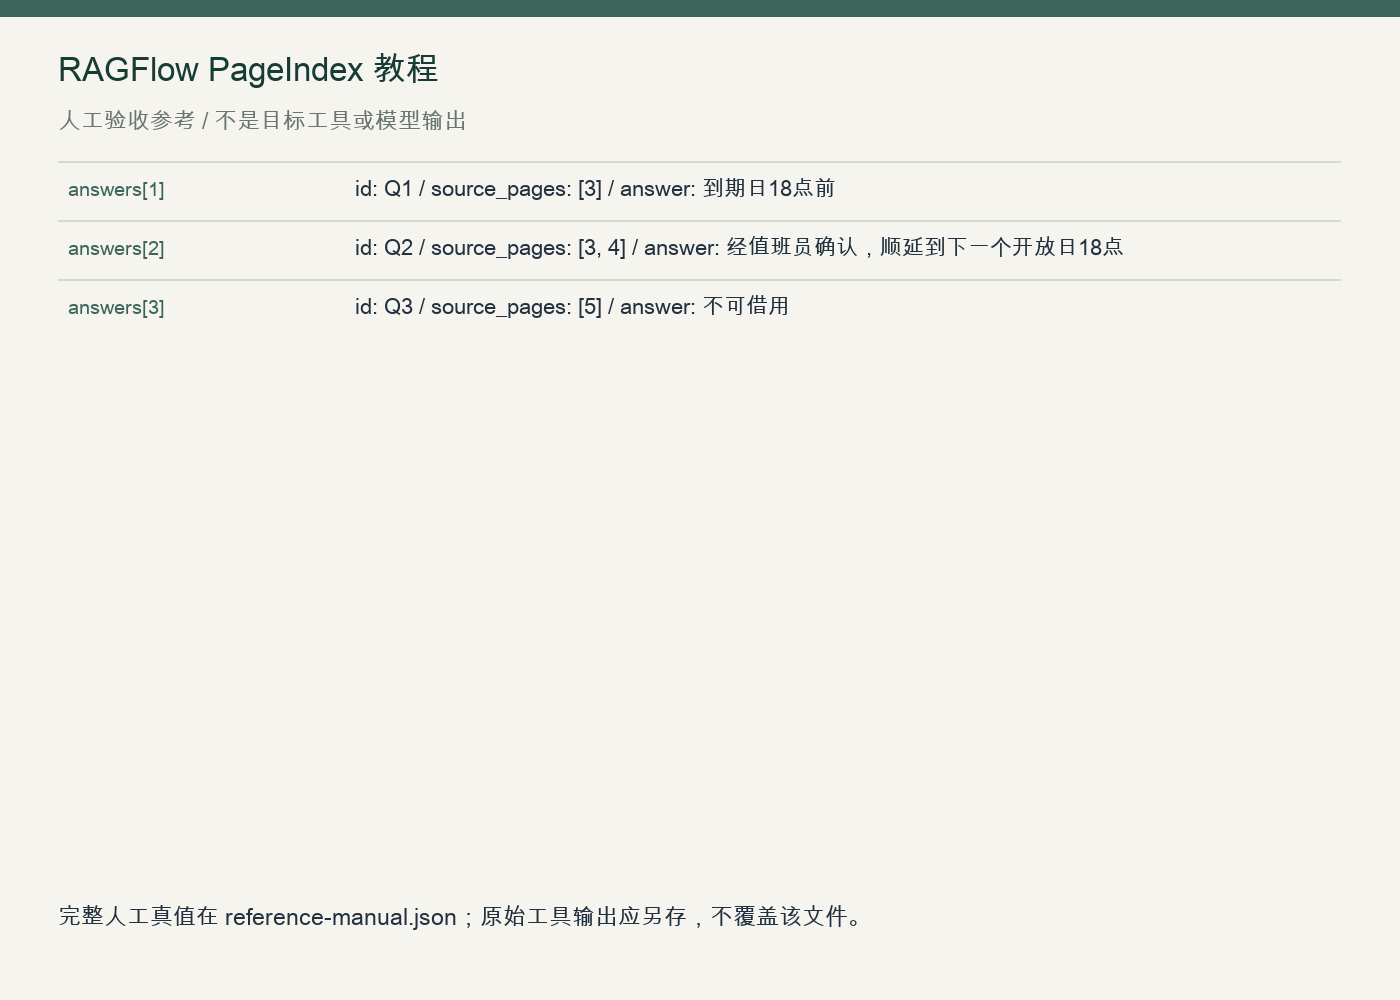
按 actual-template.json 保存三条实际回答和一基源页码。脚本只核对本题事实记录,不能代替浏览实际索引与原页。
bash
python3 verify.py --actual my-pageindex-observation.json7. 保存失败节点和缺来源负例
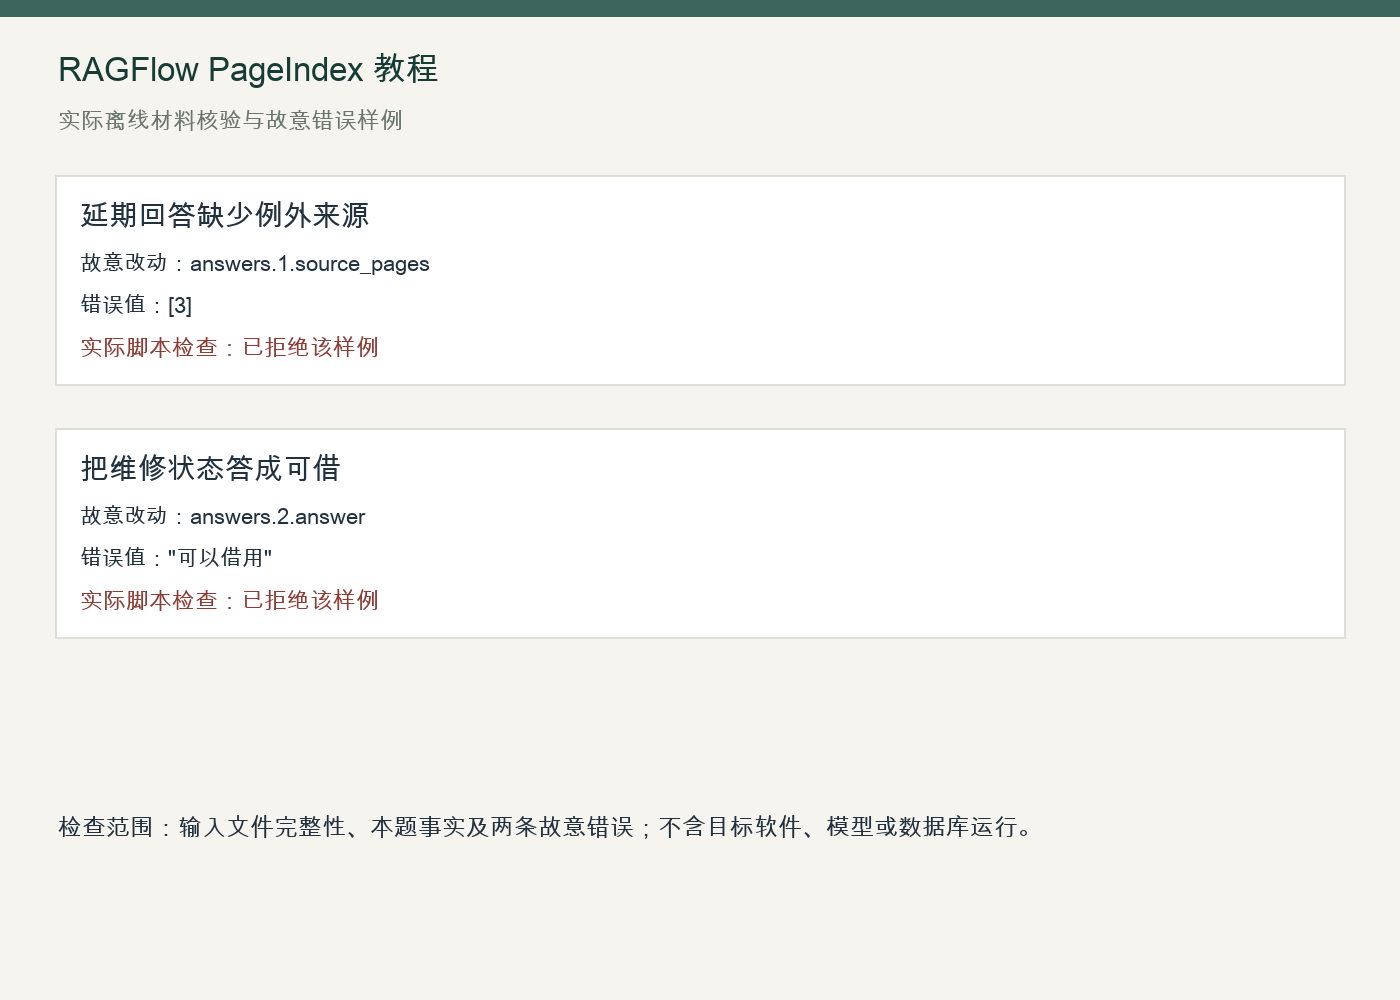
如果索引缺例外章节,保留实际任务错误后修复,不用人工目录图冒充编译成果。负例会拒绝只引用第3页的延期答案。
怎样确认已经完成
- 原始输入、来源和单位已保留,材料检查及两条故意错误样例均运行。
- 在真实工具保存原生输出,回读本题关键事实、缺值与来源;未运行部分仍标记未执行。
- 保存工具/模型版本和实际结果,人工修改与模型返回分开归档。
常见问题
PageIndex与知识图谱适合相同的问题吗?
本页按手册章节找到主规则与附录例外;知识图谱页检查设备、部件和供应方的有向关系。问题和验收对象不同,不能把章节树当实体关系图。
RAGFlow PageIndex 教程需要哪些条件?
需可用 RAGFlow 1.0.0-rc1 实例、embedding/chat 模型和实际解析记录。官方部署起点为 x86-64、16GB RAM、50GB 可用磁盘;本练习未部署 RAGFlow、未嵌入、未编译知识。代码 Apache-2.0,模型许可另计。
RAGFlow PageIndex 教程的图片和检查通过代表什么?
原始输入、人工参考与实际离线材料检查均有对应文件;官方图说明操作入口。目标软件和模型未执行的部分已在步骤中注明,不能用材料检查替代真实产品运行。