
展开本页目录
开始前准备什么
- 下载并解压到独立目录,先阅读README里的真实执行范围。
- 使用自有输入,不把系统朗读、程序合成源或官方截图冒充模型生成。
- 先完成12秒练习,再扩大文件长度;固定实际工具、模型与运行设备。
- 锁定同一段原创混音
- 分别跑模型A与B
- 进入Ensemble并核对目标
- 固定一次集成算法
- 导出三个独立目录
- 按相同区间回听
- 保存可复核的比较结论
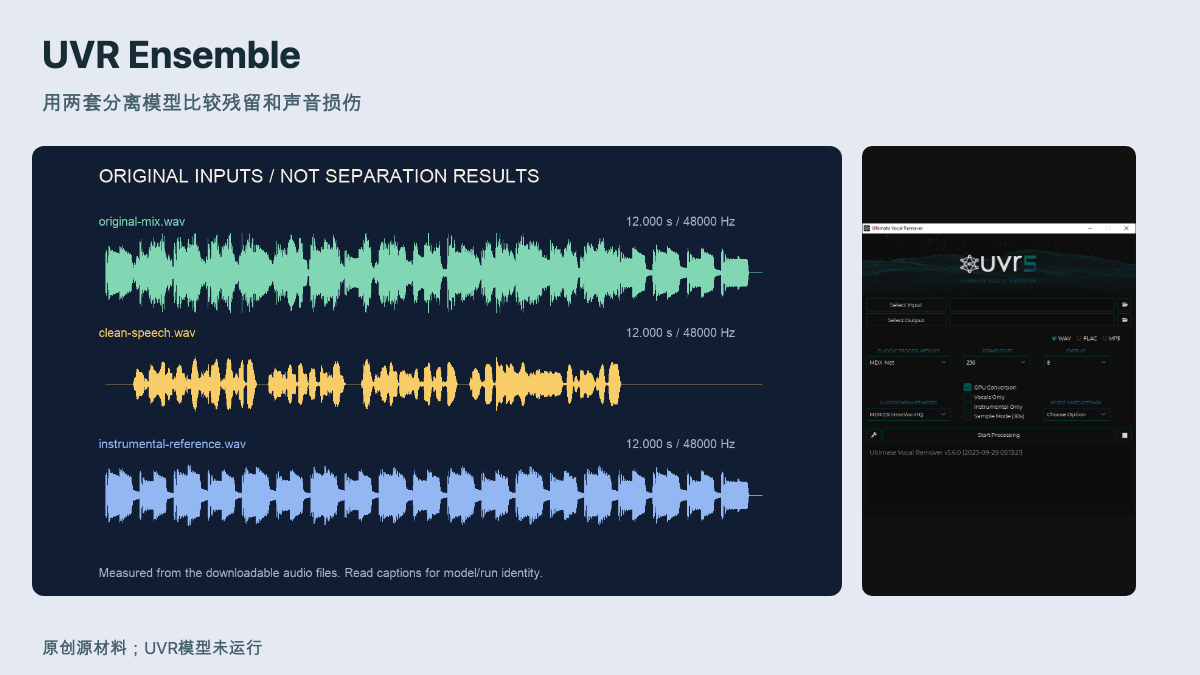
含原创输入、逐步说明、真实检查脚本和已标明身份的实际输出;不含模型权重。
已固定同一原创混音与源轨并运行输入校验;未运行两套UVR模型或Ensemble,不提供伪造的集成成功结果。
读取实际PCM16文件与源hash,拒绝损坏或空音频;不请求任何模型。
已固定同一原创混音与源轨并运行输入校验;未运行两套UVR模型或Ensemble,不提供伪造的集成成功结果。
1. 锁定同一段原创混音
三个实验都使用同一个original-mix.wav,不改变音量、起点和文件。源人声与伴奏只作独立参考,不能分别拿不同素材证明某个模型效果好。
bash
python3 verify.py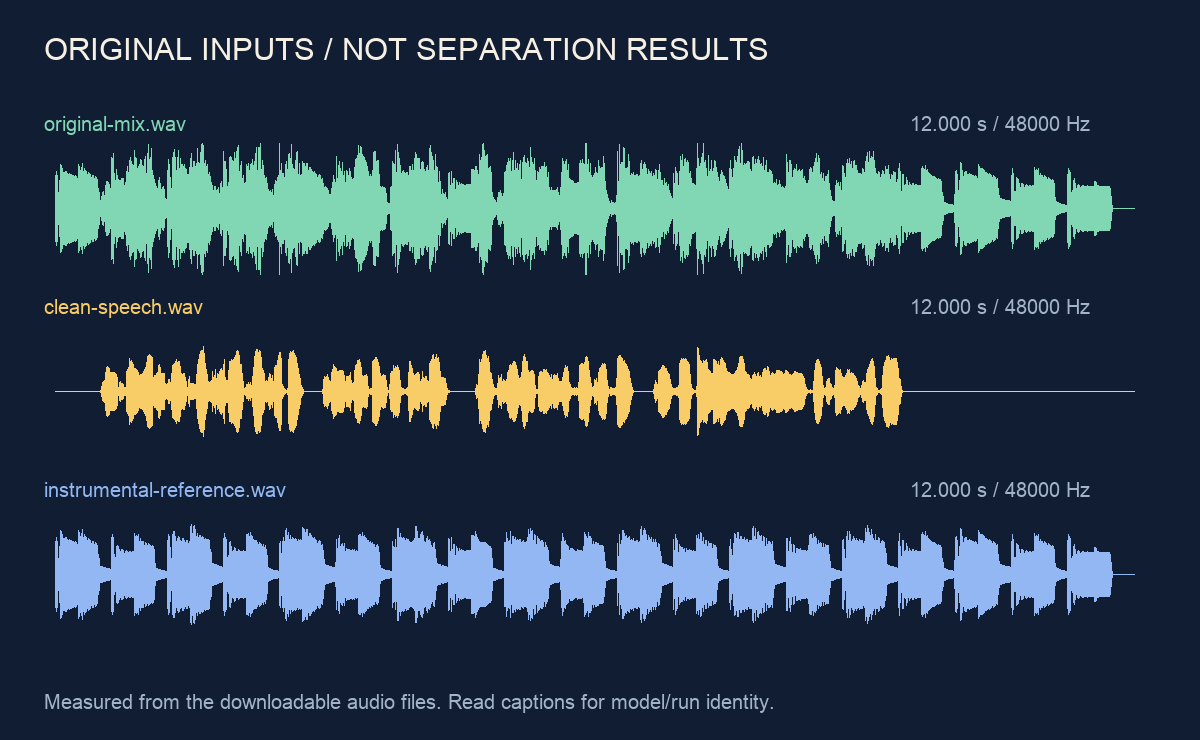
2. 分别跑模型A与B
从实际安装版本的Download Center选择两套支持相同目标stem的模型,分别导出并记录模型全名。先确认A与B都能单独运行;若只有一个可用模型,本页实验尚未满足条件。
3. 进入Ensemble并核对目标
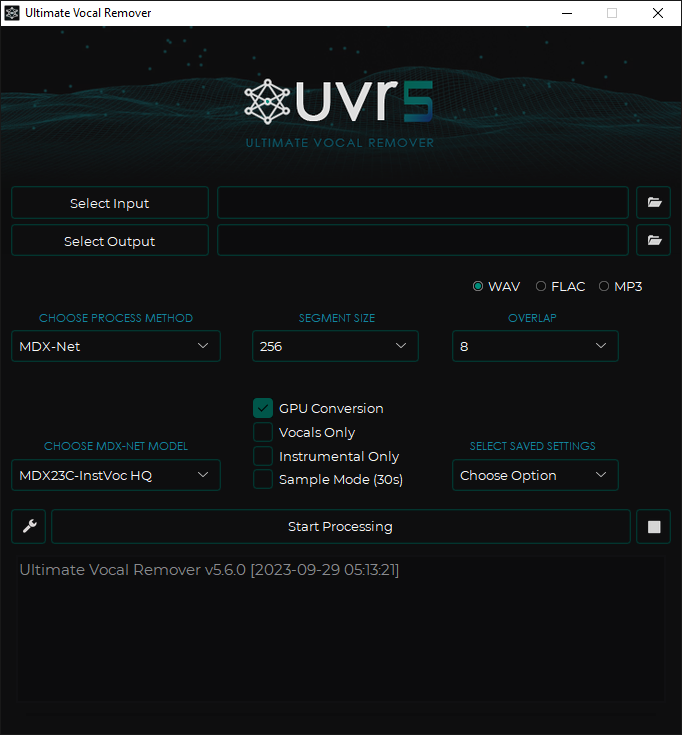
Choose Process Method切换Ensemble Mode,选择同一人声/伴奏目标,至少选择两个实际可用模型。官方初始界面图是基础控件依据,不表示本站已运行Ensemble或出现某个新控件。
4. 固定模型后只比较集成算法
确认 A、B 都使用同一 original-mix.wav 且目标 stem 相同,再记录当前可选的 Average/Min Spec/Max Spec 算法。不要在切算法时同时更换模型、音量或裁切范围。
将 A、B 与 Ensemble 输出保存在三个独立目录,使用相同区间与监听增益回听。分别记录人声残留和目标声音损伤;集成结果并不保证优于两套单模型。
5. 导出三个独立目录
把单模型A、单模型B、集成放到三个目录,保留原始文件名与日志。音量比较前做一致的监听增益,避免更响的一份被误认为更清晰。
6. 按相同区间回听
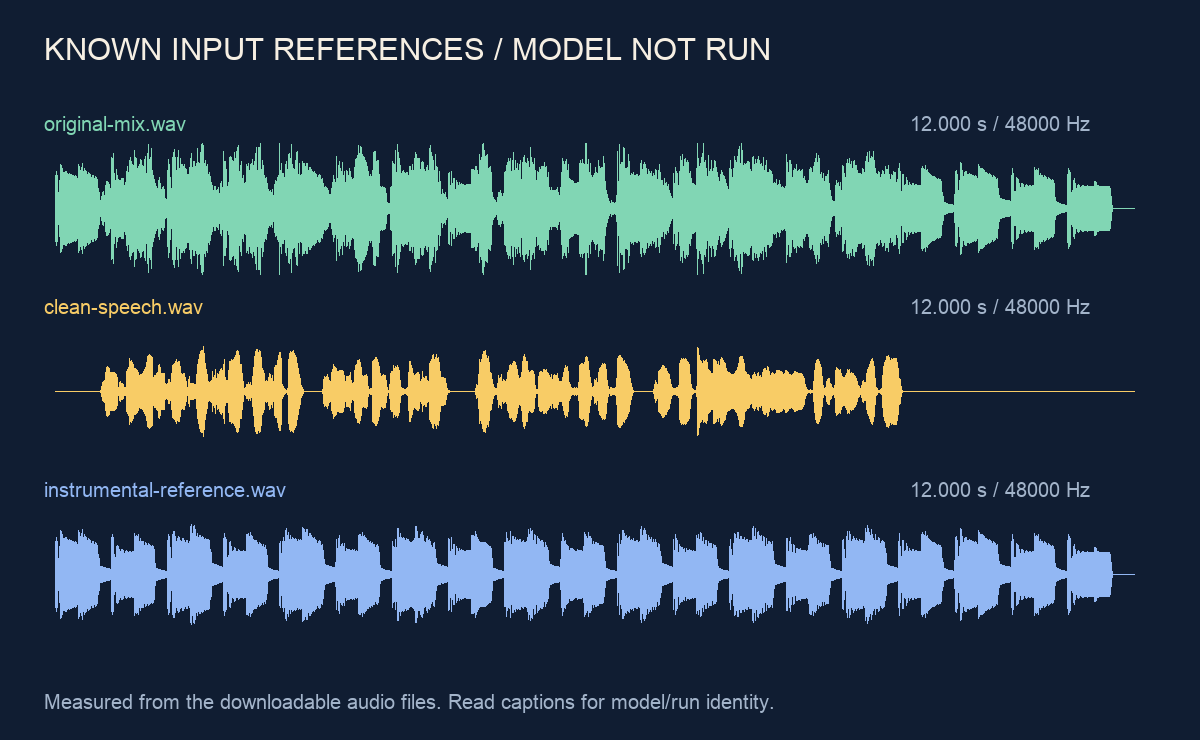
在0.5–3.0秒检查语音残留,在末句检查词尾与音乐瞬态。三份实际模型输出缺一份就不公布胜负;包内三个源文件只是实验输入。
bash
python3 verify.py --file ensemble-output.wav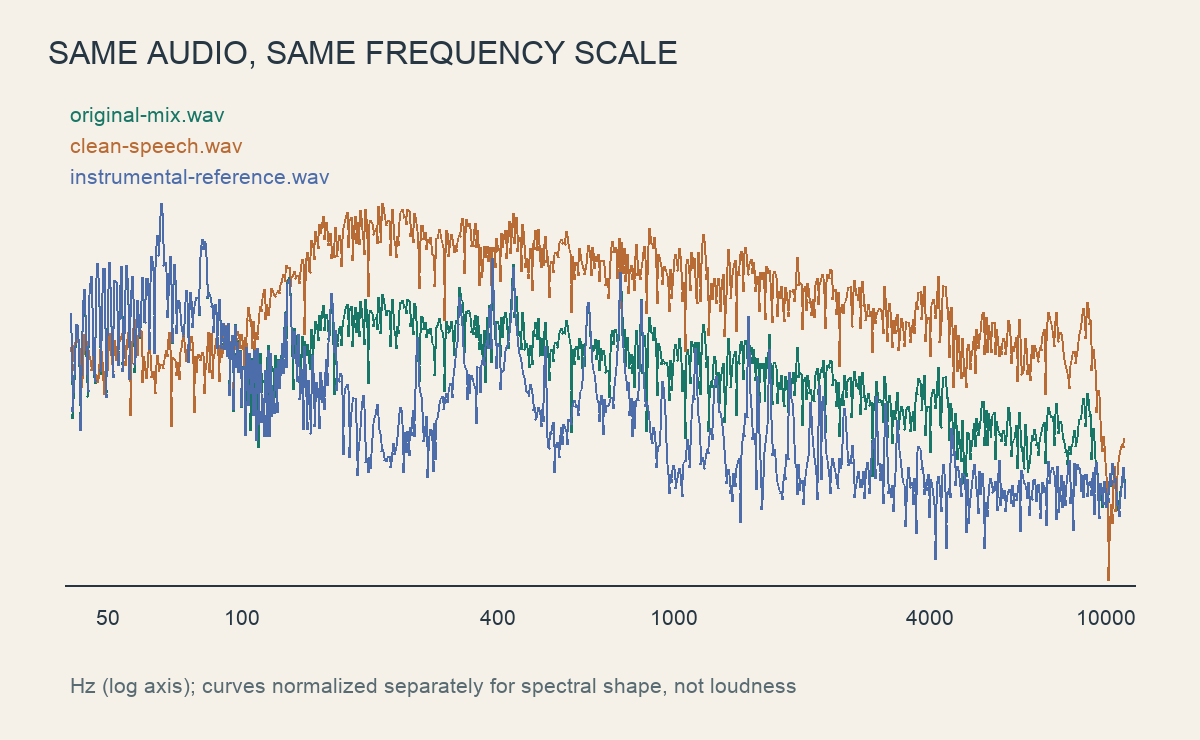
7. 保存可复核的比较结论
每份结果记录来源模型、算法、损伤时间点与试听理由,结论仅覆盖当前混音。需要重混时阅读Demucs贝斯降低教程,不能把Ensemble数量当作质量分数。
怎样确认已经完成
- 实际输入与输出均可解码,采样率、声道、帧数和时长已记录。
- 按指定同一音节/乐句或首尾有声段回听,保留残留、失真和失败区间。
- 已固定同一原创混音与源轨并运行输入校验;未运行两套UVR模型或Ensemble,不提供伪造的集成成功结果。
常见问题
UVR Ensemble下载后就是模型成功结果吗?
已固定同一原创混音与源轨并运行输入校验;未运行两套UVR模型或Ensemble,不提供伪造的集成成功结果。 输入预检、已知源参考和模型推理是不同证据,未运行时不提供伪造结果。
人声分离不干净怎样判断完成?
先核对当前教程中的真实文件、参数和模型身份,再按第六步的同一区间验收;仅文件存在、峰值变小或界面显示完成都不足以证明声音质量。