
展开本页目录
开始前准备什么
- 下载并解压独立练习包,先读 README 的实际执行范围。
- 使用原创或获授权输入,保留原文件、软件版本与失败记录。
- 模型和在线渠道需要单独准备;不包含权重、真实密钥或付费额度。
- 先读带上下文的源字幕
- 固定版本并先导入字幕
- 开启术语校对暂停
- 修改实际生成的术语文件
- 恢复翻译并保留上下文
- 逐次出现核对一致性
- 归档后才运行下个任务
原创输入、操作脚本、来源与验收说明;未运行范围逐项标明。
1. 先读带上下文的源字幕
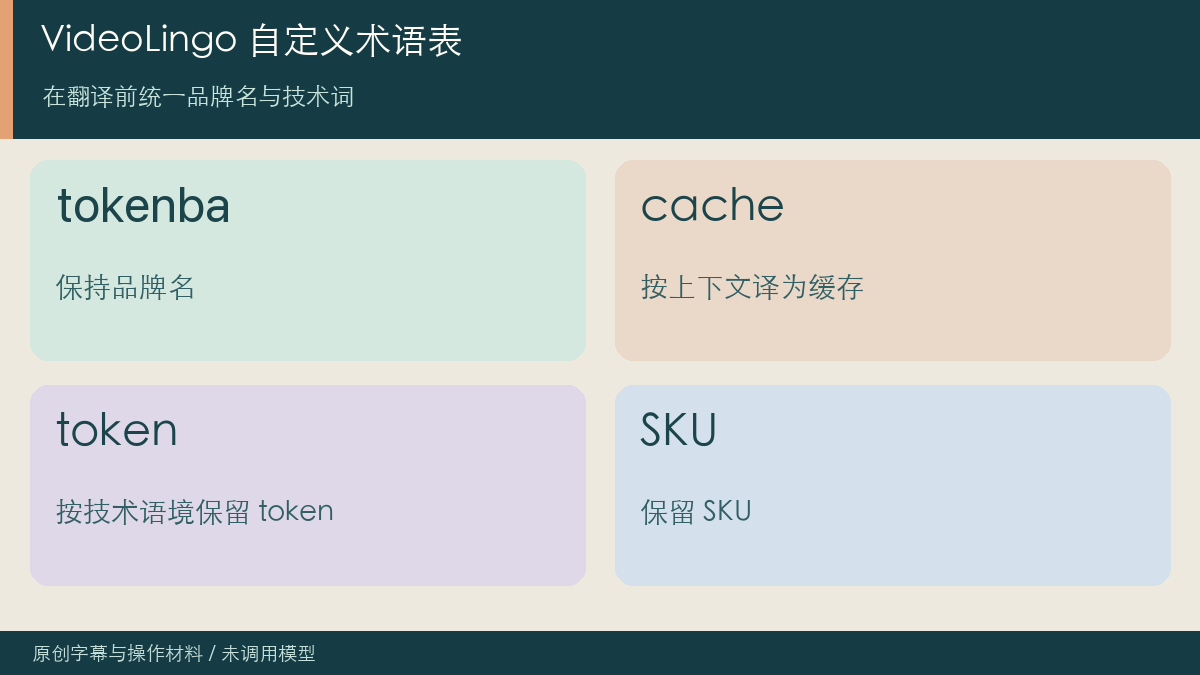
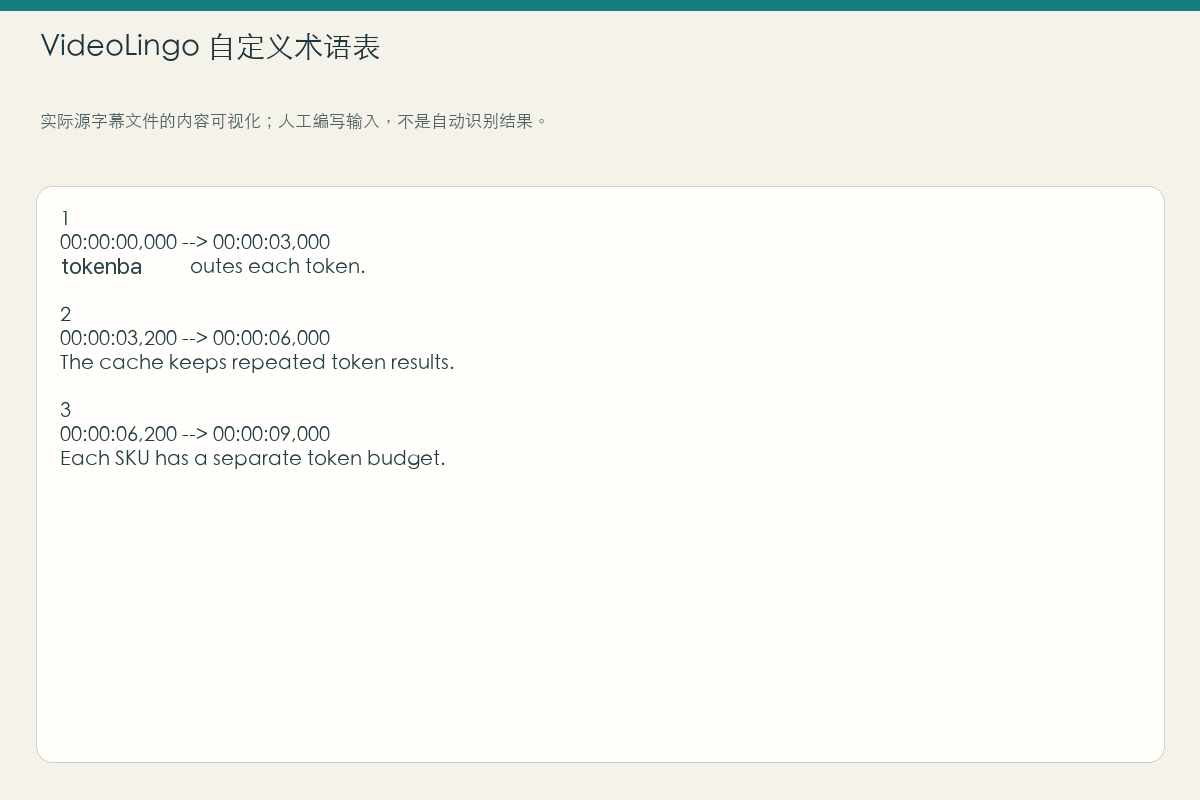
source.srt 是原创技术说明,含 apizt、cache、token、SKU,并在不同句子重复。先在 source-notes.md 确认语境;不能只看词典里一个孤立词就决定整段译文。
2. 固定版本并先导入字幕
使用 v3.1.1;已有 UTF-8 SRT 可通过本地 HTTP API 的 input 入口传入,源语言明确设英语。只输入 SRT 时输出只有字幕,没有视频,不要期待凭字幕自动获得成片。
3. 开启术语校对暂停
在 config.yaml 设置 pause_before_translate: true,再执行 subtitles 阶段。等 status 为 paused、active 为 false 后处理术语;202 只代表请求被接受,不是完成。
4. 修改实际 terminology.json 而非覆盖示意规则
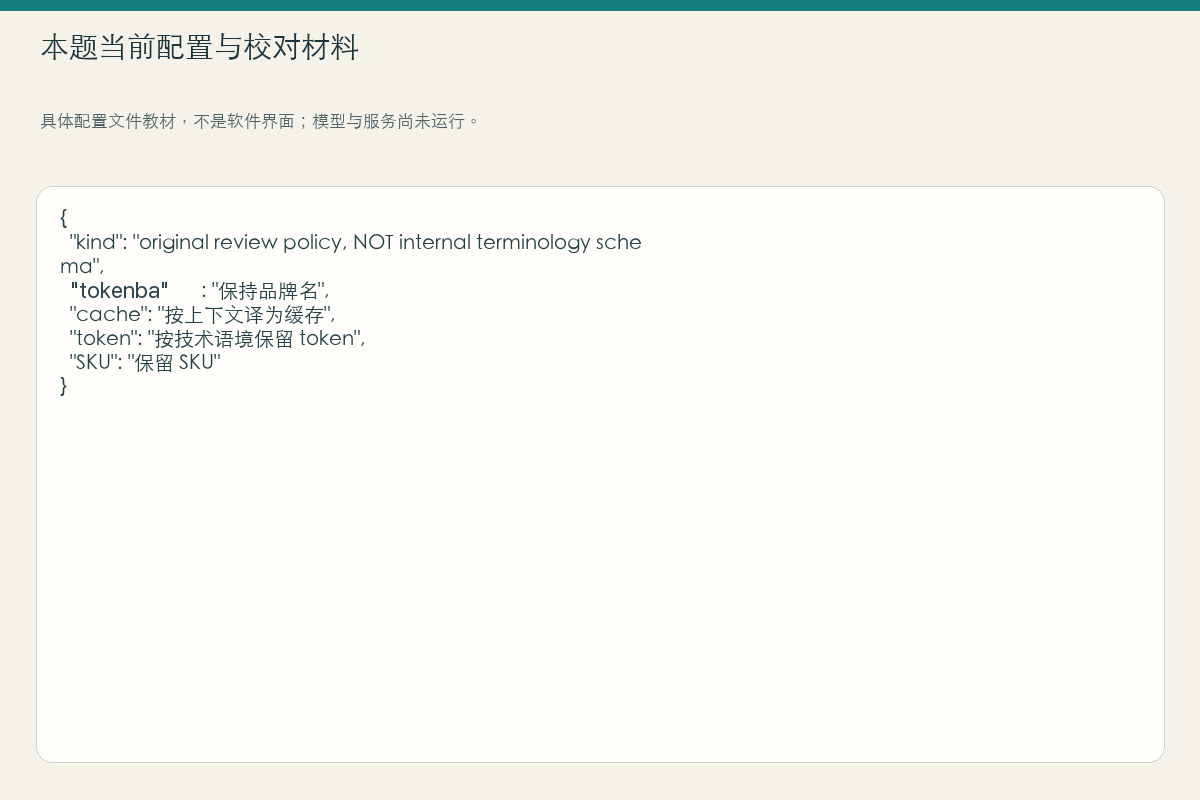
等任务进入 paused 且 active=false,再打开 output/log/terminology.json。按这次真实生成的字段修改 apizt、cache、token、SKU 的上下文译法,保留其它键和词项。
包内 terminology-policy.json 是人工政策输入,不保证与内部 schema 一致。修改后用 POST /resume 恢复;若再校译文,只改 translation_results.xlsx 的 Translation 列,保持 Source 与行数。
review.example.yaml
pause_before_translate: true
pause_after_translate: true
5. 恢复翻译并保留上下文
校对后 POST /resume。若还要人工复核译文,设 pause_after_translate,再只改 translation_results.xlsx 的 Translation 列;保持 Source 和行数,避免破坏对应关系。
6. 逐次出现核对一致性
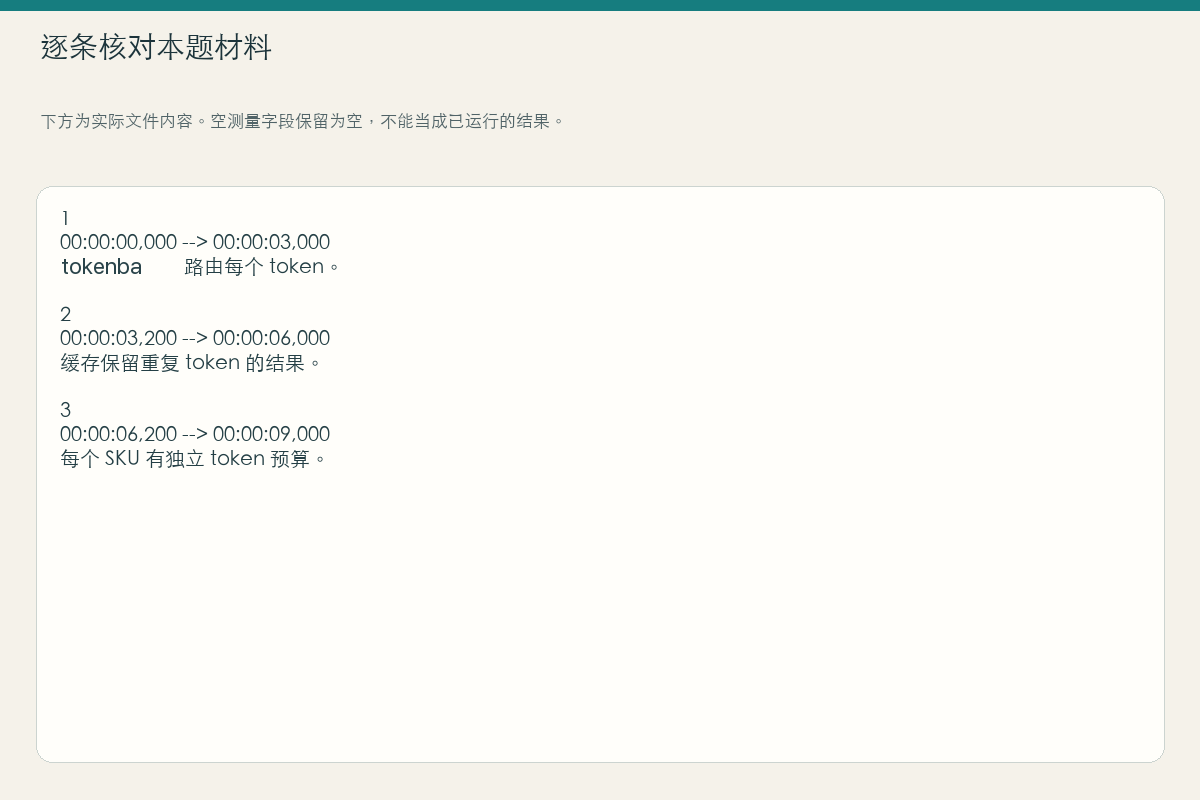
对照最终字幕中三次 token 和两次 SKU,区分应保留英文、应译为中文及数字单位。包内 manual-translation.srt 是人工参考,不是已调用 LLM 的输出;术语命中不能代替整句理解。
7. 归档后才运行下个任务
本地 API 单进程串行处理,归档完成后再换输入。重试会复用中间文件,换模型并不会自动重算所有阶段;改参数实验先保留旧结果,避免无意覆盖。
怎样确认已经完成
- 7 个步骤使用同一明确输入,真实结果与人工/官方参考分别标识。
- 实际输出重新打开,核对文字、时间码、尺寸、图层或剪点;结构通过不代替内容验收。
- 保留原始输入、版本、参数、输出和失败样本,正式任务先做小样。
常见问题
VideoLingo 术语表怎么操作?
先导入带上下文的 SRT 并开启术语校对暂停,修改实际生成的术语文件后恢复翻译。逐次回查 apizt、cache、token 与 SKU 的译法;仅输入 SRT 时输出字幕,不会自动生成原视频。
VideoLingo 自定义术语表需要哪些输入,本站实际运行了什么?
已完成原创输入、可下载材料和文件预检;未运行本页工具的模型、TTS、付费 API 或外部生成。 输入与脚本在本页 ZIP,详细来源、命令和未运行范围见 README。
AI 翻译品牌名总翻错,练习包能直接得到工具生成结果吗?
请按7步区分输入、官方示例、人工参考和真实输出。未运行模型的页面没有代造结果;免费代码也可能需要下载权重、硬件或外部服务额度。