
展开本页目录
开始前准备什么
- 先解压练习包,保留原生输入文件;合成样本与作者参考不作为真实业务证据。
- 核对官方支持的账号、套餐、语言、客户端和管理员权限;本页不代替产品订阅。
- 五份PDF由作者编写并显著标为虚构纸尺实验,没有DOI,不是发表研究或科学证据。
- 打开五份原创虚构PDF
- 建立带类型的抽取列
- 从一份报告先试抽
- 逐格打开支持原文
- 分开零值和缺失
- 导出后再做单位换算
- 保存格级证据和错误
1. 打开五份原创虚构PDF
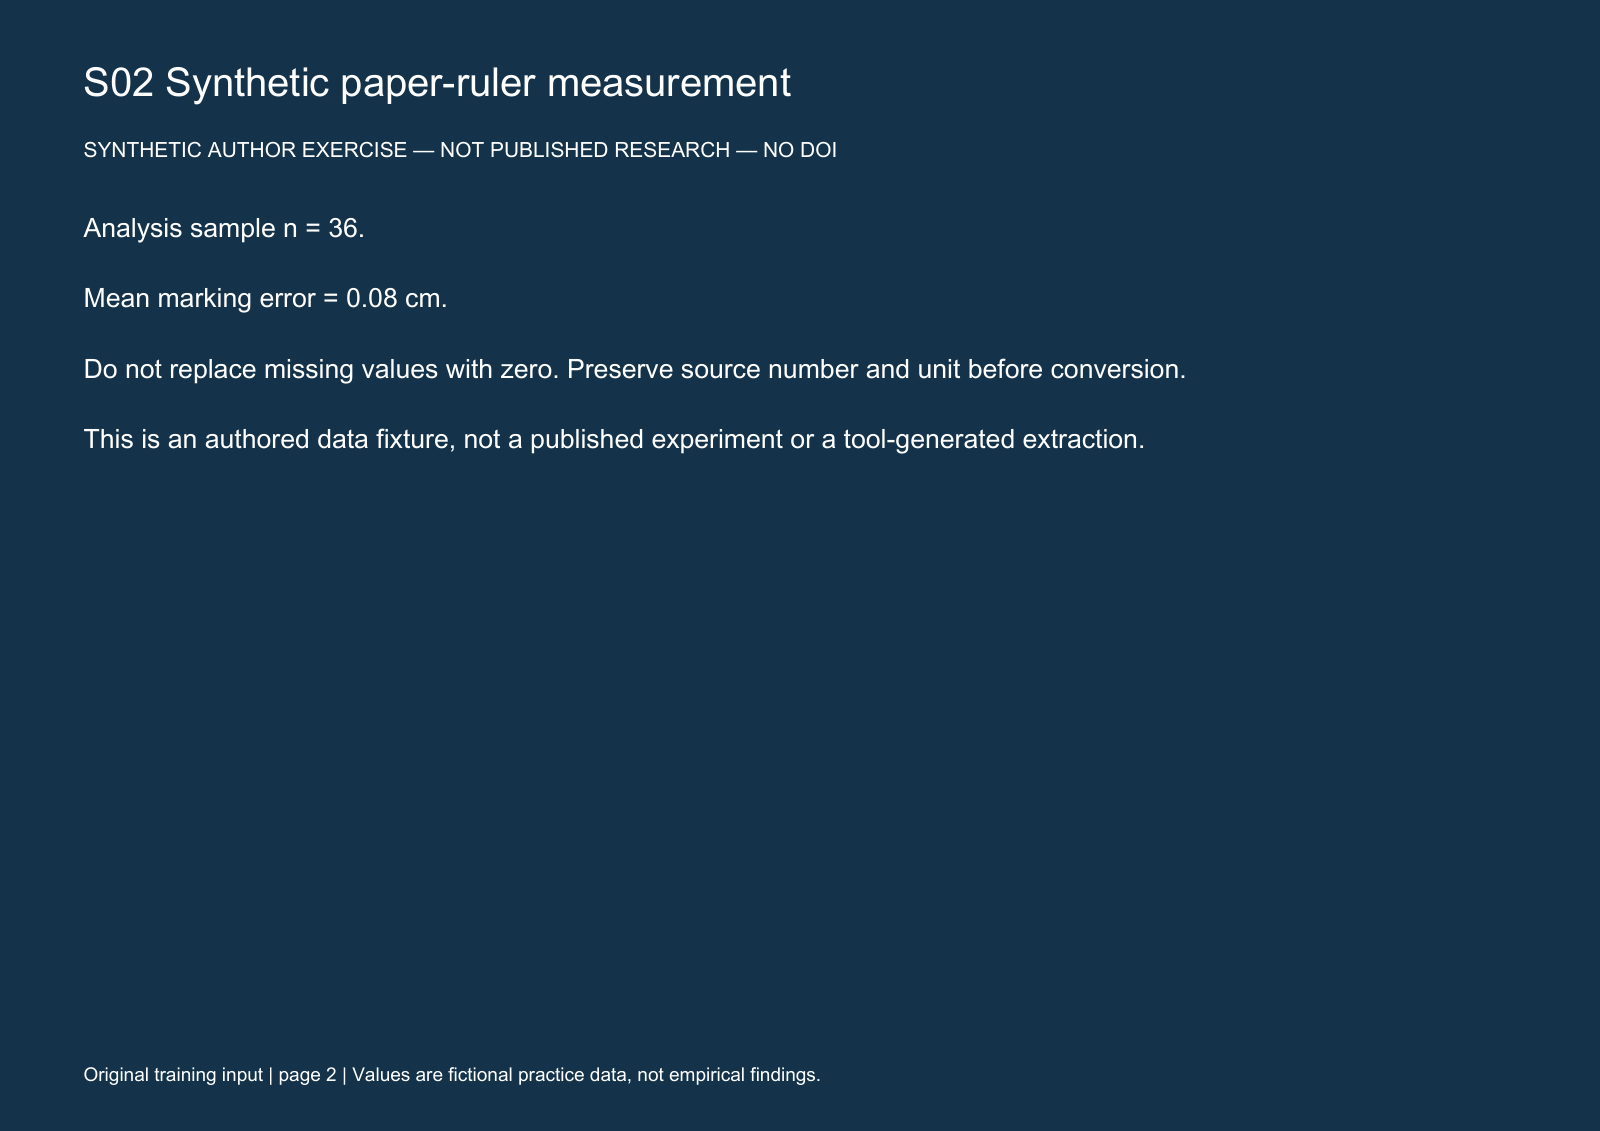
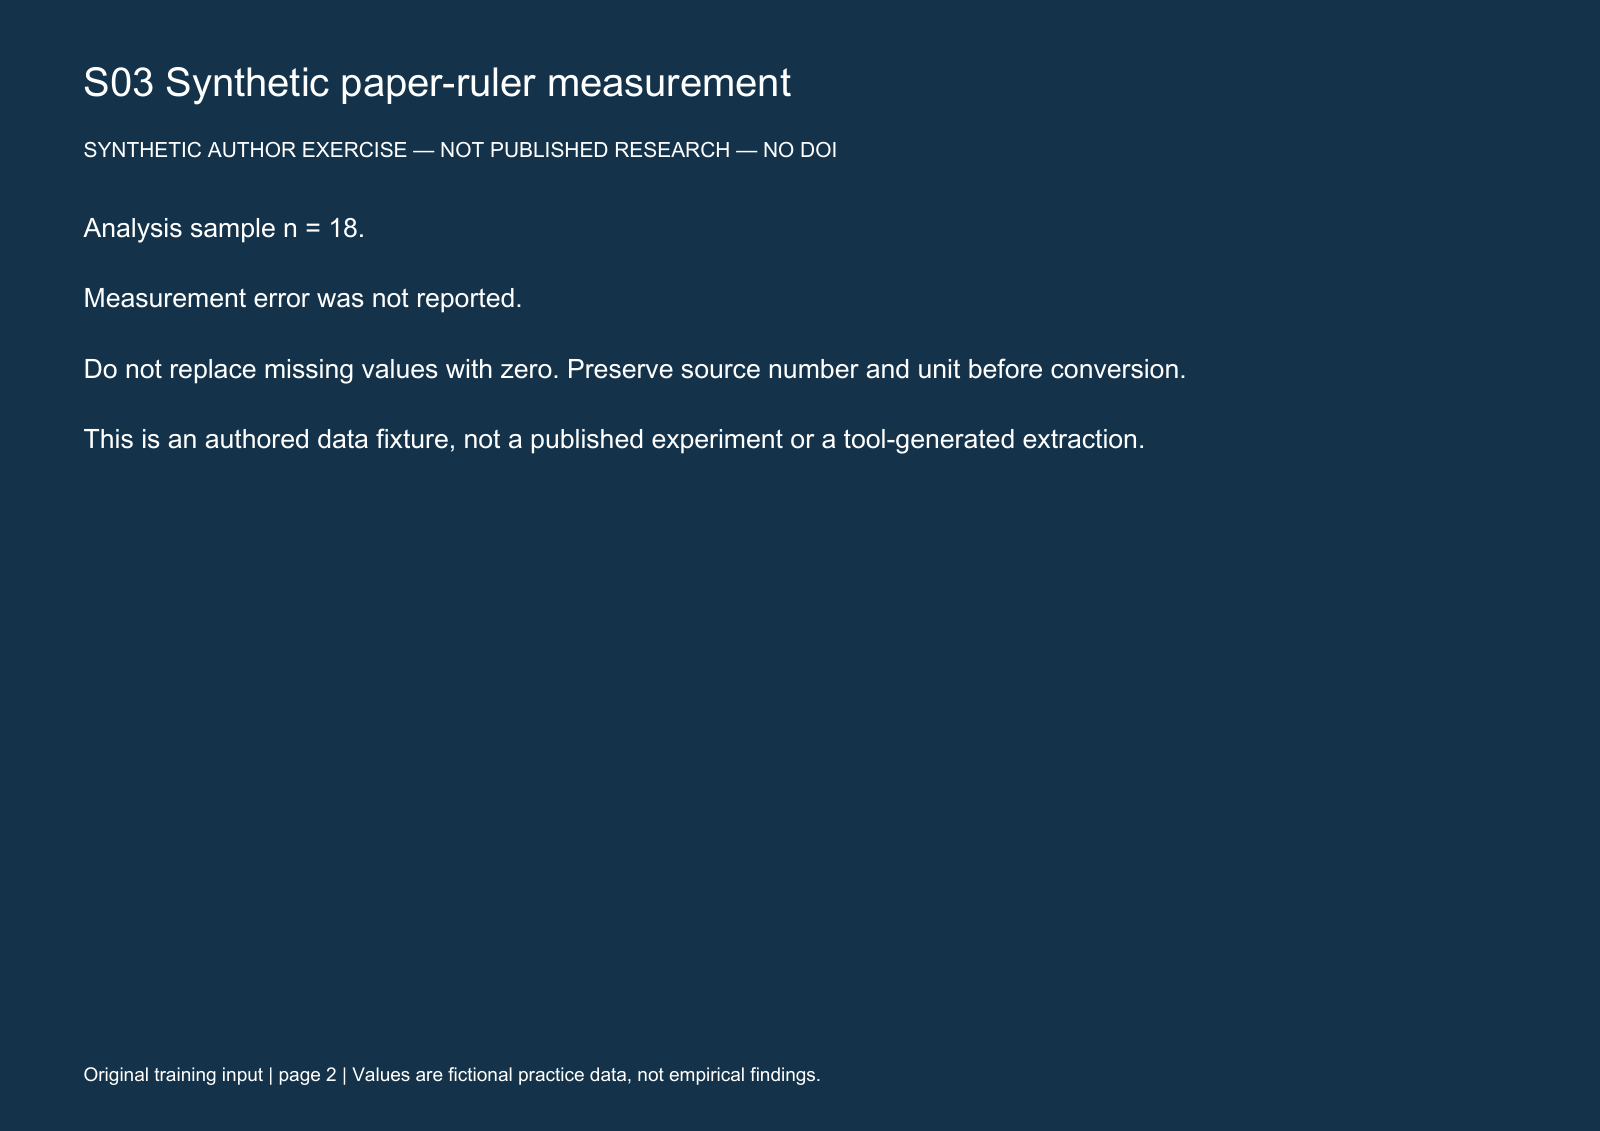
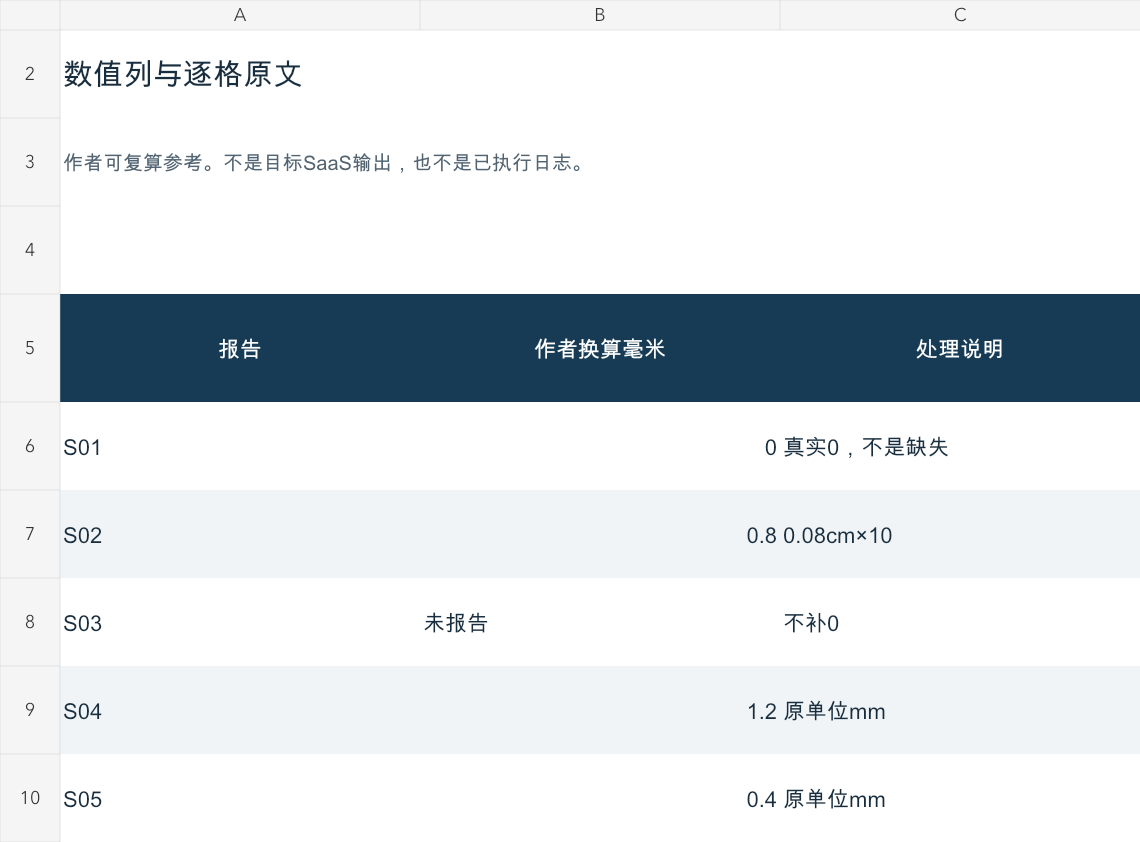
逐份看第2页结果:S01为0mm,S02为0.08cm,S03未报告。PDF实际文字可选择,不是空白占位。
2. 建立带类型的抽取列
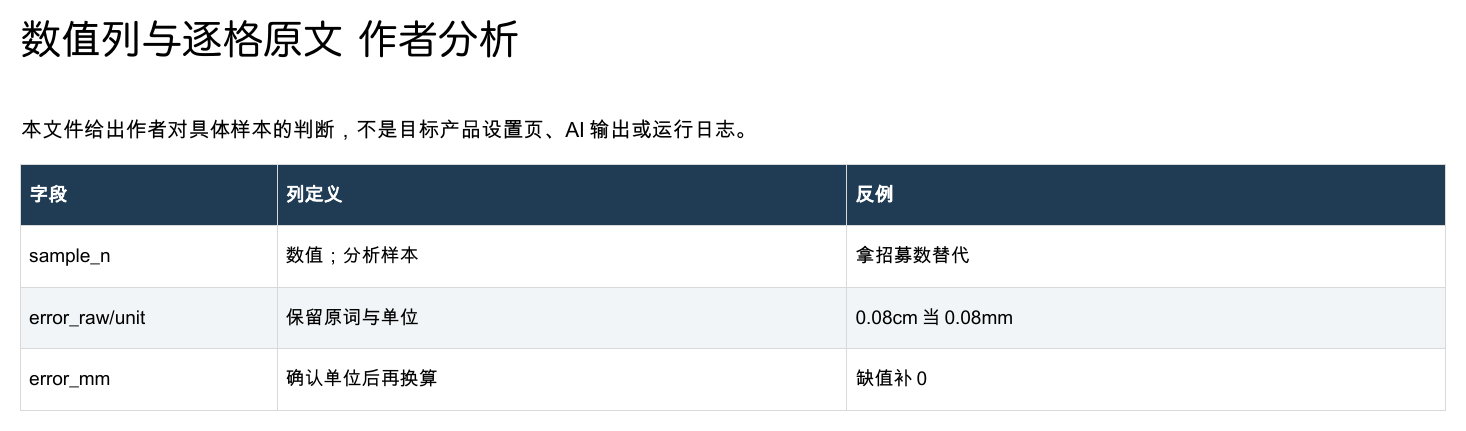
在Elicit支持的上传文件工作流定义sample_n、error_raw、unit和source_location;单位与原数值分列,换算列另外做。
3. 从一份报告先试抽
先只用S02检查数值与单位的返回方式,记录产品实际支持的列类型和提示,不编造JSON导入接口。
4. 逐格打开支持原文
对每个样本数和误差值打开产品给出的证据定位,和PDF第2页对照;无法定位就标待核,不接受孤立数字。
5. 分开零值和缺失
S01的0是明确观测值,S03是未报告;缺失样本不能进入“平均误差为0”的结论或被替换为0。
6. 导出后再做单位换算
保留实际CSV原列,作者reference.xlsx另列0.8mm等换算参考;产品导出不能被作者表冒充。
7. 保存格级证据和错误
逐行记录源页、原词、源单位和人工改动,检查导出行ID不串位,保留错误与未执行状态。
prompt.txt
text
任务:Elicit批量数据抽取:自定义数值列,逐格打开支持原文并导出证据表

输入:input.docx和同包原生练习材料,保持原件不变。
1. 定义带输出类型的抽取列
2. 逐格打开支撑语句/出处核对单位与分母
3. 导出CSV并保留证据定位
具体样本:
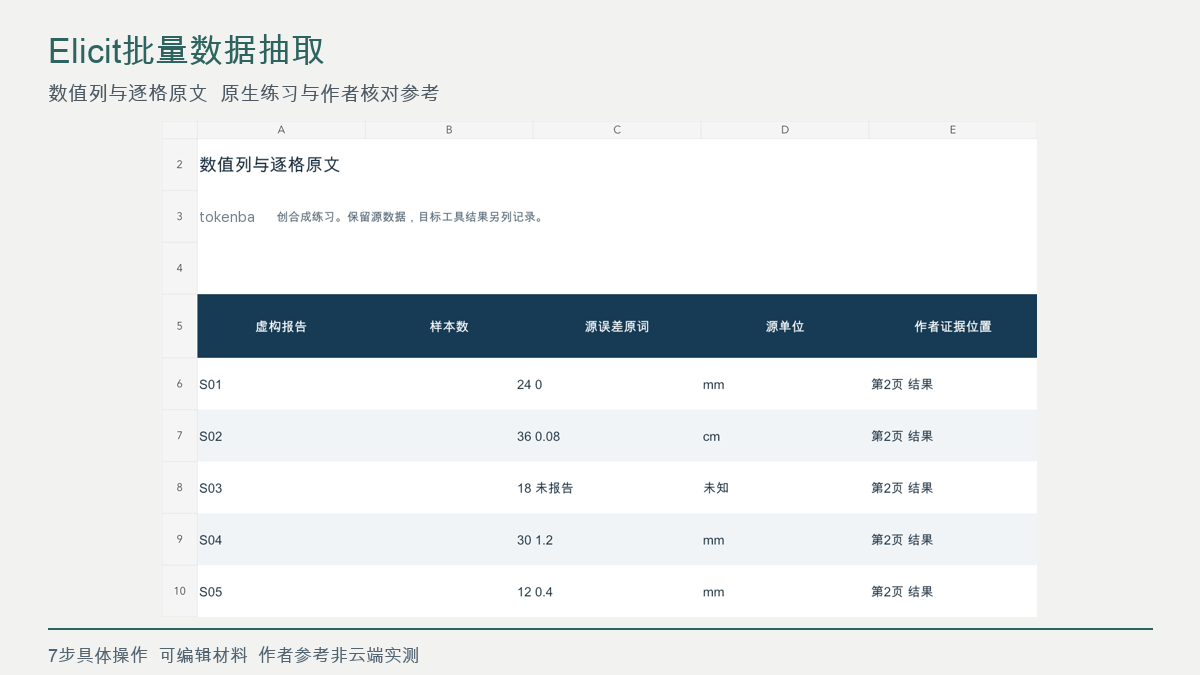
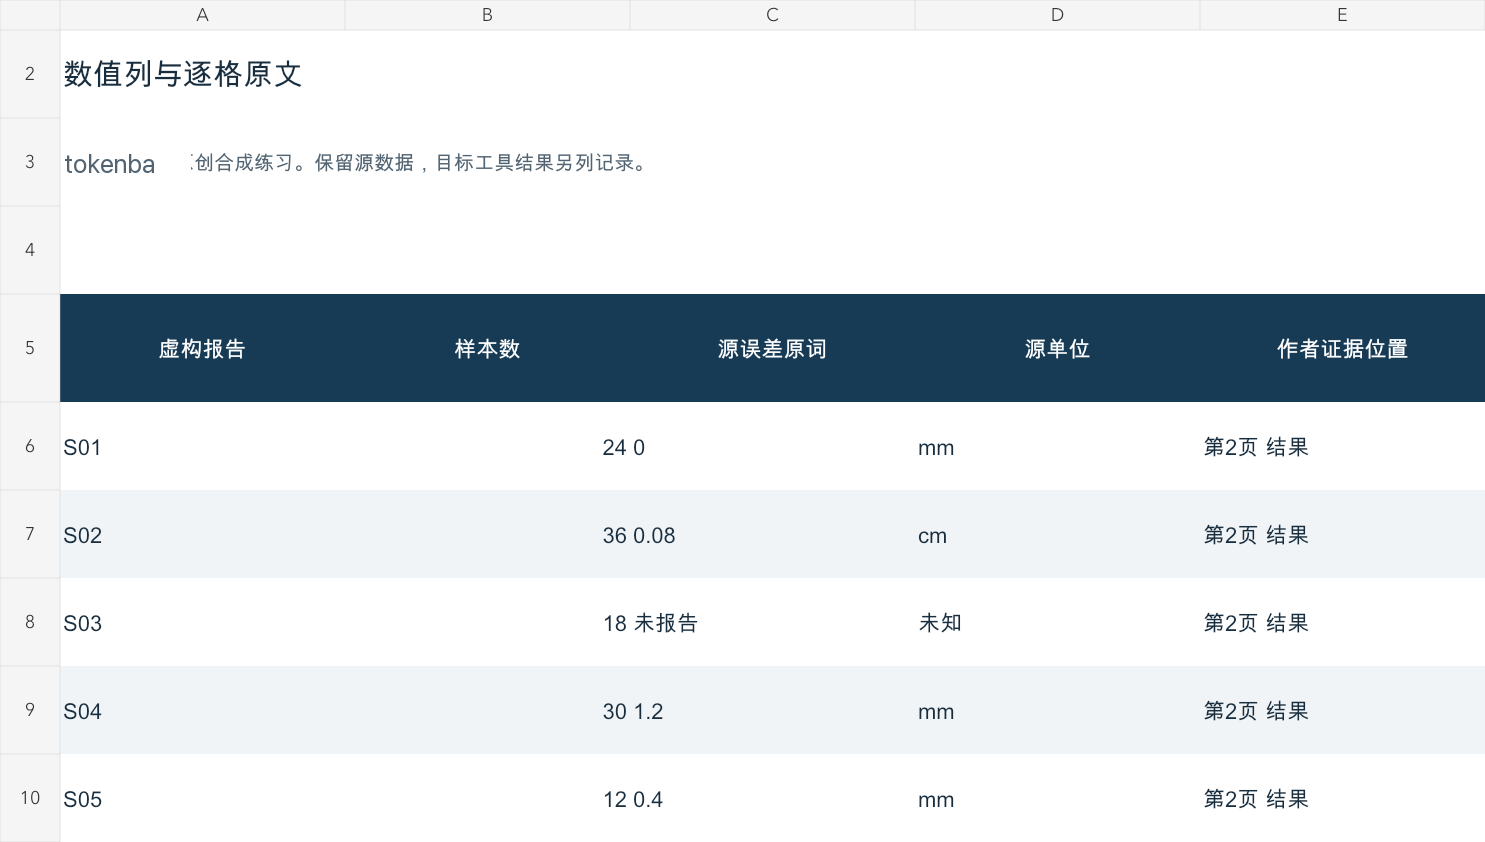
S01;24;0;mm;第2页 结果
S02;36;0.08;cm;第2页 结果
S03;18;未报告;未知;第2页 结果
S04;30;1.2;mm;第2页 结果
S05;12;0.4;mm;第2页 结果

输出:跨论文提取表、单元格证据截图与CSV
验收:每个数值有源位置,单位不混;缺失不由摘要猜填,导出列可对齐
身份与边界:五份PDF由作者编写并显著标为虚构纸尺实验,没有DOI,不是发表研究或科学证据。
不得伪造产品入口、账号权限、来源、DOI、运行轨迹或已通过记录。
练习文件与执行范围
五份PDF由作者编写并显著标为虚构纸尺实验,没有DOI,不是发表研究或科学证据。
下载包保留作者输入、分析与结果参考,以及等待你填写的实际运行记录。此页未登录执行目标云端功能。
怎样确认已经完成
- 每个数值有源位置,单位不混
- 缺失不由摘要猜填,导出列可对齐
- 先抽取源数值与源单位,再核对证据句和分析分母;0.08cm等于0.8mm,未报告必须与0分开。
- 五份PDF由作者编写并显著标为虚构纸尺实验,没有DOI,不是发表研究或科学证据。
常见问题
Elicit能从多篇论文批量抽数值并带出处吗?
先只用S02检查数值与单位的返回方式,记录产品实际支持的列类型和提示,不编造JSON导入接口。 先抽取源数值与源单位,再核对证据句和分析分母;0.08cm等于0.8mm,未报告必须与0分开。
AI抽取表里每个格子的证据在哪里打开?
保留实际CSV原列,作者reference.xlsx另列0.8mm等换算参考;产品导出不能被作者表冒充。 五份PDF由作者编写并显著标为虚构纸尺实验,没有DOI,不是发表研究或科学证据。
下载包中的结果是目标产品已经生成的吗?
结果参考由作者制作并以原生文件打开、渲染和检查,供你实际操作后对照。没有将本地材料验证说成目标SaaS已运行。