
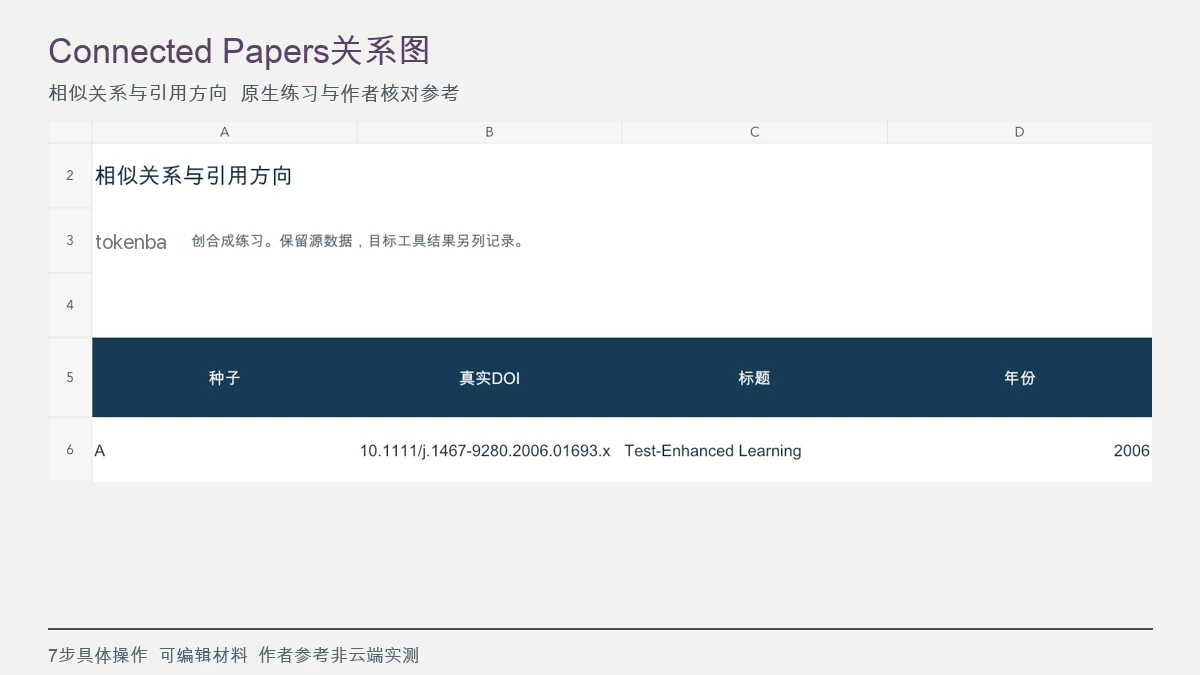
Connected Papers:相似论文图与前序后续工作
Connected Papers相似图和直接引用图不能混读;Prior、Derivative两份候选清单需分别回源核对方向。
阅读文章正在打开页面…
正在加载内容,请稍候。
54 篇教程,当前显示第 1–48 篇。选择页码继续浏览,或切换任务主题。
Connected Papers相似图和直接引用图不能混读;Prior、Derivative两份候选清单需分别回源核对方向。
阅读文章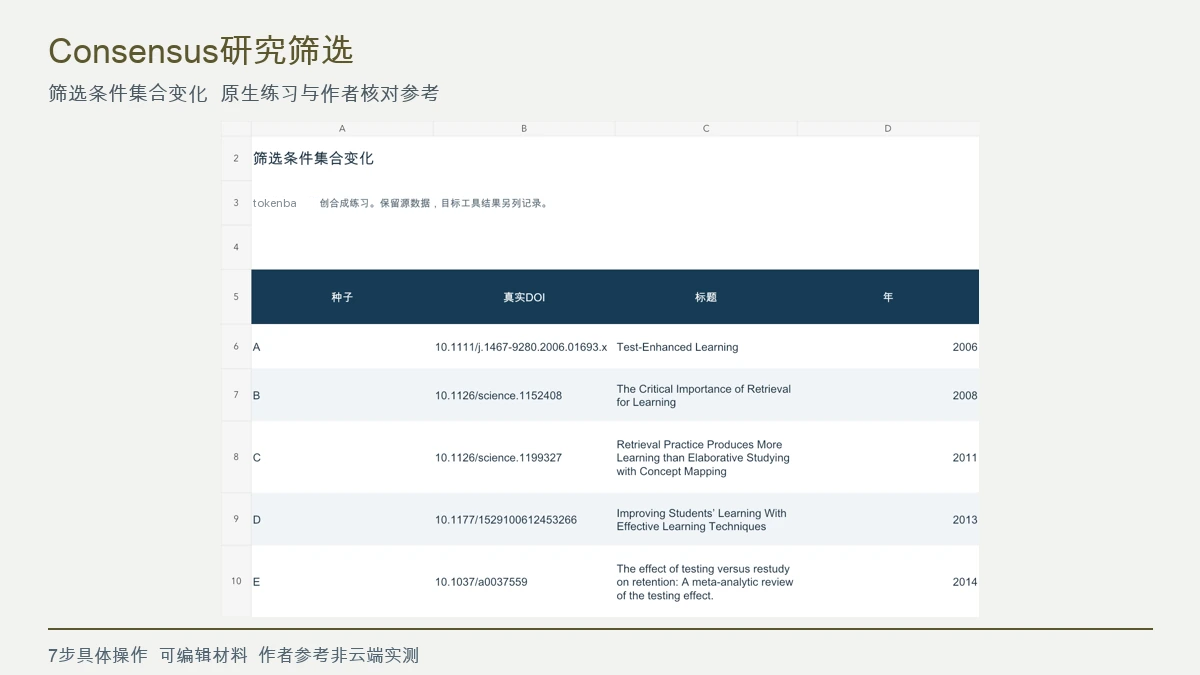
在 Consensus 保留未过滤的 S0 结果,再分别按研究类型、受试对象与开放获取建立独立集合,最后组合筛选。逐条回原文说明保留与排除理由,开放获取不代表研究质量更高。
阅读文章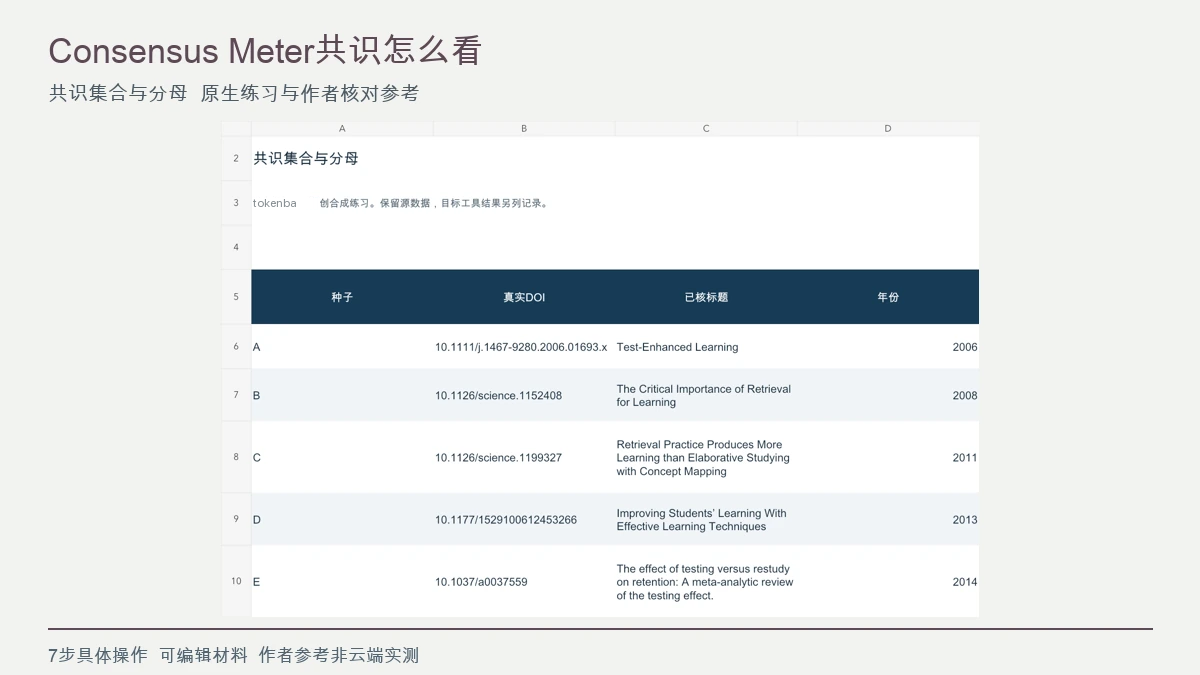
先看哪些研究进入分母,再读Yes、No、Possibly的原文条件;Meter百分比不等于总体真理概率。
阅读文章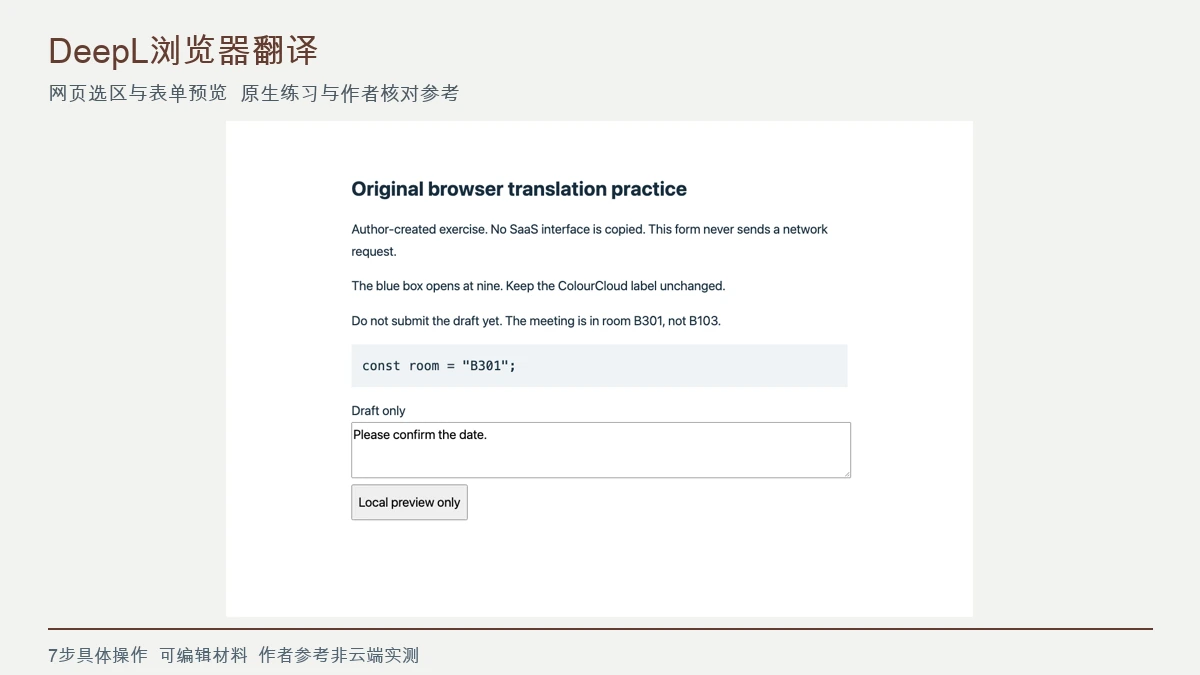
先分清选区、整页和输入框三种范围;本地练习表单没有网络提交,AI翻译也不等于发出消息。
阅读文章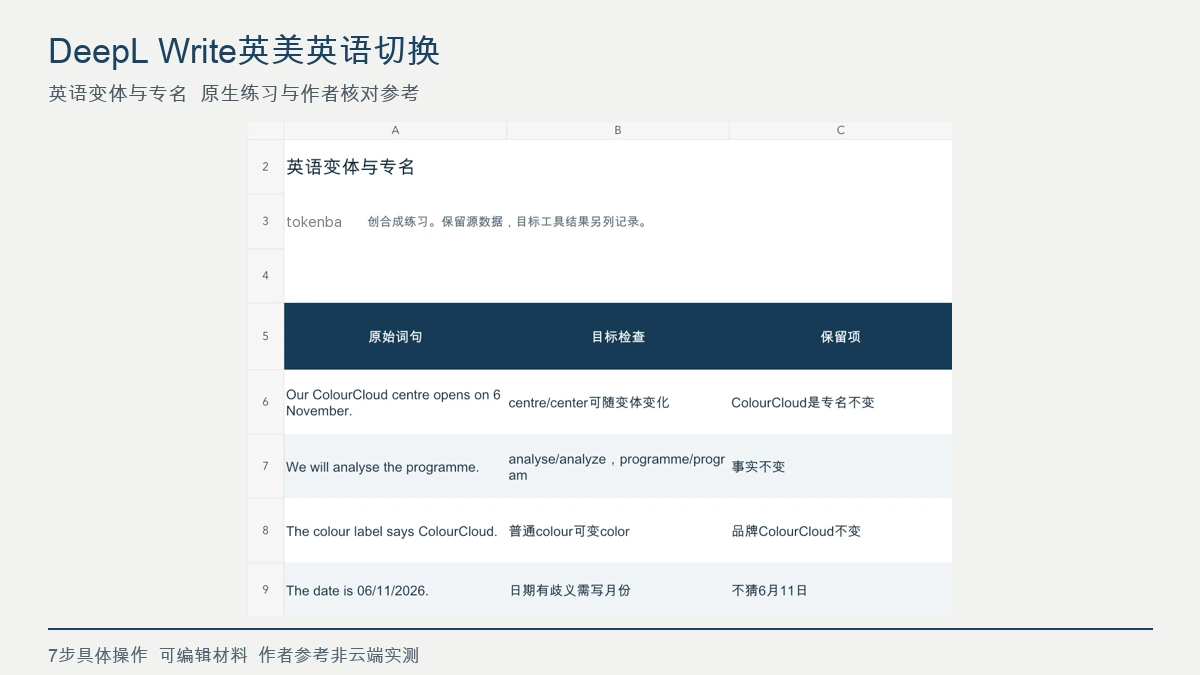
英美变体可统一普通拼写,但ColourCloud专名和2026年11月6日事实不应被误改。
阅读文章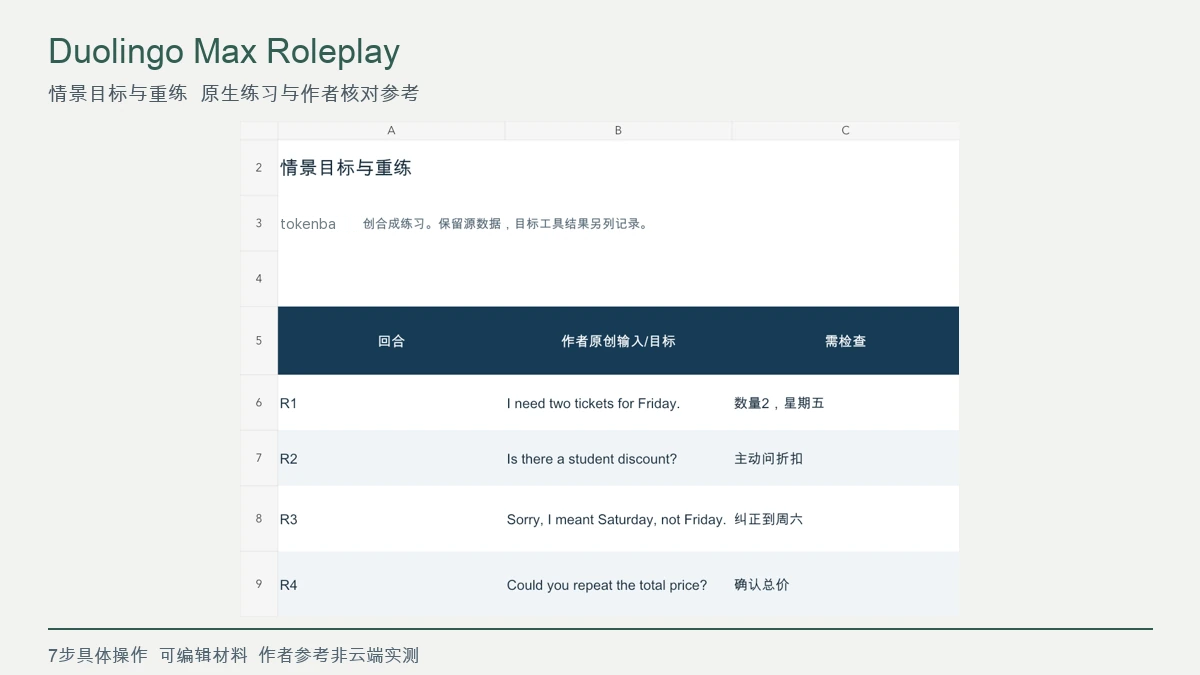
Roleplay先核对情景目标,再看针对实际说法的反馈;目标达成和语法无误分别判断,只重练一个缺口。
阅读文章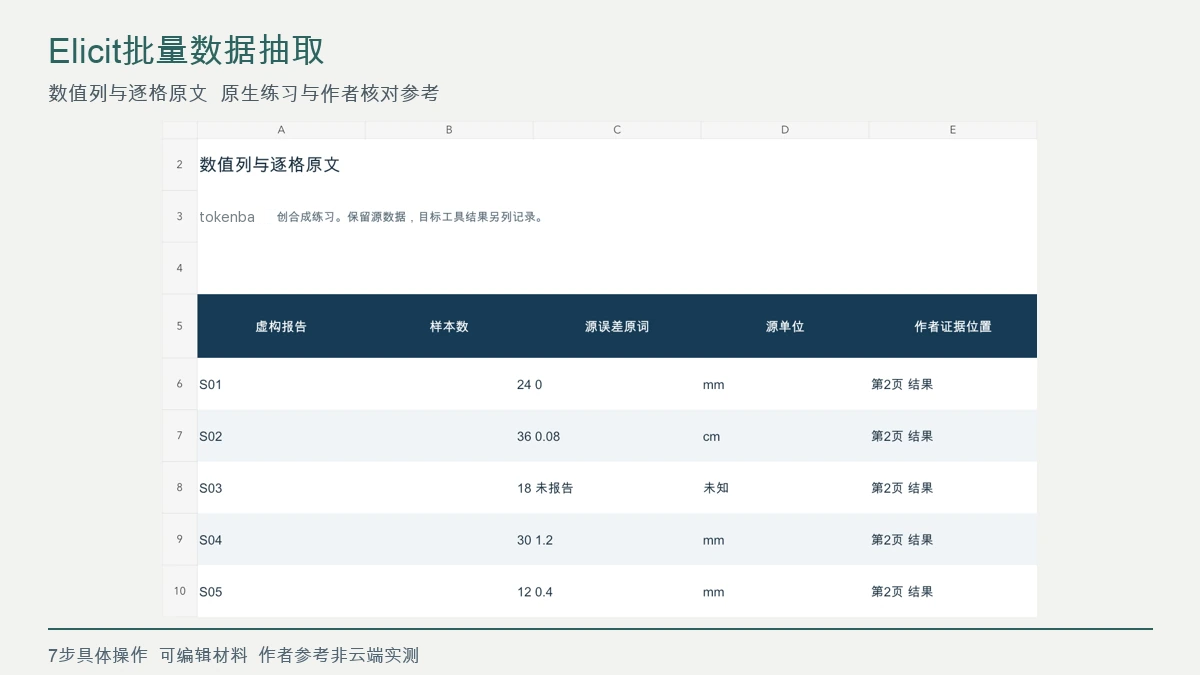
先抽取源数值与源单位,再核对证据句和分析分母;0.08cm等于0.8mm,未报告必须与0分开。
阅读文章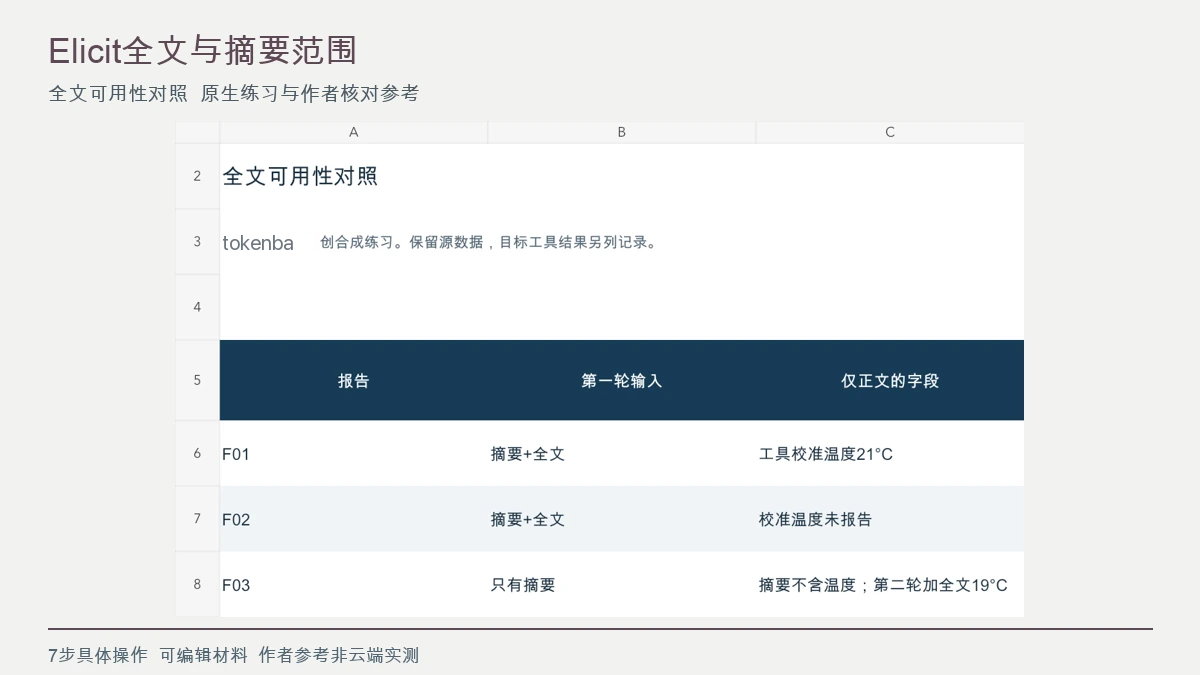
正文专有字段只在拿到全文后才能新增;摘要没有温度不能猜成常温,未报告与未获取要分开。
阅读文章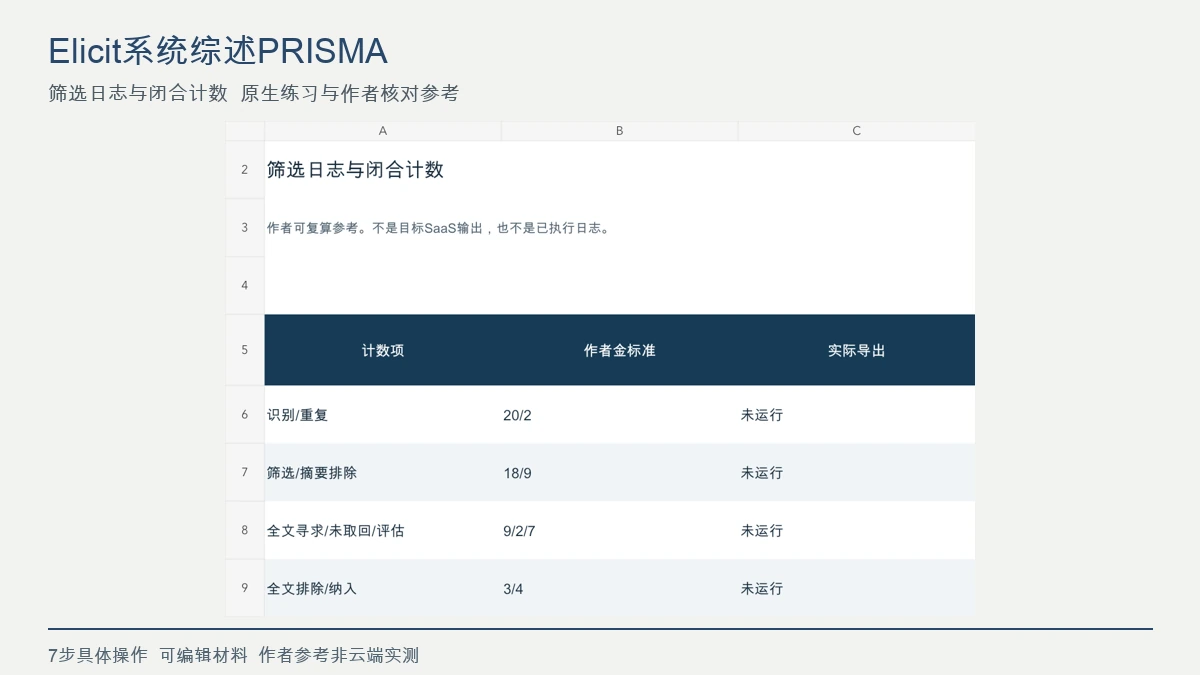
PRISMA计数必须从逐条决策复算:20识别、2重复、18筛选、9摘要排除、2全文未取回、3全文排除、4纳入。
阅读文章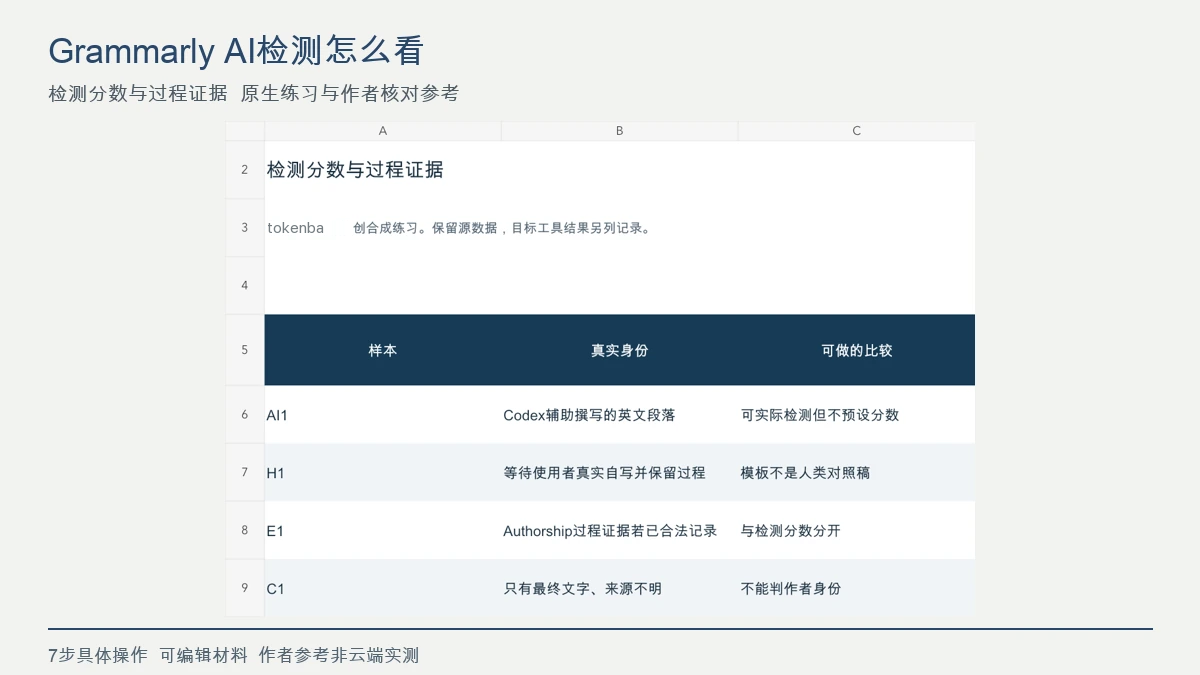
作者身份不能从AI检测分数直接推断;本包只提供明确AI辅助样本,真正人类对照稿必须由使用者亲自写并保留过程。
阅读文章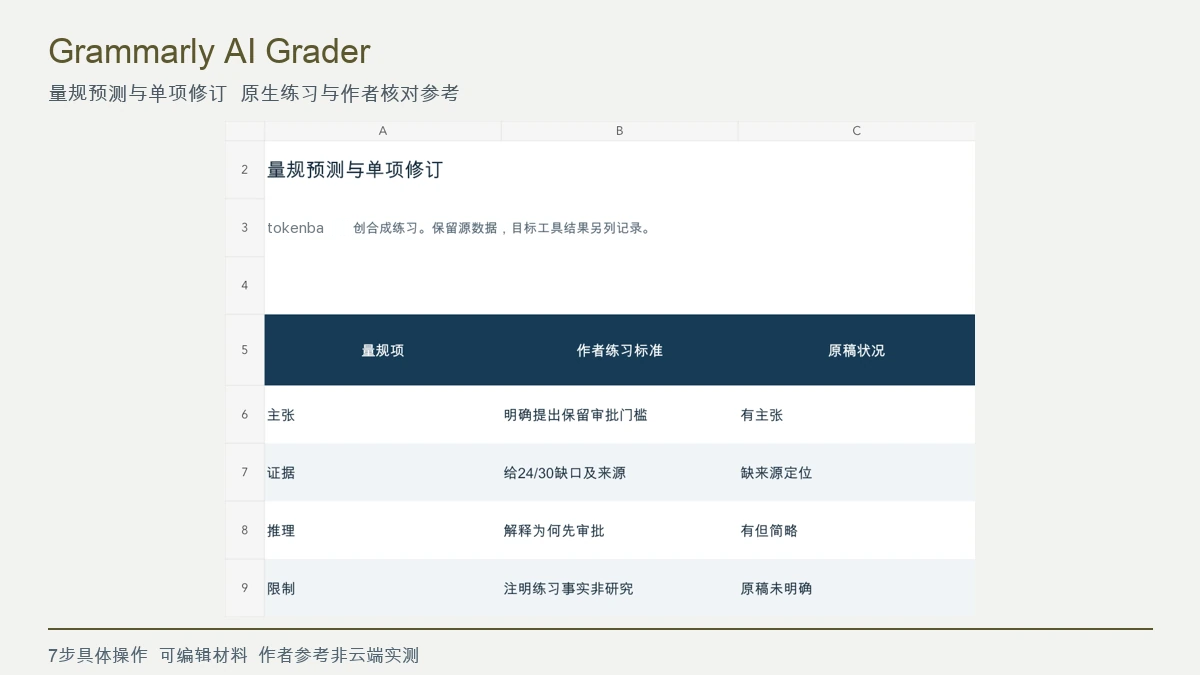
AI Grader的分数是预测,建议需回到量规与文本;本题只补来源定位,不为涨分编造证据或替教师打正式分。
阅读文章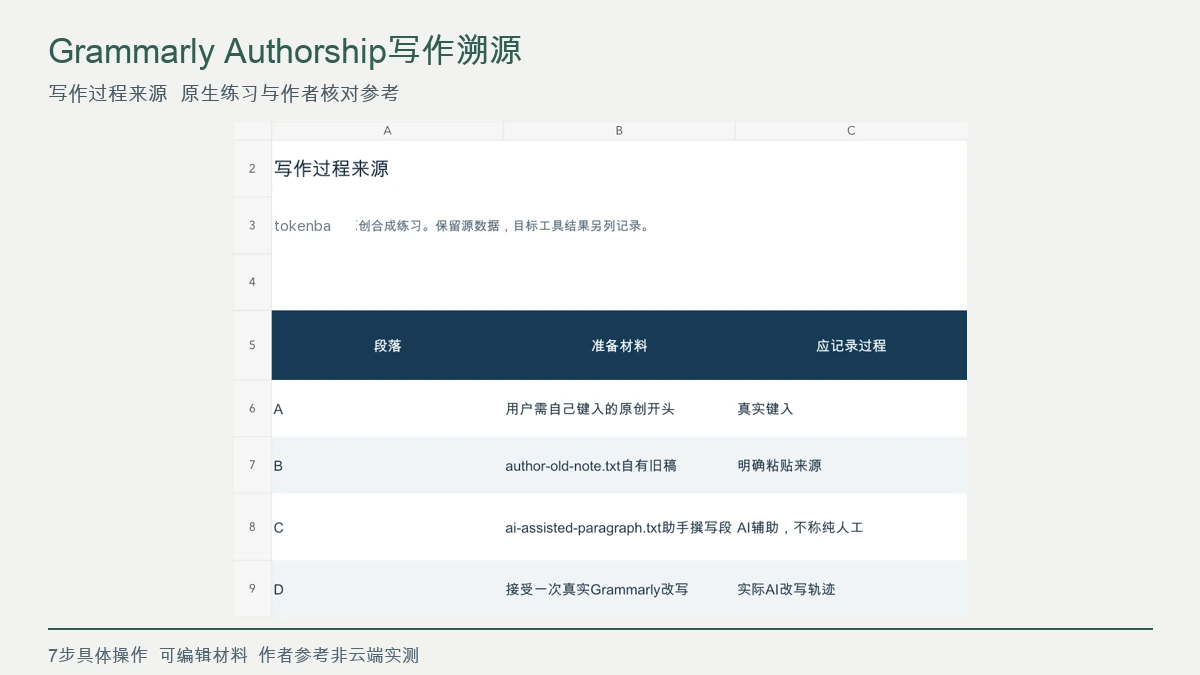
在受支持编辑器启用 Grammarly Authorship,分别亲自键入一段、粘贴注明来源的旧稿、接受一处真实 AI 改写。查看原生来源分类后导出报告,示例文件不能代替真实写作过程。
阅读文章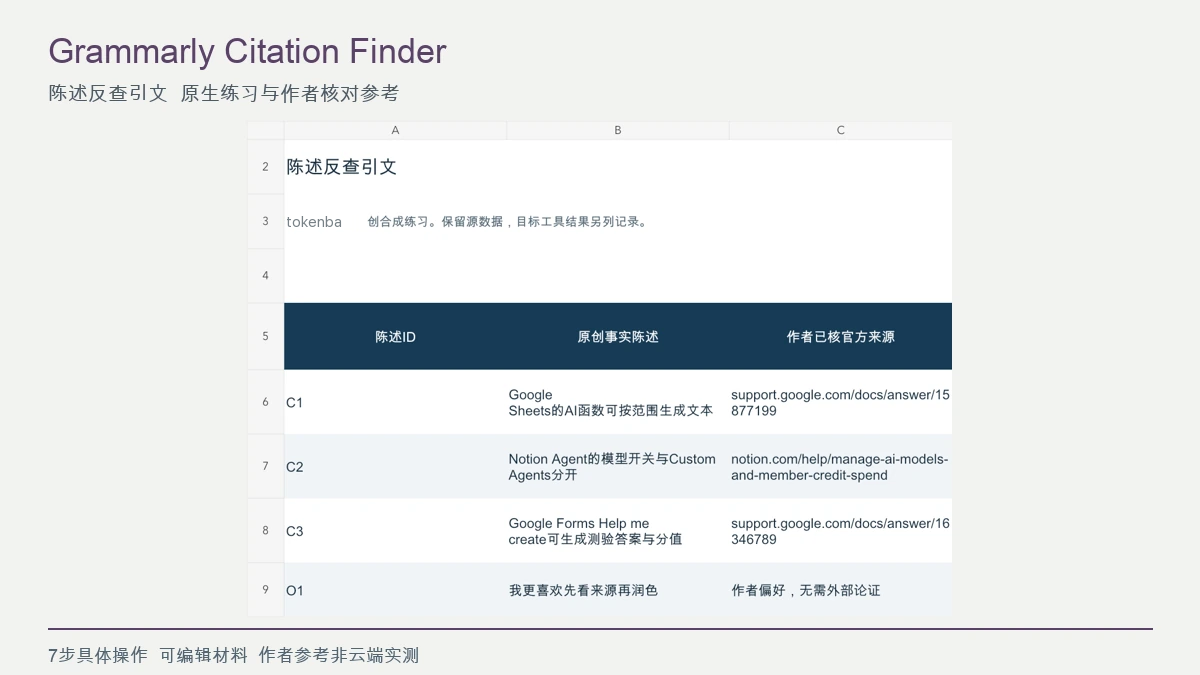
Citation Finder推荐的链接必须支持原句才能插入;工具名称相同或看起来权威并不足以当证据。
阅读文章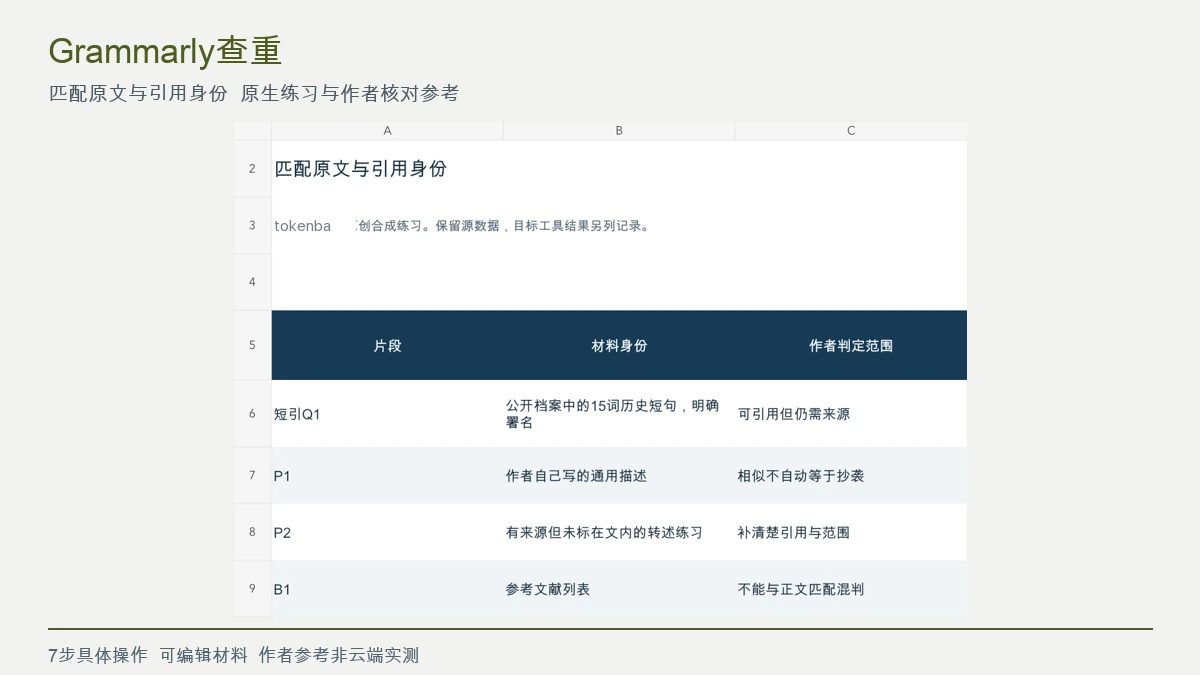
查重是定位文本与来源的匹配线索;每处仍要按引用身份和上下文判断,不能把“有匹配”直接等同违规。
阅读文章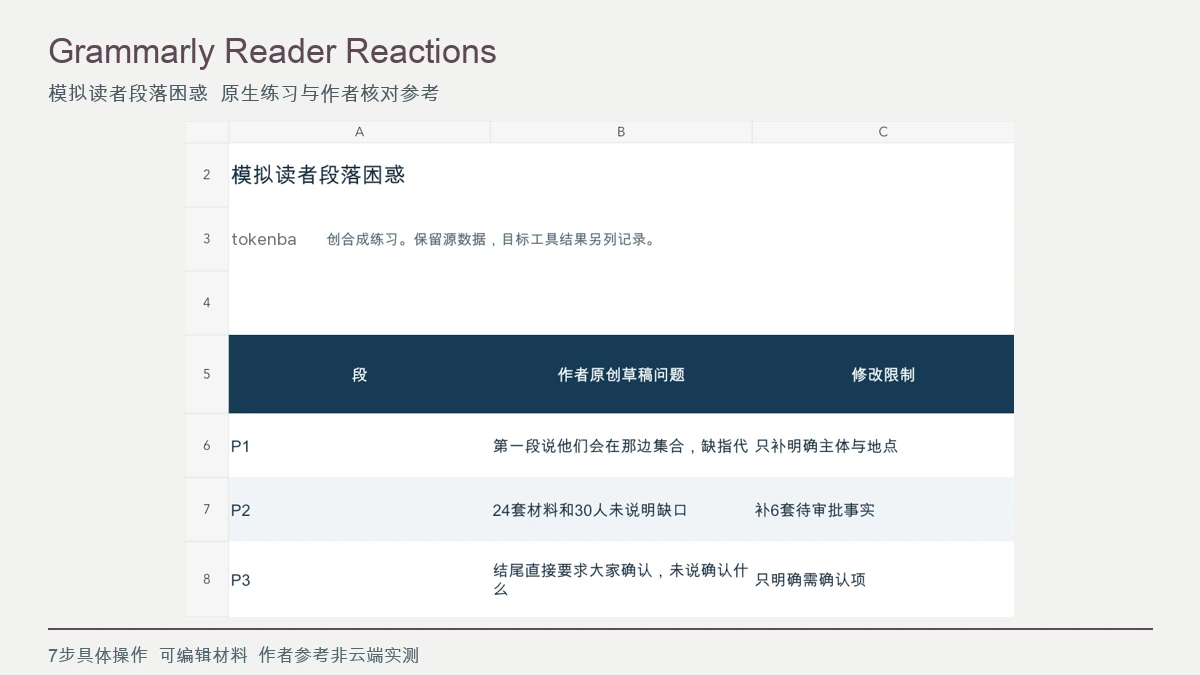
Reader Reactions是模拟读者预测,先定位困惑段落,只改一个事实表达缺口,再比较实际反应,不冒充真人调研。
阅读文章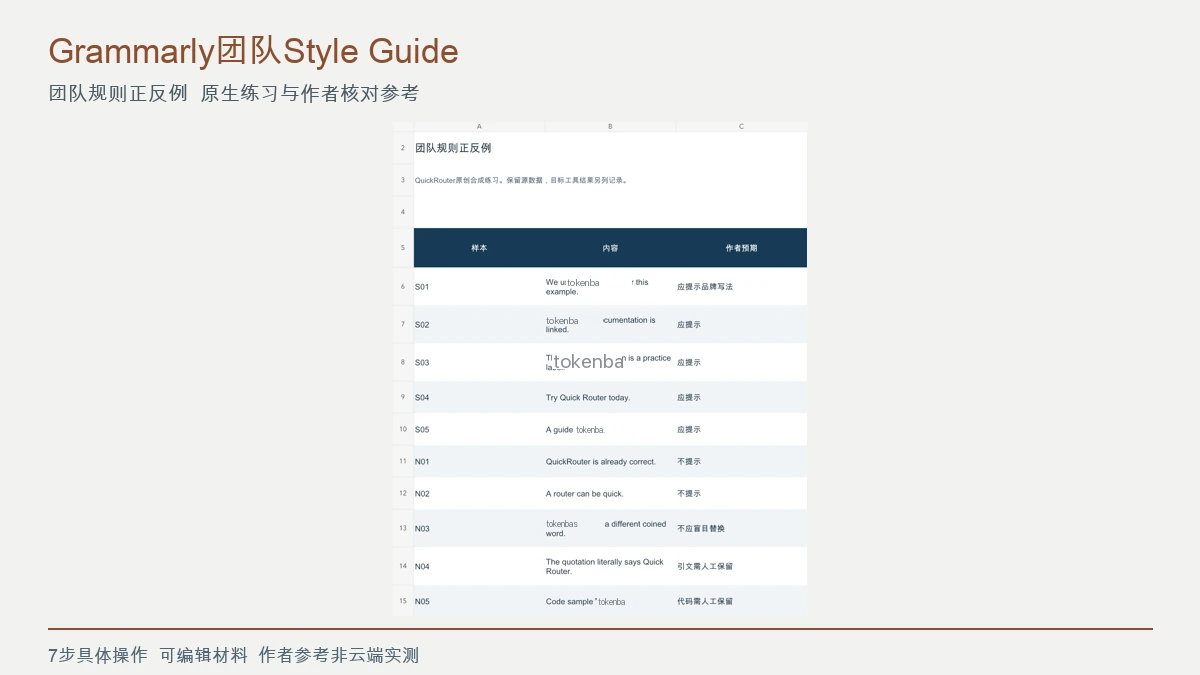
规则必须同时看五个正例与五个反例;若界面不支持语境例外,就让引用和代码保留人工判断,不能编造开关。
阅读文章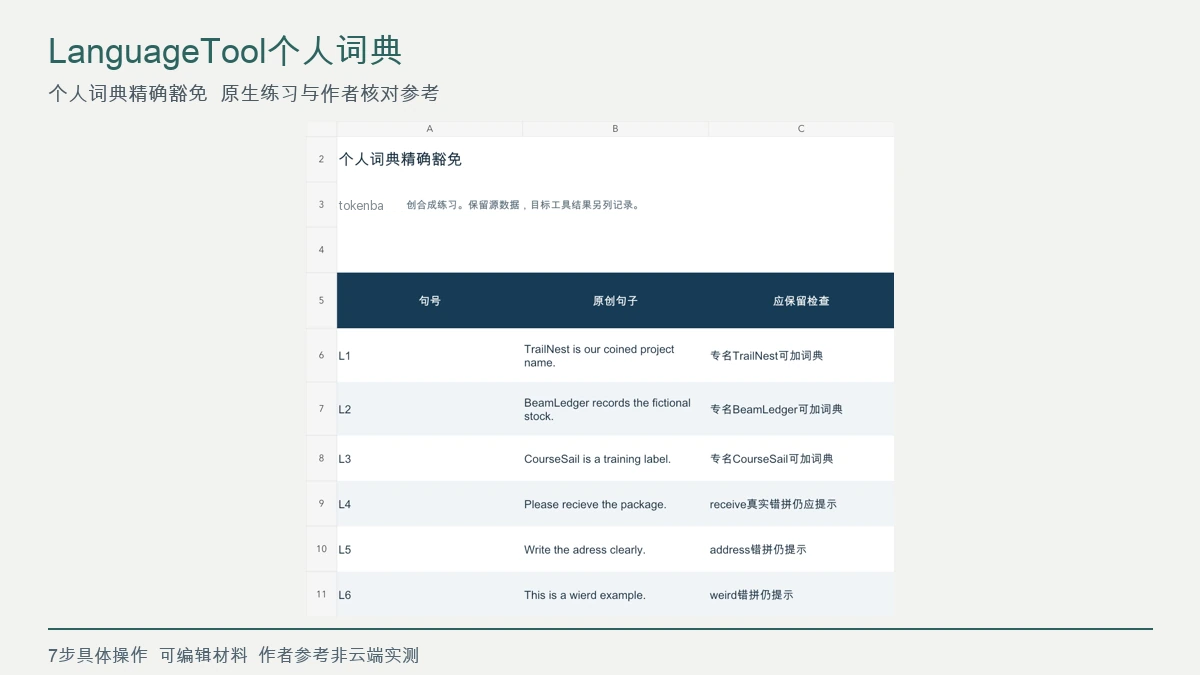
只把三个完整专名加入个人词典;recieve、adress、wierd和未授权近似错拼仍应接受检查。
阅读文章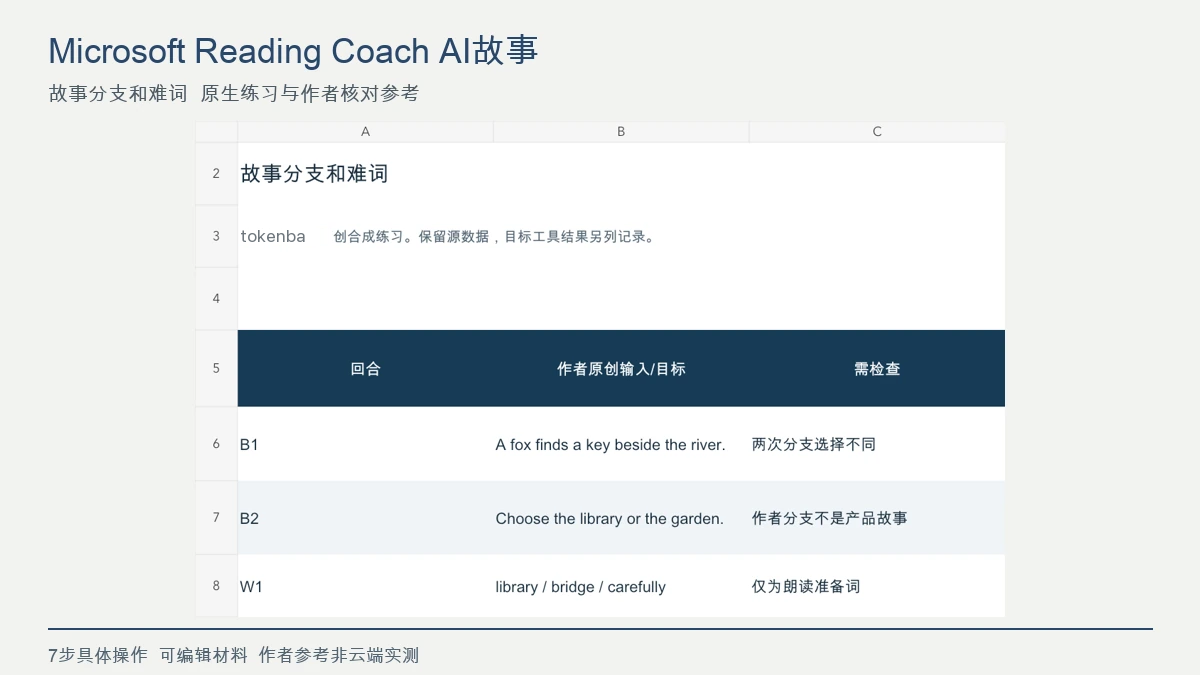
先保存两次实际故事分支,再练应用本次标出的难词;作者准备词不等于系统判错,准确率不预填。
阅读文章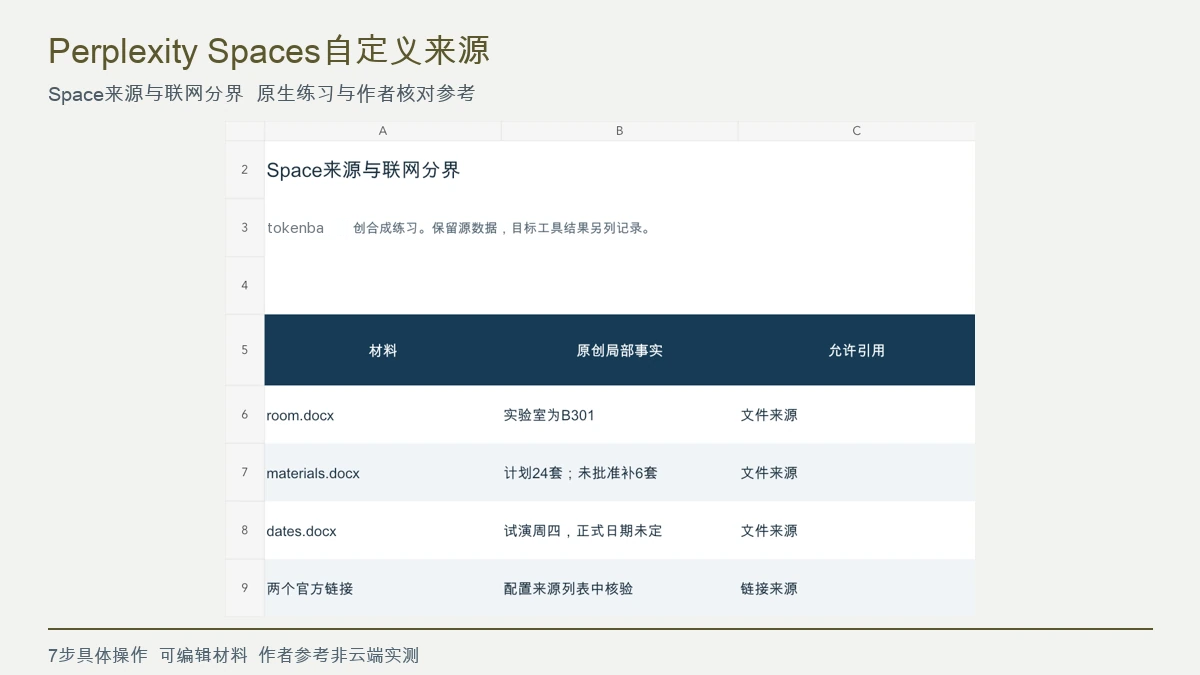
先分清文件答案与联网补充;没有原生禁网选项时,明确只是来源偏好,不把提示词当权限边界。
阅读文章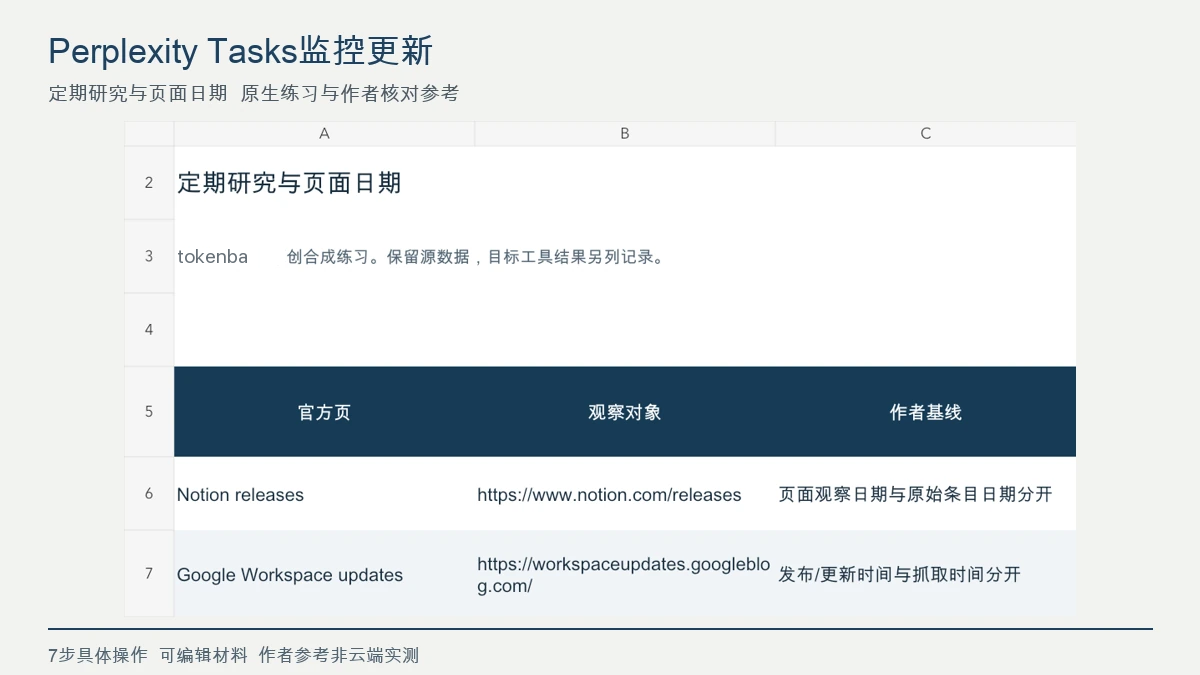
“今天抓到”不是“今天发布”;定期任务每条更新要回原页核对日期,与基线去重,测试后停用。
阅读文章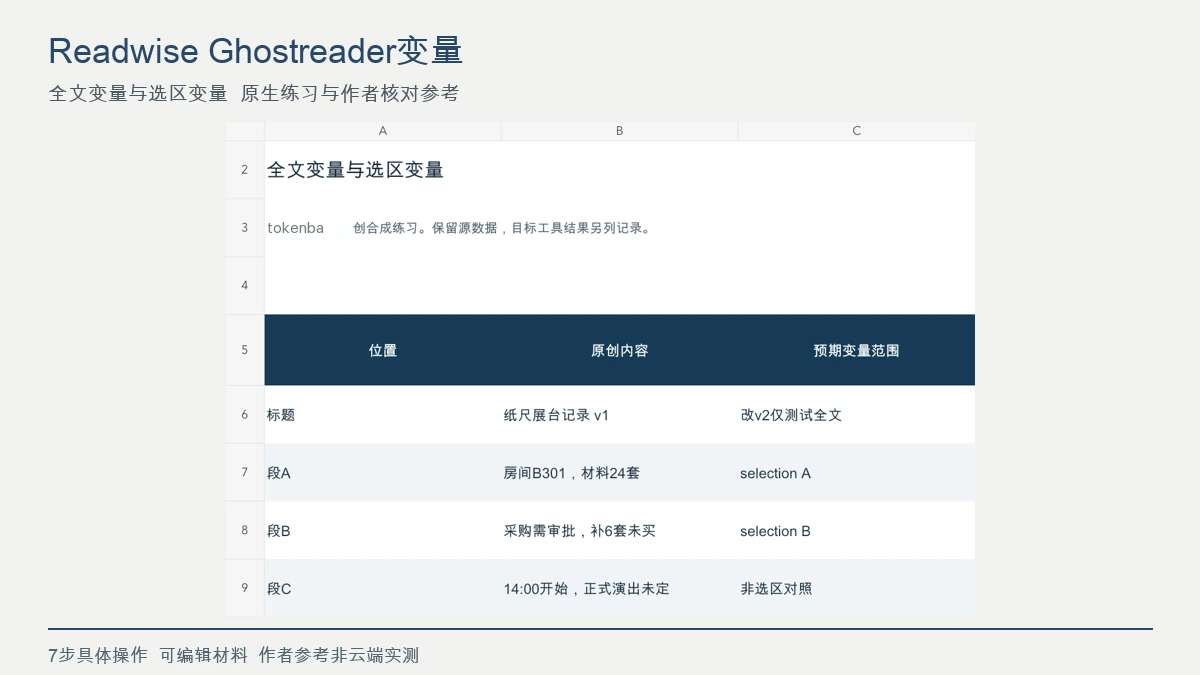
分别用selection与document传参,看同一原文不同范围;标题版本变化只在全文上下文核对,不凭提示词名推断变量展开。
阅读文章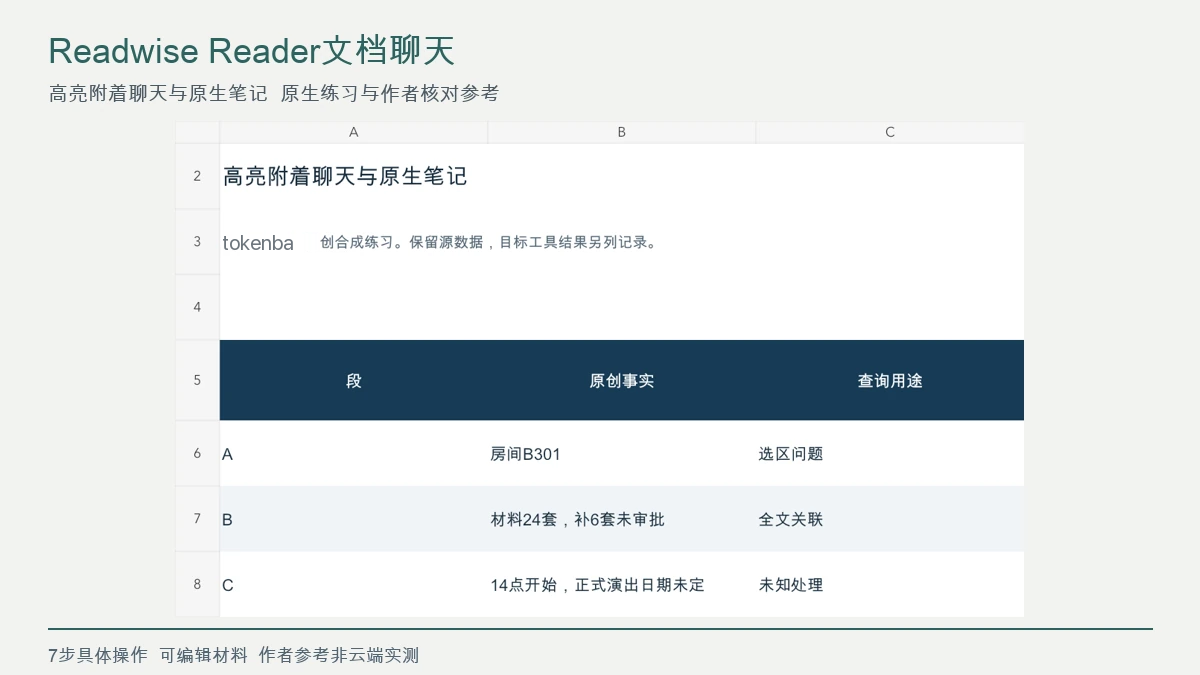
本题必须使用Reader高亮注释栏打开附着该段的Ghostreader Chat,再把核过的真实回答保存回文档笔记。缺高亮附着或原生笔记保存就停止;选中段落是聚焦上下文,不是限制全文访问。
阅读文章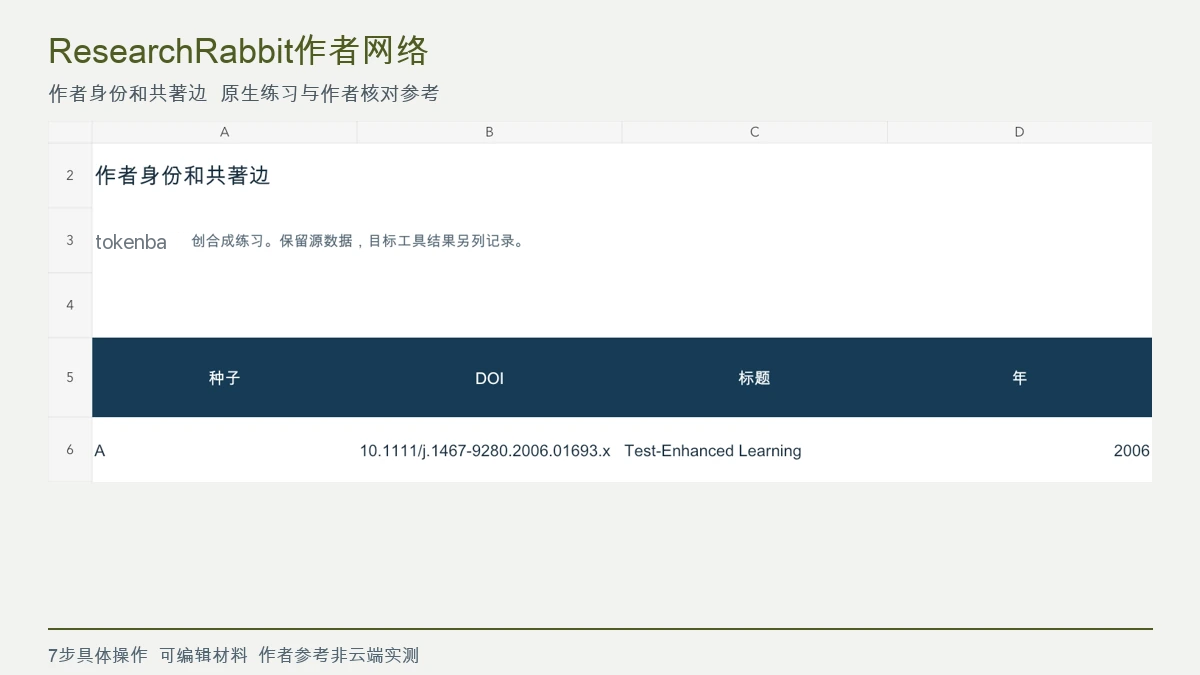
从作者视图展开的每条共著边都应指回共同论文;相同姓氏或缩写不能自动合并身份。
阅读文章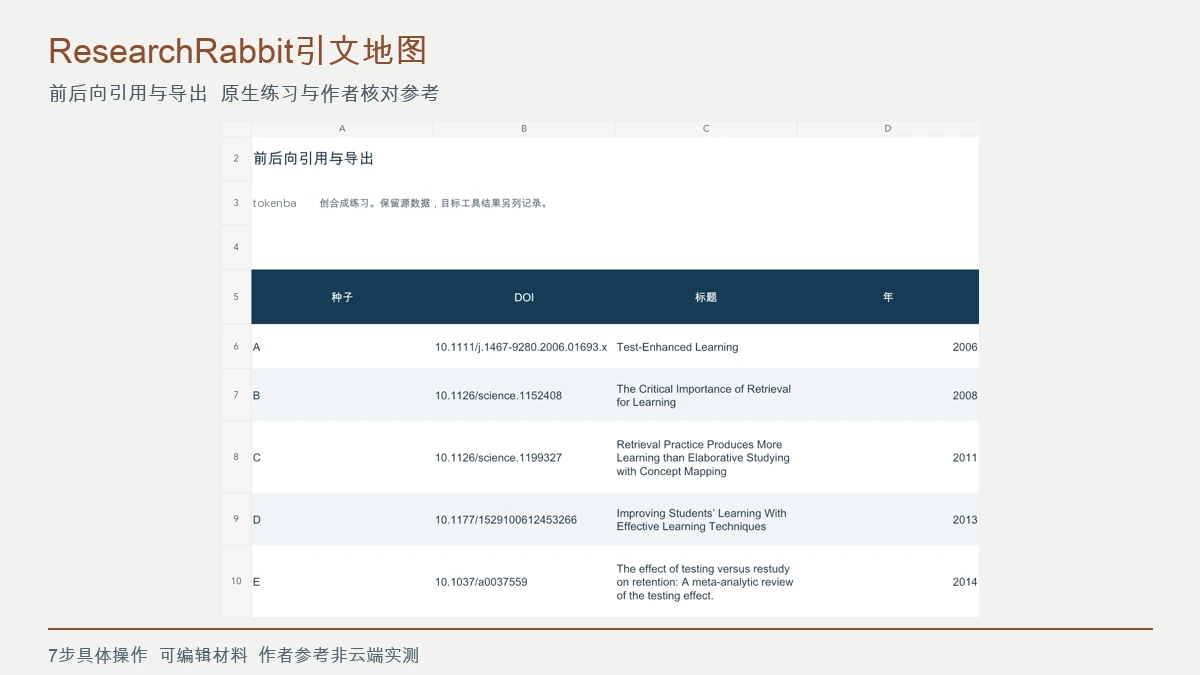
前向是后来谁引用种子,后向是种子引用谁;导出需保留来源层与版本身份,不按相似标题误合。
阅读文章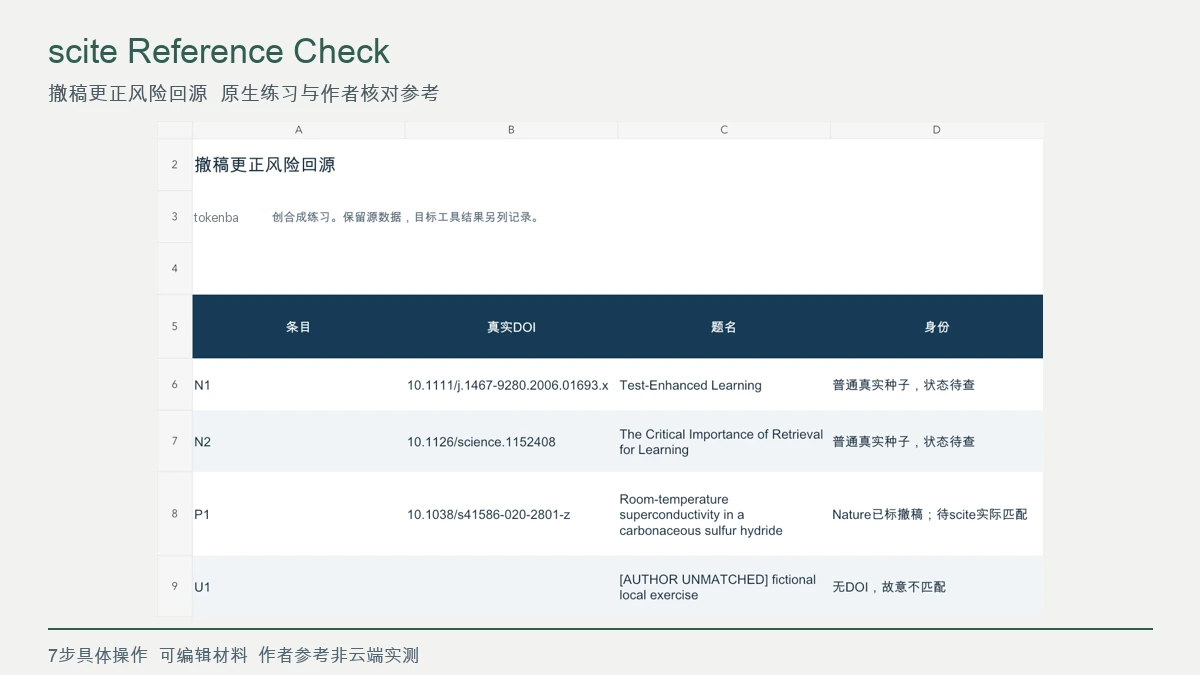
Reference Check只定位风险线索;每个撤稿或更正标记必须回出版方公告,未匹配条目单独列。
阅读文章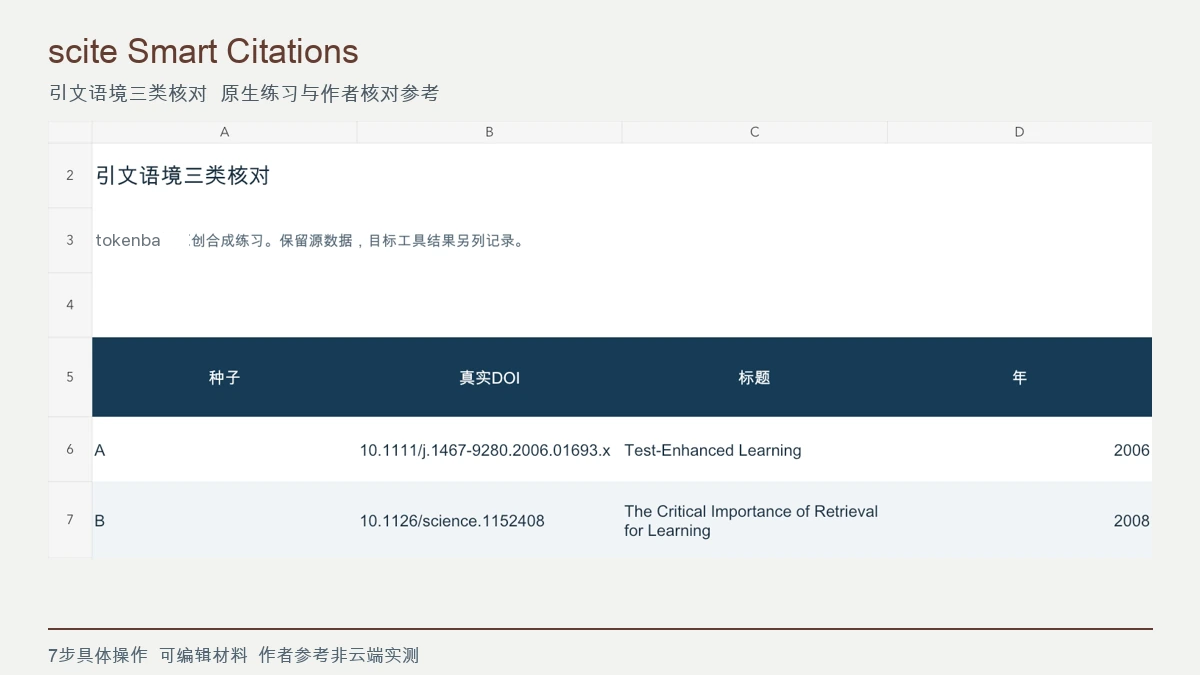
Smart Citations的分类需回到施引论文的完整语境;Mentioning不能算Supporting,Contrasting要说清反驳对象。
阅读文章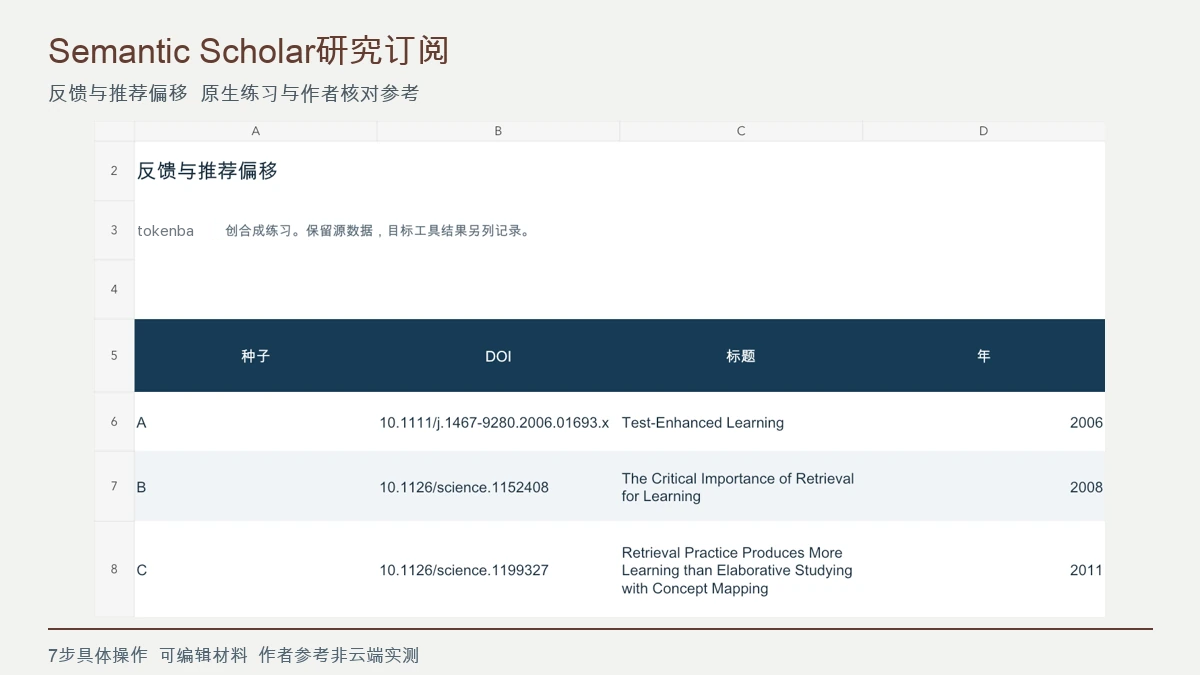
Research Feed反馈应对应真实推荐与明确理由;下一轮可以没有明显改善,个性化推荐也不是系统综述。
阅读文章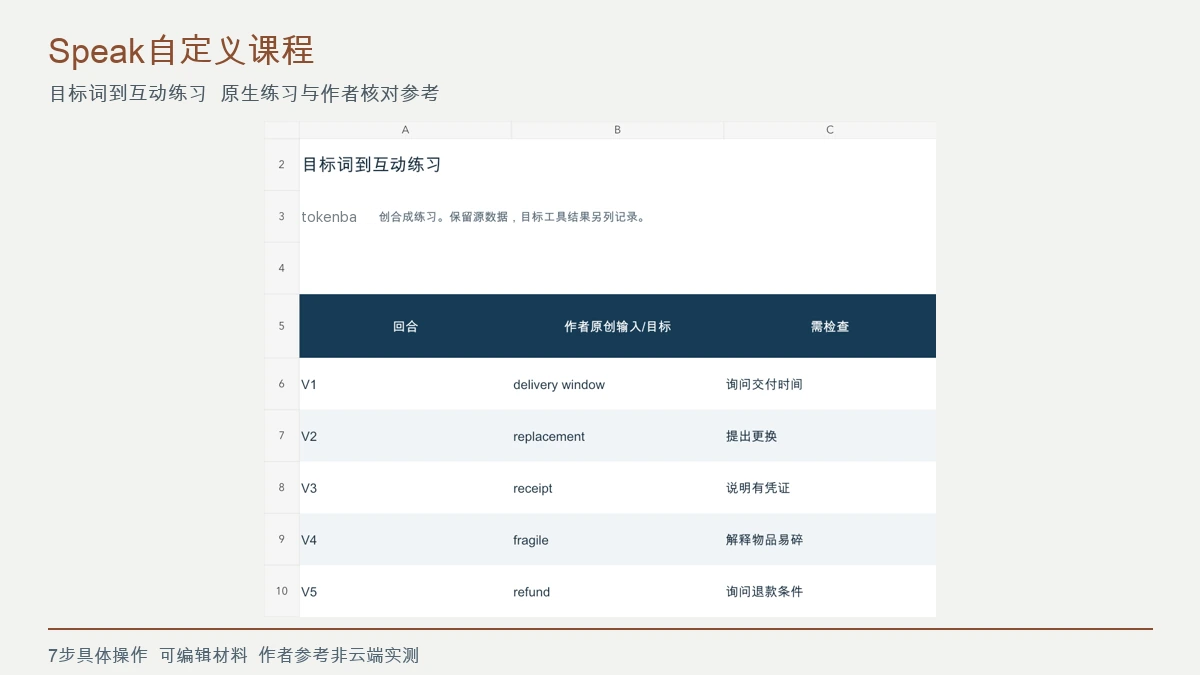
自定义课程要检查目标词是否进入可做的互动任务;只在目录列了词不算覆盖,缺项明确补练。
阅读文章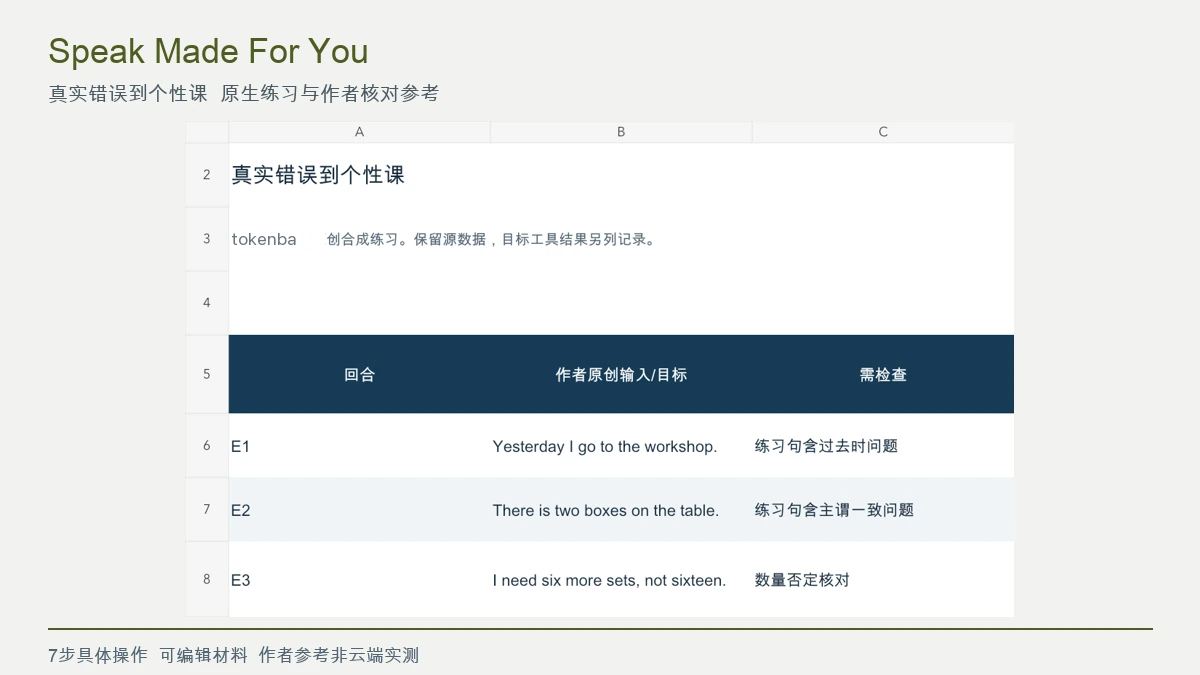
Made For You必须来自使用者真实练习;把原生个性课逐项映射到实际说法,没有触发就保留未触发。
阅读文章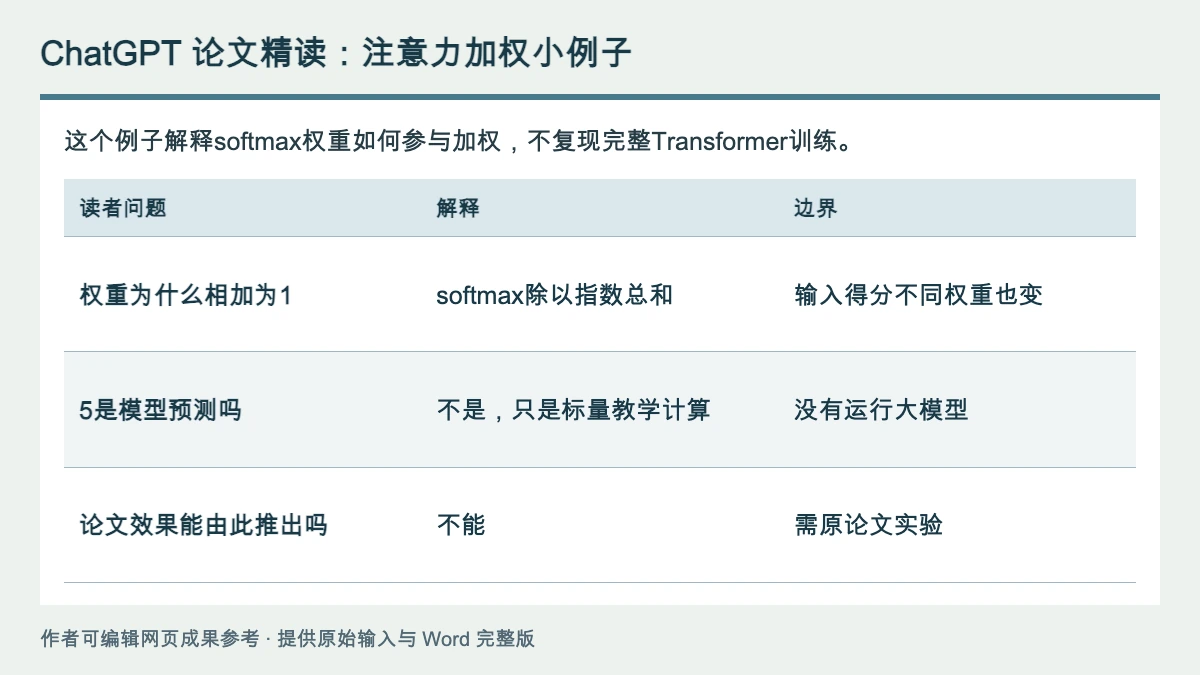
将论文与自己的基础交给 ChatGPT,先补齐 softmax 和加权求和概念,再用 0 与 ln3 得到 1/4、3/4 权重,把 2 与 6 加权得到 5。该小例子只解释概念,原论文的投影和多头结论仍需回到正文。
阅读文章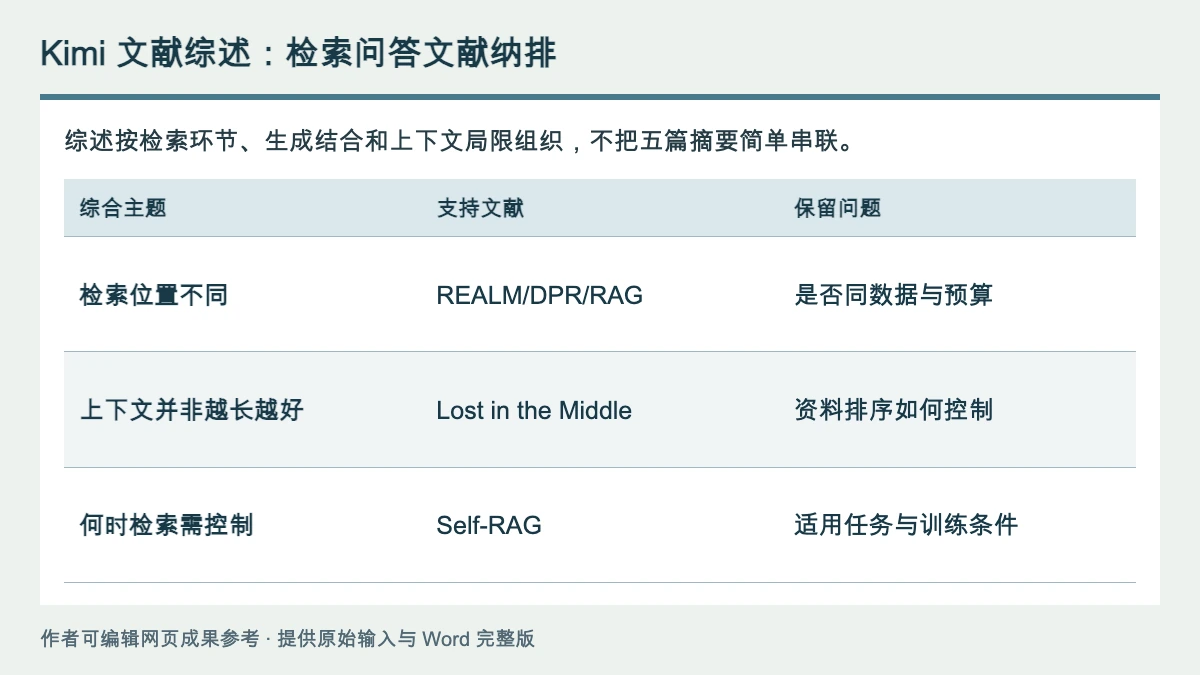
在 Kimi Deep Research 先锁定纳排标准,再逐篇打开七个 arXiv 原文,将 REALM、DPR、RAG、长上下文与 Self-RAG 的方法位置分开比较。BERT 和 Attention 只作背景,不跨实验条件排指标总榜。
阅读文章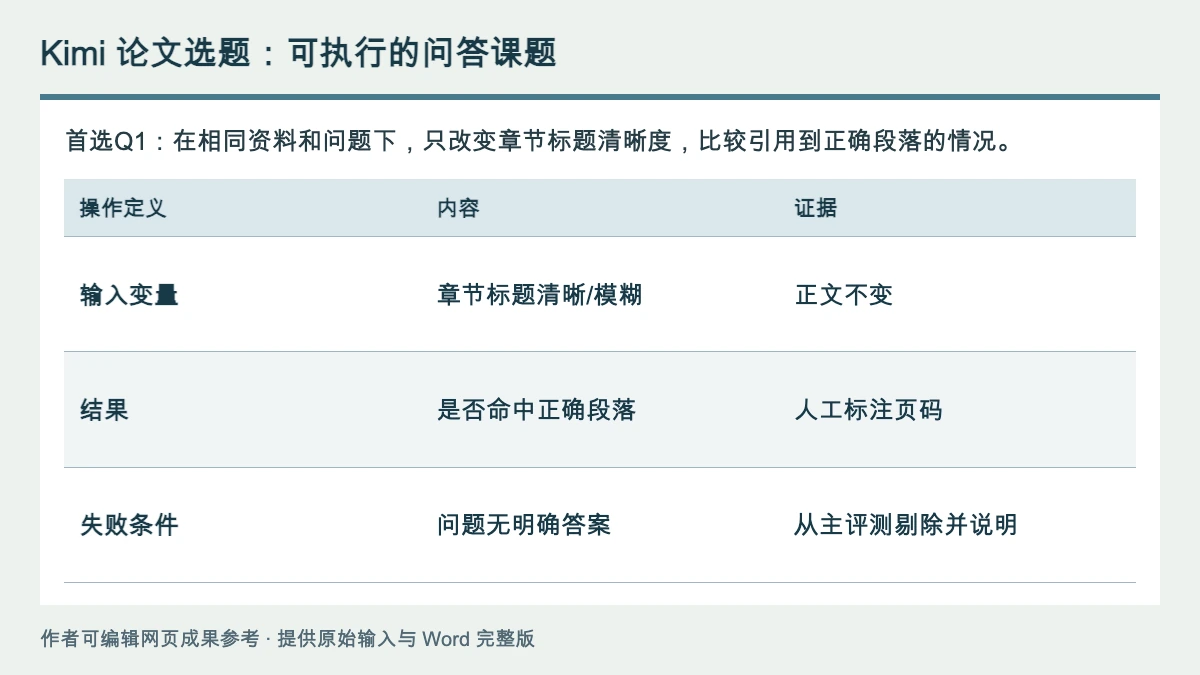
把两周、二十题和数据可得性约束交给 Kimi,比较三个候选课题后选定单一变量问题。先用四题检验正确段落命中的人工标注规则,存在歧义先修口径再做模型实验。
阅读文章
在 NotebookLM Sources 发起限定范围的资料发现,逐条打开候选原站。去掉只含追踪参数差异的 S02,保留三份独立官方来源后再导入,并用具体问题检查实际入库范围。
阅读文章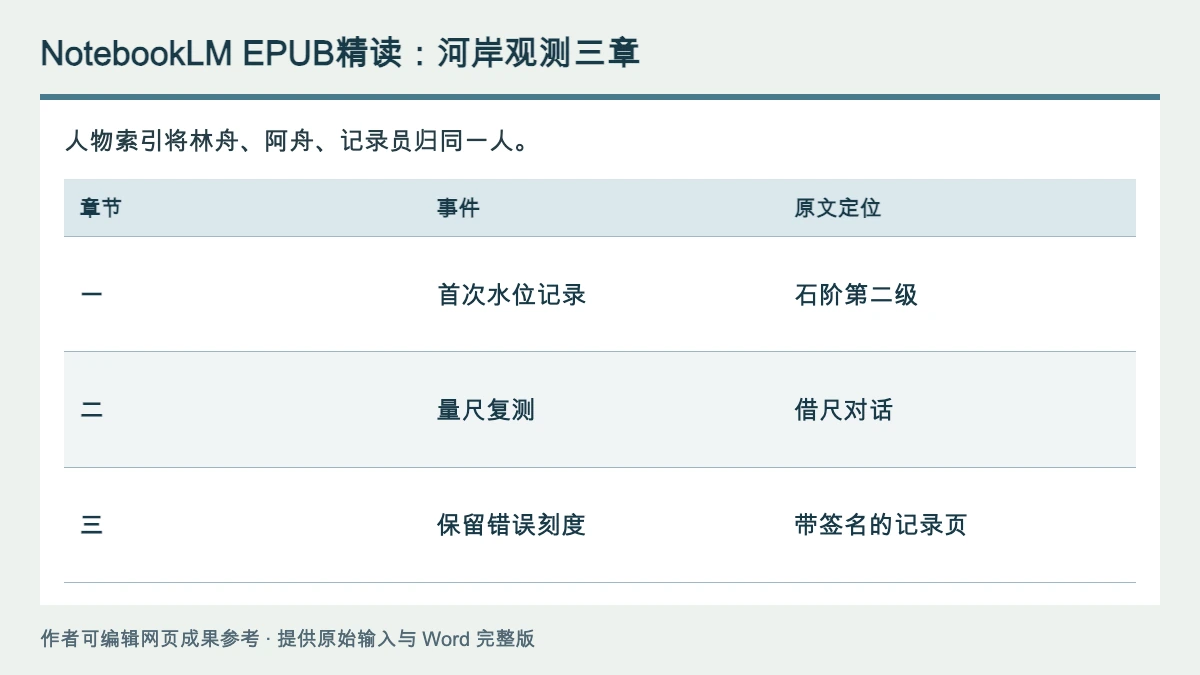
把原创三章 EPUB 上传到 NotebookLM,先检查章节文本,再按人物别称与事件建立证据索引。林舟、阿舟和记录员可依原文归一,桥守没有同一身份依据时单独保留。
阅读文章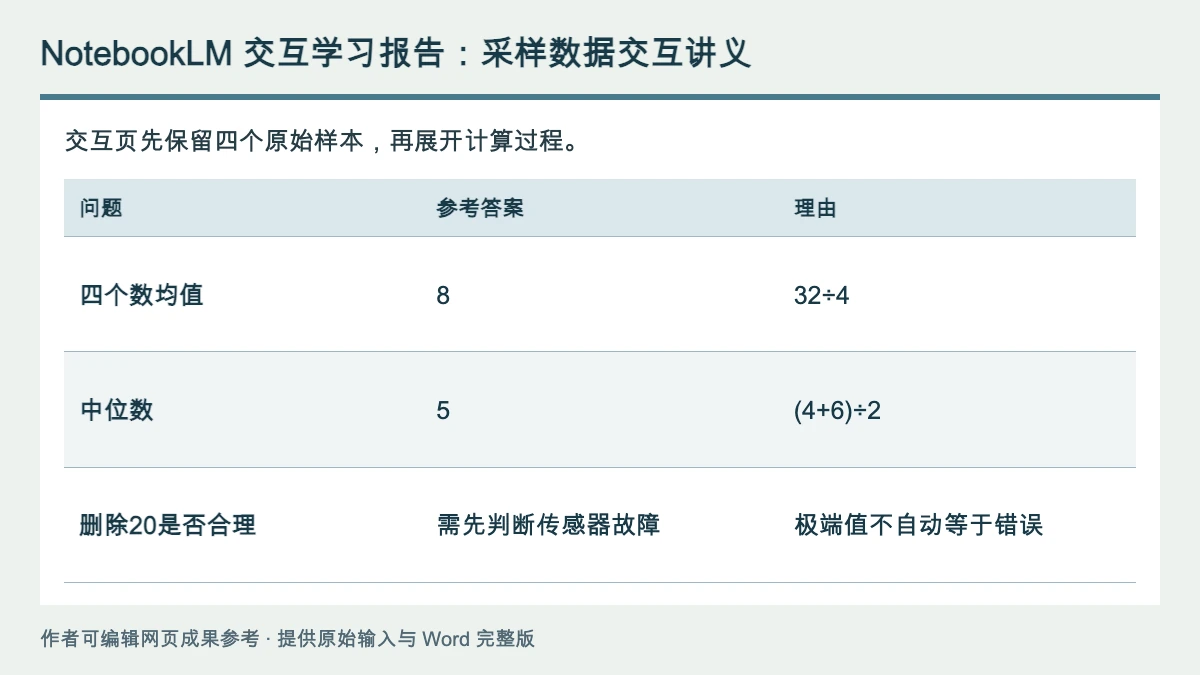
在 NotebookLM Studio 选择 Reports 的交互学习报告,围绕 2、4、6、20 的讲义加入均值、中位数和练习目标。逐项展开内容,核对均值 8 与中位数 5 都对应正确问题。
阅读文章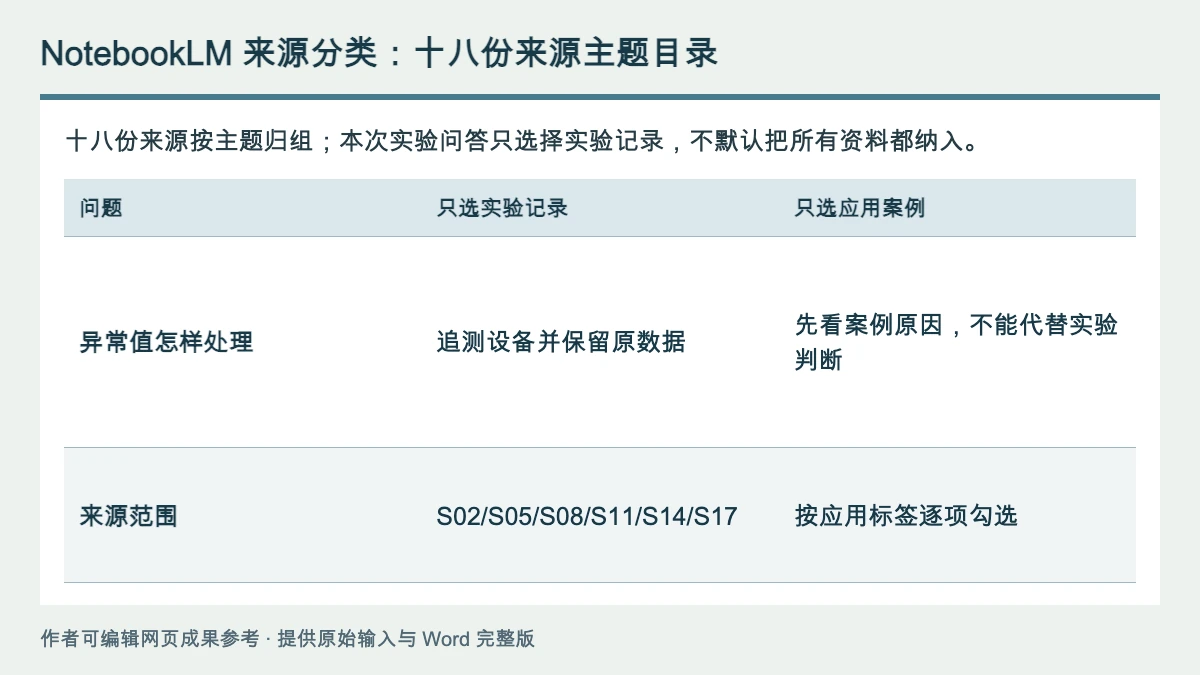
给 NotebookLM 的十八份来源整理主题标签,改名并移动误分资料。每次问答用复选框明确选择实验组或应用组,回读引用确认范围;主题标签不会改变共享权限。
阅读文章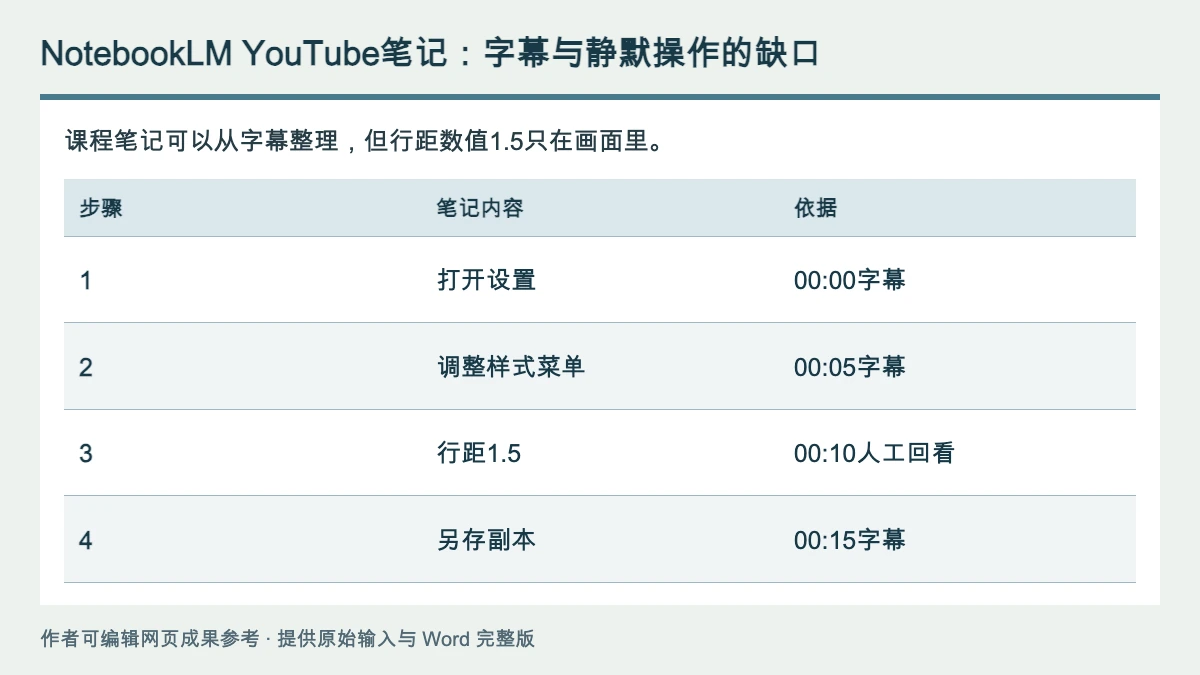
导入公开带字幕的 YouTube 链接,打开来源确认读入的是字幕,再要求按来源整理引用笔记。回看静默演示画面并标出字幕无法提供的步骤;本地 VTT 教材不是线上导入记录。
阅读文章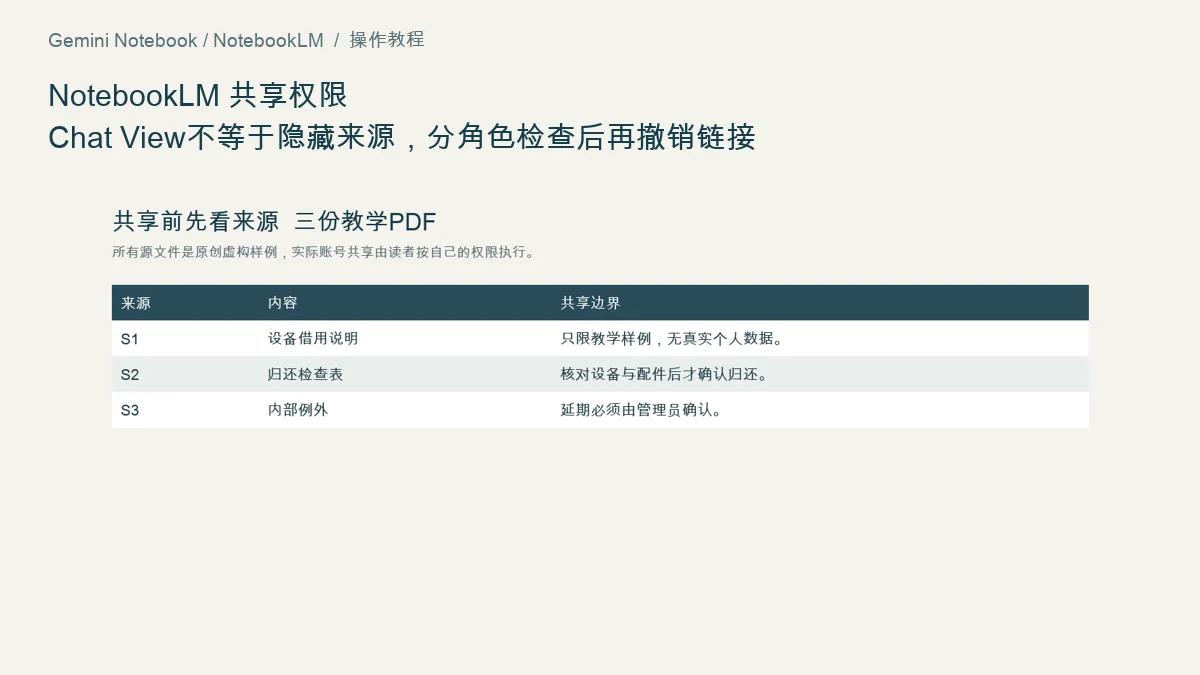
只用虚构来源建立测试笔记本,分别设置 Viewer/Editor,再用自己控制的不同账号检查普通链接与 Chat View 的来源可见范围。
阅读文章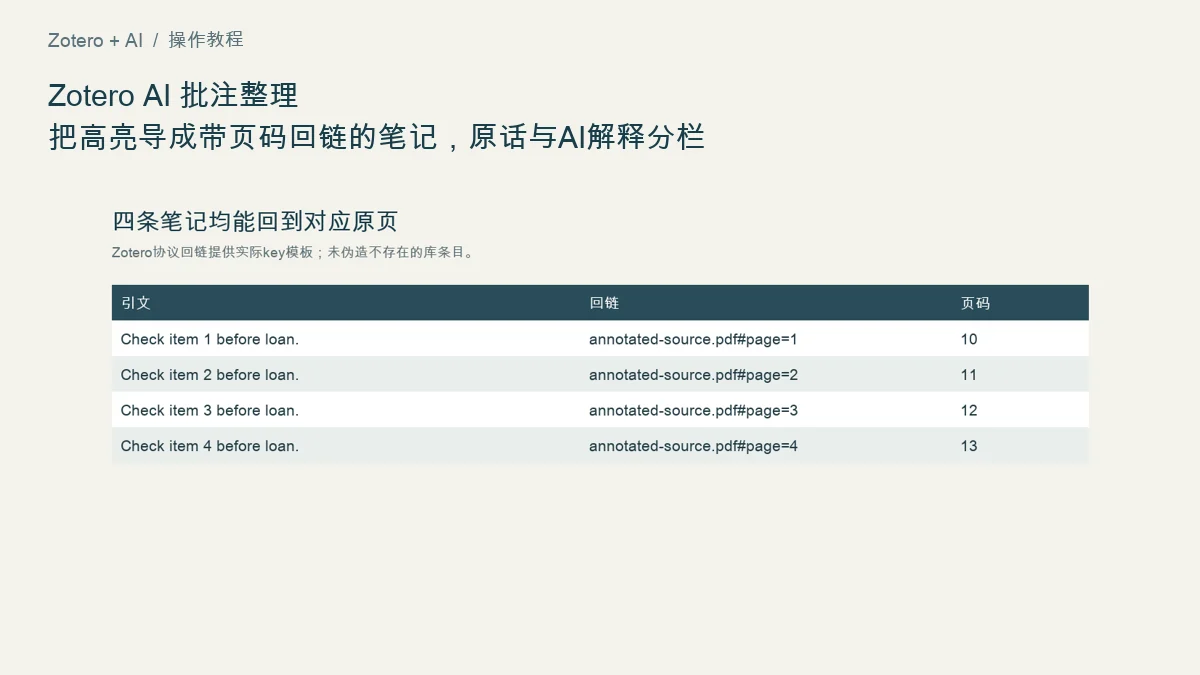
实际PDF含4个高亮注释和1条文字注释;物理页1至4对应印刷页10至13,本地笔记回链均指回原始PDF。
阅读文章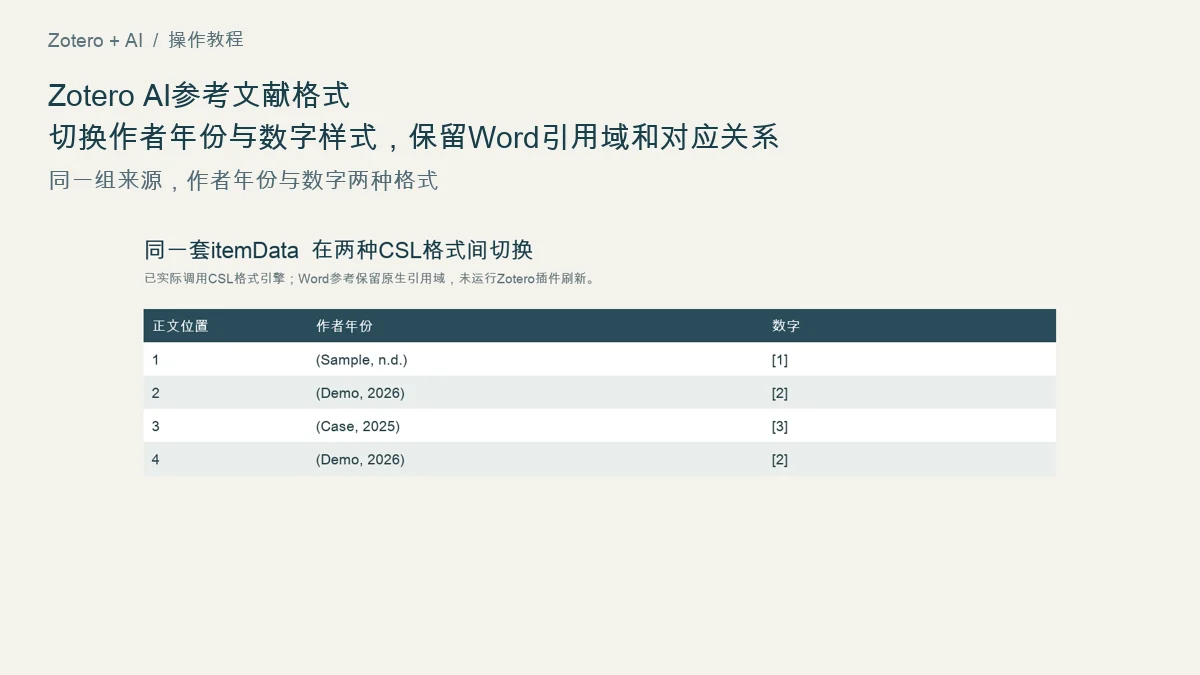
实际CSL引擎生成[1][2][3][2],删去唯一REF3引用后重排为[1][2][1];作者拼写更正同时反映于文内与文末。未执行Zotero插件刷新。
阅读文章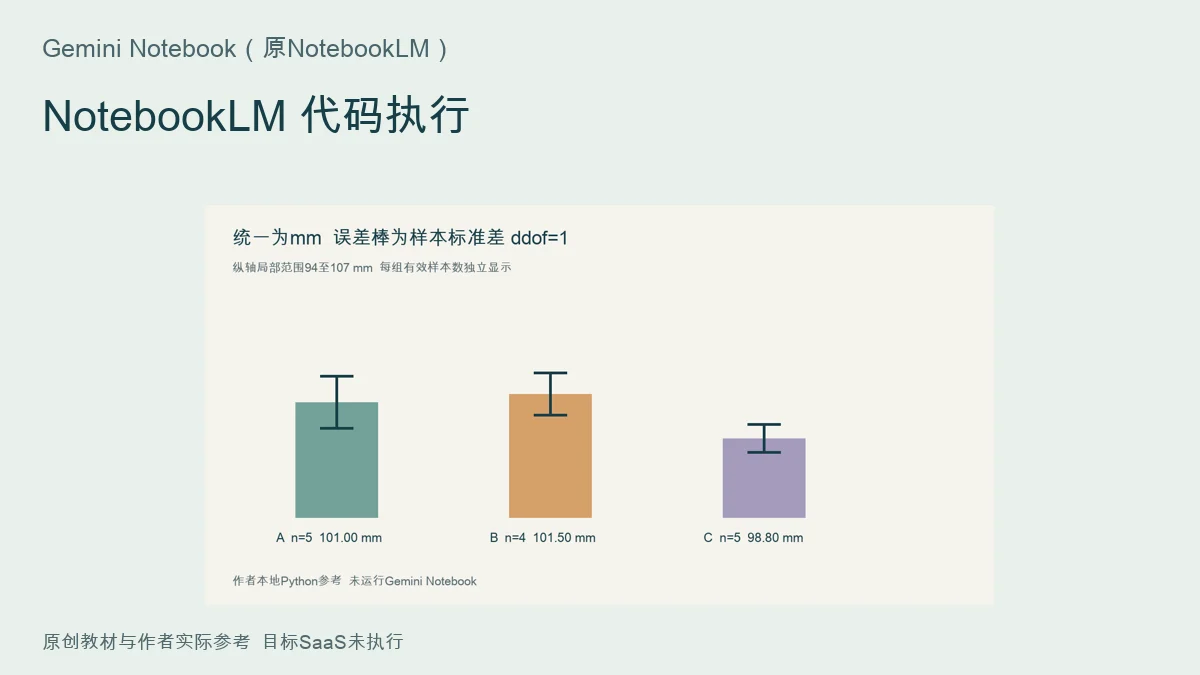
NotebookLM 代码执行:在Gemini Notebook现名与账户门槛下练原生代码执行,先统一cm/mm,再分别计算有效样本数与样本标准差。
阅读文章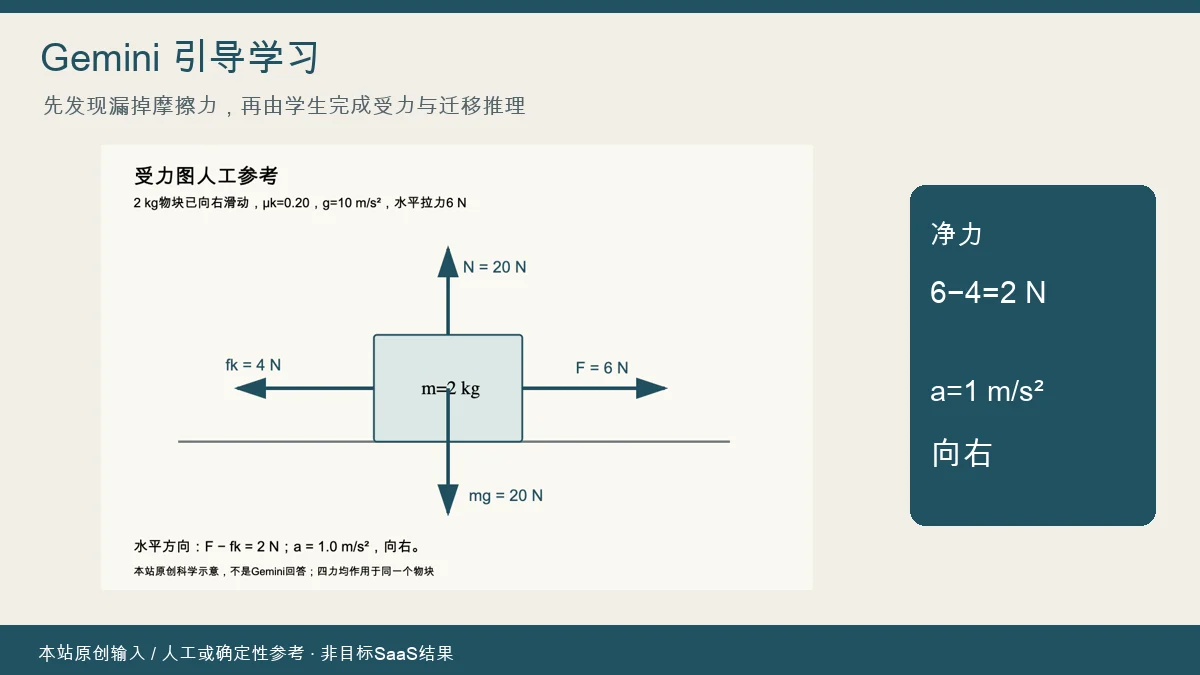
在 Gemini 引导学习上传受力图,先让学生列出四个力,再提示竖直平衡、摩擦力和水平净力。原题应得 N=20N、摩擦4N、净力2N、加速度1m/s²,最后把拉力改8N由学生独立解释。
阅读文章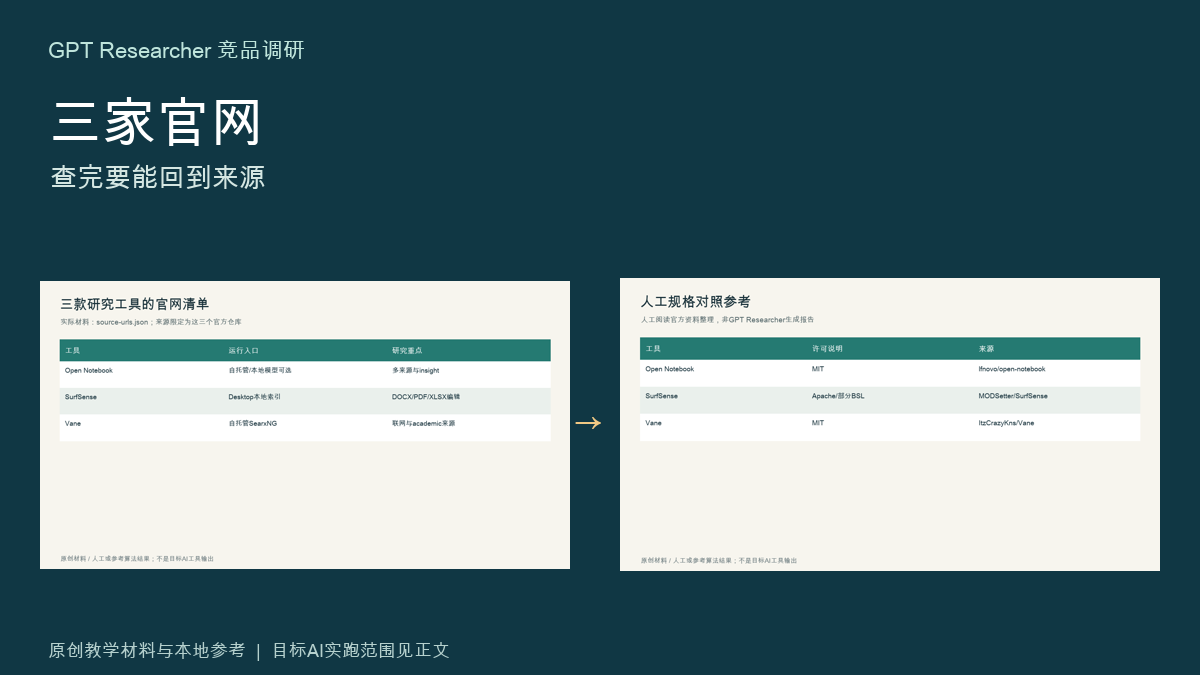
只依据source-urls.json三个官方来源,比较运行方式、资料类型、许可边界。每个结论保留直接URL与采集日期。官网没有说明的RAM或免费调用次数写未说明,不推荐购买,不补造数字。
阅读文章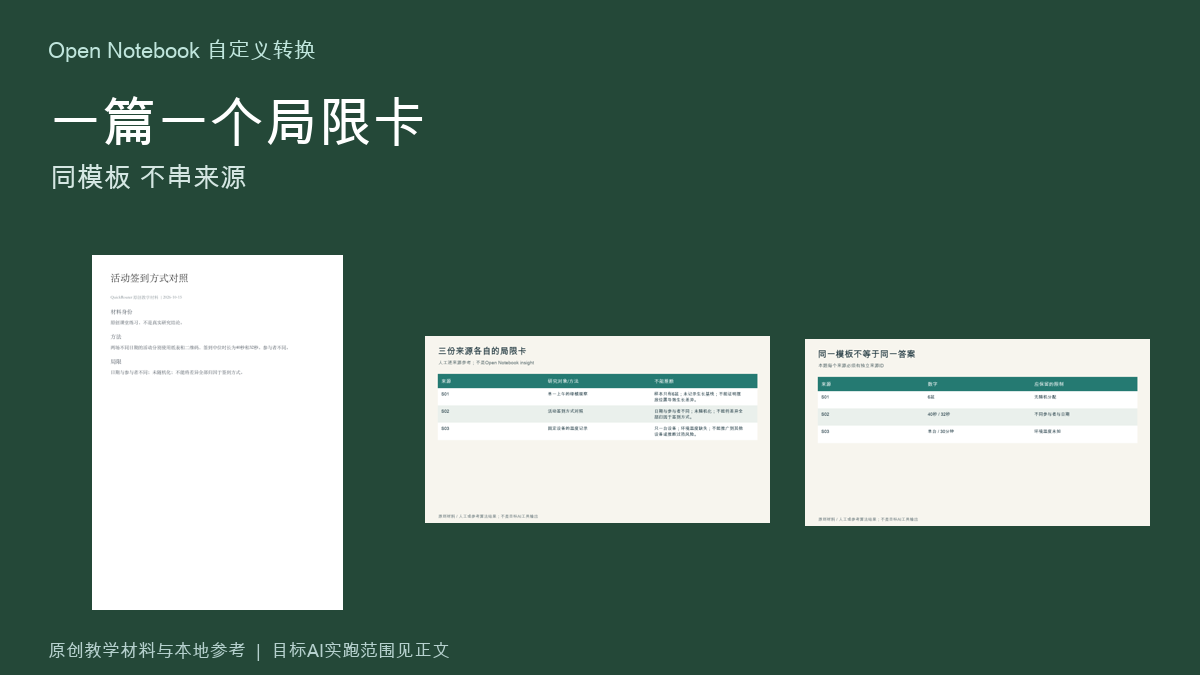
按当前单个来源输出研究对象、方法、能说明、不能说明和对应原句。来源没写则写来源未说明。保留S01/S02/S03,不能串用其他来源,不能从相关推断因果。
阅读文章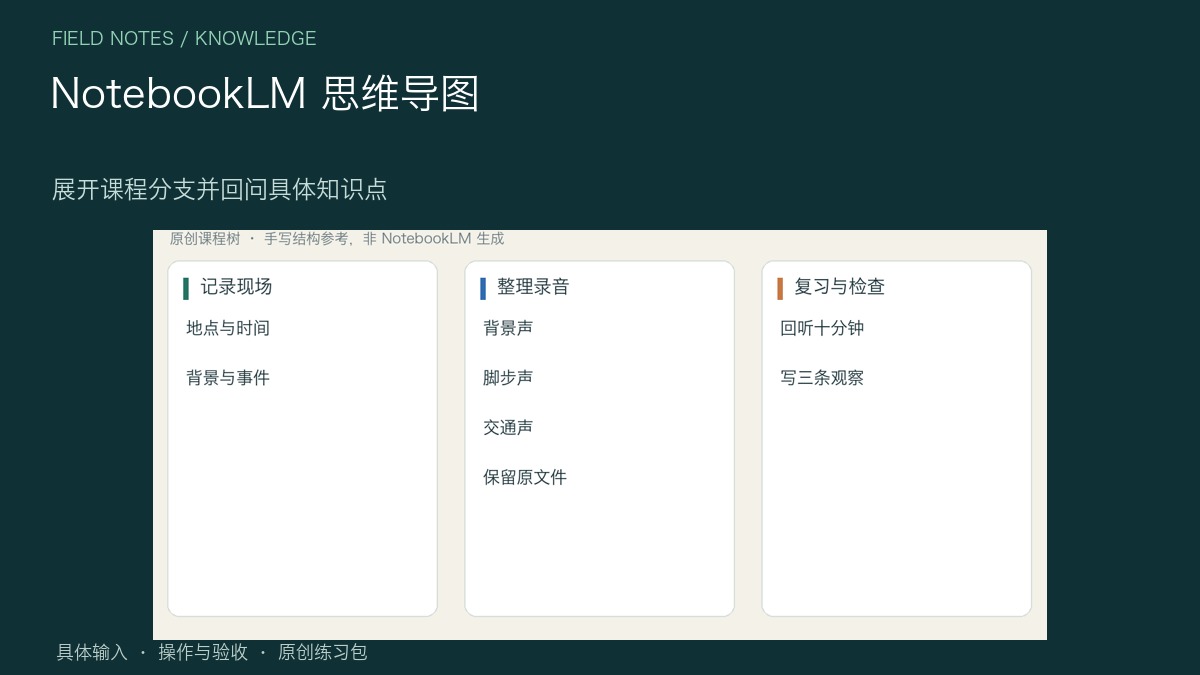
在 NotebookLM 网页版导入课程笔记,点击 Mind Map 生成导图,再展开整理录音分支,点击节点追问来源里的理由。最后下载实际导图,检查分支与中文文字;具体产品名称和入口以当前账号为准。
阅读文章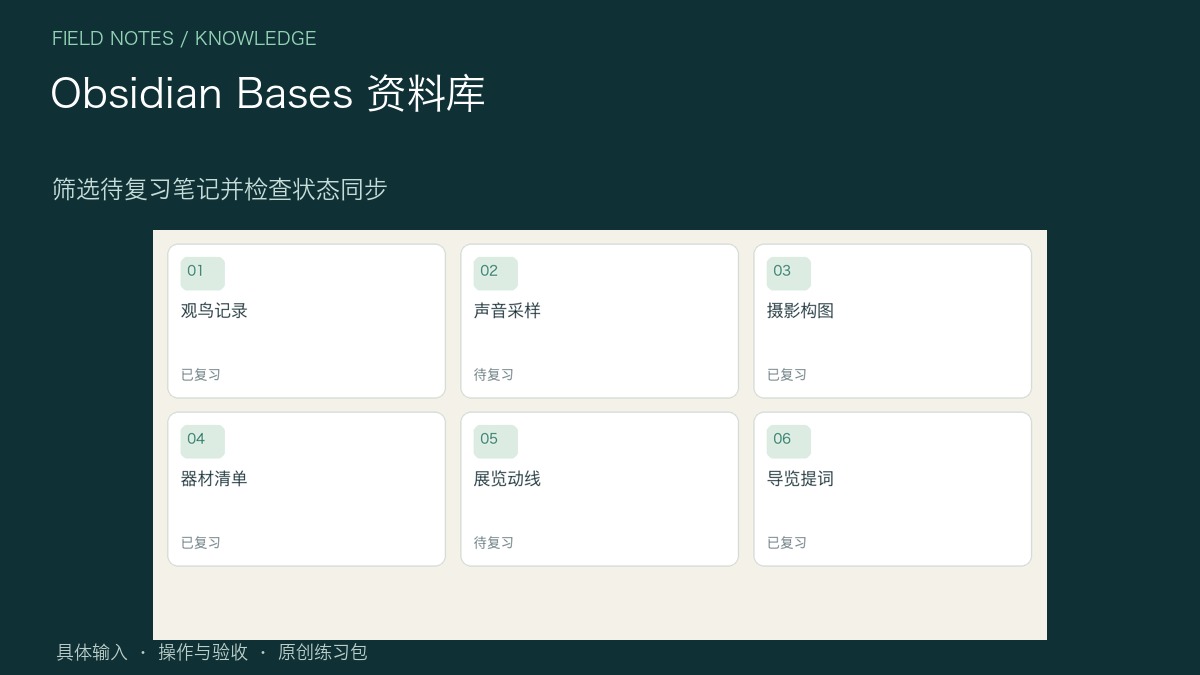
在独立 vault 启用 Bases,打开 research.base,按 Research 路径和待复习状态筛选笔记。把 02-声音采样的状态改为已复习后,视图应从两条变为一条,原笔记与来源仍可打开。
阅读文章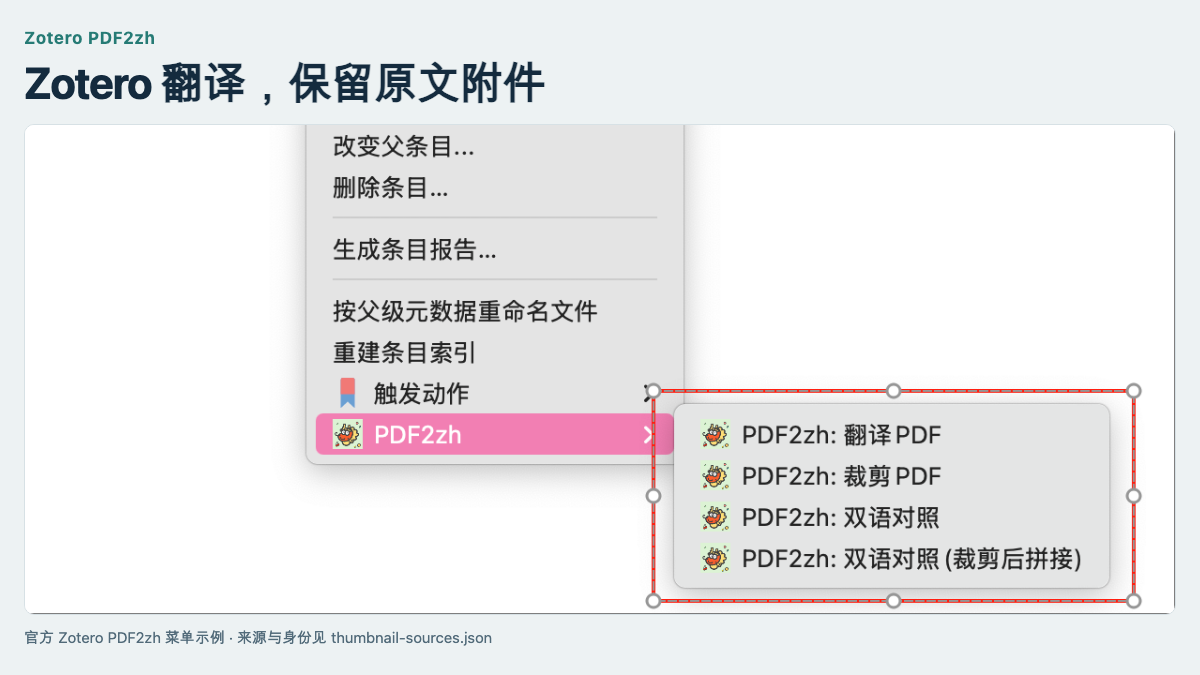
在独立 Zotero 测试库导入原创条目,配对安装插件与 Server,核对翻译进度、原文保留和译文附件挂载。
阅读文章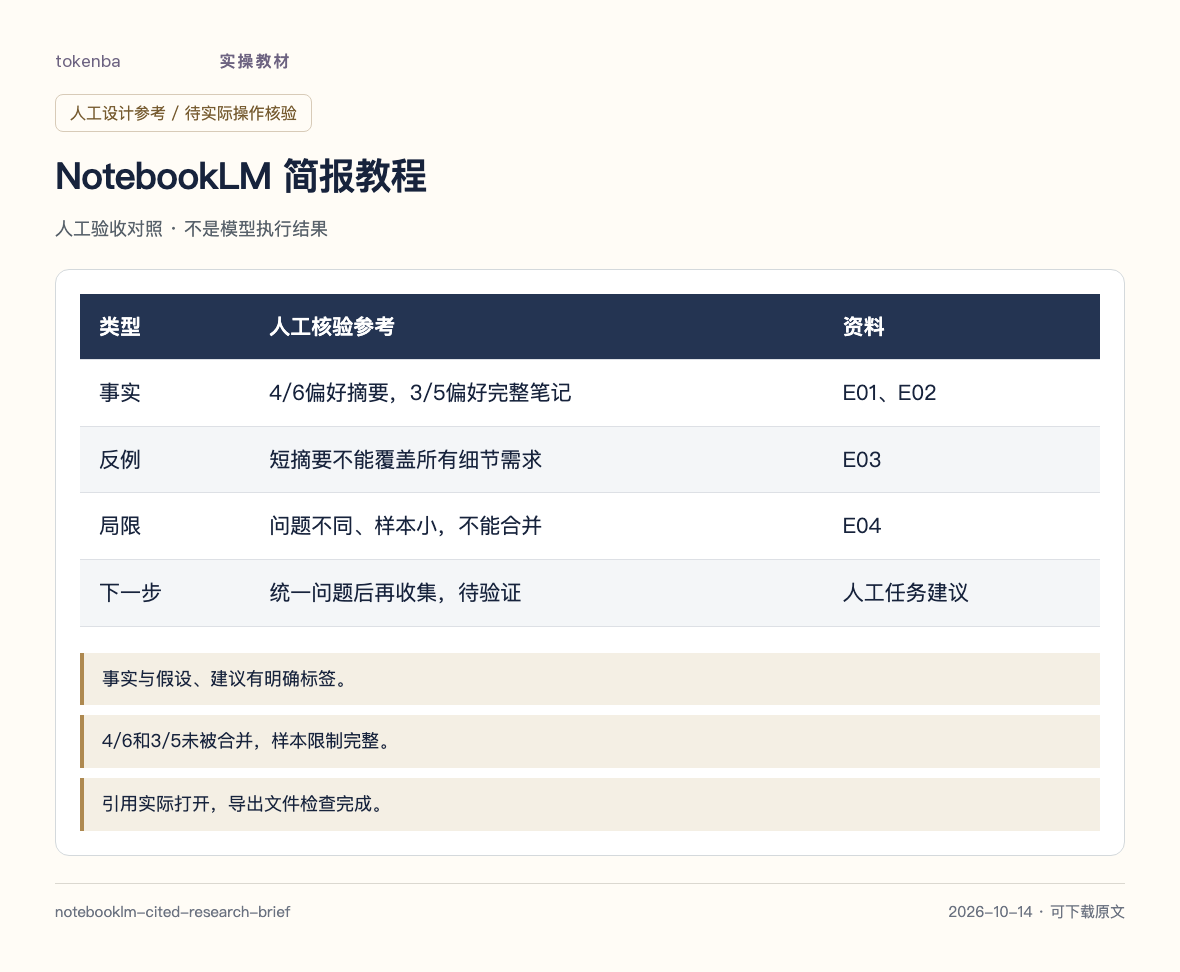
上传 reading-excerpts.md,在 Studio 报告选择简报文档或自定义一页格式。先用 Chat 确认各观察的样本和问题差异,再生成报告;保留引用和资料编号。 分别有4/6与3/5,且解释了题目不同;没有11人统一百分比。反例提到保留完整笔记的需求,下一步是待收集事实。
阅读文章注册后创建 apizt API Key,选择客户端和模型,再生成接入配置。从一次简单请求开始,按实际用量付费。
在控制台创建令牌,选择需要使用的模型权限。
按工具要求填写 API Key、接口地址与模型 ID。
确认收到有效结果,再到控制台查看用量与费用。