
展开本页目录
开始前准备什么
- 先解压练习包,保留原生输入文件;合成样本与作者参考不作为真实业务证据。
- 核对官方支持的账号、套餐、语言、客户端和管理员权限;本页不代替产品订阅。
- 短引仅15词且给公开档案出处。其余段落由作者编写;本包没有伪造查重百分比或“保证通过”结果。
- 打开原创稿和短引出处
- 保留引用与转述标记
- 运行Plagiarism Checker
- 逐处打开匹配来源
- 把三类匹配分开判断
- 补引用或改清楚转述
- 保存报告并注明覆盖局限
1. 打开原创稿和短引出处
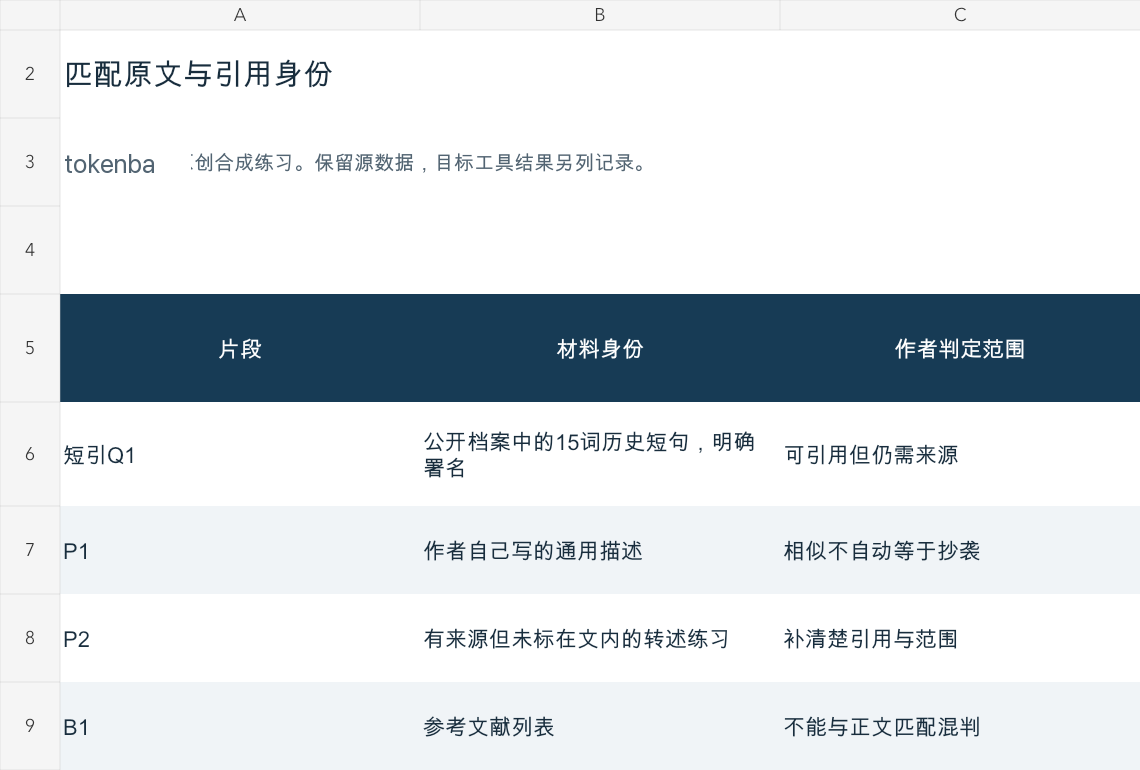
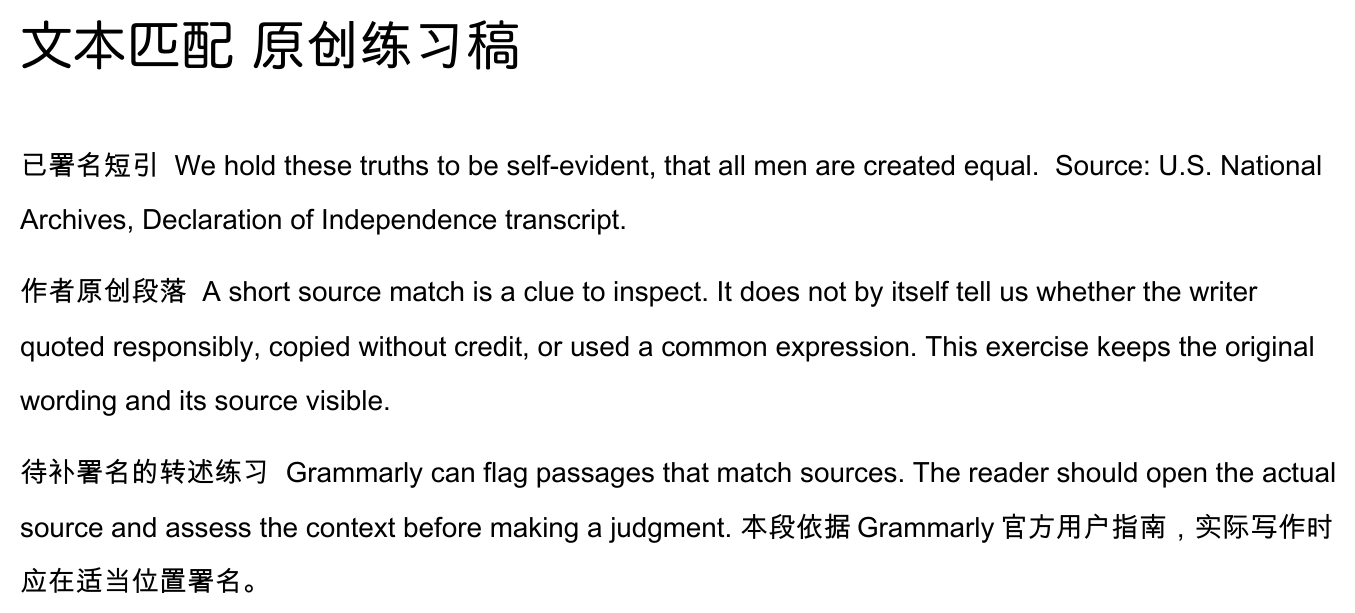
阅读plagiarism-practice.docx与source-register.docx,短引有明确来源且长度很短;不要把公开历史句冒称你的原创。
2. 保留引用与转述标记
把作者观点、已署名短引、待补署名的转述分清。需要的是可回读证据,不是一个目标相似率。
3. 运行Plagiarism Checker
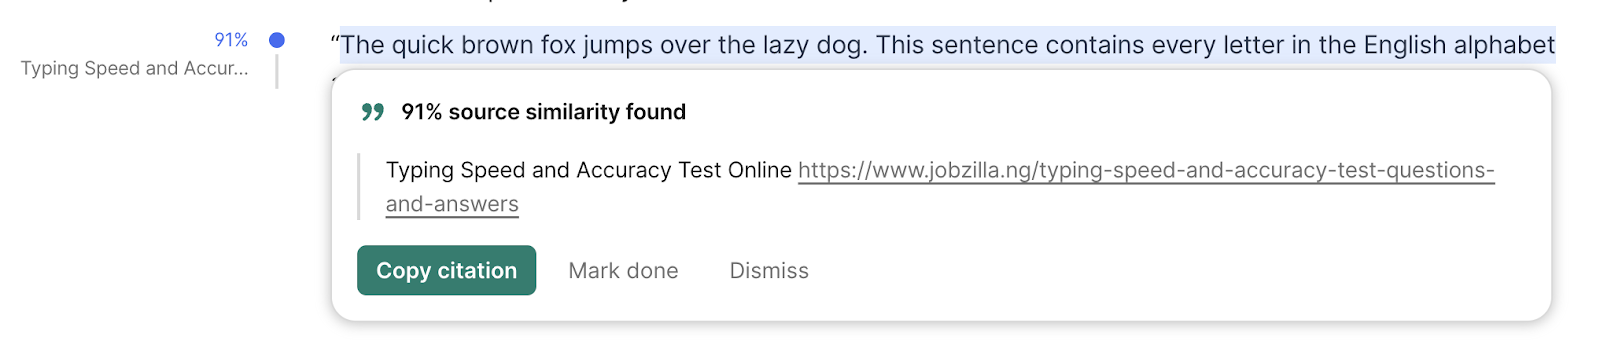
在符合资格的Grammarly编辑器运行Plagiarism Checker,记录实际返回。未匹配到已知来源也如实保留,不手填一个分数。
4. 逐处打开匹配来源
逐个点击匹配卡打开原页,比较到底是同一短句、常见表达还是较长转述。打不开的来源保留未核。
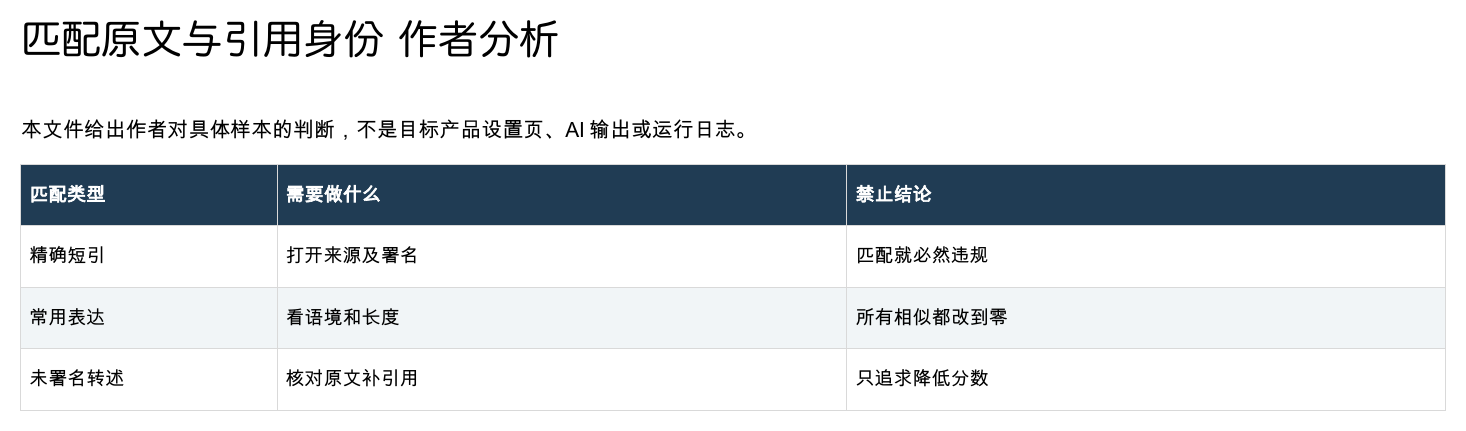
5. 把三类匹配分开判断
按表把匹配分为引用、常用表达、需补出处三类;含引号与署名的短引可能仍被检出,但不由分数直接定性。
6. 补引用或改清楚转述
对真正缺署名的段落补恰当引文或用自己的理解重新说明,并保留原稿。不要为逃避检测进行机械替换。
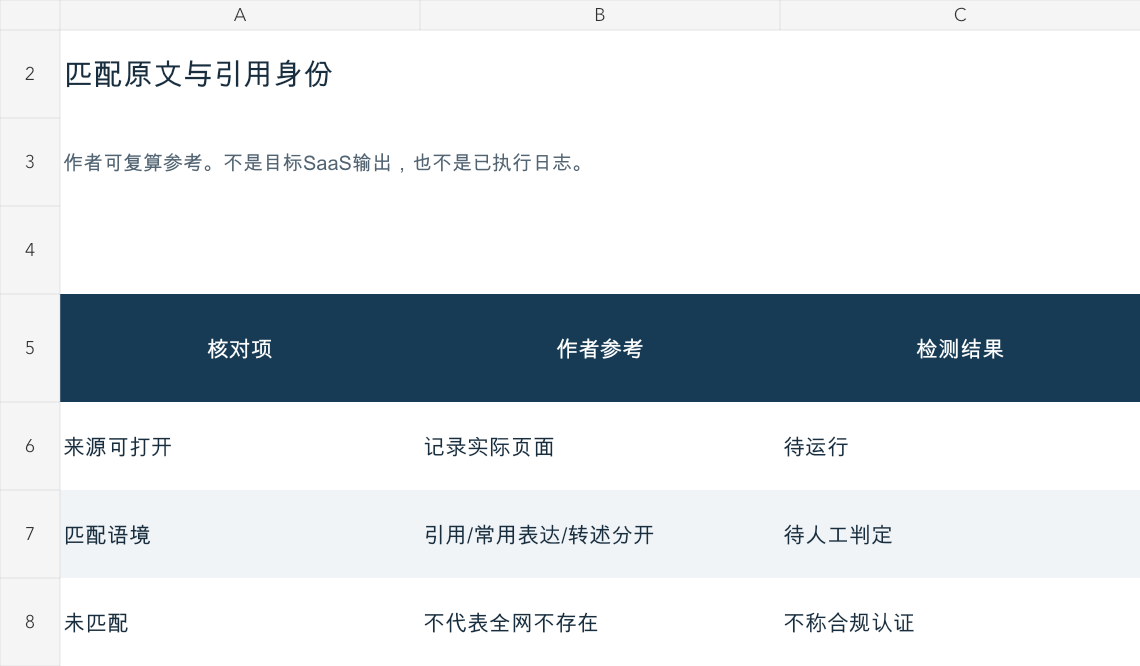
7. 保存报告并注明覆盖局限
导出实际报告与人工判断,写明查重库非穷尽、工具不是学术合规认证。作者参考不代表目标产品已经检查本稿。
prompt.txt
text
任务:Grammarly查重:逐处打开匹配来源,分清引用、常用表达与未署名转述

输入:input.docx和同包原生练习材料,保持原件不变。
1. 运行Plagiarism Checker
2. 逐处打开匹配来源和相似片段
3. 给确需引用的段落补署名并记录哪些是常用表达
具体样本:
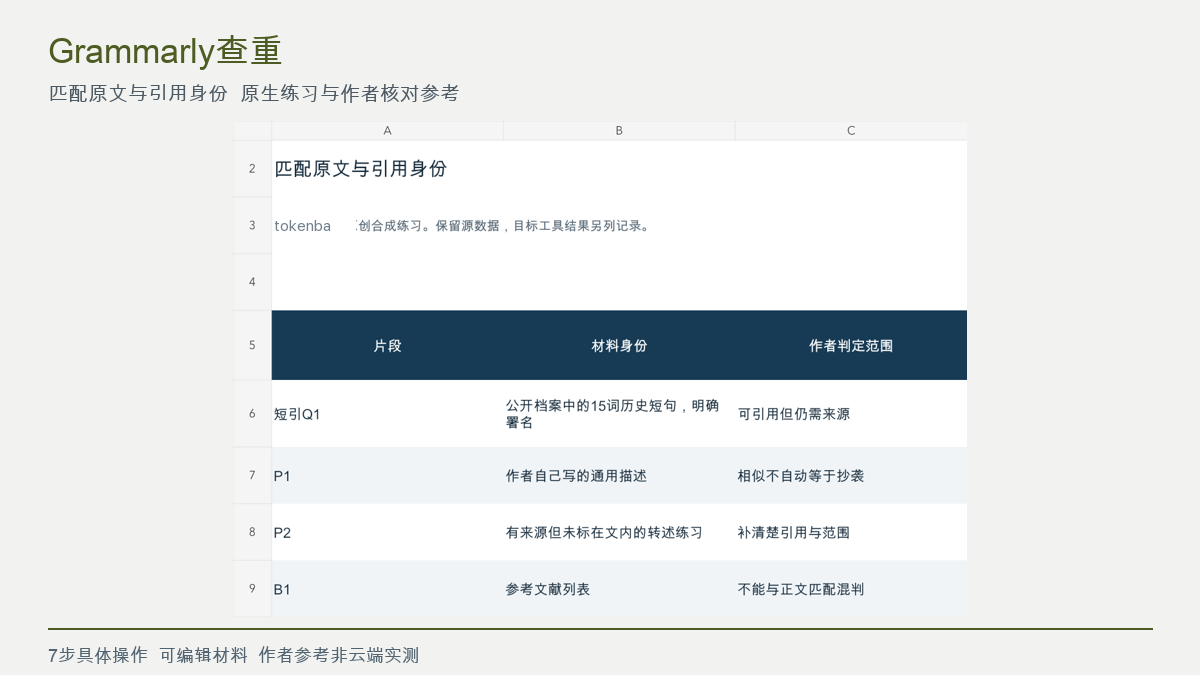
短引Q1;公开档案中的15词历史短句,明确署名;可引用但仍需来源
P1;作者自己写的通用描述;相似不自动等于抄袭
P2;有来源但未标在文内的转述练习;补清楚引用与范围
B1;参考文献列表;不能与正文匹配混判

输出:匹配来源卡、人工判定表与修改后引用
验收:不把所有匹配都判为抄袭;已署名短引与无署名转述分开,所有测试内容版权可说明
身份与边界:短引仅15词且给公开档案出处。其余段落由作者编写;本包没有伪造查重百分比或“保证通过”结果。
不得伪造产品入口、账号权限、来源、DOI、运行轨迹或已通过记录。
练习文件与执行范围
短引仅15词且给公开档案出处。其余段落由作者编写;本包没有伪造查重百分比或“保证通过”结果。
下载包保留作者输入、分析与结果参考,以及等待你填写的实际运行记录。此页未登录执行目标云端功能。
怎样确认已经完成
- 不把所有匹配都判为抄袭
- 已署名短引与无署名转述分开,所有测试内容版权可说明
- 查重是定位文本与来源的匹配线索;每处仍要按引用身份和上下文判断,不能把“有匹配”直接等同违规。
- 短引仅15词且给公开档案出处。其余段落由作者编写;本包没有伪造查重百分比或“保证通过”结果。
常见问题
Grammarly查重显示相似就一定是抄袭吗?
在符合资格的Grammarly编辑器运行Plagiarism Checker,记录实际返回。未匹配到已知来源也如实保留,不手填一个分数。 查重是定位文本与来源的匹配线索;每处仍要按引用身份和上下文判断,不能把“有匹配”直接等同违规。
怎么打开匹配原文区分引用和常用表达?
对真正缺署名的段落补恰当引文或用自己的理解重新说明,并保留原稿。不要为逃避检测进行机械替换。 短引仅15词且给公开档案出处。其余段落由作者编写;本包没有伪造查重百分比或“保证通过”结果。
下载包中的结果是目标产品已经生成的吗?
结果参考由作者制作并以原生文件打开、渲染和检查,供你实际操作后对照。没有将本地材料验证说成目标SaaS已运行。