
展开本页目录
开始前准备什么
- 先解压练习包,保留原生输入文件;合成样本与作者参考不作为真实业务证据。
- 核对官方支持的账号、套餐、语言、客户端和管理员权限;本页不代替产品订阅。
- draft.docx和revision-reference.docx由作者编写,未运行Grammarly或招募真人读者;反应与分数不预填。
- 打开三段含缺口的草稿
- 选择真实Reader Reactions入口
- 运行并保留原始反应
- 定位一个可核困惑点
- 仅补一段明确说明
- 重新检查同受众反应
- 保存预测身份与修订差异
1. 打开三段含缺口的草稿
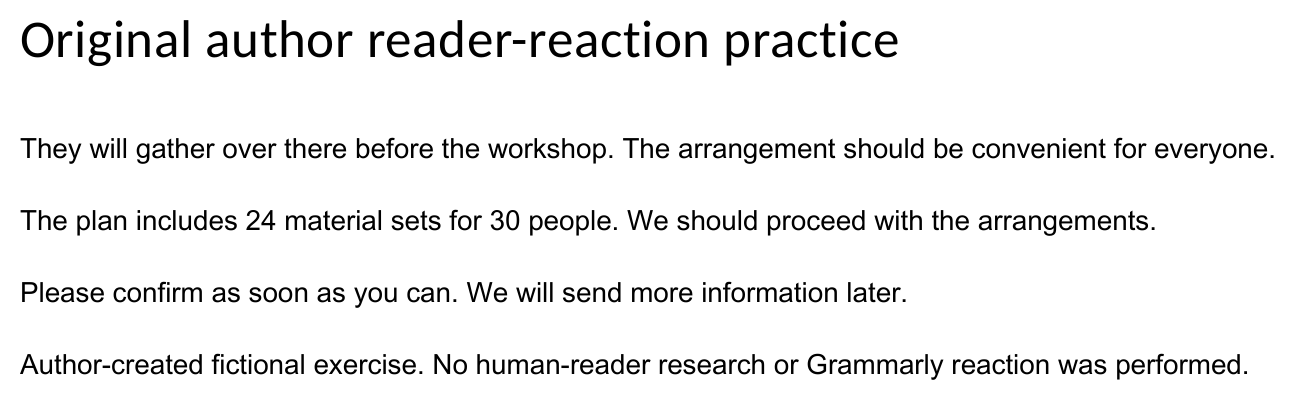
阅读draft.docx,P1指代不明、P2未解释24对30、P3确认对象不明;这些是作者设计问题,不是产品已判反馈。
2. 选择真实Reader Reactions入口
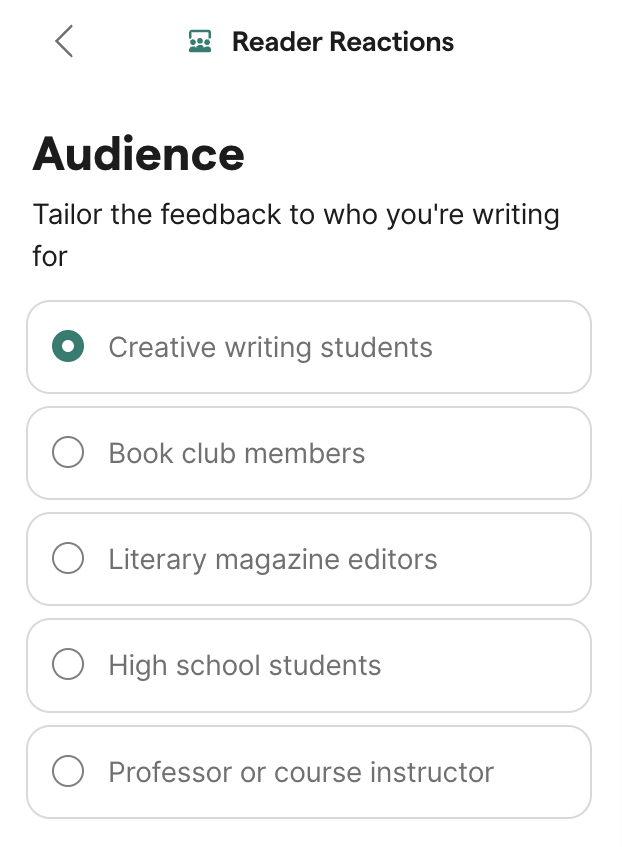
在支持的Grammarly Docs代理查看受众设置,只有实际提供字段才填写,不能自造虚构用户画像控件。
3. 运行并保留原始反应
保存实际预测反应和对应段落,不强行要求它命中作者三项问题;没有反应也如实记录。记录反应针对P1、P2还是P3,不能只留总评价。
4. 定位一个可核困惑点
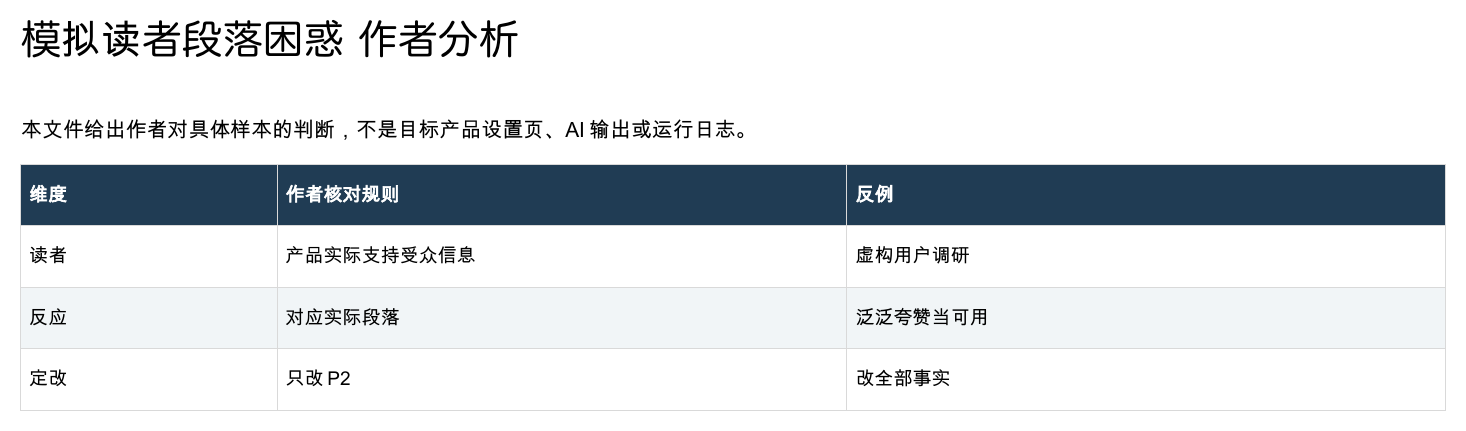
优先选择P2的24/30关系,回读上下文确认困惑有文本依据,不按预测就更改事实。
5. 仅补一段明确说明
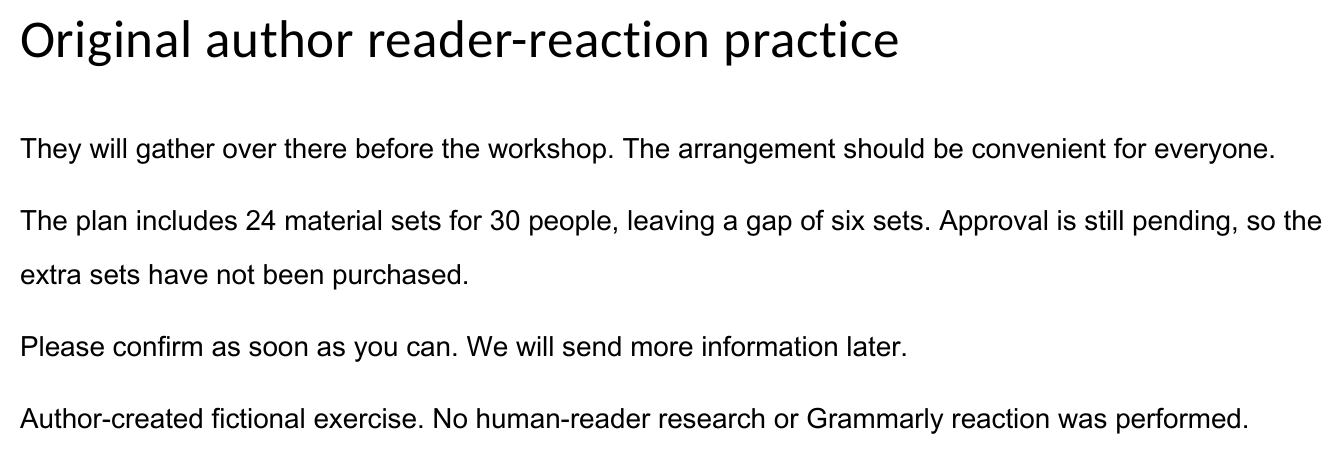
在副本把P2写明还缺6套且采购尚未审批,保持人数、时间和其他两段不变,便于归因。
6. 重新检查同受众反应
按同样设置重跑,记录预测是否改变;没有变化可保留,不捏造兴趣百分比。对照中保留P1和P3未改,便于解释变化。
7. 保存预测身份与修订差异
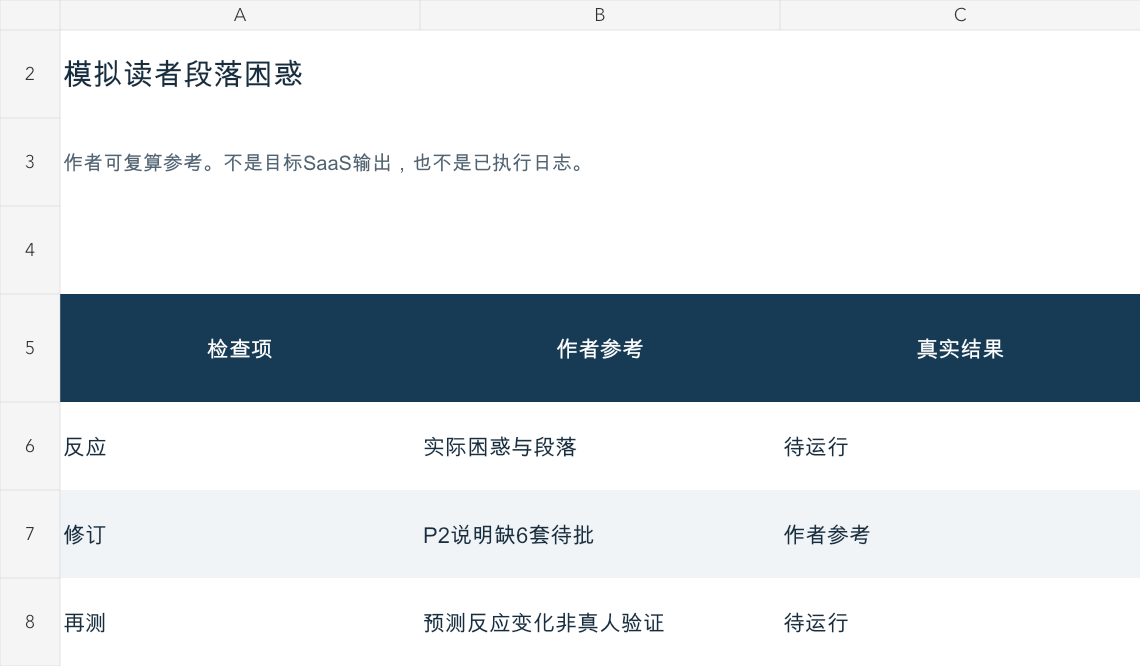
将作者改动、实际反应和待真人验证分列,明确模拟读者不能代替用户访谈或真实可用性测试。
prompt.txt
任务:Grammarly Reader Reactions:查看模拟读者在哪一段困惑,再定点修改

输入:input.docx和同包原生练习材料,保持原件不变。
1. 运行Reader Reactions并选择实际支持的受众信息
2. 定位反应对应段落,区分困惑/兴趣/潜在问题
3. 仅改一处后重看反应差别
具体样本:
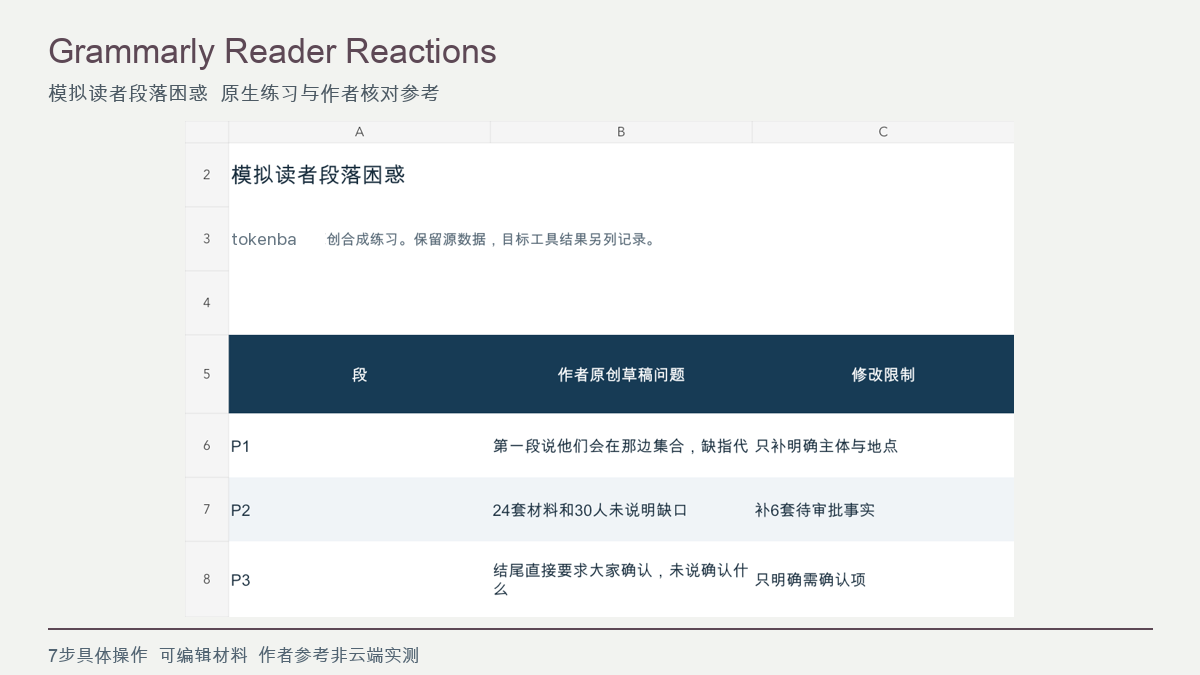
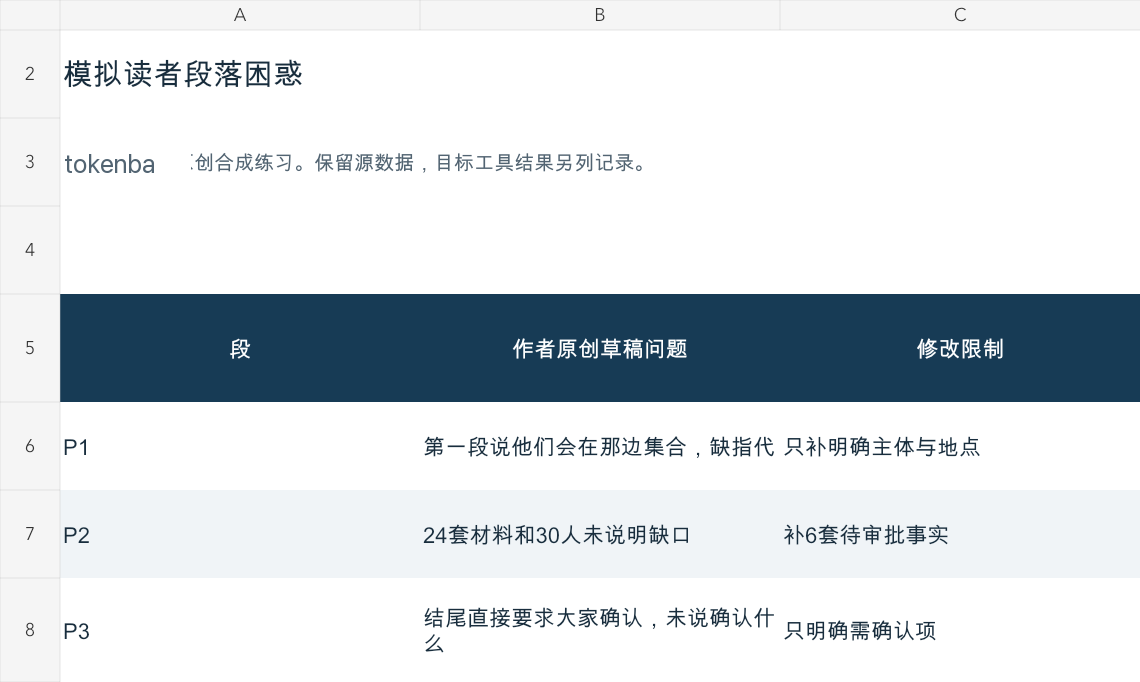
P1;第一段说他们会在那边集合,缺指代;只补明确主体与地点
P2;24套材料和30人未说明缺口;补6套待审批事实
P3;结尾直接要求大家确认,未说确认什么;只明确需确认项

输出:模拟读者反馈、段落定位和定点修订对照
验收:反馈来自实际文本;预测反应不能冒充真人调研,改动保持事实不变
身份与边界:draft.docx和revision-reference.docx由作者编写,未运行Grammarly或招募真人读者;反应与分数不预填。
不得伪造产品入口、账号权限、来源、DOI、运行轨迹或已通过记录。
练习文件与执行范围
draft.docx和revision-reference.docx由作者编写,未运行Grammarly或招募真人读者;反应与分数不预填。
下载包保留作者输入、分析与结果参考,以及等待你填写的实际运行记录。此页未登录执行目标云端功能。
怎样确认已经完成
- 反馈来自实际文本
- 预测反应不能冒充真人调研,改动保持事实不变
- Reader Reactions是模拟读者预测,先定位困惑段落,只改一个事实表达缺口,再比较实际反应,不冒充真人调研。
- draft.docx和revision-reference.docx由作者编写,未运行Grammarly或招募真人读者;反应与分数不预填。
常见问题
Grammarly能预测读者看到哪段会困惑吗?
保存实际预测反应和对应段落,不强行要求它命中作者三项问题;没有反应也如实记录。记录反应针对P1、P2还是P3,不能只留总评价。 Reader Reactions是模拟读者预测,先定位困惑段落,只改一个事实表达缺口,再比较实际反应,不冒充真人调研。
Reader Reactions是实际读者反馈还是AI模拟?
按同样设置重跑,记录预测是否改变;没有变化可保留,不捏造兴趣百分比。对照中保留P1和P3未改,便于解释变化。 draft.docx和revision-reference.docx由作者编写,未运行Grammarly或招募真人读者;反应与分数不预填。
下载包中的结果是目标产品已经生成的吗?
结果参考由作者制作并以原生文件打开、渲染和检查,供你实际操作后对照。没有将本地材料验证说成目标SaaS已运行。