
展开本页目录
开始前准备什么
- Qwen3-TTS-12Hz-1.7B-VoiceDesign;复用时另用对应Base。模型Apache-2.0,官方示例Python3.12/CUDA/bfloat16;显存与FlashAttention2按环境确认。
- 解压本页独立练习包,先读README中的素材身份与执行范围;保留原文件并另存实际结果。
- 先固定成年角色与试听台词
- 加载VoiceDesign而不是Base
- 一次只改一个声音特征
- 生成两条真实试听样音
- 选中声线后建立复用提示
- 用三句新台词核对一致性
- 归档描述和真正声音文件
原创输入、提示/参数、7步README、来源与检查表;无模型权重或账号。
分清真实输入、程序参考与待运行的模型输出。
用实际输出填写每一项,不把本地文件检查当效果验收。
教学记录格式,软件原生导入能力另行确认。
1. 先固定成年角色与试听台词
voice-card.json定义一名原创成年车站播报员,不指向真人;audition.txt是一句中性播报。input-system-reference.wav为系统朗读,用来核对台词,不能拿它评价Qwen声线设计质量。
2. 加载VoiceDesign而不是Base
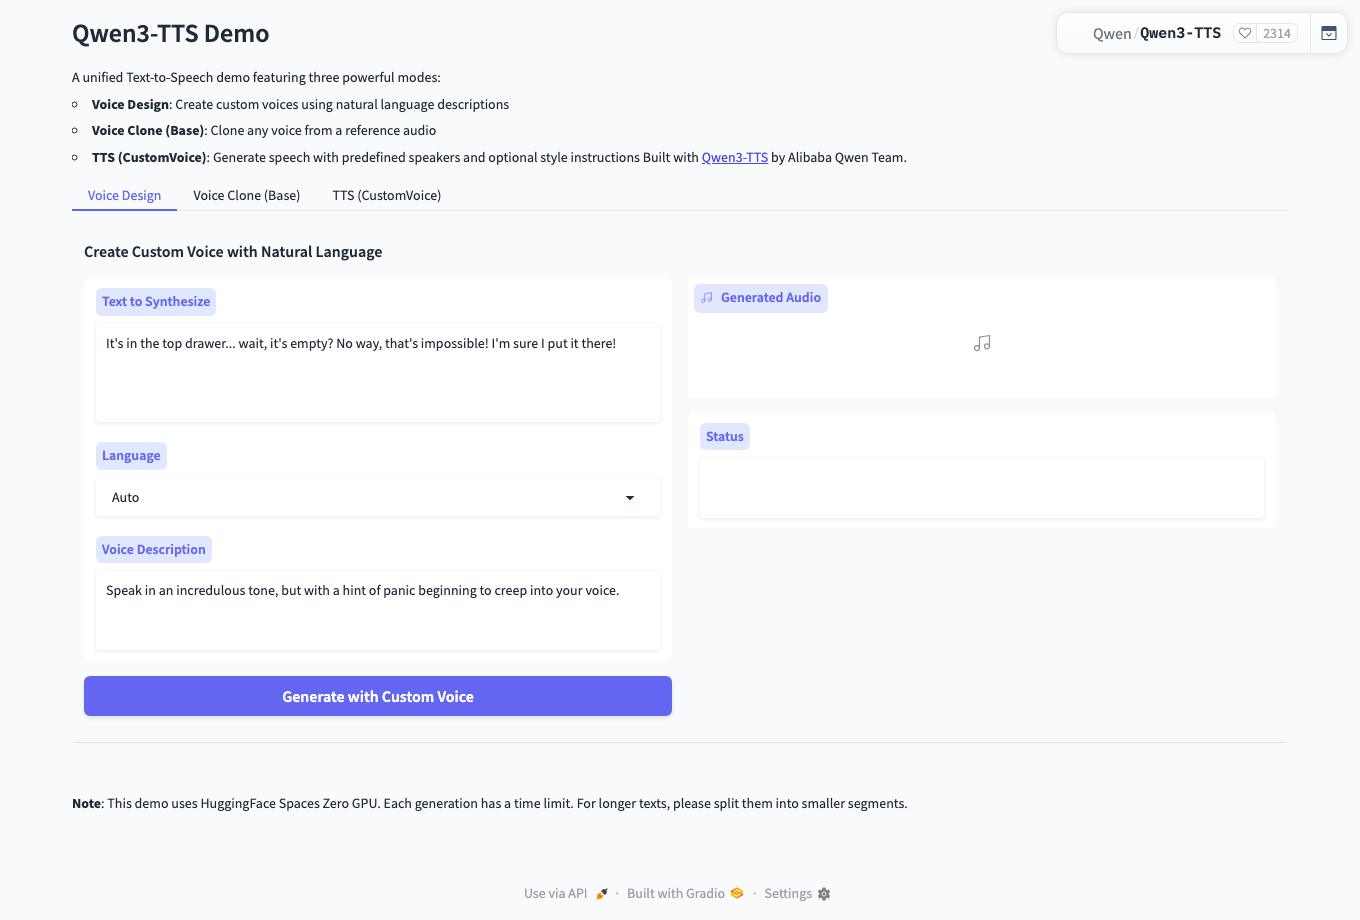
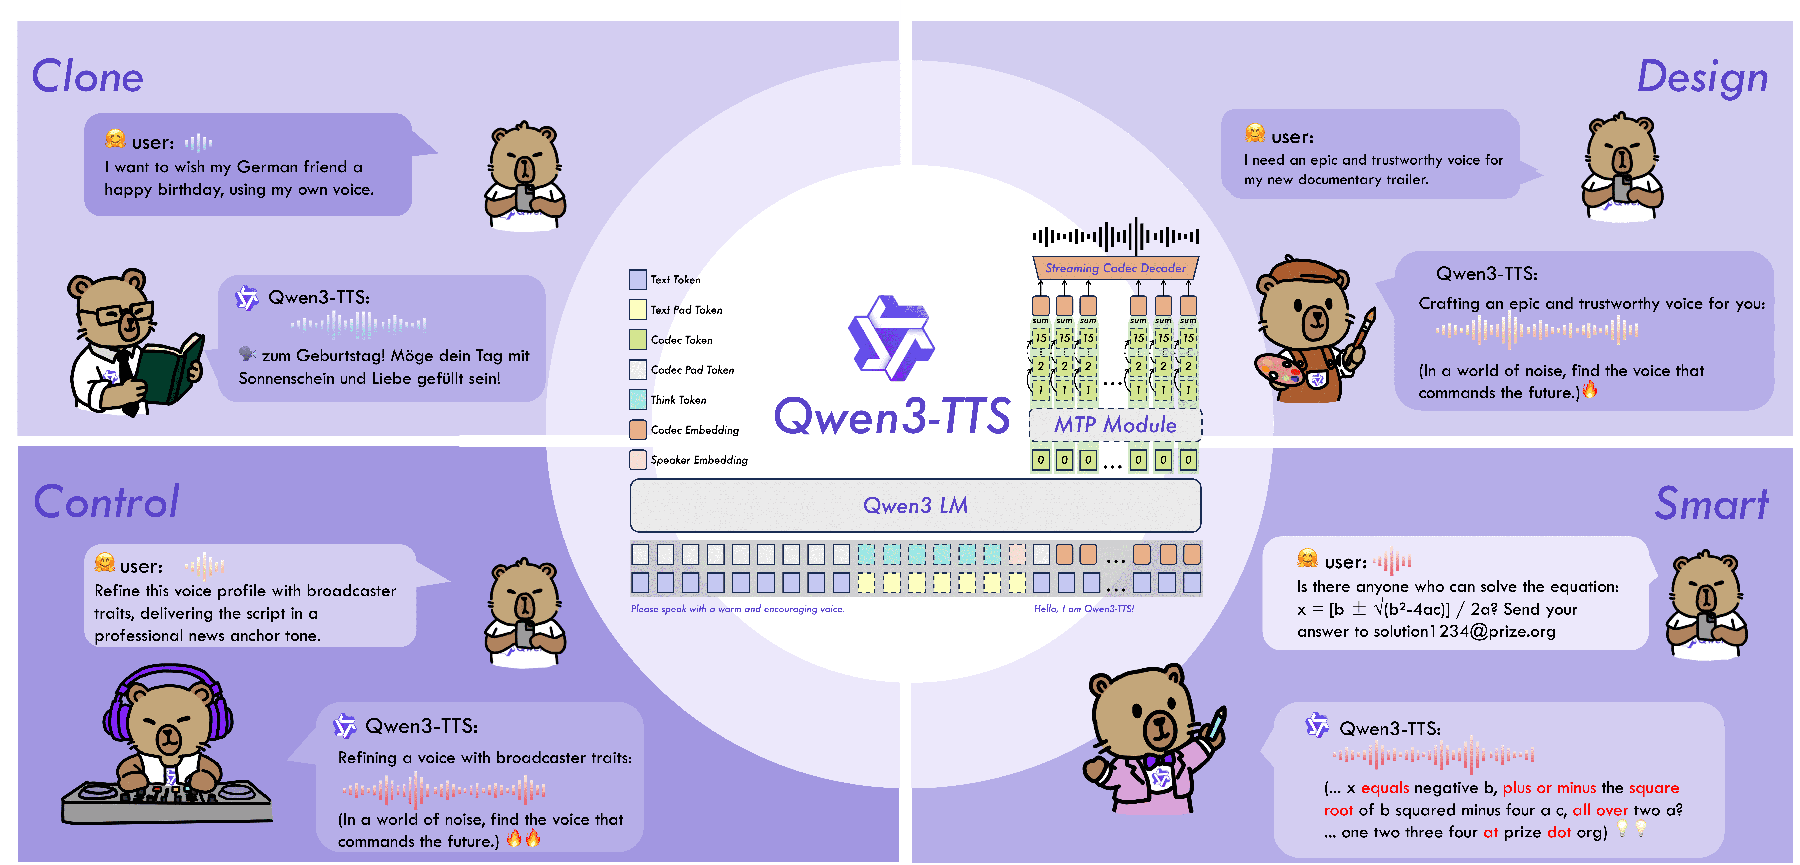
按官方qwen-tts示例加载Qwen3-TTS-12Hz-1.7B-VoiceDesign。Base处理参考音克隆,CustomVoice用已有声音,三种职责不同;本题第一步不提供真人参考音。
3. 一次只改一个声音特征
把两份成年音色描述分别放入instruct,保持text、language和输出条件一致;比较沉稳/轻快或低/中音,不同时换台词和年龄。描述不保证每项都准确,需要试听选择。
4. 生成两条真实试听样音
在已安装qwen-tts的环境运行run-qwen.py --mode design,用--voice a或b选择两份描述;脚本调用generate_voice_design并另存真实WAV。系统参考不能复制成audition-a/b冒充输出,试听表等待实际填写。
prompt.txt
成年男播报员,温和沉稳的中低音,语速清楚自然,不夸张,不模仿任何真实人物。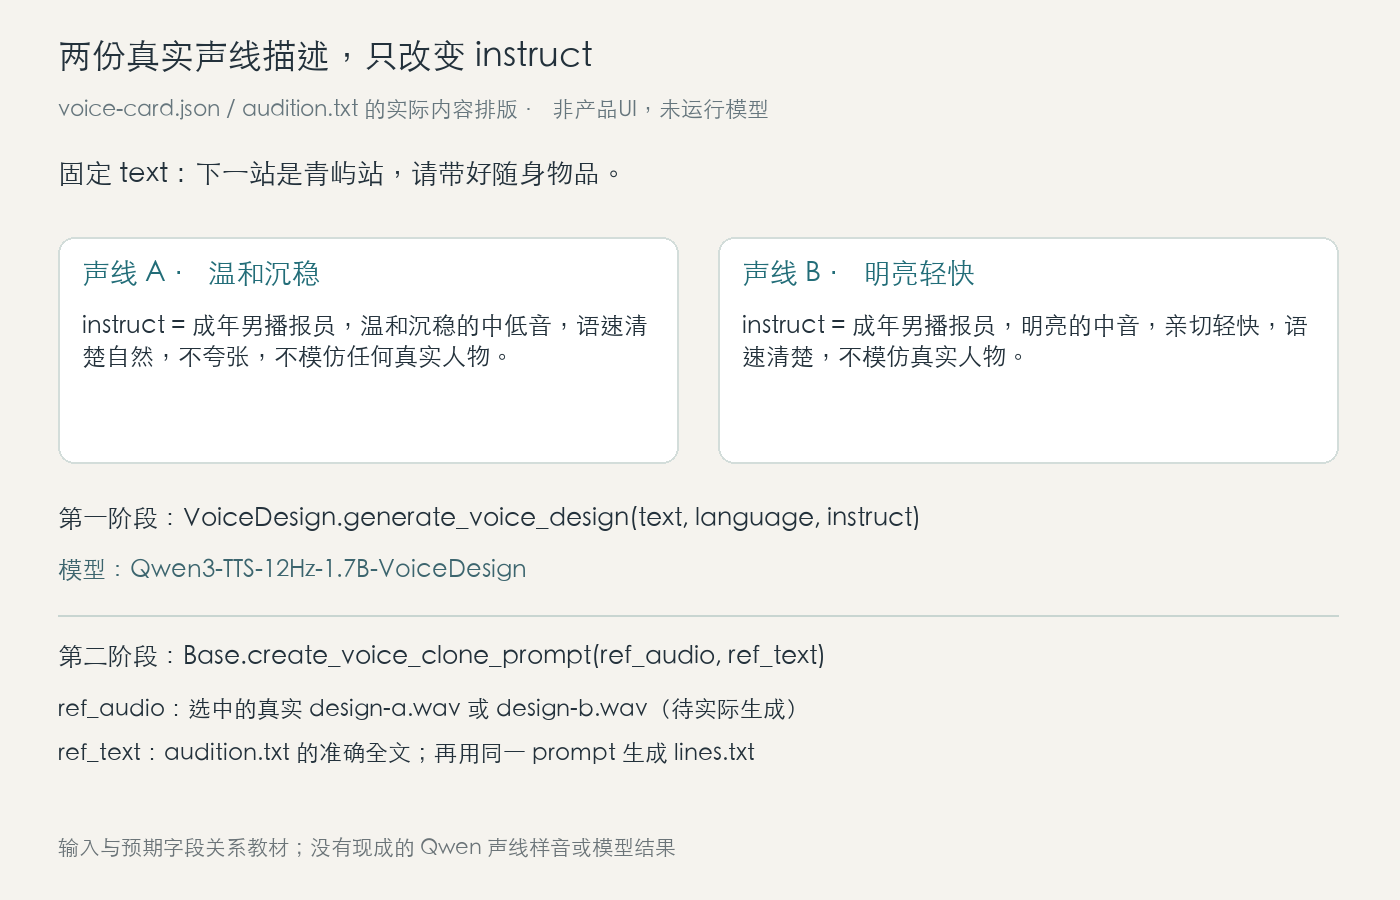
5. 选中声线后建立复用提示
运行run-qwen.py --mode reuse --reference 实际设计样音,脚本用audition.txt作准确ref_text交给Base的create_voice_clone_prompt,再调用generate_voice_clone生成lines.txt三句。参考应来自自己的真实设计结果,不能换成网络真人录音。
6. 用三句新台词核对一致性
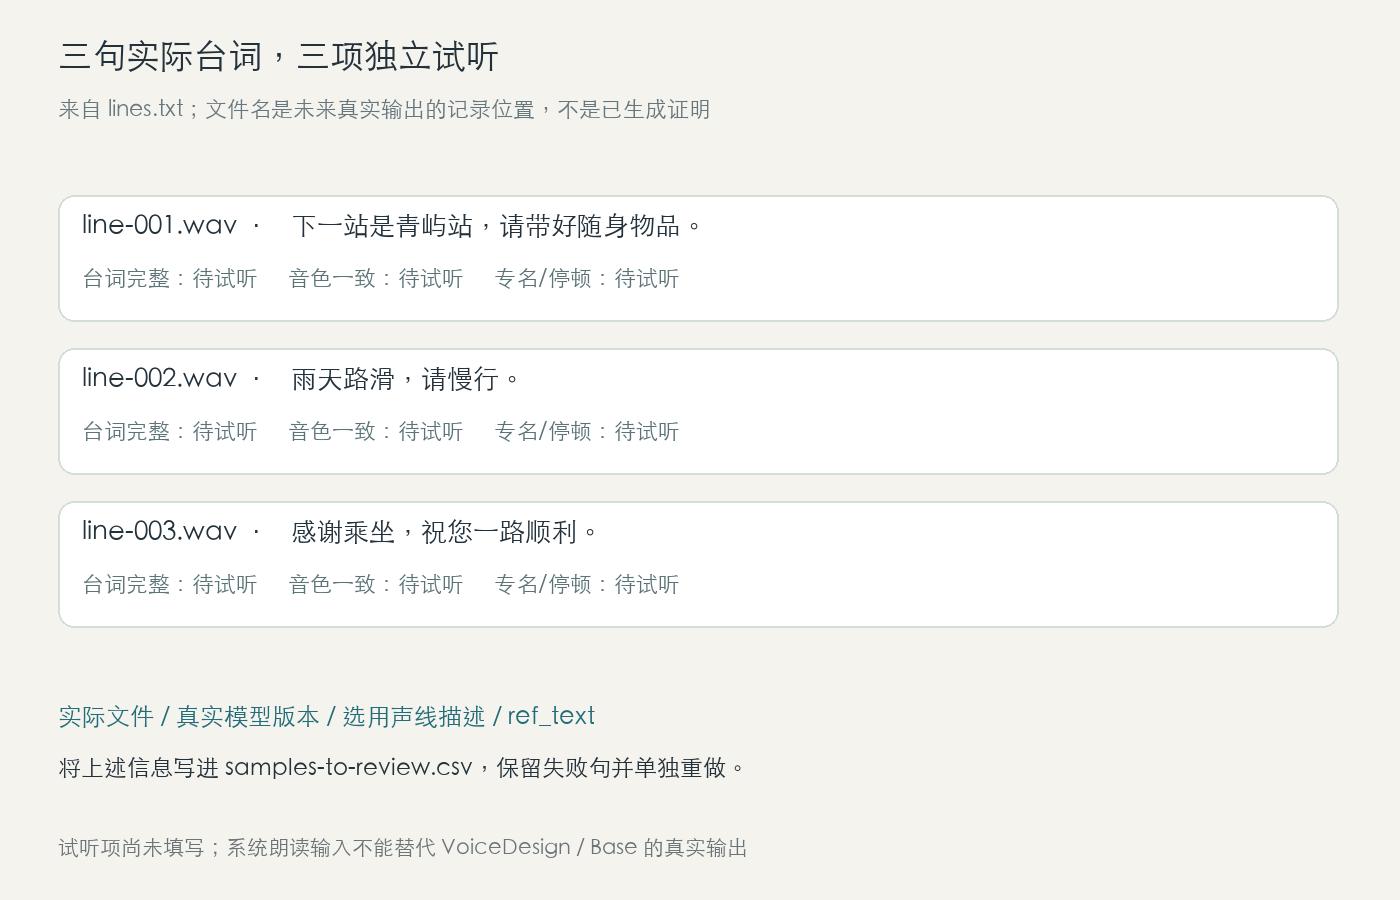
依次生成lines.txt里的三句,回听音色、气口和专名读法是否漂移。音色相近和每句内容完整分开记录,不把保存了prompt当作一致性已自动通过。
7. 归档描述和真正声音文件
保留原描述、选中样音、ref_text和三条真实输出。开源本地模型与阿里云音频API是不同入口,本教程不假设apizt聊天Key能直接合成。
怎样确认已经完成
- 首轮两份描述使用同一台词,角色明确为原创成年虚构角色。
- 复用参考来自真实VoiceDesign输出,ref_text逐字对应。
- 三句新台词完整且音色可接受,没有用系统参考冒充。
常见问题
不用克隆真人也能设计角色声音,这篇从哪里开始?
先用第1步的具体输入,再按照Qwen3-TTS原生入口操作。在已安装qwen-tts的环境运行run-qwen.py --mode design,用--voice a或b选择两份描述;脚本调用generate_voice_design并另存真实WAV。系统参考不能复制成audition-a/b冒充输出,试听表等待实际填写。
给原创角色固定一把声音,怎么确认结果真的完成?
首轮两份描述使用同一台词,角色明确为原创成年虚构角色。 复用参考来自真实VoiceDesign输出,ref_text逐字对应。 结构回读不代替播放、试听或逐处检查。
Qwen3-TTS 声线设计是否需要apizt API?
本题主要使用工具原生本地或官方网页能力,不要求apizt Key。Qwen3-TTS-12Hz-1.7B-VoiceDesign;复用时另用对应Base。模型Apache-2.0,官方示例Python3.12/CUDA/bfloat16;显存与FlashAttention2按环境确认。
Qwen3-TTS的英文资料应该搜什么?
可用“Qwen3 TTS VoiceDesign describe voice reusable clone prompt”查找对应能力;先确认官方来源中的模型/工作流,再核对本文输入和实际输出,不套用同名第三方服务参数。