
展开本页目录
开始前准备什么
- 下载本页素材,使用有权处理的声音,保留原始输入。
- 为对应工具建立独立 Python 环境,核对实际模型与版本。
- 先在小样中试听并保留失败记录,再处理长录音。
- 准备带停顿的短句录音
- 开启 word_timestamps
- 比较句级与词级边界
- 保留缺失与短时长的词
- 先修文字,再修高亮时间
- 移交到字幕渲染步骤
2026-10-23 核验材料;实际执行范围、结果与限制见下方记录。
补充:原有练习资料与下载
本任务输入、脚本、原始输出或明确待运行模板、原文、校验与损坏负例;不含模型权重。
macOS say 合成的本站原创任务输入;不是模型生成成功证明。
朗读输入与回听依据,独立于机器实际稿。
包含具体命令、步骤、来源与未运行范围。
保留原始文件;准确性需回听,脚本存在不代表模型已运行。
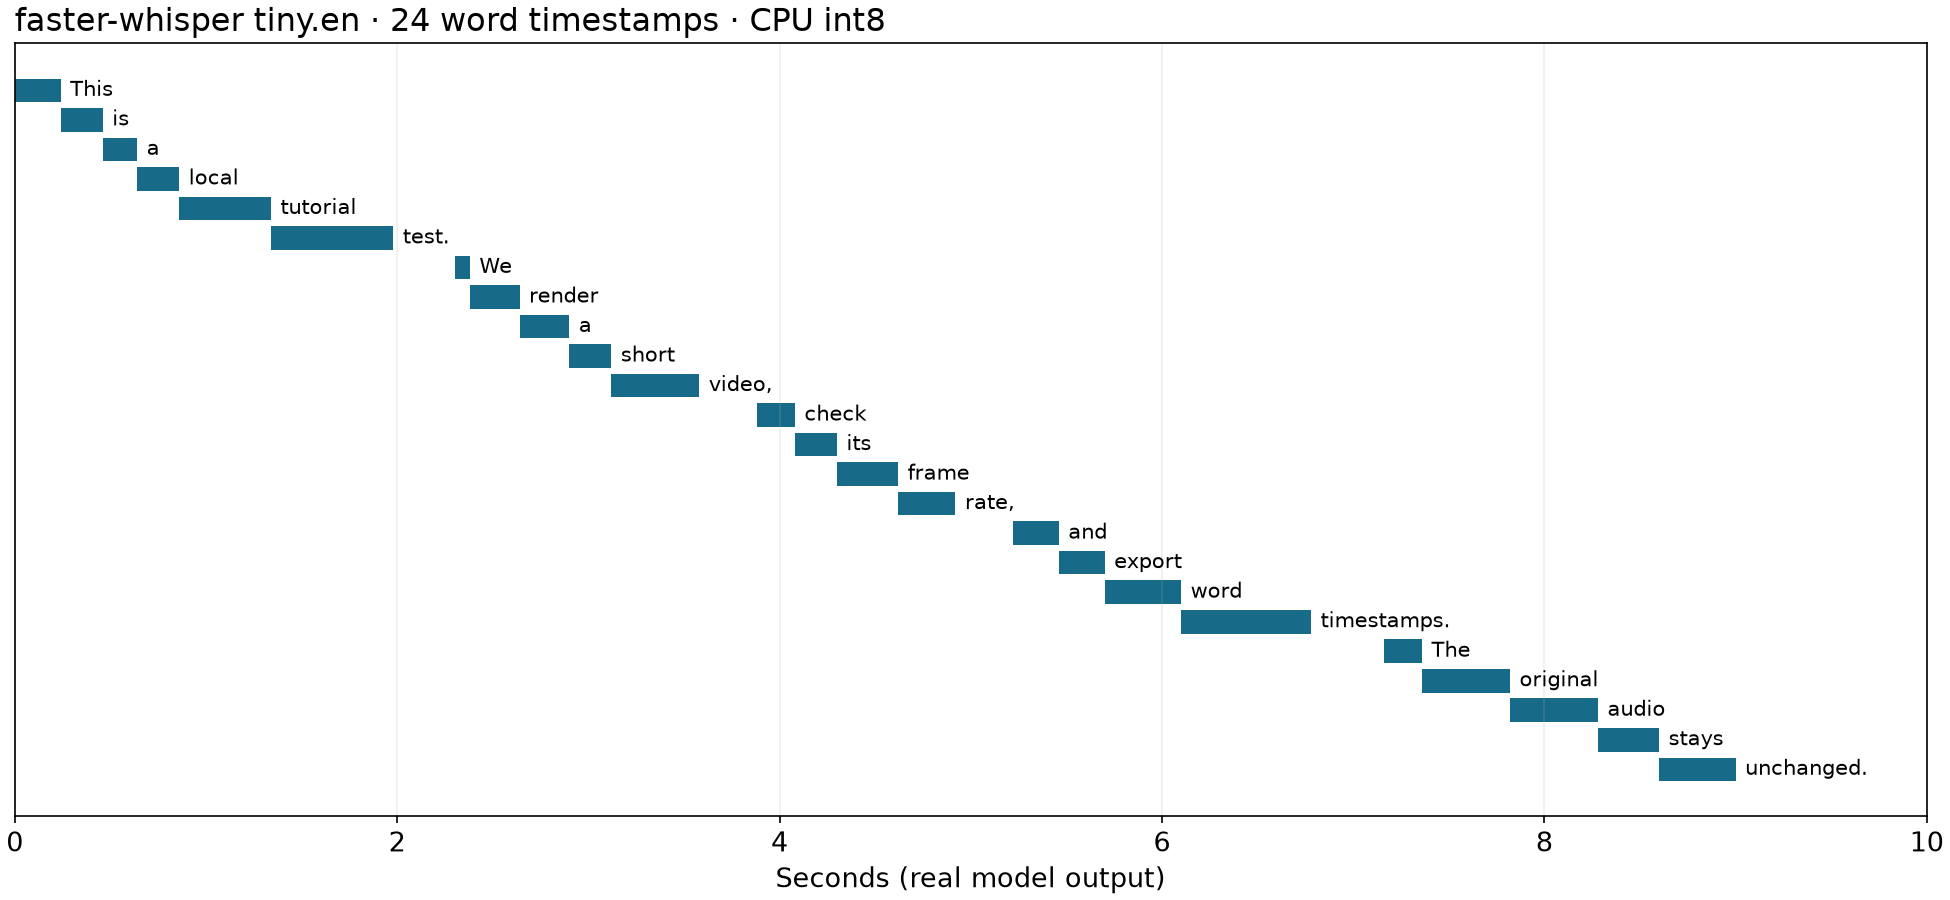
真实词时间戳:24个词的起止与置信信息
同一音频第二次调用开启word_timestamps,真实导出24个词,并提供逐词时间轴与TSV。
· 同一9.472秒英语样本第二次独立transcribe,word_timestamps=True,24个词;不是强制对齐、说话人分离或帧精度字幕。
- 运行环境
- 1.2.1;macOS arm64,本地独立运行目录;无私人素材、无付费API调用
1. 保留原始音频并记录采样率和时长,调用transcribe时加word_timestamp
保留原始音频并记录采样率和时长,调用transcribe时加word_timestamps=True。
bashsegments, info = model.transcribe("speech.wav", language="en", word_timestamps=True) segments = list(segments)2. 完成segments迭代,再遍历segment.words,导出start/end/wo
完成segments迭代,再遍历segment.words,导出start/end/word/probability。
bashfor segment in segments: for word in segment.words or []: print(word.start, word.end, word.word, word.probability)3. 先查看words.tsv:本次第一词This为0.00–0.24s,最后词unchang
先查看words.tsv:本次第一词This为0.00–0.24s,最后词unchanged.为8.60–9.00s。
4. 检查每词起止顺序和是否越过音频长度;概率是模型置信信息,不是时间戳精度保证
检查每词起止顺序和是否越过音频长度;概率是模型置信信息,不是时间戳精度保证。
5. 逐词字幕需要结合停顿、标点、每行字数再分组;在剪辑器中回听抽检,低置信度词单独复核
逐词字幕需要结合停顿、标点、每行字数再分组;在剪辑器中回听抽检,低置信度词单独复核。
这次实际得到什么
- 实际输出24个英语词,逐词起止顺序检查通过。
- 首词This为0.00–0.24秒,末词unchanged.为8.60–9.00秒。
- 第二次开启word_timestamps的推理约0.425秒,已加载模型;不能与首次下载总时长比较。
- 导出TSV包含start、end、probability、word,可下载逐词核对。
使用这份结果时注意
- 同一9.472秒英语样本第二次独立transcribe,word_timestamps=True,24个词;不是强制对齐、说话人分离或帧精度字幕。
用自己的本地模型目录生成词级JSON
需要安装faster-whisper及兼容依赖,准备已下载的模型目录和有权使用的音频。运行:python word_times.py /模型目录 input.wav。本页原有tiny/int8实测继续作为示例,不承诺所有录音同样准确。
word_times.py
import json, sys
from pathlib import Path
from faster_whisper import WhisperModel

model = WhisperModel(sys.argv[1], device="cpu", compute_type="int8")
segments, info = model.transcribe(sys.argv[2], word_timestamps=True)
words = []
for segment in segments:
    for word in segment.words or []:
        words.append({"start": word.start, "end": word.end,
                      "word": word.word, "probability": word.probability})
Path("words.json").write_text(
    json.dumps({"language": info.language, "words": words}, ensure_ascii=False, indent=2),
    encoding="utf-8",
)
print("已保存词级结果;请回听并检查错词与边界")
1. 准备带停顿的短句录音
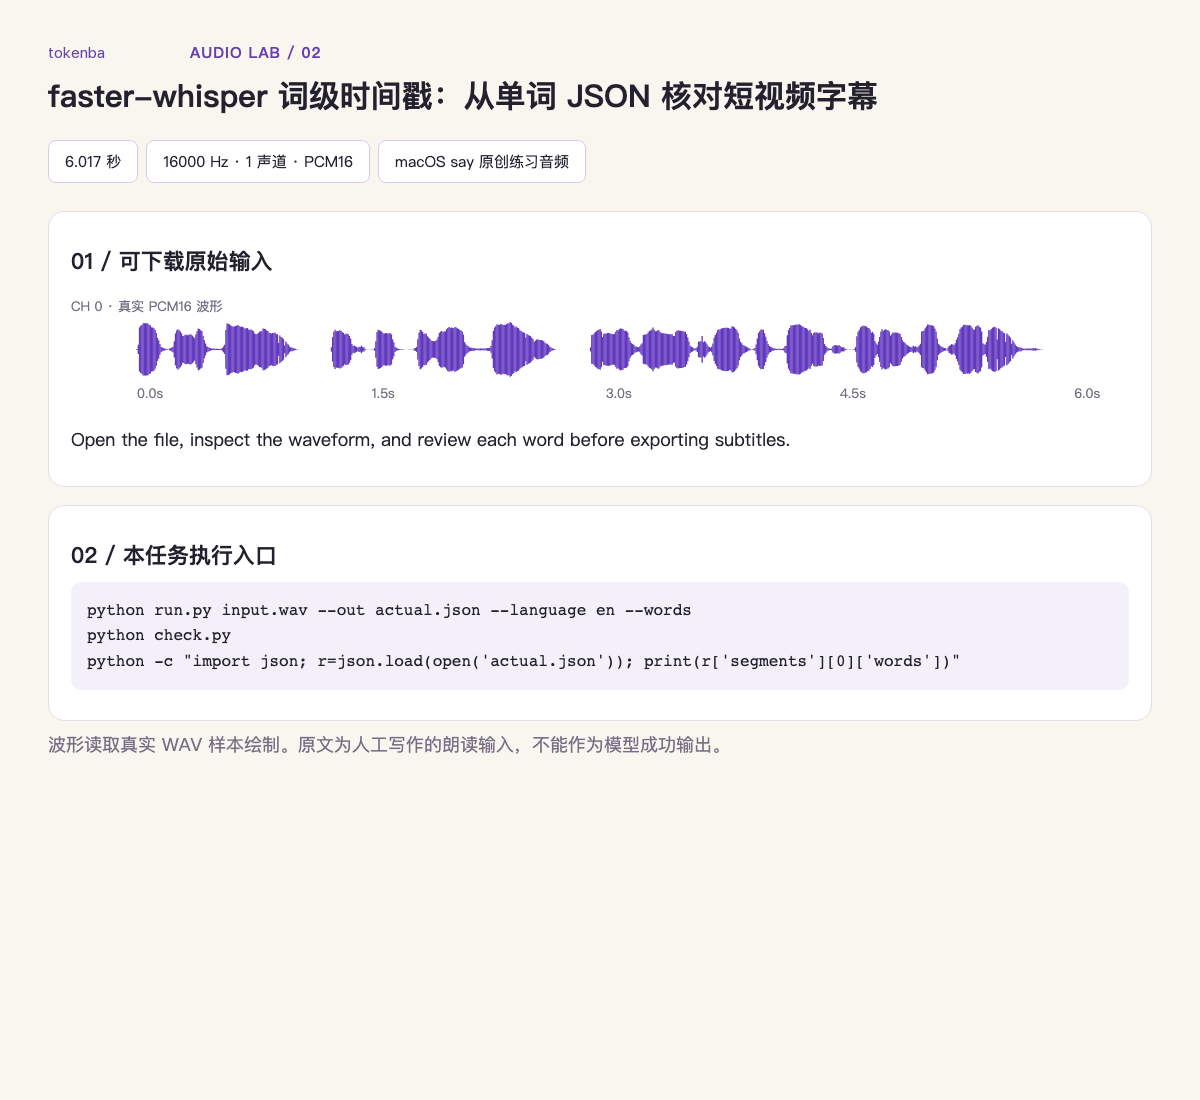
input.wav 朗读 open / file / waveform 等单词,中间有自然停顿。下载 expected.txt,先用播放器判断每个短语的起止,不先手写毫秒数。
2. 开启 word_timestamps
run.py 用 word_timestamps=True 保留 words 数组,含 start/end/word/probability。本页实际 JSON 来自 CPU tiny/int8;概率是模型信息,不是人工验收结果。
3. 比较句级与词级边界
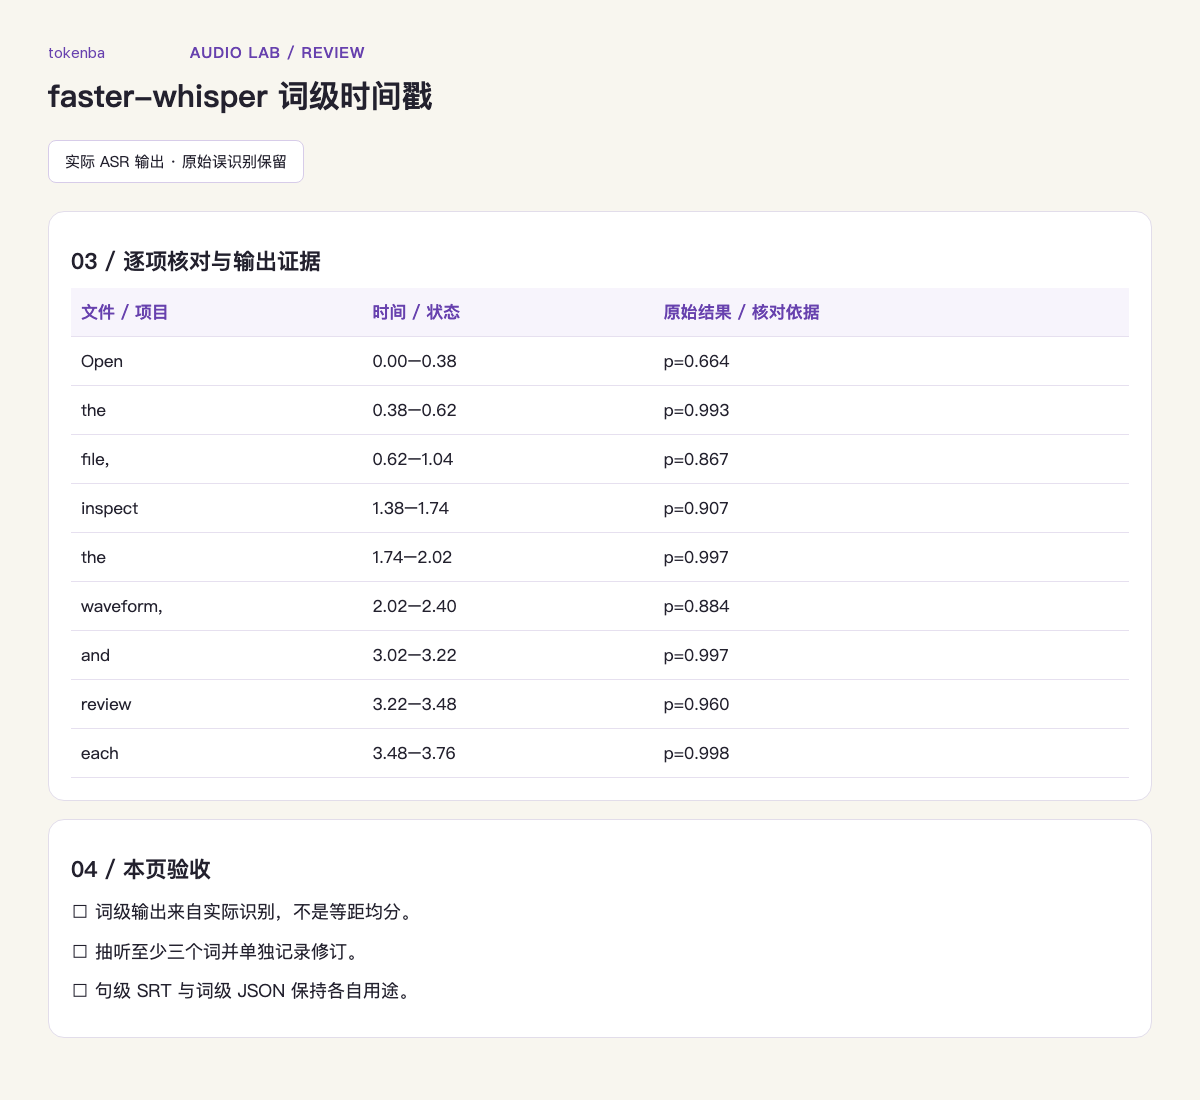
同一句的 segment 覆盖整个短语,words 描述具体词。用本页图中的实际时间表选出至少三个词,回听开头、停顿和段尾;不要把每句平均切分冒充词级识别。
run-commands.sh
python run.py input.wav --out actual.json --language en --words
python check.py
python -c "import json; r=json.load(open('actual.json')); print(r['segments'][0]['words'])"
4. 保留缺失与短时长的词
检查词级时间是否有限、是否 start < end、是否超出原音。脚本把异常记录为需回听,不强制给无时间词补随机毫秒;标点不一定有独立时长。
5. 先修文字,再修高亮时间
输出 raw-words.json、reviewed-words.csv 两份。根据回听修订,保持与原词关联;词准确性不足时重新识别或转 WhisperX 强制对齐,而不是隐藏错误。
6. 移交到字幕渲染步骤
使用 actual.srt 作为句级字幕,词级 JSON 用于高亮渲染。已有 Remotion 页面负责样式和帧映射;本页负责从音频产生可核对的时间证据。
7. 下载材料、检查负例与继续操作
解压素材包后先运行 python check.py,再运行 python check.py --self-test。前者读取真实 WAV / JSON / SRT 与源 hash;后者拒绝损坏 WAV、倒置时间、越界时间和缺失词时间。文件通过不代表文字、情绪或说话人判定已通过。
怎样确认已经完成
- 词级输出来自实际识别,不是等距均分。
- 抽听至少三个词并单独记录修订。
- 句级 SRT 与词级 JSON 保持各自用途。
常见问题
为什么调用后没有words结果?
确认启用了word_timestamps,并真正遍历segments及segment.words。检查当前库版本和原始返回,不用空数组伪装成功。
SRT为什么没有每个单词单独一行?
句级SRT与词级JSON用途不同:SRT适合阅读,JSON供高亮动画或精细修订。逐词显示样式由后续字幕渲染处理。
词级时间戳能完全精确吗?
不能。相邻词、弱音和标点边界可能不稳定;实际回听后再高亮,必要时使用对应语言的对齐模型。
为什么字幕 SRT 没有每个单词一行?
素材包保留可阅读的句级 SRT 和独立词级 JSON,避免长句拆成密集闪烁字幕。视觉排版由后续字幕渲染页处理。