
展开本页目录
开始前准备什么
- 本题公开输入为原创或虚构教学材料,不需要登录第三方平台。
- API步骤需要自己的apizt Key;在模型广场核对当前权限和费用,Key只留在本机。
- 本地处理步骤需要文中注明的Python、FFmpeg或对应工具;本地执行与云API计费分别判断。
- 先标记输入的三类事件
- 打开网页Voice Changer
- 选一把现成可用声线
- 固定设置先做短转换
- 先对照台词与停顿
- 分开验证合成教材和真人事件
- 交付两个音轨和身份记录
2026-10-24 核验材料;实际执行范围、结果与限制见下方记录。
补充:原有练习资料与下载
可打开输入、完整七步README、提示/参数、来源与验收表。
包含本题真实原料身份、执行范围与官方来源。
使用实际输出填写,不把输入解码当效果通过。
本题具体条件,原生工具字段以当前界面为准。
真实操作、成品与核验记录
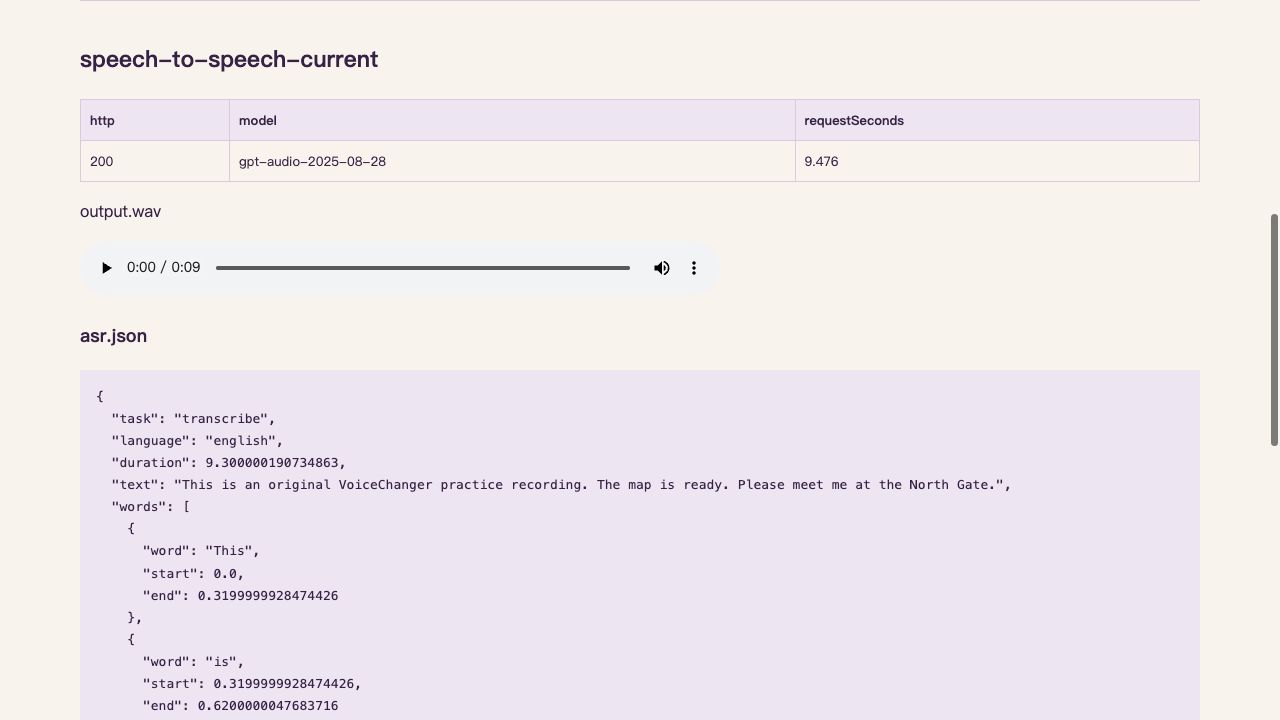
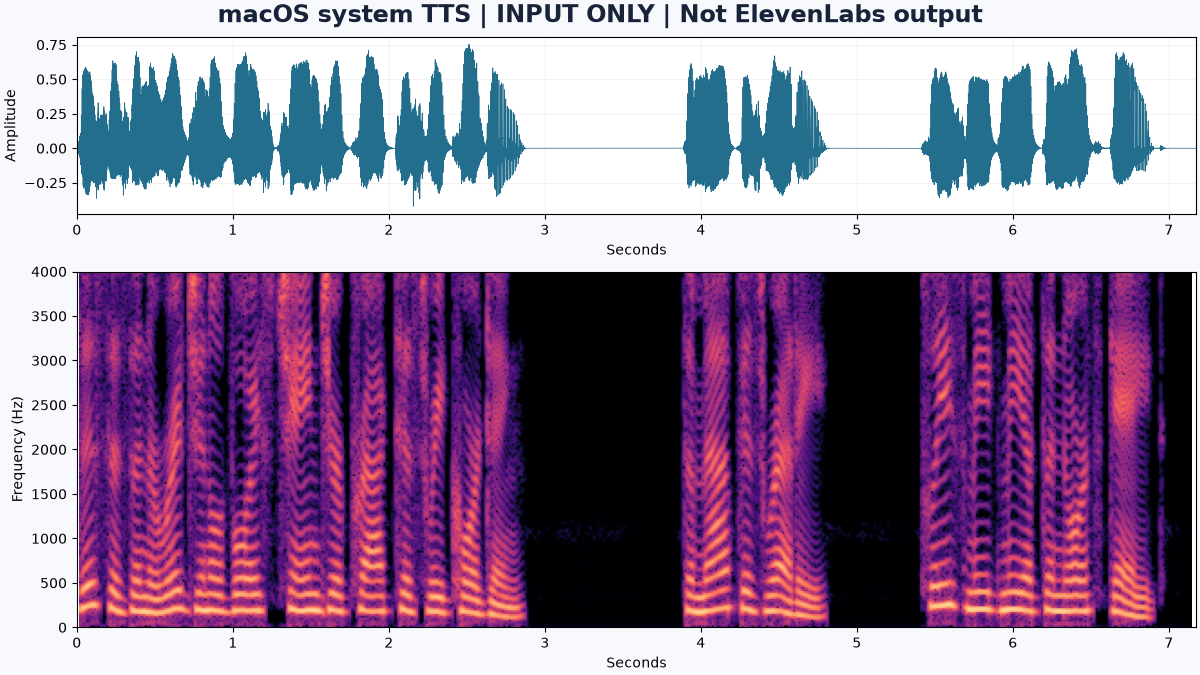
通过 apizt 的 gpt-audio-2025-08-28 实际输入原创合成语音,得到新的 WAV。另一次 Whisper 请求识别出原台词,但原音约7.17秒、结果约9.3秒,不能宣称时间与停顿完全保留。这是语音到语音替代示范,不是 ElevenLabs 原生 Voice Changer。
· 按下列具体任务验收API或本地执行;产品原生功能、文件成功与内容质检分别说明。
已取得下列真实结果;仍有内容质量或功能范围需要按本页检查项复核。
- 运行环境
- apizt API;具体型号与参数见每个请求回执;macOS;公开报告不包含凭据
1. 准备有权使用的源音频
本例为系统TTS合成教学台词,不是真人音色,也没有模仿特定人物。
2. 使用支持音频的当前型号
chat/completions 中传 input_audio,modalities包含text和audio;实际旧型号503,新型号返回WAV。
3. 独立核对输出
下载WAV,检测时长、声道和解码;使用Whisper独立转写,比较台词与停顿,保留速度变化。
这次实际得到什么
- 真实WAV及独立ASR保留,台词没有翻译成别的内容。
- 声音和总时长改变,未证明逐音素时序一致。

使用这份结果时注意
- 需要ElevenLabs专用音色或其原生参数时,不能把本例gpt-audio参数照搬。
1. 先标记输入的三类事件
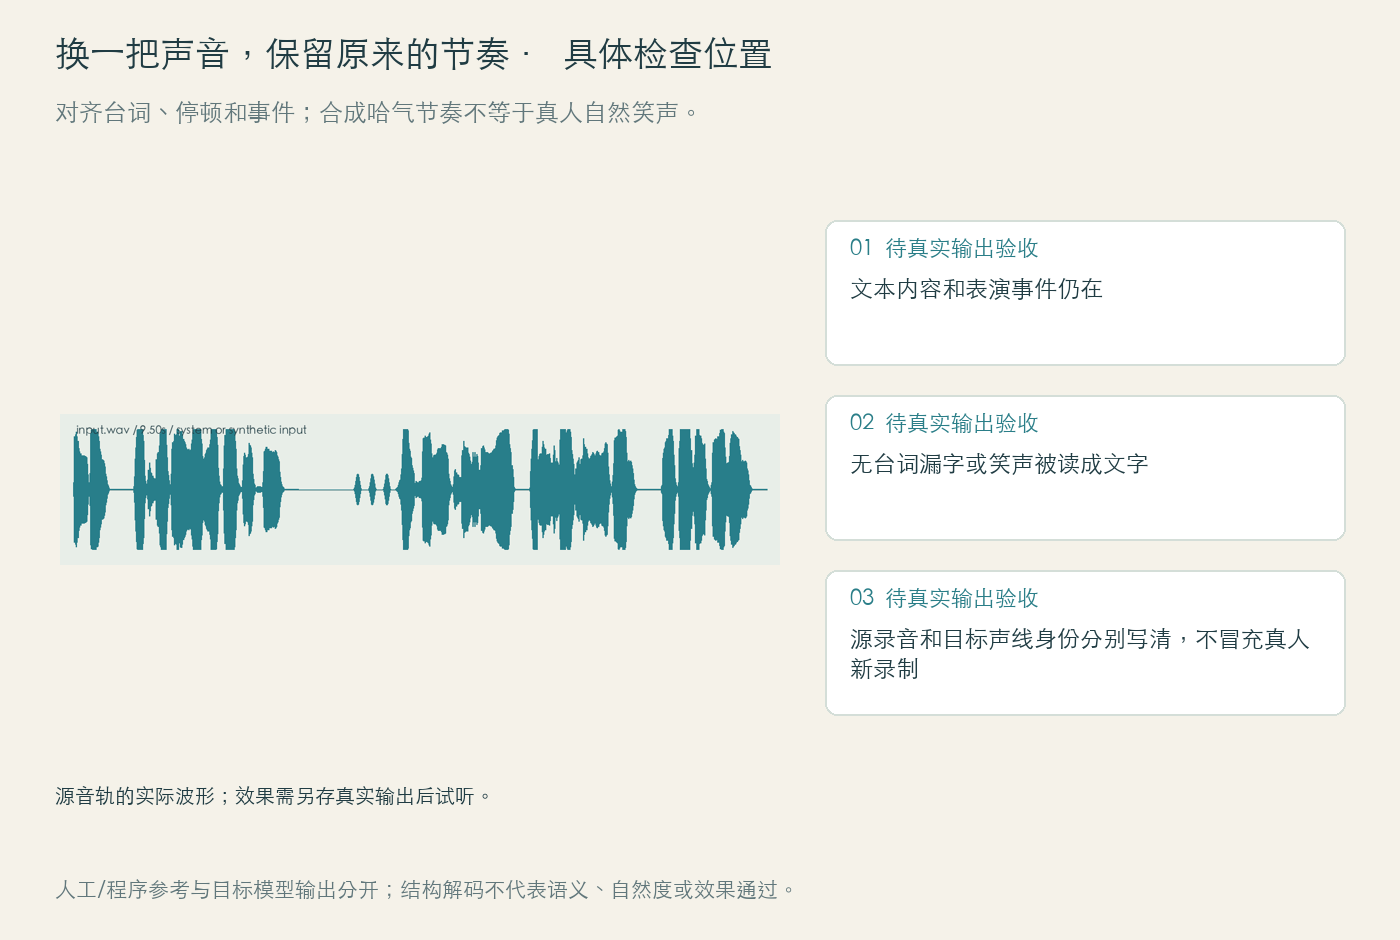
试听input.wav并读events.csv:第一句后有明确停顿,中段是数学合成哈气节奏,末句是系统朗读。它只练上传与时序比较;若要验自然笑声和轻声表演,请换自己或获授权的10秒表演录音。
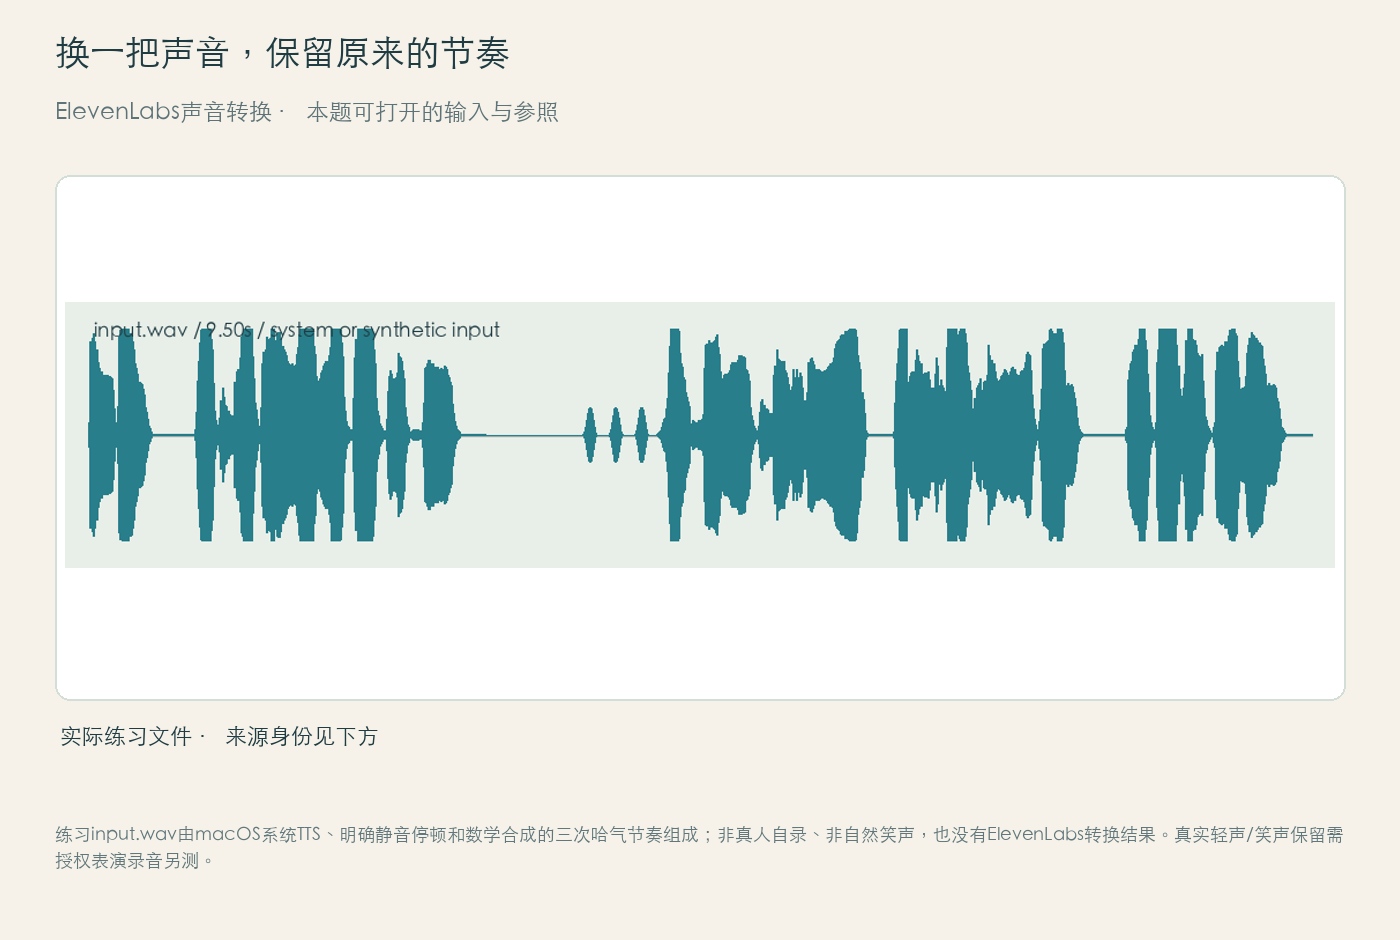
练习input.wav由macOS系统TTS、明确静音停顿和数学合成的三次哈气节奏组成;非真人自录、非自然笑声,也没有ElevenLabs转换结果。真实轻声/笑声保留需授权表演录音另测。
横向滑动查看细节,或打开原图放大对照。
2. 打开网页Voice Changer
在ElevenLabs Playground进入Voice Changer,使用上传音频或原生录音入口。官方网页指南有单次时长和大小限制,本题短样远低于上限;API的speech-to-speech接口不是本题必须步骤。
3. 选一把现成可用声线
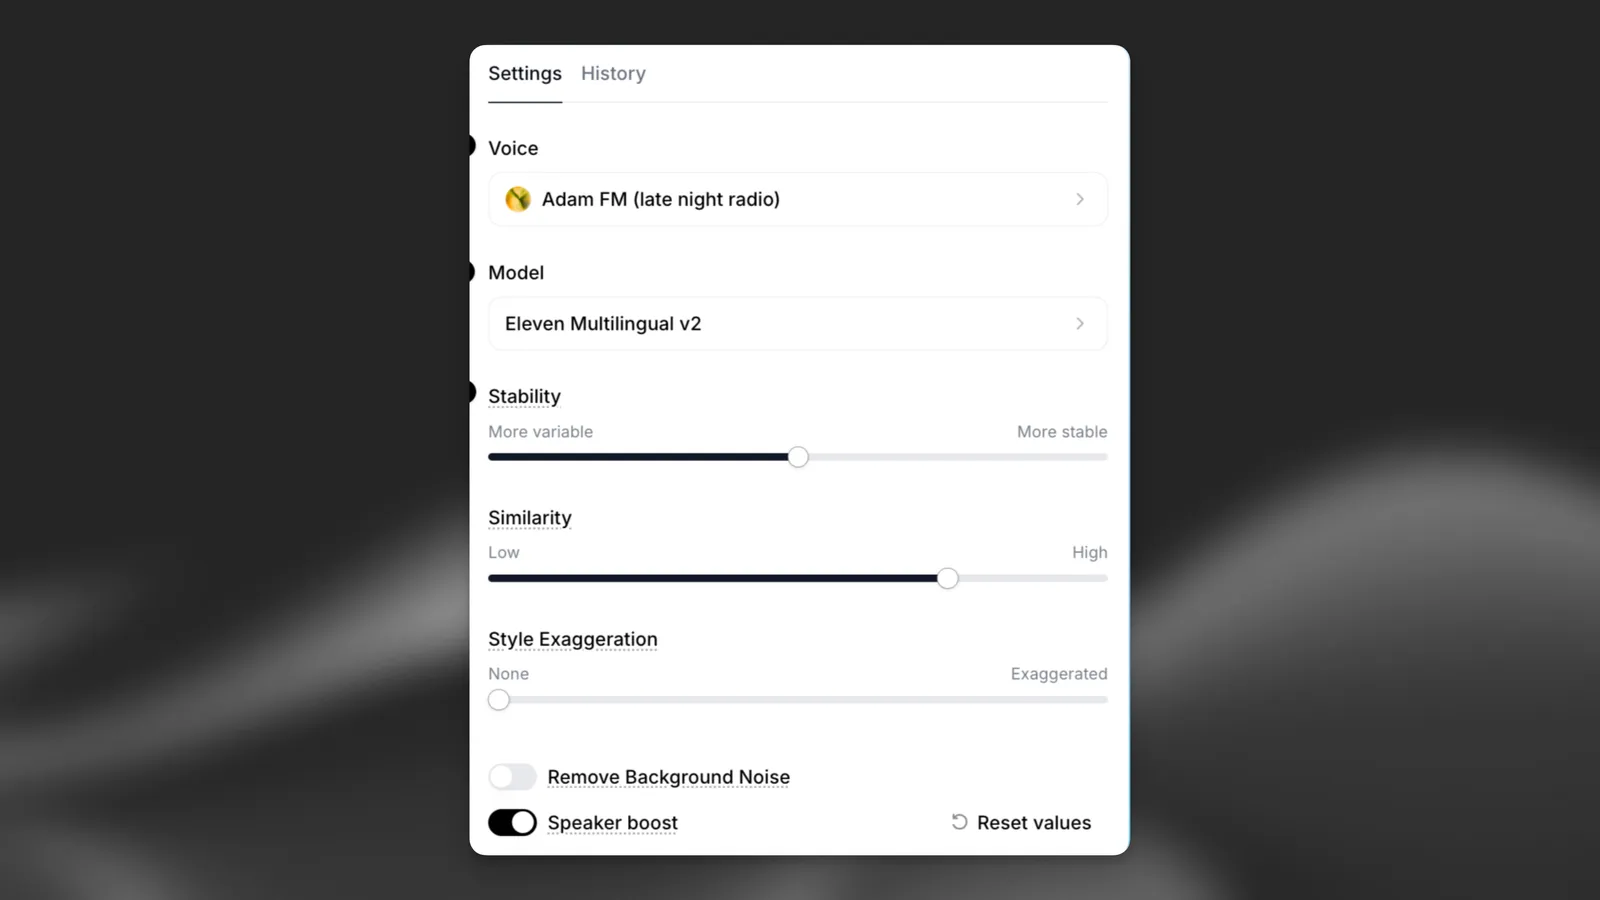
从账户有权使用的预设/现成声线选角色音色,记录名称与使用条件。不做声线克隆,不把一个熟人名字当授权;转换的是已存在的节奏表演,和由文字设计新声线分开。
prompt.txt
台词:等等……我差点忘了带地图。哈哈,还好你提醒我。我们小声一点,别打扰别人。任务:使用Voice Changer选择一个现成且可用的角色声线,转换已有音频,不重新从台词做TTS,不创建或克隆陌生人声音。分别回听停顿、笑声事件和轻声段。
4. 固定设置先做短转换
上传input.wav,检查片段长度和实际费用提示,再用当前界面允许的默认或保守设置生成。parameters.json是记录表,不能冒充可导入预设;不要从文档猜每个账户一定有同名滑块。
5. 先对照台词与停顿
将实际输出与源录音轮流播放,核对“地图”和“提醒”没有漏读,第一句后停顿仍能听见。不要拿新的TTS读稿替代转换结果,因为新TTS可能重新安排全部停顿。
6. 分开验证合成教材和真人事件
对本包只记录合成节奏是否保留,不把它写成自然笑声通过;对授权表演录音才记录真笑声、轻声与情绪是否还在。若笑声被读成“哈哈”两个字,单列失败而不是只看台词一致。
7. 交付两个音轨和身份记录
另存实际转换音频,保留源音、选用声线与费用记录。标注声音转换和源录音身份,避免冒充某人新录制。先通过短样再延长,下载包不附捏造转换后音频。
怎样确认已经完成
- 文本内容和表演事件仍在
- 无台词漏字或笑声被读成文字
- 源录音和目标声线身份分别写清,不冒充真人新录制
常见问题
ElevenLabs声音转换替代这次真实做到了什么?
通过 apizt 的 gpt-audio-2025-08-28 实际输入原创合成语音,得到新的 WAV。另一次 Whisper 请求识别出原台词,但原音约7.17秒、结果约9.3秒,不能宣称时间与停顿完全保留。这是语音到语音替代示范,不是 ElevenLabs 原生 Voice Changer。
是否需要登录第三方平台?
本页主流程按上方实测中的apizt API或本地工具执行。需要ElevenLabs专用音色或其原生参数时,不能把本例gpt-audio参数照搬。