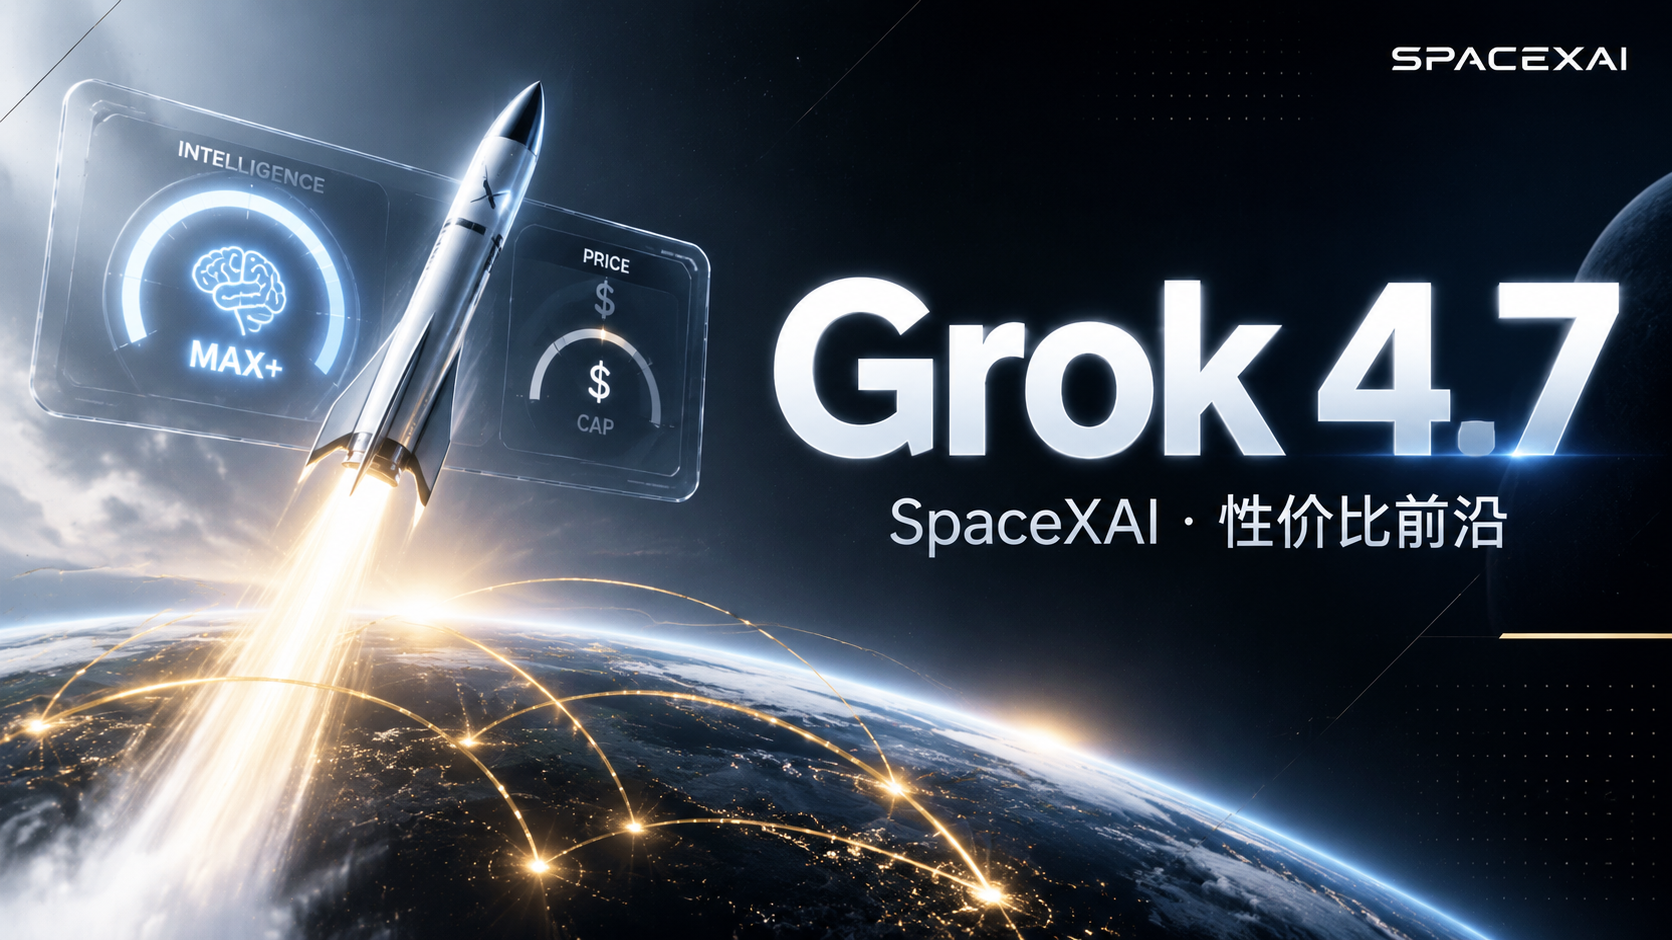
Grok 4.7 评测解读:长程编码、同价资料与 Token 用量
Grok 4.7 评测要同时阅读公开编码成绩和长任务用量。本文保留发布资料;同价说明不保证同一任务账单相同,应在相同工具环境记录最终交付、延迟和全部 Token。
#Grok 4.7#SpaceXAI#长程 Agent
4 分钟1,600 字
阅读全文
正在打开页面…
正在加载内容,请稍候。
工程实践 · 技术洞察 · 行业趋势
apizt 编辑部分享工程实践、架构设计与行业洞察,让技术知识更简单、更实用。
52
深度文章
400+
模型覆盖
实时
价格更新
Grok 4.7 评测要同时阅读公开编码成绩和长任务用量。本文保留发布资料;同价说明不保证同一任务账单相同,应在相同工具环境记录最终交付、延迟和全部 Token。
GPT-6 Sol 评测要先看有效代码结果,再阅读公开定价和缓存说明。本文的版本资料不表示所有通道都享有相同缓存规则;完整成本包括工具回合、失败重试与输出预算。
GPT Image 2.5 评测必须区分 Flare 与 Sunburst 的准确型号,并把速度和细节分别验收。本文解读公开图像资料;多轮编辑每步保存原图、输出、参数与费用,防止越改越偏。
DeepSeek V4.1 Flash 评测要区分公开发布的新版 Flash、旧 Flash 名称和独立 Pro 型号。本文据原文资料讨论版本关系,接入时按当前服务的准确 ID、输入方式和参数做自己的小样测试。
GPT-6 Astra 评测需要把推理基准和 Computer Use 分成各自的能力范围。本文整理既有公开资料;使用搜索或电脑工具前应确认客户端与通道,实际操作保留执行与恢复记录。
Gemini 3.8 Flash 评测应同时检查代码任务和实际协议的参数。本文阅读公开编码与 Agent 资料;自己的兼容层、原生素材输入和思考档位需分别验收,不能只替换名称。
Wan 3.0 Video 评测应把长镜头、音画同步和参考素材的目标写成验收表。本文整理原有视频公开资料;榜单位置与当前通道稳定性不同,真实成片需下载播放并按时长核对费用。
GLM-5.3 Flash 评测需区分视觉材料理解、代码任务与 FlashX 名称。本文整理原文中的发布信息,接入时保留准确 ID,再验证思考设置、图片字段和目标通道支持。
GLM-5.3 评测应把后训练和公开编码成绩作为阅读资料,再以失败测试验收自己的任务。本文不增加新实测;旧客户端关闭思考的设置需按目标型号重新核对。
Gemini 3.7 Flash 评测需把公开速度、价格与 Agent 资料分别阅读。本文整理 3.7 Flash 的既有发布内容,目标通道的首字延迟、总耗时和格式错误还需要用同一批任务记录。
Grok 4.6 评测适合先阅读公开的长程训练与任务资料,再检查自己的工具轨迹。多小时运行和低 token 单价不能单独证明任务更好或更便宜,最终产物与账单要一起验收。
DeepSeek V4 Pro 0813 评测按 0813 快照资料阅读稀疏注意力、长上下文和编码任务。快照名称与网关 ID 的关系必须单独核对,不能把公开原生 Responses 能力当作当前网关已透传。
Qwen3.8 Max 评测需将公开模型规模、上下文和任务基准区分。本文保留 3.8 Max 原有资料;请求名称、快照和开源状态分别核对,再准备有来源的代码或长文任务。
DeepSeek V4 Flash 评测围绕原文的 0731 发布资料和与 Pro 的对照展开。Flash 与 Pro、后续 Flash 版本不能混用名称;比较工程任务时先固定版本与输入,再检查参数兼容和输出。
Claude Opus 5 评测围绕长程代码修改和公开任务资料展开。阅读 Opus 5、Fable 5 与旧 Opus 的对照时,先确认版本、基准来源和计价口径,再用自己的任务决定是否升级。
Kimi K3 评测适合从原文的长上下文和多模态资料选择任务。模型规模不是结果保证;给来源编号、保留会话与工具历史,并检查缺资料和冲突材料的处理。
GPT-5.6 SOL Pro 评测应先识别原文中的 SOL Pro 名称、型号和任务基准。阅读多档位与长上下文资料后,使用实际目录 ID 做自己的固定任务测试,不能从名称自行推定路由。
Grok 4.5 评测应把公开推理成绩和回答风格分开判断。本文整理 4.5 资料;不冗长不代表事实正确,自己的分析任务仍需核对引用、缺信息处理及最终交付。
Seedream 5.0 Pro 评测依据原文官方资料阅读信息可视化和精细图像编辑。自己的素材应固定文案及保留项,真实请求再核对版本 ID、图像端点、输出尺寸和完整费用。
Claude Sonnet 5 评测先从小范围代码修复、文档调整和失败测试观察任务完成条件。本文整理 Sonnet 5 的公开发布资料及与 Opus 的对照,不把任务定位视为任何通道的实测承诺。
Doubao Seed 2.1 Pro 评测依据原文中的官方发布资料区分 Agent、编码与接入。发布分数不表示本站已运行同样任务;先固定脱敏材料,再记录实际工具执行与费用。
Nano Banana Pro 评测应将信息图、商品图和人像等任务分别验收。本文保留公开样例资料;中文文字、数据、Logo 与主体细节逐项核对,不能从单个漂亮样例推断所有场景通过。
GLM-Image 评测适合把中文排版和画面质感分开评价。本文阅读既有公开样例,自己的海报应固定文案、布局与尺寸,再逐字核对错误、主体细节和实际输出文件。
Kimi K2.7 Code 评测依据原文官方资料阅读编码、多模态和思考模式。准备一个可重复的脱敏代码任务,保存请求、输出和测试记录;官方成绩不表示本站已跑出同样结果。
GPT Image 2 评测适合把文字准确度、输出规格和原图保留分开检查。本文整理原有公开图像资料;商品背景编辑和海报文字需要真实文件对照,尺寸或榜单不能代替内容验收。
Grok 4.3 评测需把实时信息工具、代码任务和价格变化分开阅读。原文的发布定位不表示当前兼容请求默认联网,资料时效与工具开放情况要在实际响应中核对。
GLM-5.2 评测应将公开长上下文与编码资料同实际接入区分。原文的开源说明、模型权重和 API 服务是不同交付,窗口规模也不能代替检索与引用验收。
Kimi K2.6 评测围绕原文的长程任务和编码资料展开。用 K2.5、Claude 或 Grok 做对照时,工具环境和任务结束条件要一致,不能只比较公开榜单中的不同题集。
Claude Fable 5 评测要把分析题和金融材料中的假设、来源与计算过程分开阅读。本文整理原文中的公开指标及接入方法,实际业务判断仍需自己的证据表和验收题。
Claude Opus 4.8 评测需要保留长任务的代码版本、工具历史和最终产物。本文按既有公开资料阅读 4.8 的任务定位,与相邻版本比较时仍以同一失败用例和完整账单为依据。
MiniMax M3 评测要区分公开模型能力与实际工具环境。本文按 M3 的既有资料讨论长上下文和编码;电脑动作由客户端工具执行,代码和图片输入则按目标接口逐项验收。
Gemini 3.5 Flash 评测要区分公开 Token 效率数据和自己任务中的完整账单。本文保留 3.5 Flash 的发布资料,比较 Agent 任务时还需对齐工具、输入与输出预算。
Qwen3.7 Max 评测先把公开推理、代码和长程执行指标分开阅读。本文保留 3.7 Max 资料;长期自主运行不是默认网关保证,自己的流程需检查工具历史、退出与任务验收。
AI 编程模型对比应同时检查代码正确性与工具执行过程。原文中的 HumanEval、SWE-Bench 等公开基准适合了解评测任务;自己的仓库仍需固定版本和失败测试再比较。
Grok 4.2 评测先看原文的工程基准和任务定义,再以自己的失败测试验证编码工作。速度与成本定位需要实际通道记录,不能用同系列 Heavy 的成绩代表普通 4.2 请求。
国产大模型对比先区分代码、中文文本和多模态任务。原文按公开资料比较 DeepSeek、GLM、Qwen 与 Kimi,实际选型需对齐版本、输入类型、协议与完整任务成本。
GPT-5.5 评测围绕原有发布资料中的复杂任务与多模态方向阅读。自己接入时应保存工具历史、最终输出和用量,避免把 HTTP 成功当作任务交付或新版本比较结论。
DeepSeek V4 Pro 评测可以先阅读 MoE 和多 token 预测的公开说明,再把它们与自己的代码任务分开评估。本文保留原发布材料,真实效果与费用需要固定任务输入和实际响应记录。
Gemini 3 Pro 评测可以从原文中的 UI 生成和算法方向选择一个可检查的任务。界面截图、代码实现和真实交互分别验收;发布资料的多模态定位不替代当前接口的素材测试。
GPT-5.4 评测先从原文的推理与代码任务确认需要的交付,再检查目录提供的接口。GPT-5.4 的任务资料、模型方案和真正执行测试是不同证据,应分别保存。
Qwen3 Coder 评测从专用编码模型的公开资料出发,实际关注仓库输入与失败用例。本文保留接入与案例材料;生成修改、运行测试和完成合并分别记录,不能只看 SWE-Bench 标题。
Doubao Seed 2.0 评测应先明确中文业务资料、代码或摘要的具体任务。本文按 Seed 2.0 的既有公开资料讨论这些方向,不能把后续 2.1 型号的接口或成绩直接挪到本篇版本。
Seedance 2.0 评测应该把公开动作与音画样例同自己的创建、查询和成片验收区分。原文保留历史材料;接入前核对所用版本与完整 ID,提交任务后保存状态再查询。
Kimi K2.5 评测先区分视觉理解、工具执行与多智能体调度。本文整理 K2.5 公开资料;即使模型生成多个任务计划,应用端仍需实际执行、回传结果并检查冲突。
Qwen-Plus 评测可从中文内容生成、字段提取或代码小任务建立样本。本文整理既有 Qwen-Plus 资料;文字流畅、工具字段返回和真正执行业务是不同验收项。
Claude Haiku 4.5 评测适合先观察客服短消息分类与简短资料处理的验收条件。本文解读既有发布资料和价格入口,轻量定位不能代替实际误分率、缺字段处理和批次账单。
GLM-4.6 评测按原有公开资料阅读代码与中文任务的使用方向。维护旧 4.6 应用时保留请求基线,新 GLM 的思考规则和视觉规格不能自动套回旧型号。
GPT-5 mini 评测可以从原文的日常轻量任务选择分类或摘要样本。低单价不自动等于批量正确;先统计缺字段、格式失败与升级处理,再逐步增加并发。
Grok 4 评测应先识别普通 Grok 4 与 Heavy 的型号差异,再阅读公开实时信息与代码资料。联网工具和素材来源需要实际确认,系列指标不能直接归给普通 API 请求。
Gemini 2.5 Flash 评测先把短摘要、分类或字段提取的目标写清楚。本文整理 2.5 Flash 的既有发布资料;所谓轻量和速度定位,需要在目标通道记录实际延迟、错误和完整用量后判断。
Gemini 2.5 Pro 评测需要把公开多模态与推理基准放回具体题目条件中。本文保留 2.5 Pro 的既有发布资料及接入入口,图片、音频、视频等素材在当前网关中的传入方式分别验证。
DeepSeek V3 评测从中文内容和代码任务的固定输入开始阅读。本文保留 V3 原有实战材料与接入示例,当前可用型号、协议和账单要另行核对,不能借新版本规格改写旧任务。